Staging-слой на EAV: случай, когда антипаттерн оправдан
В этой статье — про STAGING-слой нашего DWH и о том, как мы работаем с EAV-паттерном. Сразу оговорюсь: EAV в реляционной базе — устоявшийся антипаттерн, который в большинстве задач стоит обходить стороной. Здесь я рассказываю не о том, хорош EAV в целом или плох, а о конкретном случае, когда он оказался оправдан: почему он к нам пришёл, как мы с ним живём, что он даёт и где реально мешает.
TL;DR. На STG мы храним данные в EAV-партициях по (сущность, источник, период), при загрузке раскладываем значения по типам и разделяем их на OK и FAIL, а JDBC-драйвер разворачивает это в обычные таблицы для чтения.
С чем мы имеем дело
Использование в стеке NiFi позволяет строить такие процессы и писать такие процессоры, которые позволяют брать данные практически из любых внешних источников. Сам STG об источнике ничего не знает. Забрать данные и привести их к JSON — задача ETL-процесса в NiFi, а STG имеет лишь API, который кушает данные.
Обратная сторона такой универсальности: схему входящего JSON заранее никто не описывает. Одна и та же сущность в двух источниках может прийти с разным набором полей, а новое поле появляется тогда, когда его добавили на стороне источника, а не когда мы об этом узнали. Записи бывают вложенными: документ приходит со строками, поле может оказаться объектом.
Одну и ту же сущность мы грузим из разных источников и за разные периоды, и каждая выгрузка у нас живёт отдельно: её можно удалить или перезалить, не трогая остальные. После загрузки и нормализации основными потребителями становятся наши ETL-процессы. Они перекладывают данные на детальный слой (DET).
И ещё одно требование, которое в итоге определило многое: если какое-то значение не удалось разобрать, мы хотим об этом знать, а не обнаружить через полгода дыру в отчёте.
Зачем на STG нужны типы
JSONB позволил бы сохранять входящий документ без раскладки на отдельные значения. Да, вероятно, это было бы даже быстрее, но само по себе такое хранение не отвечает на вопросы, которые возникают перед перекладкой на детальный слой.
Мы хотели использовать STG не только как помойку входных данных, но и дать пользователям возможность уже на этом этапе видеть, что и как загрузилось и какие значения требуют внимания.
В целом, на STG у нас три основных типа данных: строка, число и дата.
Есть также колонка ref_value: в неё попадают значения, распознанные как ссылки (UUID) на связанные сущности — например, номенклатуру или контрагента.
Перед перекладкой на детальный слой нам нужно понимать:
Каков характер данных этого поля?
Поле числовое или всё же значимая часть значений имеет строковый характер?
А если дата-инженер ошибётся, выставит неверный тип на DET и часть данных при перекладке будет утеряна?
Мы решили, что пользователю системы не нужно самому отвечать на эти вопросы: типовую часть этой работы можно и нужно автоматизировать.
Поэтому часть этой работы мы забрали на STG:
При загрузке мы собираем первичную структуру и статистику, раскладываем значения строк по полям в зависимости от их характера.
Нормализация работает только с техническим, а не с бизнесовым смыслом данных, но приводит значения колонки к единому типу. Значения, которые не удалось привести, не теряются: они фиксируются в инцидентах, требующих внимания.
А вот для чтения у нас есть JDBC-драйвер. Он разворачивает EAV в широкую таблицу и поддерживает часть стандартного SQL: фильтры, агрегации, группировки, соединения таблиц. Это SELECT и точечный INSERT в конкретную партицию; UPDATE, DELETE, DDL, а также UNION, CTE и оконные функции драйвер не выполняет.
Как устроены данные
Таблица STG — это версия загрузки
У нас таблица STG определяется не именем, а тройкой: код сущности (code), ресурс — источник, из которого пришли данные (resource_name), и период (period_id). Например, counterparty#accounting#202609 — контрагенты из одной конкретной бухгалтерской базы за сентябрь 2026 года. Загрузили те же контрагенты за октябрь — это уже другая таблица.
EAV, только попроще
Классический EAV раскладывает данные на три уровня: сущность, атрибут и значение, причём атрибуты обычно живут в отдельном справочнике. Мы пошли проще и объединили атрибут со значением: в строке значения поле указано прямо по имени (field_name), а само значение лежит в одной из колонок value_*, в зависимости от типа.
Вот так выглядят таблицы:
CREATE TABLE entity (
    guid           uuid,
    code           varchar(255) NOT NULL,
    resource_name  varchar(255),
    period_id      integer NOT NULL,
    source_json    jsonb,           -- исходный JSON записи целиком
    process_guid   uuid NOT NULL,   -- пакет загрузки
    load_dt        timestamp NOT NULL,
    "$parent"      uuid,            -- guid родительской записи, у корневых NULL
    source_id_str  varchar(255),    -- legacy: не используется — хэш JSON и кода: пишем, но не читаем
    source_id_int  integer          -- legacy: не заполняется
) PARTITION BY RANGE (code, resource_name, period_id);
CREATE TABLE entity_field_value (
    guid                  uuid,
    entity_guid           uuid NOT NULL,   -- entity.guid
    entity_code           varchar NOT NULL,
    entity_resource_name  varchar,
    period_id             integer NOT NULL,
    process_guid          uuid NOT NULL,
    field_name            varchar,
    value_str             varchar,         -- String
    value_int             varchar(156),    -- BigDecimal, но строкой
    value_dt              varchar(156),    -- Timestamp, но строкой
    ref_value             uuid,            -- Ref, ссылка (UUID) на объект в источнике
    entity_id_str         varchar,         -- legacy: не используется — копия entity.source_id_str
    entity_source_id      integer          -- legacy: не заполняется
) PARTITION BY RANGE (entity_code, entity_resource_name, period_id);
И её двойник entity_field_value_fail с точно такой же структурой. Про него я расписал отдельный раздел ниже.
Помимо основных таблиц хранения данных у нас есть вспомогательные таблицы для метаданных:
entity_partition— реестр партицийcache_entity_structure— кэш структурыentity_field_statistic— статистика по разложенным записям
В этой статье я не буду углубляться в устройство этих таблиц — это отдельная история, о которой мы расскажем отдельно.
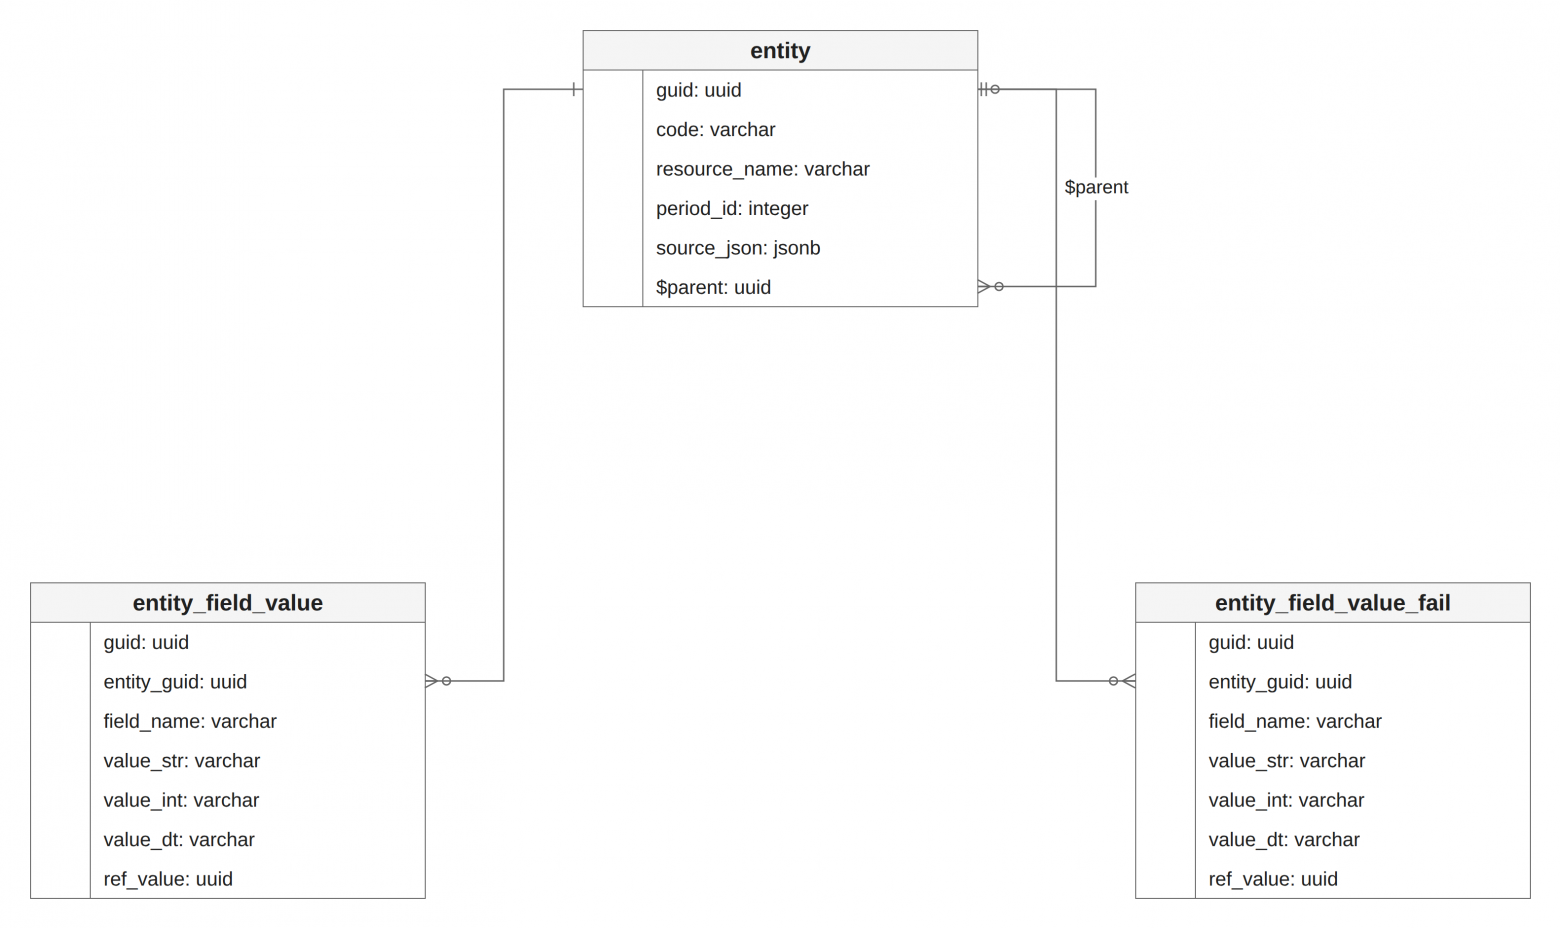
Партиция создаётся при первой загрузке таблицы:
CREATE TABLE entity_1041 PARTITION OF entity
    FOR VALUES FROM ('counterparty', 'accounting', 202609)
    TO ('counterparty', 'accounting', 202610)
    WITH (autovacuum_enabled = false);
Партиция на версию загрузки — это то, что делает EAV у нас вообще живым. Для каждой логической таблицы драйвер выбирает партиции нужного источника и периода, не захватывая остальные выгрузки. При чтении он обращается к паре партиций — сущностей и их значений; при каждом JOIN к сущности добавляется ещё одна такая пара. Номера вроде entity_1041 и entity_field_value_1042 — внутренние идентификаторы, которые сервис присваивает партициям при их создании. Удалить выгрузку — значит сделать DROP этих партиций, а не DELETE по сотням миллионов строк значений.
Как данные попадают в STG
Всё, что связано с источником, живёт в NiFi: подключение, выгрузка, преобразование в JSON, нарезка на пакеты. Оркестрацией процессов занимается AirFlow, но это совсем другая история. Для STG все источники выглядят одинаково — как вызовы одной универсальной ручки:
POST /api/entity-field-val/{code}/{period_id}/{resource_name}
В теле — массив JSON-объектов. Код, ресурс и период корневой сущности задаются в пути, всё остальное сервис выясняет сам.
Рекурсивный разбор JSON
Разберём на примере. Пусть NiFi прислал в POST /api/entity-field-val/sale/202609/shop_a массив с одним документом:
[
  {
    "Ссылка": "8a1f2c3e-1947-4c62-9d85-6b02e7f3a410",
    "Номер": "0000-000123",
    "Дата": "2026-09-15T10:30:00",
    "Сумма": 1599.90,
    "Комментарий": "",
    "Контрагент": { "Ссылка": "5b2e9410-6a83-47fd-b205-3c18e9a76042", "Наименование": "ООО Ромашка" },
    "Товары": [
      { "Номенклатура": "77c04a12-3f86-49d1-a207-5e6b8c930014", "Количество": 10, "Цена": 99.90 },
      { "Номенклатура": "91d4b630-82a5-4f19-bc07-6e3a2058d941", "Количество": 1, "Цена": 600 }
    ],
    "Теги": ["опт", "срочно"]
  }
]
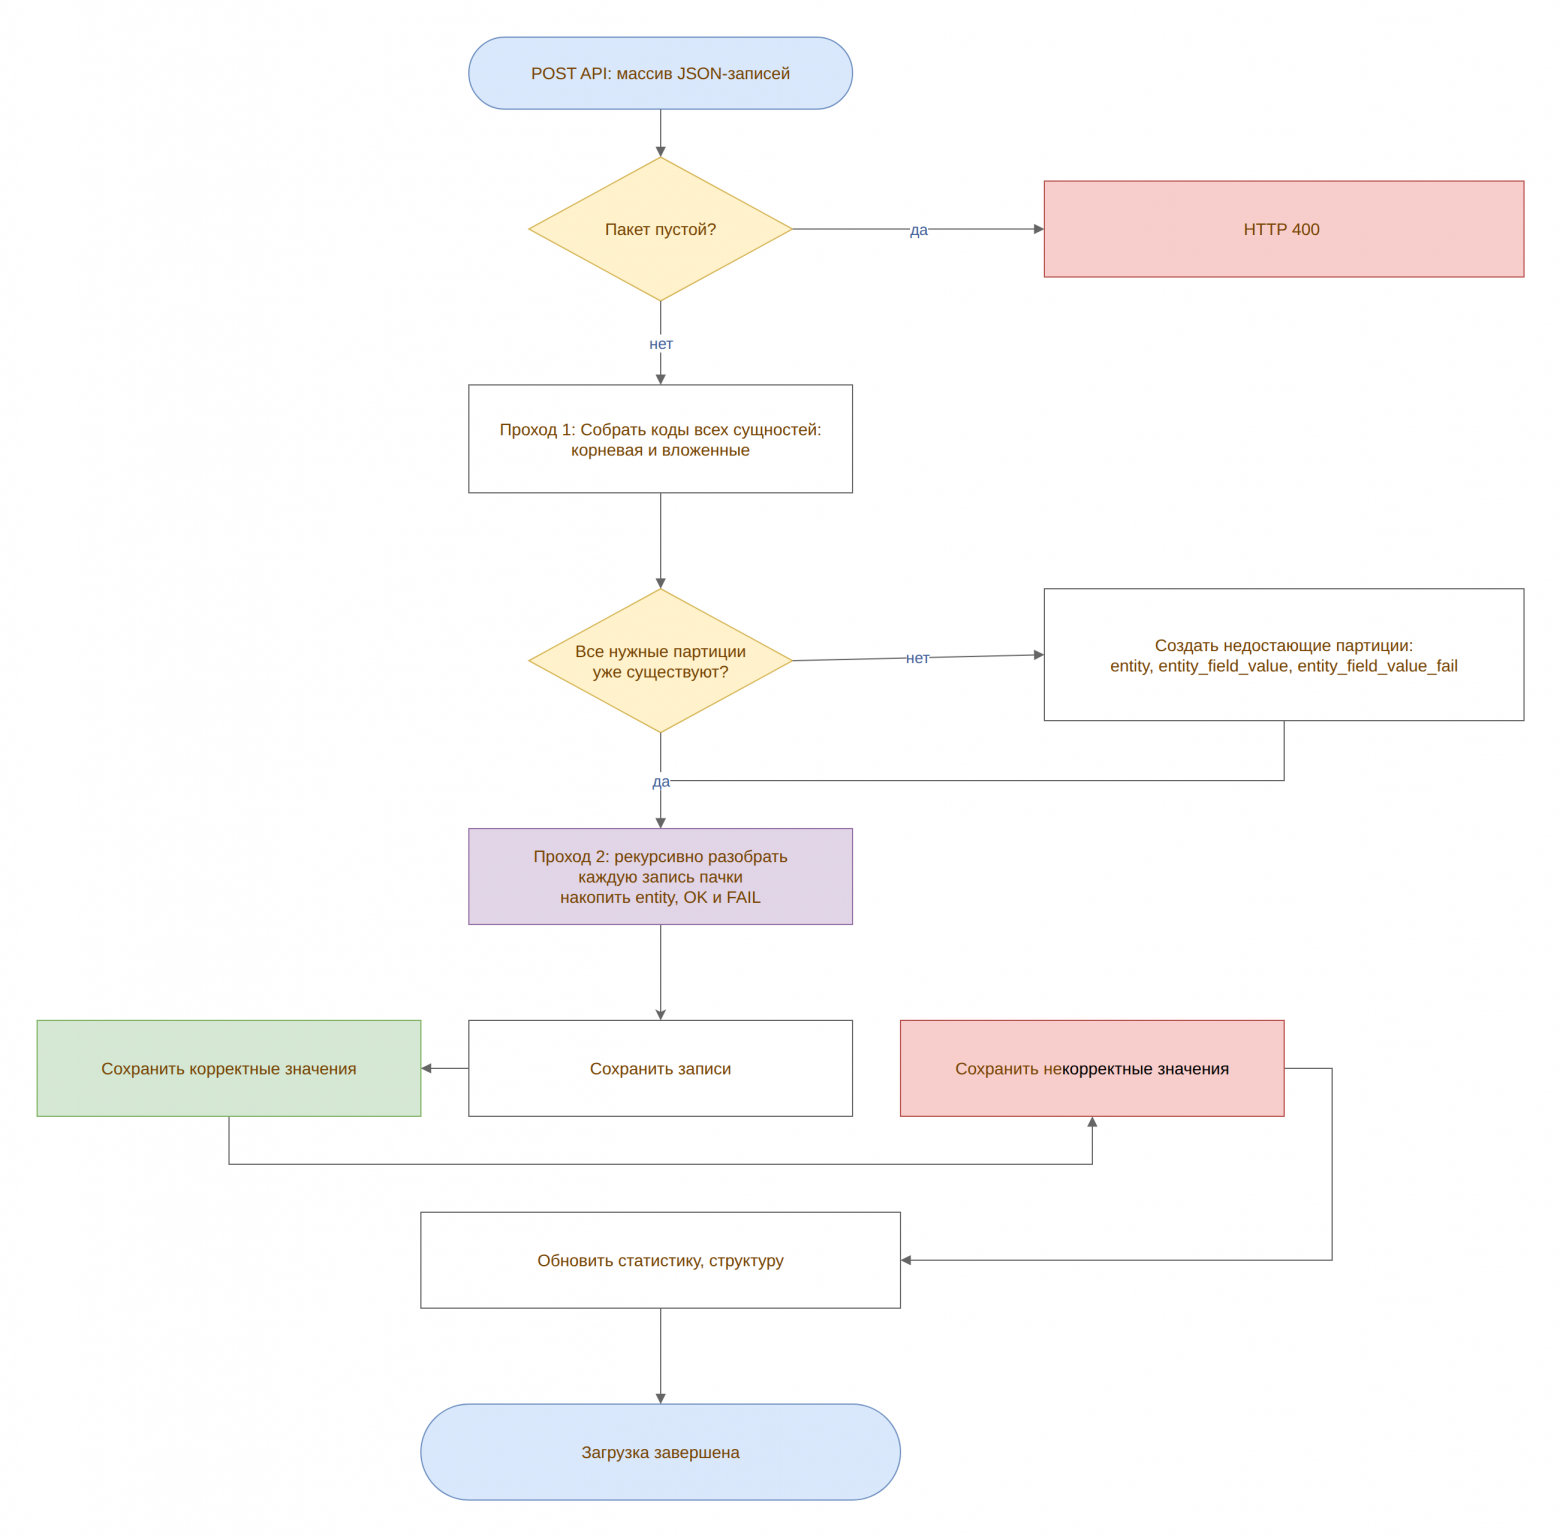
Обработка идёт в два прохода.
Первый проход — какие таблицы понадобятся. Сервис обходит весь пакет и собирает коды всех вложенных сущностей. Объект или массив в поле X сущности P даёт код P_X. В примере это sale, sale_Контрагент, sale_Товары и sale_Теги: партиции создаются и для массива без объектов, хотя записей в нём не будет. Вложенность может быть любой глубины: если бы у строки товара был массив Скидки, появилась бы ещё sale_Товары_Скидки. Для каждой сущности, у которой ещё нет партиций в этой версии загрузки, создаются три партиции. Пакеты одной таблицы могут прийти параллельно, поэтому партиции создаются под блокировкой и в отдельной транзакции.
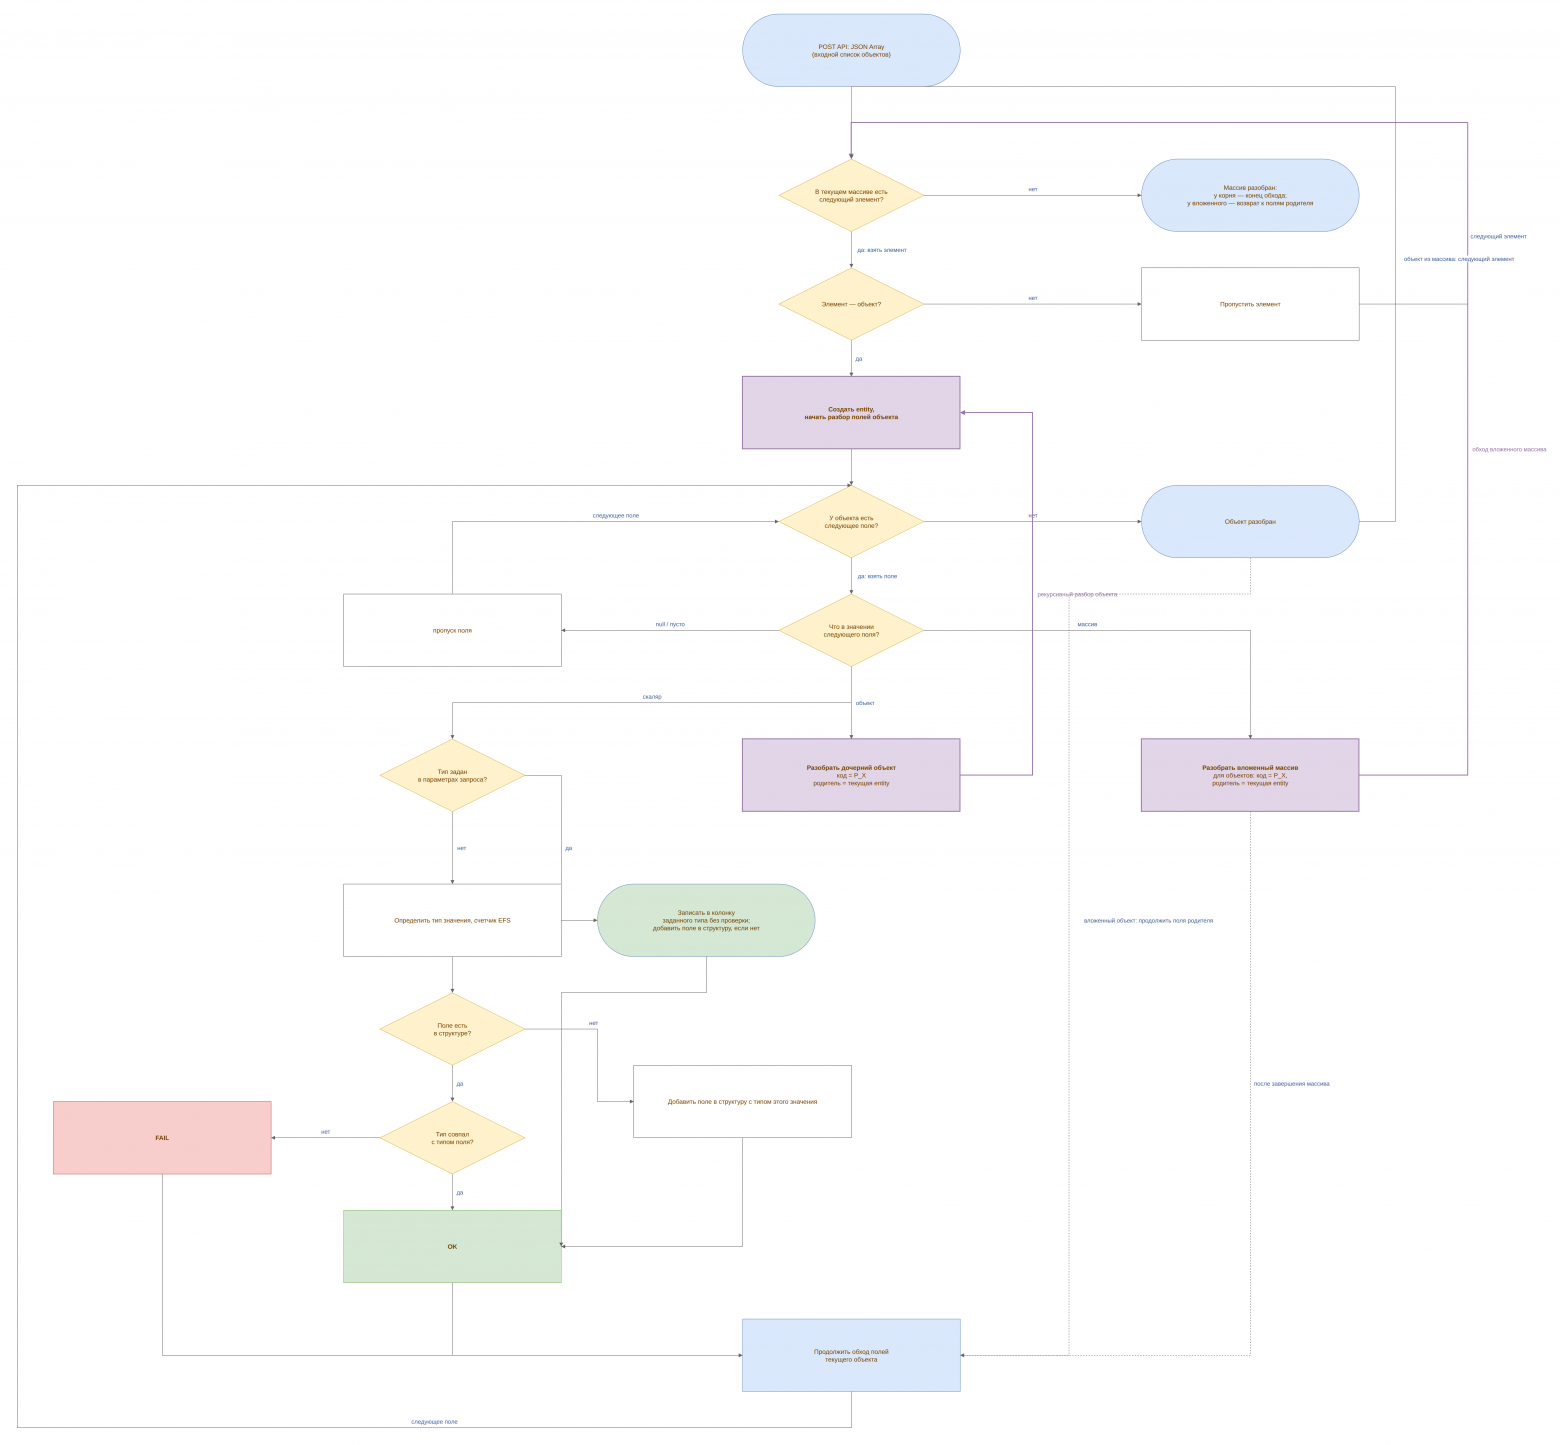
Второй проход — раскладка. Каждая запись превращается в строку entity, и дальше сервис идёт по её полям. Для каждого поля решение принимается по тому, что в нём лежит:
Что в поле | Что происходит |
|---|---|
null или пустая строка | Пропускается; значение остаётся в |
Скаляр — строка, число, дата, UUID | Становится строкой значения: определяем тип, кладём в OK или FAIL (об этом ниже) |
Объект | Становится записью дочерней сущности |
Массив объектов | Каждый элемент — отдельная запись дочерней сущности |
Массив объектов вперемешку с другими элементами | Объекты разбираются как выше, всё остальное пропускается |
Элемент массива, который не объект — скаляр или вложенный массив | Пропускается вместе со всем содержимым, остаётся только в |
Пробелы в именах полей заменяются на _. Строковые значения очищаются от неразрывных пробелов и пробелов по краям: значение из одних пробелов считается пустым.
У каждой записи свой source_json. У корневой — документ целиком, у дочерней — только её объект: у строки товара это {"Номенклатура": "77c04a12-...", "Количество": 10, "Цена": 99.90}.
Из документа выше получится:
Таблица | Записей entity | Значений |
|---|---|---|
| 1 | Ссылка, Номер, Дата, Сумма — 4 значения; Комментарий пустой, Теги — массив без объектов |
| 0 | пустая таблица: партиции создаются для любого массива, а записей в нём не оказалось |
| 1, | Ссылка, Наименование — 2 значения |
| 2, | по 3 значения на строку — 6 значений |
Через драйвер непустая часть примера выглядит как три обычные таблицы; дочерние записи связаны с документом через $parent. Пустая sale_Теги тоже появляется в каталоге.
Тип поля можно задать и явно, указав его в параметрах запроса при загрузке — например, ?Товары.Цена=String для вложенного поля. Подробно об этом — в разделе «OK и FAIL».
При сохранении и OK, и FAIL сервис накапливает статистику EFS по фактически заполненной колонке значения: string_count, big_decimal_count, timestamp_count и ref_count. Счётчики общие для обеих партиций и привязаны к партиции OK. После обработки пакета приращения добавляются в entity_field_statistic; на пару (partition_id, field_name) приходится одна строка. null и пустые строки в эти счётчики не входят.
Алгоритм целиком состоит из двух частей. Верхний уровень — подготовка и запуск разбора для каждой записи пакета:
Сам разбор — рекурсивная процедура разобрать(объект, P). Встретив вложенный объект, она вызывает саму себя для него с кодом P_X:
Когда загрузка завершена, сервис делает ещё один шаг — наводит порядок в только что заполненных партициях.
После загрузки: VACUUM ANALYZE
В конце прогрузки процесс вызывает ещё один API нашего бекенда, который запускает команду VACUUM ANALYZE по всем партициям таблицы, включая вложенные.
VACUUM — уборка. При загрузке мы только добавляем строки, но нормализация уже обновляет значения и переносит их между OK и FAIL через удаление и вставку. После этих операций остаются старые версии строк, место которых нужно освобождать для повторного использования. Кроме того, VACUUM обновляет карту видимости, которая помогает PostgreSQL выполнять чтение только по индексу, без лишних обращений к таблице.
ANALYZE — статистика. После загрузки данных на STG слой последует его перекладка на DET. Здесь мы начали ощущать небольшие проблемы с производительностью. Статистика сразу после прогрузки находилась в печальном состоянии и планировщик при чтении данных при перекладке выбирал не самые оптимальные сценарии, поэтому и было принято решение обновлять её вручную после выгрузки.
Обслуживание запускаем явно. Autovacuum в этих партициях отключен, а VACUUM ANALYZE вызывается из процесса после загрузки. Так обслуживание привязано к известному этапу обработки. Это не означает, что уборка не нужна: при выборе момента запуска нужно учитывать и последующую нормализацию, которая снова меняет данные и статистику.
OK и FAIL
Тип значения мы определяем по содержимому: похоже на UUID — Ref, на дату — Timestamp, на число — BigDecimal, всё остальное — String. Дальше смотрим в структуру таблицы:
поле уже известно и тип совпал — значение идёт в
entity_field_value;поле известно, а тип другой — в
entity_field_value_fail;поле видим впервые — его тип становится типом первого встреченного значения, а значение идёт в
entity_field_value.
Если мы заранее знаем, что поле нужно считать, скажем, строкой, тип можно передать в параметрах запроса при загрузке — например, ?ИНН=String. Тогда все значения этого поля записываются как строки, даже если по содержимому они выглядят как числа или даты. Это удобно для кодов и идентификаторов, где ведущие нули или нечисловая форма значимы.
Такой подход позволяет нам не держать мусор в основном хранилище, но при этом не отбрасывать его без следа.
Нормализация типов
После загрузки NiFi запускает нормализатор. Он проходится по каждому полю загруженной сущности (сущностей, если включен параметр учета вложенных объектов) и пытается привести все данные в рамках каждой колонки к единому формату.
EFS (entity_field_statistic) хранит четыре счётчика типов по всем значениям поля вне зависимости от того, в какую партицию оно попало. На самом деле статистика — вопрос оптимизации. В ходе загрузки мы собираем агрегированную по полям статистику с количеством значений каждого типа, чтобы потом для нормализации у нас не было необходимости слать длительные COUNT-запросы с фильтрами в партиции на сотни млн. и более строк.
Нормализатор ищет тип, доля которого среди всех значений поля достигла заданного порога. По умолчанию это 90%; допустимый порог — больше 50% и не больше 100%. Если такой тип найден, он становится типом поля. Если ни один тип не набрал порог, выбирается String.
Есть и принудительный режим Force String Type, который сразу выбирает String для всех обрабатываемых полей.
Например, у Код_Клиента 50% чисел, 40% строк и по 5% дат и ссылок. При пороге 90% доминирующего типа нет, поэтому все значения переводятся в String и оказываются в OK: существующие числа, даты и ссылки записываются в value_str, а остальные колонки значения очищаются. Счётчики EFS меняются вместе с данными.
Другой случай: у Количество 92% чисел и 8% строк. Выбирается BigDecimal. Числа из FAIL переносятся в OK, а строки, если они до этого лежали в OK, — в FAIL. Строки в числа не преобразуются. Распределение типов в EFS от такого перемещения не меняется.
Транзакция у нас работает на уровне одного поля, то есть все переносы, чистки, обновление статистики и структуры в рамках одного поля являются атомарной операцией. Однако, если какая-то часть полей была нормализована, при сбое в следующей итерации уже обработанные данные не откатятся.
Поля, требующие внимания, в том числе поля с оставшимися значениями в FAIL, собираются в список. После успешного обхода сущности отправляется один инцидент с этим списком, если отправка в Kafka включена. При ошибке выполнения нормализация останавливается, и до отправки списка по этой сущности дело не доходит.
Алгоритм нормализации целиком:
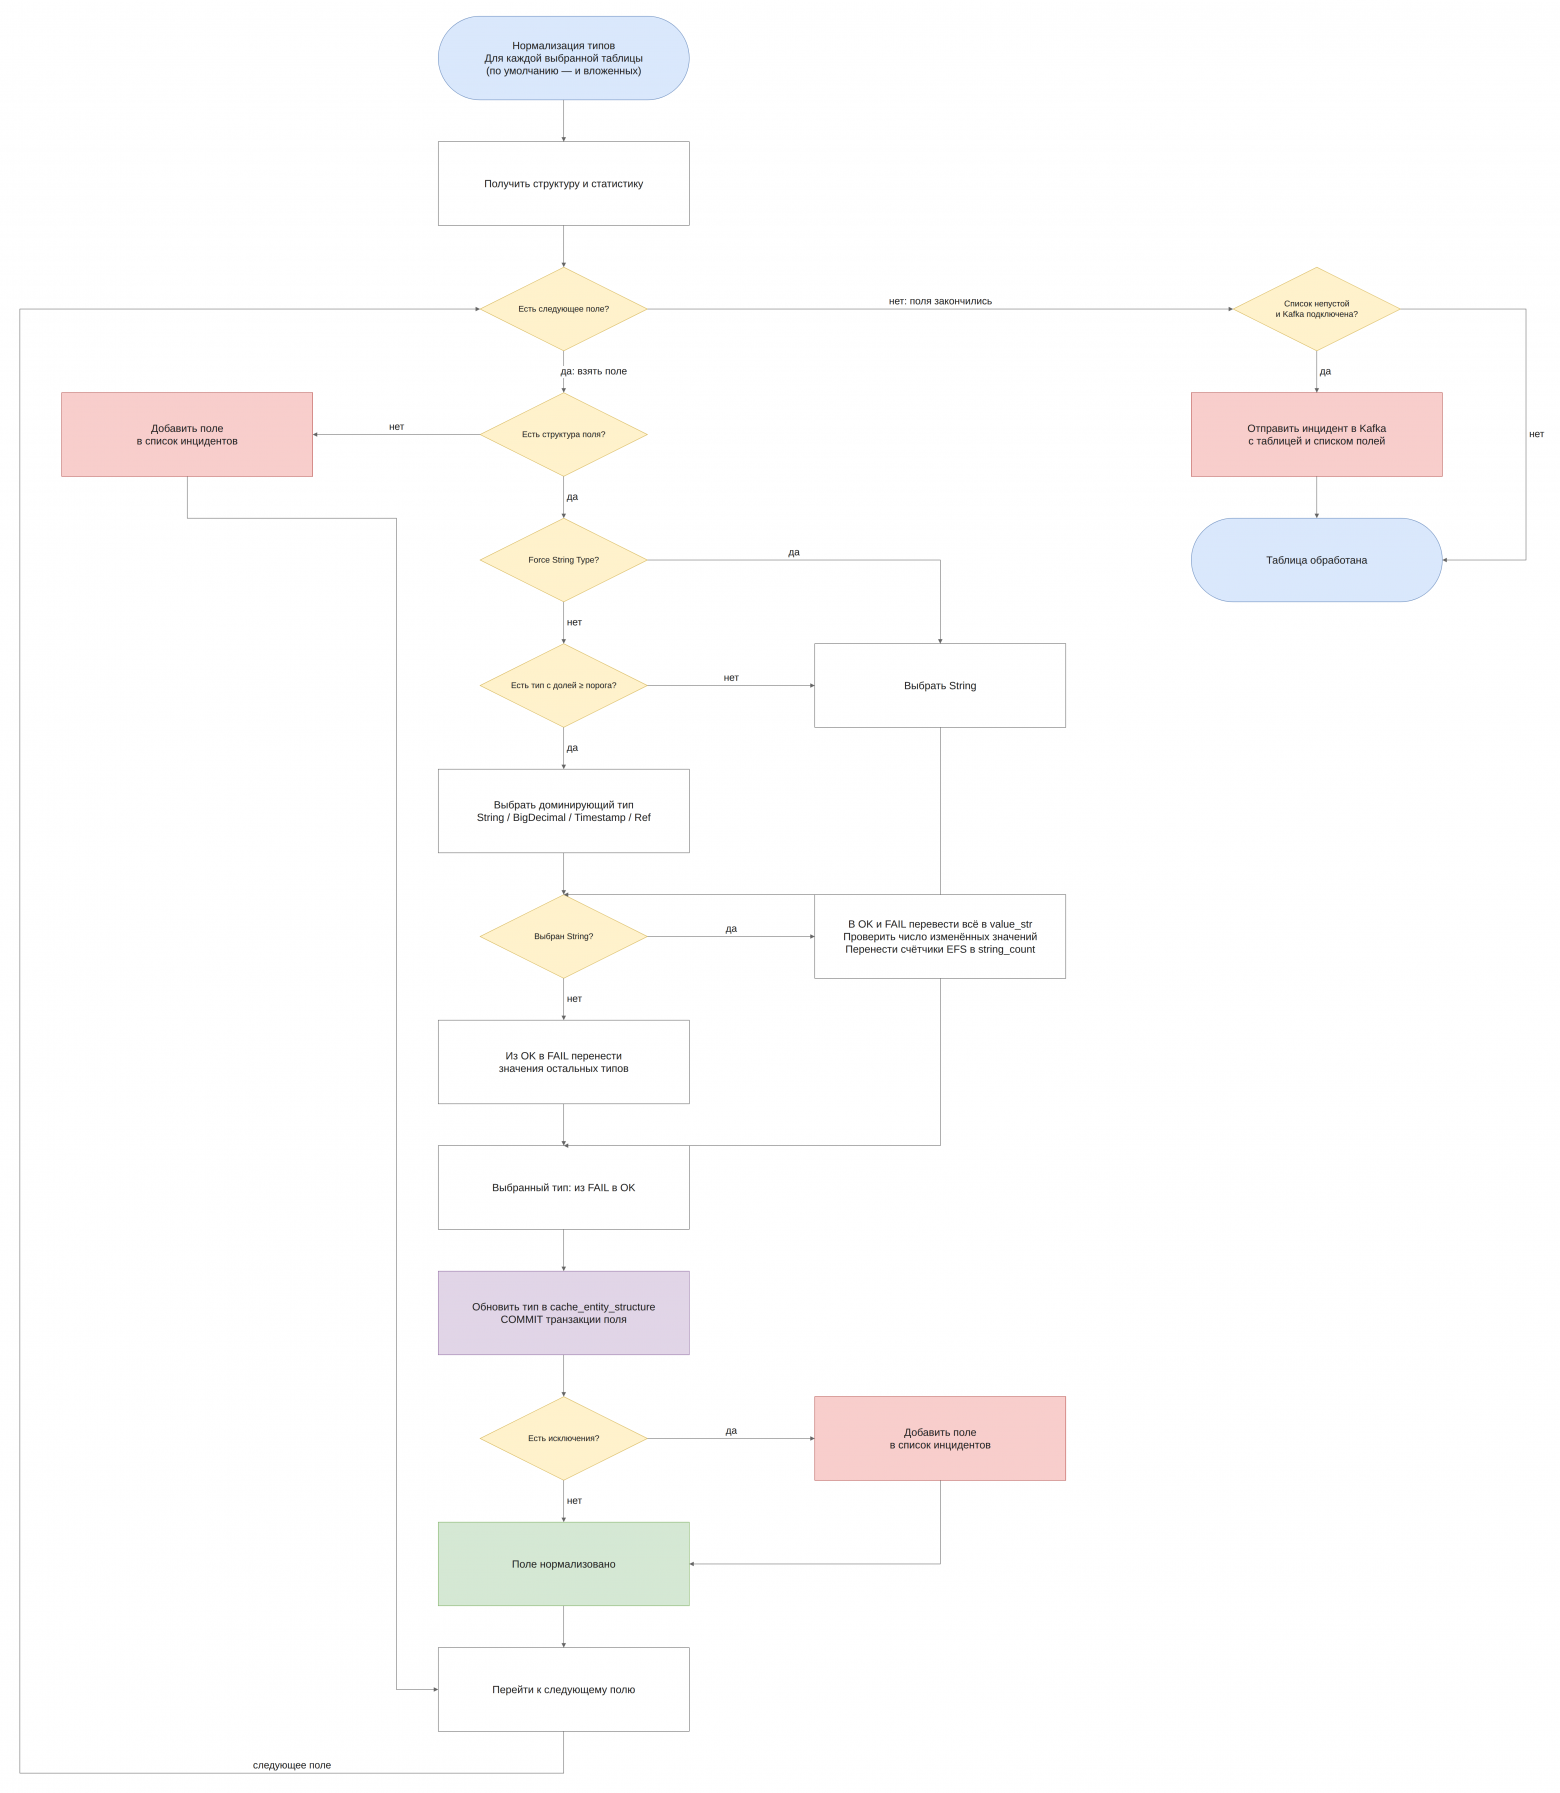
В результате ETL читает через драйвер значения канонического типа. Смешанные поля без доминирующего типа сохраняются строками целиком. Исключения у полей с доминирующим нестроковым типом драйвер не читает — они остаются в партиции FAIL, их можно посмотреть напрямую, например в DBeaver, и они попадают в список инцидентов.
Во что превращается запрос драйвера
Начнём с простого чтения одной колонки без фильтрации, сортировки и соединений:
SELECT "s_Номер" AS "Номер"
FROM "sale#shop_a#202609" s
LIMIT 100;
Для такого запроса драйвер сначала собирает значения по entity_guid, а затем присоединяет их к записям сущностей. В PostgreSQL получается такой SQL:
SELECT "S"."S_НОМЕР" AS "Номер"
FROM (
    SELECT
        ea."S_НОМЕР",
        e.guid AS "S_ENTITY_GUID",
        e.period_id AS "S_PERIOD_ID",
        e.load_dt AS "S_LOAD_DT",
        e."$parent" AS "S_PARENT_GUID",
        e.resource_name AS "S_RESOURCE_NAME"
    FROM stg.entity_1041 e
    LEFT JOIN (
        SELECT
            entity_guid,
            min(CASE WHEN field_name = 'Номер'
                THEN value_str END) AS "S_НОМЕР"
        FROM stg.entity_field_value_1042
        GROUP BY entity_guid
    ) ea ON e.guid = ea.entity_guid
) AS "S"
LIMIT 100;
Даже для одной колонки требуется разворот строк EAV. MIN(CASE ...) извлекает номер, а LEFT JOIN сохраняет записи сущностей, у которых этого значения нет: для них колонка будет NULL. Служебные колонки драйвер добавляет во внутреннюю выборку, а наружу возвращает только запрошенный номер.
Теперь — запрос с соединением и фильтрацией.
Допустим, при переносе на DET нам нужно получить строки продаж за сентябрь вместе с номерами документов. Для потребителя это обычное соединение документа с товарными строками:
SELECT "s_Номер" AS "Номер",
       "t_Номенклатура" AS "Номенклатура",
       "t_Количество" AS "Количество"
FROM "sale#shop_a#202609" s
JOIN "sale_Товары#shop_a#202609" t
    ON "s_ENTITY_GUID" = "t_PARENT_GUID"
WHERE "s_Дата" >= '2026-09-01'
ORDER BY "s_Номер"
LIMIT 100;
В PostgreSQL такой запрос разворачивается следующим образом:
SELECT "S"."S_НОМЕР" AS "Номер",
       "T"."T_НОМЕНКЛАТУРА" AS "Номенклатура",
       "T"."T_КОЛИЧЕСТВО"::numeric AS "Количество"
FROM (
    SELECT
        min(CASE WHEN efv1.field_name = 'Номер'
            THEN efv1.value_str END) AS "S_НОМЕР",
        min(CASE WHEN efv1.field_name = 'Дата'
            THEN efv1.value_dt END) AS "S_ДАТА",
        e.guid AS "S_ENTITY_GUID",
        e.period_id AS "S_PERIOD_ID",
        e.load_dt AS "S_LOAD_DT",
        e."$parent" AS "S_PARENT_GUID",
        e.resource_name AS "S_RESOURCE_NAME"
    FROM stg.entity_1041 e
    LEFT JOIN stg.entity_field_value_1042 efv1
        ON e.guid = efv1.entity_guid
    GROUP BY e.code, e.guid, e.period_id, e.load_dt,
             e."$parent", e.resource_name
) AS "S"
JOIN (
    SELECT
        min(CASE WHEN efv2.field_name = 'Номенклатура'
            THEN efv2.ref_value::text END) AS "T_НОМЕНКЛАТУРА",
        min(CASE WHEN efv2.field_name = 'Количество'
            THEN efv2.value_int END) AS "T_КОЛИЧЕСТВО",
        e.guid AS "T_ENTITY_GUID",
        e.period_id AS "T_PERIOD_ID",
        e.load_dt AS "T_LOAD_DT",
        e."$parent" AS "T_PARENT_GUID",
        e.resource_name AS "T_RESOURCE_NAME"
    FROM stg.entity_1051 e
    LEFT JOIN stg.entity_field_value_1052 efv2
        ON e.guid = efv2.entity_guid
    GROUP BY e.code, e.guid, e.period_id, e.load_dt,
             e."$parent", e.resource_name
) AS "T"
    ON "S"."S_ENTITY_GUID" = "T"."T_PARENT_GUID"
WHERE "S"."S_ДАТА"::timestamp >= TIMESTAMP '2026-09-01 00:00:00'
ORDER BY "S"."S_НОМЕР"
LIMIT 100;
Внутренние GROUP BY собирают по одной строке на UUID сущности. MIN(CASE ...) достаёт нужное поле из множества строк EAV: это техническая сборка записи. LEFT JOIN сохраняет и сущности без значений нужных полей. Затем внешний запрос соединяет документы с товарными строками, применяет условие по дате, сортирует результат и ограничивает число строк.
Типы здесь определяют и выбор колонки, и операции над результатом: номер берётся из value_str, дата — из value_dt, количество — из value_int, ссылка на номенклатуру — из ref_value. Числа и даты физически хранятся строками, поэтому драйвер добавляет приведения для типизированных операций. Если после нормализации Количество стало строковым полем, изменится и SQL, который нужно построить для этой колонки.
В отличие от первого примера, здесь значения присоединяются к сущностям до технической группировки. Драйвер собирает каждую сторону соединения отдельно, после чего соединяет получившиеся широкие таблицы.
Почему EAV, а не JSONB
В этом разделе — почему мы выбрали EAV, а не JSONB или хранение в нереляционной базе.
В пользу JSONB стоит отметить, что PostgreSQL умеет работать с ним через SQL и индексировать его содержимое. Но мы работаем не только с документами целиком: после загрузки нужно проверить типы, нормализовать значения и разобраться с отклонениями. Всё это мы делаем по одному полю сразу во всей выгрузке — под такую работу EAV удобнее.
Мы не ограничиваемся одной лишь загрузкой. Если бы STG только хранил данные из внешних источников в первозданном виде, выбор пал бы на JSONB или NoSQL. Но у нас задача другая: с загруженными данными нужно работать — проверять, нормализовать, отбирать. Для этого EAV удобнее.
Проблемные значения не прячутся. После загрузки мы уже получаем данные, разложенные по типам: у пользователя нет необходимости копаться в JSON и гадать, строка это или число. У него есть драйвер и есть FAIL-партиция — ещё до нормализации он может наглядно посмотреть, каков характер загруженных данных.
Цена нормализации. В нашей системе единица обработки нормализации — поле. EAV-структура позволяет нам обрабатывать конкретные поля, не меняя сам документ. Аналогичная операция с JSONB в PostgreSQL требовала бы перезаписи всего затронутого документа. Если в документах по сто и более полей, а преобразовать нужно только одно-два, вместе с ними приходится переписывать остальные данные. На миллионах записей это может заметно увеличить стоимость нормализации.
Что у нас болит
Главная боль — время выполнения сложных запросов. При переносе на DET потребителю нужен набор строк с полями, а в STG каждое значение лежит отдельно. Поэтому прежде чем выполнить привычный запрос к продажам и товарным строкам, PostgreSQL должен собрать обе стороны соединения из EAV.
В запросе выше к каждой партиции сущностей присоединяется партиция значений, после чего результат группируется. На одну запись источника приходится несколько строк значений. Если в документе сто непустых скалярных полей, физически это сто строк EAV вместо одной строки документа.
Когда нужны только несколько колонок одной таблицы, форма запроса ещё сравнительно проста. При соединении нескольких сущностей приходится собирать каждую из них. Да, обновление статистики после загрузки помогает планировщику выбирать план, но не устраняет саму необходимость разворачивать EAV.
На практике запросы упираются в конкретные партиции, так что объём сканирования ограничен, но соединения нескольких крупных таблиц всё ещё работают небыстро.
Драйвер избавляет потребителя от ручного SQL по EAV, но вычислительную стоимость этого SQL несёт PostgreSQL.
Помимо производительности, остаются ограничения обработки данных.
Тип поля решает первое значение. Если первым пришло кривое значение, все нормальные значения этого поля уедут в FAIL. Решается нормализацией, но алгоритм определения типа можно улучшить. Вопрос временных затрат.
Типы сравниваются слишком строго. Решает содержимое значения: если поле объявлено строковым, а пришедшее значение похоже на число («123»), детектор считает, что это число, и запись уходит в FAIL, хотя строкой её можно было спокойно сохранить.
Не всё раскладывается. Из массива в EAV попадают только объекты. Два случая отбрасываются целиком, вместе со всем содержимым: скалярные массивы, например «Теги»: ["a", "b"], и вложенные массивы объектов, например [[…], […]], — даже если внутри лежат объекты. Эти значения остаются только в source_json. При этом партиция под sale_Теги создаётся всё равно, и в каталоге появляется пустая таблица. То же с null и пустыми строками: по значениям их не отличить от поля, которого не было.
Наследство. Несколько колонок в entity и entity_field_value остались от прошлых версий: одни не заполняются, другие заполняются, но никем не читаются.
Распределение типов не задаёт бизнес-смысл. Если 99% кодов выглядят как числа, порог большинства не подскажет, что ведущие нули значимы и поле должно быть строковым. Для таких полей тип лучше задавать при загрузке явно. Если вся выгрузка должна оставаться текстовой, у нормализатора есть принудительный режим String.
На уровне значений мы ничего не теряем молча: каждое значение лежит либо в OK, либо в FAIL, либо в исходном JSON. Честная цена: то, что попало только в source_json, а также значения из FAIL, через драйвер не читаются — их видно, только заглянув в таблицы напрямую.
Что стоило бы поменять
Улучшить алгоритм определения типа поля — ориентироваться хотя бы на батч загрузок, а не на первую встреченную запись.
Убрать наследственные колонки, которые не используются: они остались в
entityиentity_field_valueот прошлых версий.Смягчить сравнение типов: значение, допустимое для заявленного типа поля, не должно уходить в FAIL.
Дать способ видеть FAIL-значения не только напрямую в DBeaver, но и через штатный путь чтения.
Вместо заключения
Для нашего STG EAV оказался удобен там, где нужно принять неизвестную заранее структуру, определить типы полей, отделить конфликтующие значения и подготовить данные к загрузке в DET. Связи дочерних объектов и JDBC-драйвер позволяют ETL-процессам работать с этими данными как с обычными таблицами.
При этом цена решения видна именно в чтении. Потребителю доступен обычный SQL, но за ним стоит обратная сборка строк EAV, а на сложных соединениях и агрегатах она становится дорогой. Мы не считаем EAV универсальной заменой JSONB: если бы задача сводилась к сохранению и чтению документов целиком, аргументов в пользу JSONB было бы больше. У нас EAV держится на том, что каждое поле отдельно проходит проверку качества, а производительность запросов остаётся главным компромиссом.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.