英語以外の言語を使うとAIモデルのコストは高くなる
大手企業のAIはたいていの場合、主に英語のデータセットを中心に学習しています。新たな研究で、英語であれば適切に処理できるAIが、データが少ない少数言語を処理するときにコストが高くなってしまう可能性があることが示されました。
The Tokenizer Tax | CLEAR
https://clear-languages.org/blog/the-tokenizer-tax
昨今の生成AIの基盤となる大規模言語モデル(LLM)は、トークナイザーと呼ばれる処理により、文章を単語ごとや文字ごと、場合によってはバイト単位に分割して「トークン」と呼ばれる塊として扱います。大抵の有料型AIはこのトークンの数に応じて料金を課しています。
AI研究機関のCLEARによると、優れたトークナイザーは文章を効率的にトークン化できますが、データが少ない言語は余計に小さく分割してしまい、その結果トークン数が増加してコストが高くなってしまう可能性があるそうです。
CLEARは、「People should benefit from AI, regardless of the language they speak.(人々は、話す言語に関係なく、AIの恩恵を受けるべきである。)」という文章を例に説明しています。
この文章を、インドで使われるマラヤーラム語とエチオピアで使われるアムハラ語で表現すると以下のようになります。
・マラヤーラム語:ആളുകൾ ഏത് ഭാഷ സംസാരിക്കുന്നവരായാലും, AI-യിൽ നിന്ന് പ്രയോജനം നേടണം.
・アムハラ語:ሰዎች የሚናገሩት ቋንቋ ምንም ይሁን ምን ከ AI ተጠቃሚ መሆን አለባቸው።
そして、英語、マラヤーラム語、アムハラ語の文章をトークンに分割すると以下の通り。英語の文章は単語ごとにトークン化されますが、マルチバイト文字のマラヤーラム語は1つの単語が複数の断片に分割されているとのことです。また、アムハラ語の文字は単純に2バイトごとに分割されました。画像では「?」で表示され、レンダリングできていません。
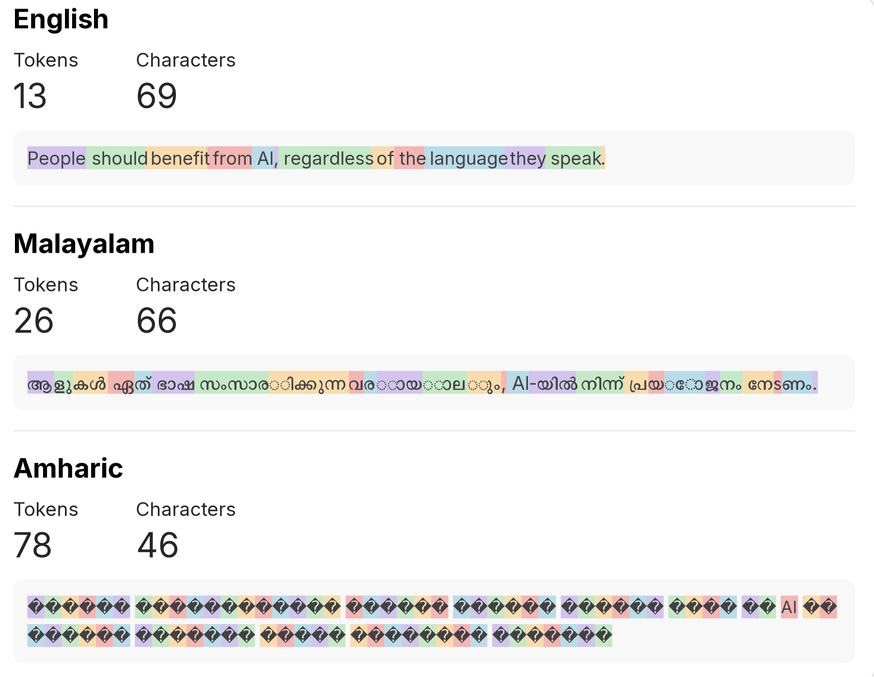
トークン数で見ると、同じ文章なのに英語は13、マラヤーラム語は26、そしてアムハラ語は78となり、アムハラ語は英語の6倍ものコストがかかってしまうことになります。
そもそも冗長な表現が多い言語もありますが、CLEARが参照したデータセットの中で最も冗長なミャンマーのシャン語でも、文字数で見ると英語より42%長いだけでした。CLEARは「冗長性だけで、トークン数が6倍にもなるのは説明できない」としています。
CLEARによると、インターネット上での使用割合が多いトップ20の言語の最小/最大トークン比率はほとんど1.5倍から3.1倍の間に収まっているものの、それ以外では差異が大きくなり、最大で17倍まで幅が広がることがあるそうです。
CLEARはこうした格差を「トークナイザー税」と称し、「トークナイザー税の影響で、特定の言語は長文を処理するユースケースが実現不可能となります。こうした不公平さは、コンピューティング能力や接続性が既に制限されている環境で特に深刻となり、AI経済への参加を阻む制約となっています」とまとめました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.