Меньше индексов, дешевле запись: как я научил PostgreSQL пересекать B-tree индексы с сохранением порядка
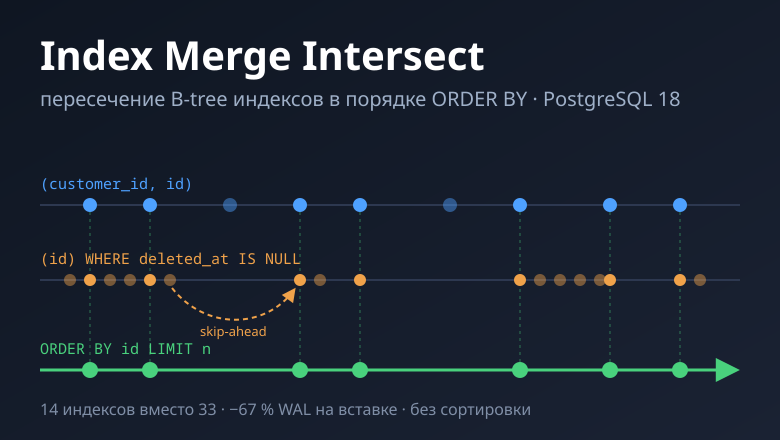
Коротко. Это расширение для PostgreSQL 18, postgresql-leapfrog. Оно добавляет в планировщик узел Index Merge Intersect: упорядоченное пересечение нескольких обычных B-tree индексов, которое останавливается на LIMIT. Идея в том, чтобы таблице не требовался отдельный составной индекс под каждую комбинацию фильтров. На моих замерах это 14 индексов вместо 33 и втрое меньше WAL на вставке.
Сразу о главном: я не пишу на C. Идея, постановка задачи, требования к поведению и проверкам мои, а код написал ИИ-агент (Claude Code) под моим руководством. Я задавал, что должно получиться, требовал тесты на каждое изменение и сравнение с обычными планами PostgreSQL, гонял сборку с assert'ами и отдавал код на ревью. Но оценить сам C-код так, как это сделает человек, знающий внутренности PostgreSQL, я не могу.
Это версия 0.0.3, эксперимент. Расширение вмешивается в планировщик и исполнитель, а ошибка там означает неверные результаты запросов. Поэтому я пишу не чтобы рекламировать, а чтобы попросить ревью: кода, подхода, методики замеров. Ниже описано, как всё устроено, и отдельный раздел «Где я не уверен» о местах, в которых я сомневаюсь сам.
Проблема: один индекс на каждую форму запроса
Типичная таблица приложения: несколько колонок-фильтров, мягкое удаление и постраничный вывод по id.
SELECT * FROM orders
WHERE customer_id = $1 AND deleted_at IS NULL
ORDER BY id DESC LIMIT 100;
Чтобы такой запрос был быстрым в обычном PostgreSQL, нужен индекс ровно под него: (customer_id, id) WHERE deleted_at IS NULL. Потом такой же с WHERE deleted_at IS NOT NULL для корзины. Потом та же пара для product_id, для warehouse_id. Потом составные индексы для фильтров, которые запрашивают вместе. Схема растёт по одному индексу на каждую «форму» запроса.
Каждый индекс занимает диск и место в buffer cache. Каждый INSERT и каждый не-HOT UPDATE пишет во все индексы и в WAL.
Можно обойтись общими индексами: по одному (filter_column, id) на фильтр и два частичных (id) на всю таблицу, для живых и удалённых строк. Их меньше, и они компактнее. Проблема в том, что обычный PostgreSQL не умеет соединить два таких индекса и сохранить порядок по id:
Index Scan использует один индекс, а остальные условия проверяет на каждой строке heap. Если совпадений мало, он прочитает тысячи лишних строк.
BitmapAnd пересекает индексы, но читает их целиком, теряет порядок и потом сортирует.
LIMIT 100его не спасает.
Не хватает узла, который читает оба индекса синхронно в порядке id, ходит в heap только за строками, прошедшими все условия, и останавливается, как только набрал LIMIT. В MySQL похожее есть давно (index merge intersection). В PostgreSQL я такого не нашёл и решил попробовать сделать. Если такое уже есть и я изобретаю велосипед, буду рад ссылке.
Как это выглядит
Миллион заказов, 200 покупателей. Недавние заказы живые, каждый пятый из старых 400 000 удалён. Индексы общие, ни одного специального под запрос:
CREATE INDEX idx_orders_customer_id ON orders (customer_id, id);
CREATE INDEX idx_orders_active_id   ON orders (id) WHERE deleted_at IS NULL;
CREATE INDEX idx_orders_deleted_id  ON orders (id) WHERE deleted_at IS NOT NULL;
Запрос «последние 100 удалённых заказов покупателя»:
SET random_page_cost = 1.1;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT * FROM orders
WHERE customer_id = 100 AND deleted_at IS NOT NULL
ORDER BY id DESC LIMIT 100;
Limit (actual time=0.092..1.882 rows=100.00 loops=1)
Buffers: shared hit=166
-> Custom Scan (Index Merge Intersect) on orders (actual time=0.091..1.866 rows=100.00 loops=1)
Outer Index: idx_orders_customer_id
Inner Index: idx_orders_deleted_id
Outer Entries Read: 585
Inner Entries Read: 20131
Matched TIDs: 100
Heap Fetches: 100
Peak Group Memory: 96 B
Skips: 4
Short Skips: 3
Buffers: shared hit=166
Execution Time: 1.907 msИз heap прочитаны ровно те 100 строк, которые вернулись. Для сравнения, все четыре плана этого запроса (тёплый кэш, ноутбук):
План | Время | Буферы | Строк из heap | Сортировка |
|---|---|---|---|---|
Index Merge Intersect | 1.9 ms | 166 | 100 | нет |
Index Scan по | 4.3–8.1 ms | 1 957 | 20 304 | нет |
Index Scan по | 2.5 ms | 3 133 | 3 554 | нет |
BitmapAnd + Bitmap Heap Scan | 10.8 ms | 621 | 393 | top-N |
BitmapAnd прочитал все 80 120 записей частичного индекса, достал 393 строки и отсортировал их, хотя нужно было 100. Планировщик выбирает новый узел сам, без хинтов, причём и при random_page_cost = 1.1, и при значении по умолчанию 4.
Пример детерминированный и прогоняется как регрессионный тест leapfrog_example. Счётчики выше вы получите точно такие же.
Как это работает
Планировщик
Расширение ставит set_rel_pathlist_hook и для каждой базовой таблицы запроса ищет наборы индексов, которые можно пересечь. Каждый индекс в наборе называется потоком (stream):
outer, внешний поток: B-tree
(k1, …, kN, sortcol), где каждаяkIсравнивается на равенство со значением, известным на старте сканирования (константа, параметр, колонка внешней таблицы, неволатильное выражение от них), а последняя колонка совпадает с первым ключомORDER BY;inner, внутренние потоки:
(j1, …, jM, sortcol, …)с равенствами на всехjI. ПриM = 0это частичный индекс, предикат которого следует из запроса, например(id) WHERE deleted_at IS NULL.
Когда все колонки перед sortcol зафиксированы равенствами, каждый индекс отдаёт записи в порядке sortcol. Это и делает возможным слияние без сортировки.
Каждый поток должен добавлять ограничение, которого нет у остальных. (customer_id, id) и (customer_id, id) WHERE deleted_at IS NULL набор не образуют: частичный индекс сам покрывает оба условия, и пересекать тут нечего. Импликация проверяется штатным predicate_implied_by.
Перебор устроен жадно. Сначала оцениваются все пары внешний + внутренний поток. От самой дешёвой пары добавляется по одному потоку, тот, который сильнее всего снижает оценку стоимости, пока такой находится и позволяет leapfrog.max_indexes (по умолчанию 4). Каждый набор становится отдельным CustomPath со своей стоимостью, а дальше PostgreSQL как обычно выбирает между ними и штатными планами. Третий индекс попадает в план, только если прочитать его дешевле, чем отфильтровать лишние строки из heap. Иначе его условие становится обычным Filter.
Исполнитель: leapfrog
Название взято из алгоритма leapfrog join. Все потоки читаются в направлении ORDER BY. Поток, который отстал, догоняет самое большое текущее значение среди потоков. Когда значения у всех совпали, строка-кандидат найдена.
Два момента, на которых всё держится:
Skip-ahead. Если поток прочитал 64 записи подряд и так и не догнал остальных, он перестаёт читать промежуток и заново спускается по B-tree прямо к нужному значению (index_rescan с sortcol >= value). Порог адаптивный и свой у каждого потока. Если прыжок приземлился на ту же или соседнюю листовую страницу, он не окупил спуск, и порог удваивается (до 64×). Длинный прыжок возвращает порог вниз. Кластеризованные промежутки так перепрыгиваются рано, а равномерно разбросанные совпадения читаются подряд.
На миллионе строк с кластерами совпадений раз в 100 000 записей это 24 буфера вместо 1 922 без пропусков. На равномерных совпадениях адаптивный порог не хуже чтения подряд (5 571 против 5 562), а фиксированный маленький порог там проигрывал (7 702).
Сопоставление по TID. Когда значения совпали, записи сравниваются по физическому адресу строки (heap TID), а не просто по sortcol. Записи каждого внутреннего потока с этим значением собираются в отсортированную группу, а записи внешнего потока ищутся в группах. Так слияние остаётся корректным и при неуникальном sortcol, и при мёртвых версиях строк, которые ещё лежат в индексах. Это адаптация RowIDIntersectionIterator из MySQL к nbtree.
Группы вместе ограничены work_mem. Если группа не помещается, она сбрасывается: для такого значения строки внешнего потока достаются из heap, и условия потока проверяются прямо на строке. Результат тот же, просто дороже.
Строка достаётся через index_fetch_heap с проходом по HOT-цепочке, как в обычном index_getnext_slot. Под EvalPlanQual (конкурентный UPDATE в READ COMMITTED, FOR UPDATE) узел перепроверяет условия всех потоков на новой версии строки, так же как Index Scan перепроверяет indexqualorig.
Модель стоимости
Структура взята из MySQL (ROR_intersect_plan::add), а все компоненты считаются штатными функциями PostgreSQL. Учитываются чтение записей с учётом пропусков, сравнения TID в группах, выборка из heap с корреляцией как у Index Scan по внешнему индексу и спуски по B-tree.
Есть одна деталь, без которой оценки были бы сильно хуже. Если в условиях константы, планировщик на этапе планирования читает реальные минимальное и максимальное значение sortcol каждого потока: по одному спуску с каждого конца индекса, как это делает get_actual_variable_range. Совпадения возможны только там, где диапазоны пересекаются, и оценивается только это пересечение. Непересекающиеся диапазоны стоят почти ноль.
Цифры: запись
Главный аргумент за пересечение индексов в записи, а не в чтении. Бенчмарк write_bench.sh: 500 000 строк, 12 колонок-фильтров по 100 значений, мягкое удаление, затем вставка 100 000 строк, обновления и удаления. Две схемы:
S, специализированная. На каждую колонку
(fK, id) WHERE deleted_at IS NULLи(fK, id) WHERE deleted_at IS NOT NULL, плюс составные индексы для частых комбинаций (6 пар, 2 тройки, 1 четвёрка). Всего 33 индекса.G, общая. На каждую колонку
(fK, id), плюс(id) WHERE deleted_at IS NULLи(id) WHERE deleted_at IS NOT NULL. Всего 14 индексов. Читается обычным PostgreSQL (G) или с leapfrog (G+L).
S (33 индекса) | G (14 индексов) | G против S | |
|---|---|---|---|
Размер индексов без PK | 375 MB | 201 MB | −46 % |
| 481 MB | 159 MB | −67 % |
| 4 035 | 23 017 | в 5.7 раза быстрее |
| 291 MB | 73 MB | −75 % |
| 82 MB | 91 MB | +11 % |
| 18 MB | 18 MB | одинаково |
Размер индексов и WAL детерминированы. Строки в секунду на моём ноутбуке гуляют до 2 раз между прогонами, поэтому опираться стоит на WAL.
Мягкое удаление с G пишет чуть больше: не-HOT обновление вставляет запись в 12 полных (fK, id) и в один частичный индекс, а у S в 12 «удалённых» частичных. Остальное в пользу G. При этом S растёт с каждой новой комбинацией фильтров, которую нужно обслуживать, а G не растёт.
Цифры: чтение
Тот же бенчмарк, LIMIT 100, медиана, random_page_cost = 1.1 (данные в памяти):
Запрос | S | G, обычный PostgreSQL | G+L (выбор планировщика, индексов в узле) |
|---|---|---|---|
один фильтр, живые строки | 0.06 ms | 0.06 ms | 0.07 ms |
один фильтр, удалённые | 0.13 ms | 1.35 ms | 0.57 ms (2) |
2 фильтра, в S есть составной | 0.07 ms | 1.48 ms | 0.68 ms (2) |
2 фильтра, в S составного нет | 5.56 ms | 1.48 ms | 0.65 ms (2) |
3 фильтра, в S есть составной | 0.02 ms | 1.49 ms | 0.62 ms (2) |
3 фильтра, в S составного нет | 5.98 ms | 1.48 ms | 0.62 ms (2) |
4 фильтра, в S есть составной | 0.04 ms | 1.43 ms | 0.80 ms (3) |
4 фильтра, в S составного нет | 6.76 ms | 1.59 ms | 0.63 ms (2) |
Как я это читаю:
Специальный индекс по-прежнему самый быстрый для того запроса, под который его создали. Пересечение индексов этого не отменяет: вы отдаёте десятые доли миллисекунды на чтении за меньшее число индексов и дешёвую запись.
Специализированная схема платит 3–7 ms за любую комбинацию, под которую индекса нет. Все комбинации предусмотреть нельзя: их число растёт комбинаторно.
С общими индексами leapfrog отвечает на любую комбинацию из 2–4 фильтров за 0.6–1.0 ms, и узел выбирает сам планировщик. На этих запросах это в 2–3 раза быстрее обычного PostgreSQL на тех же индексах. Это один ноутбук и одна схема данных, так что проверка на других данных была бы очень кстати.
Как проверяется корректность
Расширение, которое подменяет план и может вернуть не те строки, хуже, чем никакое. Поэтому тесты построены вокруг одного правила: результат узла сравнивается с результатом штатного плана на тех же данных, как мультимножества, через EXCEPT ALL в обе стороны. Отдельно проверяется, что узел действительно был в плане (custom scan: t), иначе тест мог бы пройти на fallback-плане.
14 регрессионных наборов: дубликаты
sortcol, мёртвые записи, пропуски, переполнениеwork_mem, типы (uuid,text,varcharсtext-константой,smallintсbigint, домены), параметры и generic plans,LATERAL, наборы из 3–5 индексов.11 изоляционных наборов на конкурентность: EvalPlanQual при изменении колонки равенства,
deleted_atв обе стороны, HOT-обновления,DELETE,FOR UPDATE,REPEATABLE READиSERIALIZABLE,VACUUMс открытым курсором.Сборка PostgreSQL с
--enable-cassert: проверки приведений типов узлов и затирание освобождённой памяти. CI гоняет её на каждый коммит, вместе со сборками под gcc и clang.
Неподдерживаемые случаи должны откатываться на штатный план, а не давать неверный результат. Это главное правило проекта.
Тесты не всё ловят. Ревью уже нашло настоящие ошибки, которые они пропускали. Например, планировщик читал стоимость пути после передачи его в add_path(), а тот может этот путь освободить, то есть был use-after-free. Под leapfrog.force из-за этого выбирался не самый дешёвый набор индексов. Ещё один тест менял random_page_cost у pg_default, а это настройка всего кластера. Обе ошибки исправлены, но раз такие находились, найдутся и другие. Это главная причина, по которой я прошу ревью.
Чего пока нет
Модель стоимости консервативна. На матрице из 192 запросов по миллиону строк планировщик выбирает узел сам в 2 запросах при
random_page_cost = 4и в 5 при 1.1. Заметно медленнее он оказался только в запросах сLIMIT 1, на 0.02–0.09 ms. Ещё в 21–27 запросах узел был бы быстрее больше чем на 15 %, но не выбран. Разбор этих промахов показал, что оценка самого узла сходится с реальностью в пределах нескольких процентов: PostgreSQL слишком дёшево оценивает конкурирующие штатные планы. Он считает, что фильтр распределён поidравномерно. Подкручивать константы узла под бенчмарк я сознательно не стал.Сортировка только по целочисленной колонке:
smallint,integer,bigint,NOT NULL.timestamptz,numericиuuidв качестве ключа сортировки пока не поддерживаются. Колонки равенства могут быть любого типа с B-tree opfamily.Только равенства.
IN (…), диапазоны иIS NULLв условиях потоков не поддерживаются, учитывается только первый ключORDER BY.Одна таблица на узел. Партиционированных таблиц и параллельного выполнения нет.
Только PostgreSQL 18: API планировщика и исполнителя меняется между мажорными версиями.
Бенчмарки сняты на одном ноутбуке с данными в памяти. Прогонов с холодным кэшем ОС и на 10M+ строк пока нет.
Где я не уверен
Здесь чужой взгляд нужнее всего. Код занимает около 3 тысяч строк на C в каталоге src/. Поскольку писал его ИИ, а я C не владею, смотреть стоит на всё, но вот места, где ошибка обойдётся дороже всего или где решения кажутся мне спорными:
Исполнитель,
src/executor.c: корректность под конкурентной нагрузкой. EvalPlanQual, проход по HOT-цепочкам, мёртвые записи в индексах,VACUUM, пока сканирование стоит на листовой странице. Последнее я проверял руками:isolationtesterне видит ожиданий buffer pin. Если вы знаете, как сломать узел конкурентнымUPDATEтак, чтобы он вернул лишнюю или пропустил нужную строку, это самое ценное.Пропуски,
src/indexstream.c: чтобы понять, куда приземлился прыжок, код читает внутреннюю структуру nbtree (BTScanOpaque). Это завязка на внутренности PostgreSQL 18. Есть ли более правильный способ?Планировщик и модель стоимости,
src/planner.cиsrc/costsize.c: правильно ли расширение встраивается черезset_rel_pathlist_hookиCustomPath, нет ли ещё мест, где код держит то, что планировщик может освободить или изменить. Не противоречат ли оценки тому, как PostgreSQL оценивает штатные планы. Чтение реального диапазонаsortcolиз B-tree на этапе планирования, как вget_actual_variable_range: допустимо ли это с точки зрения стоимости планирования и кэширования планов.Методика замеров: один ноутбук, данные в памяти, разброс до 2 раз между прогонами. Подскажите, как мерить правильнее, и особенно интересны прогоны на реальных данных.
Сама идея: может быть, у такого подхода есть принципиальная проблема, которую я не вижу.
Проще всего прислать issue или pull request на GitHub. Комментарии здесь тоже читаю.
Попробовать
Проще всего через Docker: поднимется PostgreSQL 18 с уже загруженной библиотекой.
git clone https://github.com/ibrohim238/postgresql-leapfrog.git
cd postgresql-leapfrog
docker compose up -d --build --wait
psql -h 127.0.0.1 -p 5433 -U postgres -d leapfrog   # пароль: leapfrog
Чтобы увидеть узел там, где планировщик его не выбирает, есть диагностическая настройка:
SET leapfrog.force = on; -- только для экспериментовДля установки на свой сервер нужны заголовки PostgreSQL 18 и shared_preload_libraries = 'leapfrog'. Подробности в README.
Вместо заключения
Идея простая: не плодить индекс под каждую форму запроса, а собирать нужный порядок из общих индексов во время выполнения. На записи выигрыш на моих замерах заметен. На чтении узел быстрее штатных планов на тех же индексах, но планировщик пока редко выбирает его сам.
Это эксперимент человека, который не пишет на C, но хотел проверить идею, и сделан он с помощью ИИ. Поэтому мне важнее узнать, где он ломается, чем услышать, что он работает. Буду благодарен за ревью кода, прогоны на ваших данных и запросы, на которых узел ошибается или проигрывает. Лицензия PostgreSQL License, использовать в production пока не советую.
Репозиторий: https://github.com/ibrohim238/postgresql-leapfrog
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.