確率と統計を視覚的なアニメーションで理解できる「Seeing Theory」
「Seeing Theory」は確率と統計の基本概念をインタラクティブに視覚化し、直感的かつ分かりやすく学べるウェブサイトです。
Seeing Theory
https://seeing-theory.brown.edu/
Seeing Theoryはブラウン大学の学部生であったダニエル・クーニン氏によって作成され、視覚化にはJavaScriptライブラリであるD3.jsが活用されています。
Seeing Theoryは以下の6つの主要な章で構成されており、基礎的な確率論から統計推論・回帰分析までを網羅しています。
・第1章:基礎確率(Basic Probability)
・第2章:複合確率(Compound Probability)
・第3章:確率分布(Probability Distributions)
・第4章:頻度論的推論(Frequentist Inference)
・第5章:ベイズ推定(Bayesian Inference)
・第6章:回帰分析(Regression Analysis)
◆第1章:基礎確率
確率論の根幹をなすチャンスイベント・期待値・分散といった基本的な概念の説明です。
・チャンスイベント
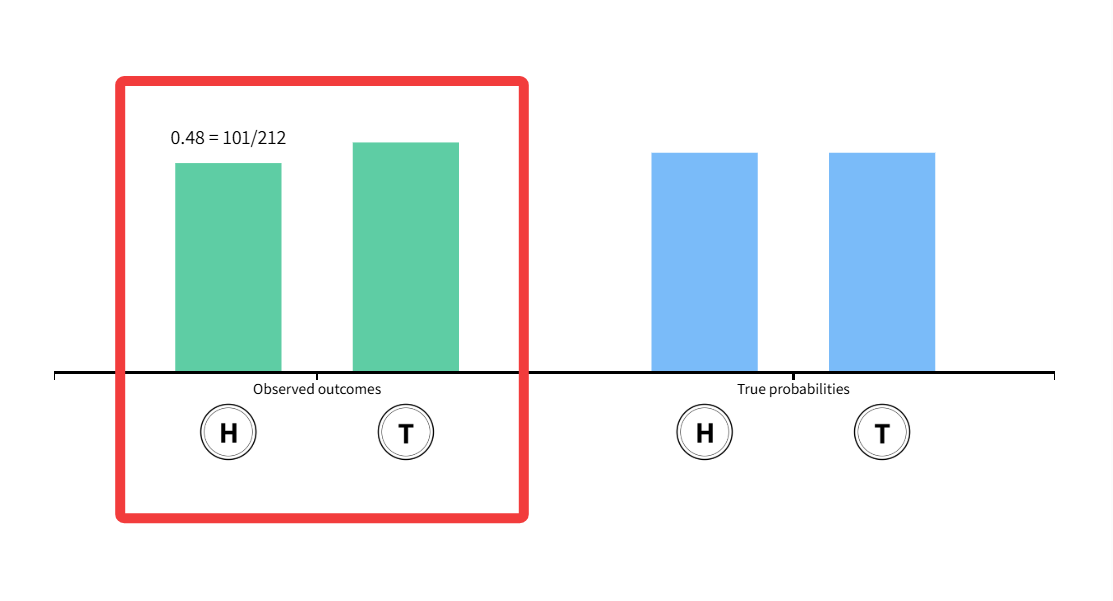
ランダム性はコイン投げのような単純な事象からより複雑な自然現象に至るまで、私たちの生活のあらゆる側面に存在します。典型的な例である公正なコイン投げでは、表と裏が出る確率はそれぞれ1/2ですが、実際の試行では必ずしも厳密に50%になるとは限りません。
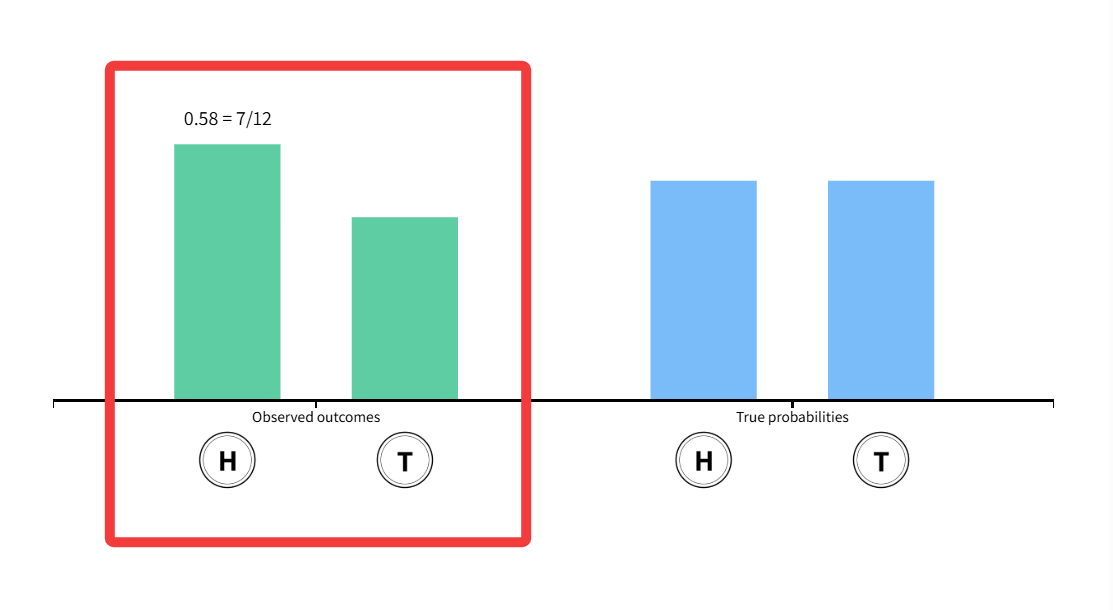
しかし、試行回数を増やすにつれて、その出現頻度は長期的な確率に収束していきます。
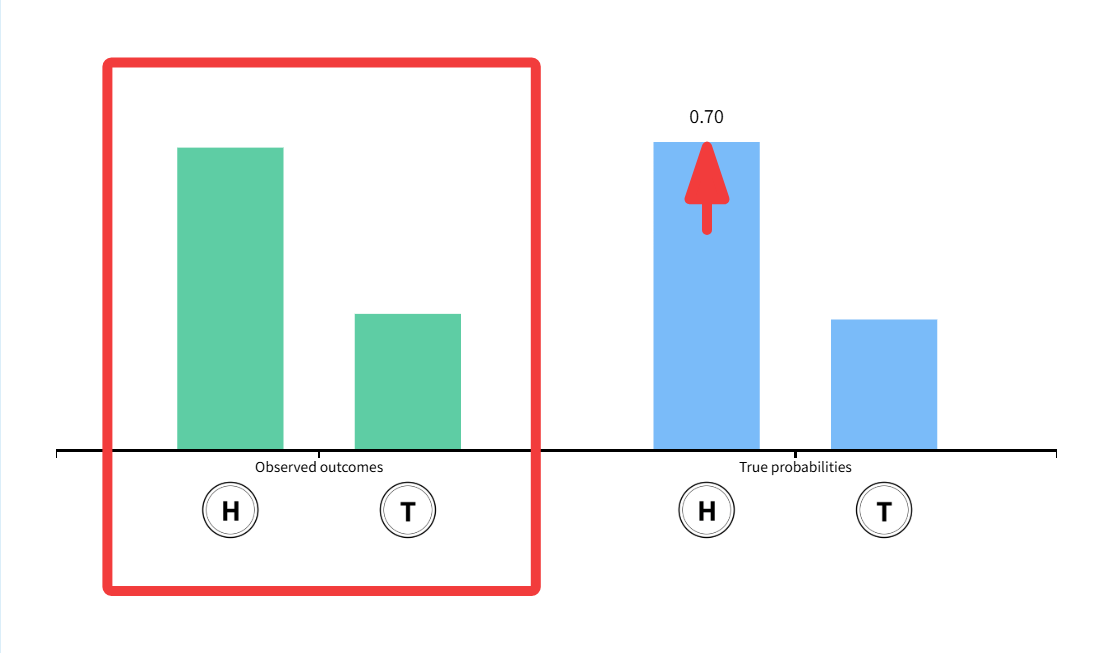
不公平なコインや偏りのあるコインの場合、表と裏が出る確率は等しくなりません。「結果」に「数値」を割り当てる(例えば、表には1、裏には0)ことにより、確率変数と呼ばれる数学的オブジェクトが作成されます。
・期待値
「期待値」は確率変数の分布の中心的な傾向を示す指標であり、多数の独立した試行から得られるサンプルの長期的な平均値として解釈できます。より厳密には、確率変数が取りうるすべての値にそれぞれの確率を掛け合わせた合計として定義され、以下の数式で表されます。
\( \text{E}[X] = \displaystyle \sum_{x \in \mathcal{X}}xP(x) \)
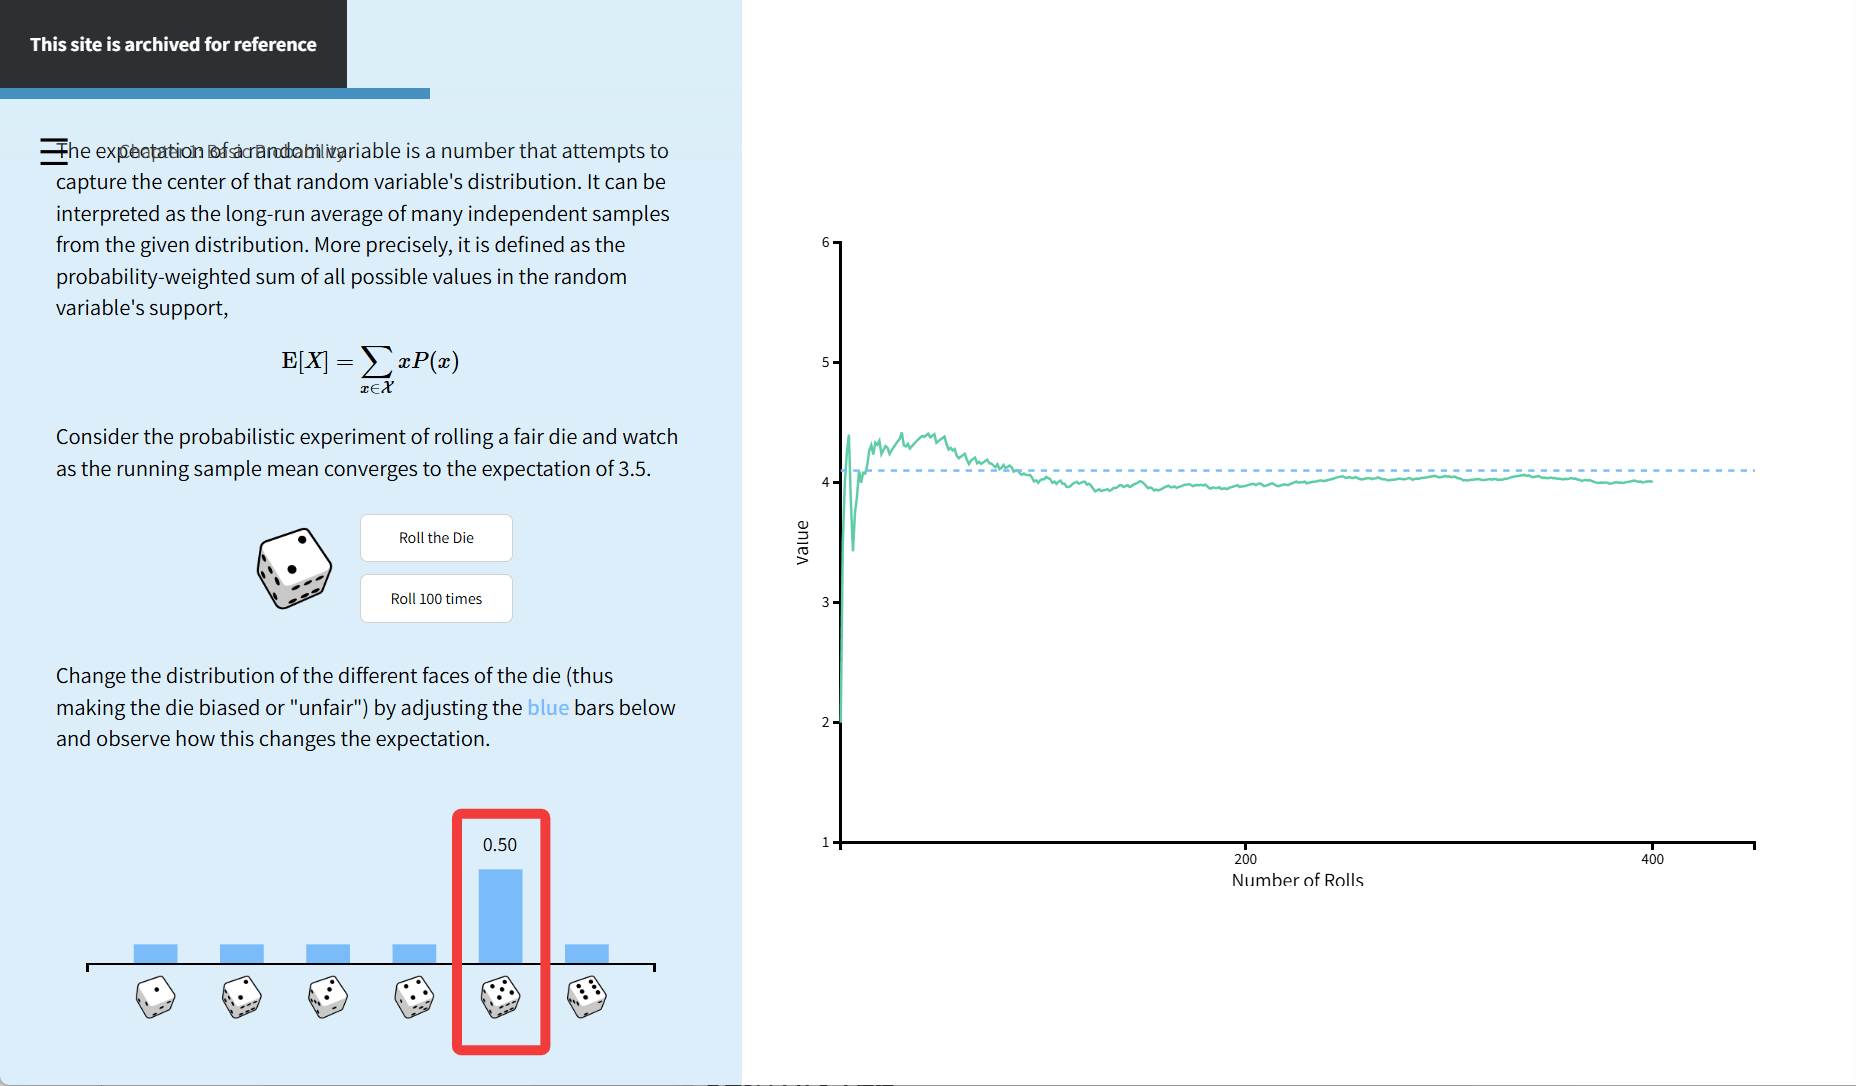
例えば、公正なサイコロを振る場合、その期待値は3.5に収束します。
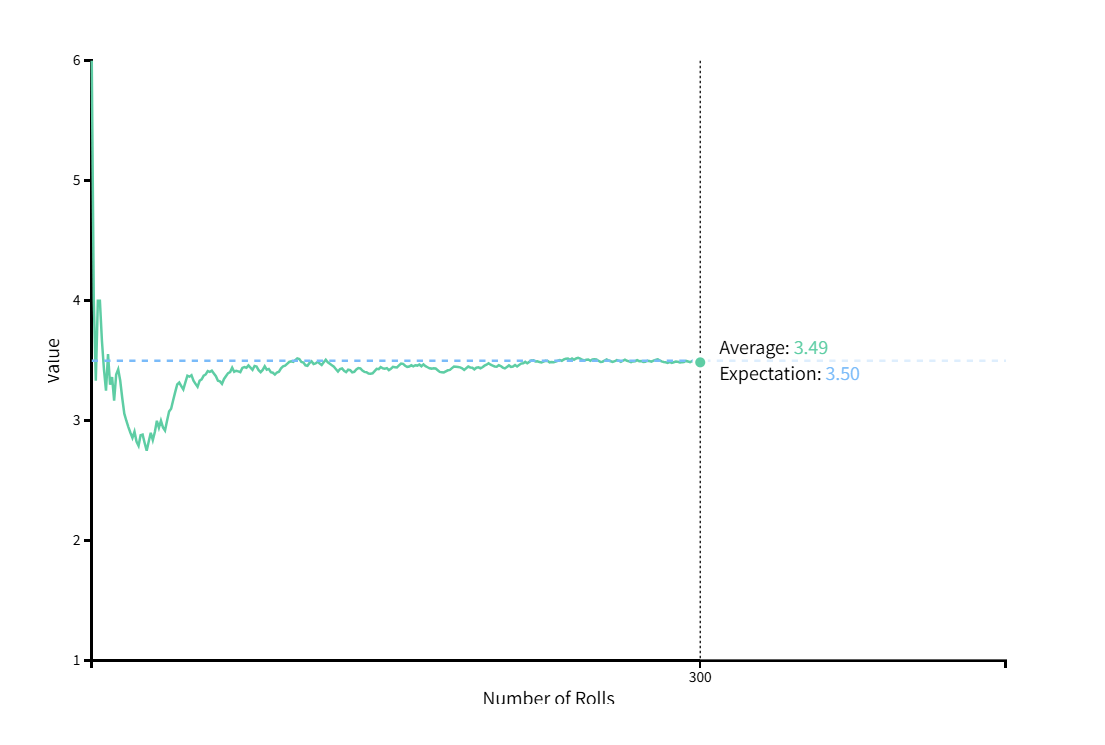
サイコロの出目の確率を調整することで、期待値がどのように変化するかを観察することができます。
・分散
期待値が分布の中心性を示すのに対して「分散」は分布の広がり、つまりデータのばらつき具合を定量化します。分散は確率変数とその期待値との差を二乗した値の平均として定義され、以下の数式で表されます。
\( Var(X) = E[(X - E[X])^2] \)
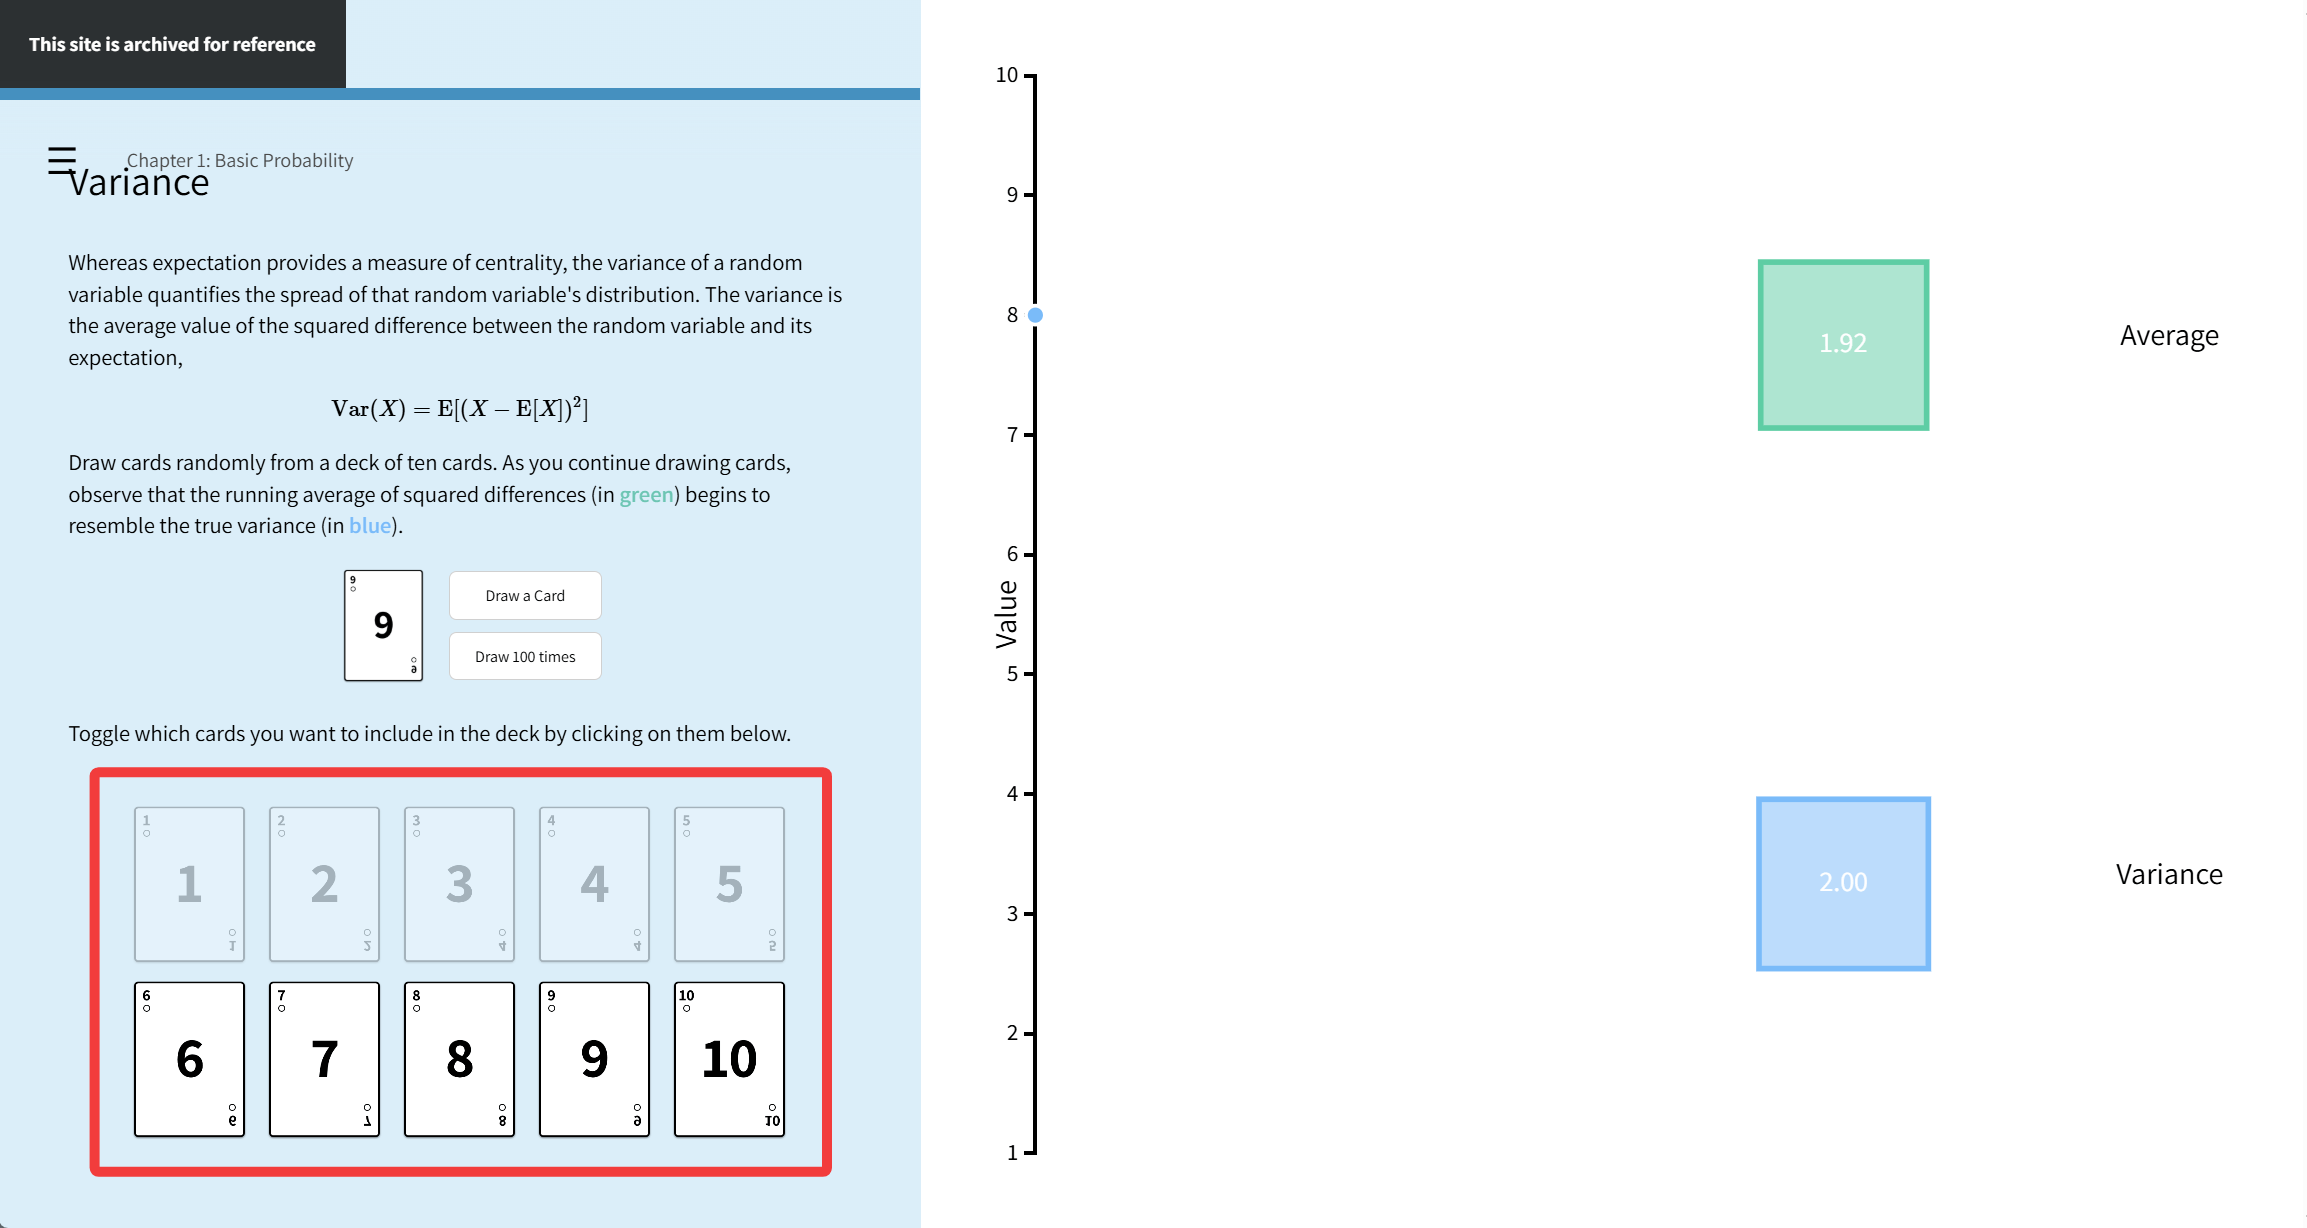
10枚のカードを使った実験では、カードを繰り返し引くにつれて二乗差の実行平均が真の分散に近づいていく様子を観察できます。
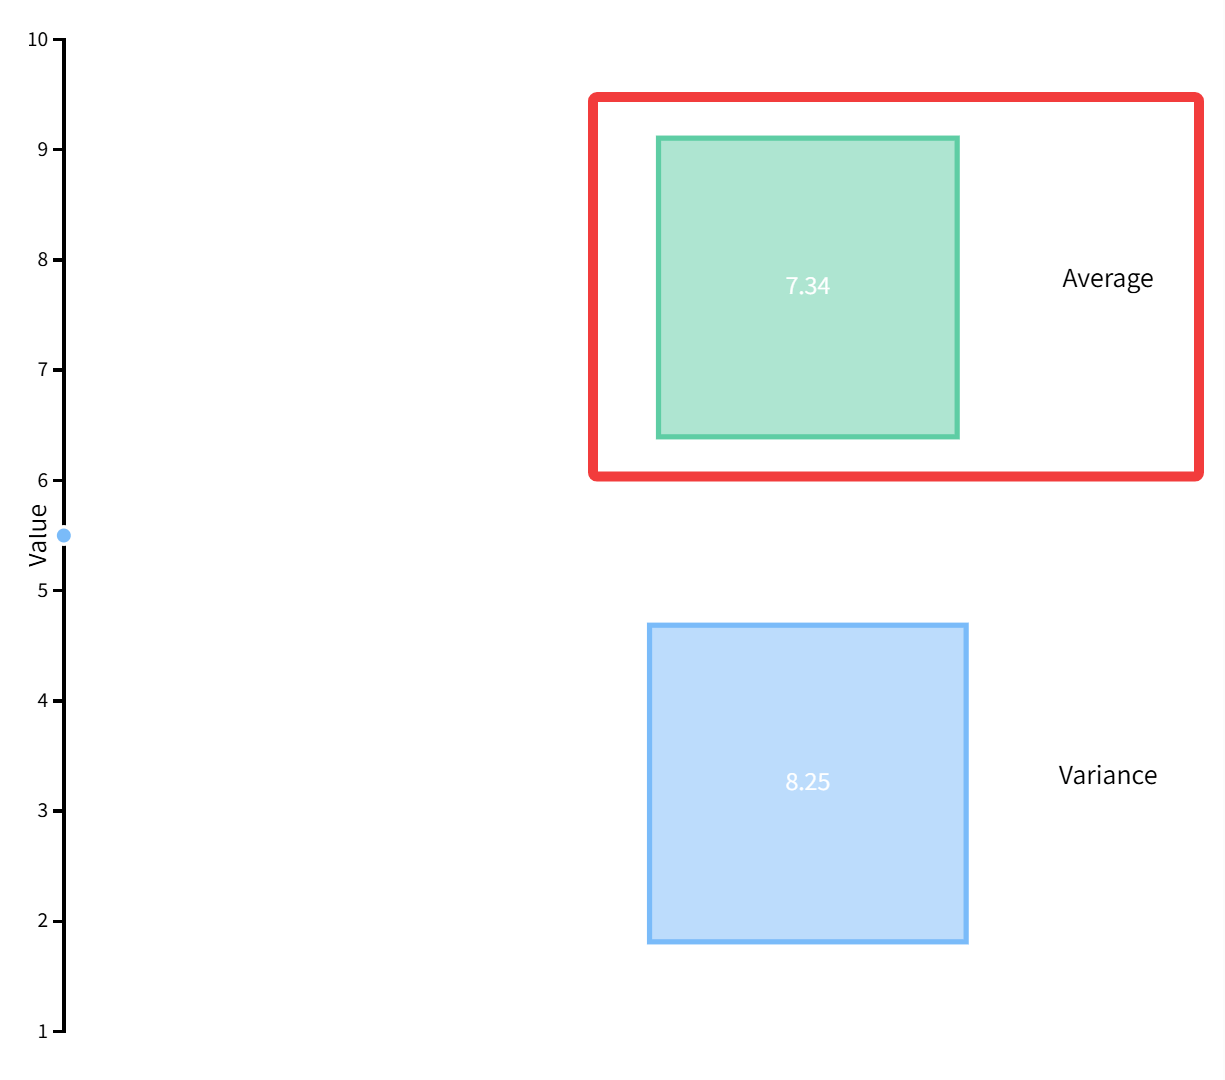
カードの選択を操作することで、デッキの内容が分散に与える影響を具体的に理解することが可能です。
◆第2章:複合確率
確率論における「複合確率」という重要な概念を、集合論・計数・条件付き確率といった3つの主要なトピックに焦点を当てて掘り下げています。
・集合論
「集合」は確率論におけるイベントを表現するための基本的な構成要素です。例えば、「サイコロで偶数を出す」というイベントは集合{2, 4, 6}として表すことができます。この章で提供されるインタラクティブなツールを使用するとユーザーは集合を構築しベン図を用いて視覚化することができます。
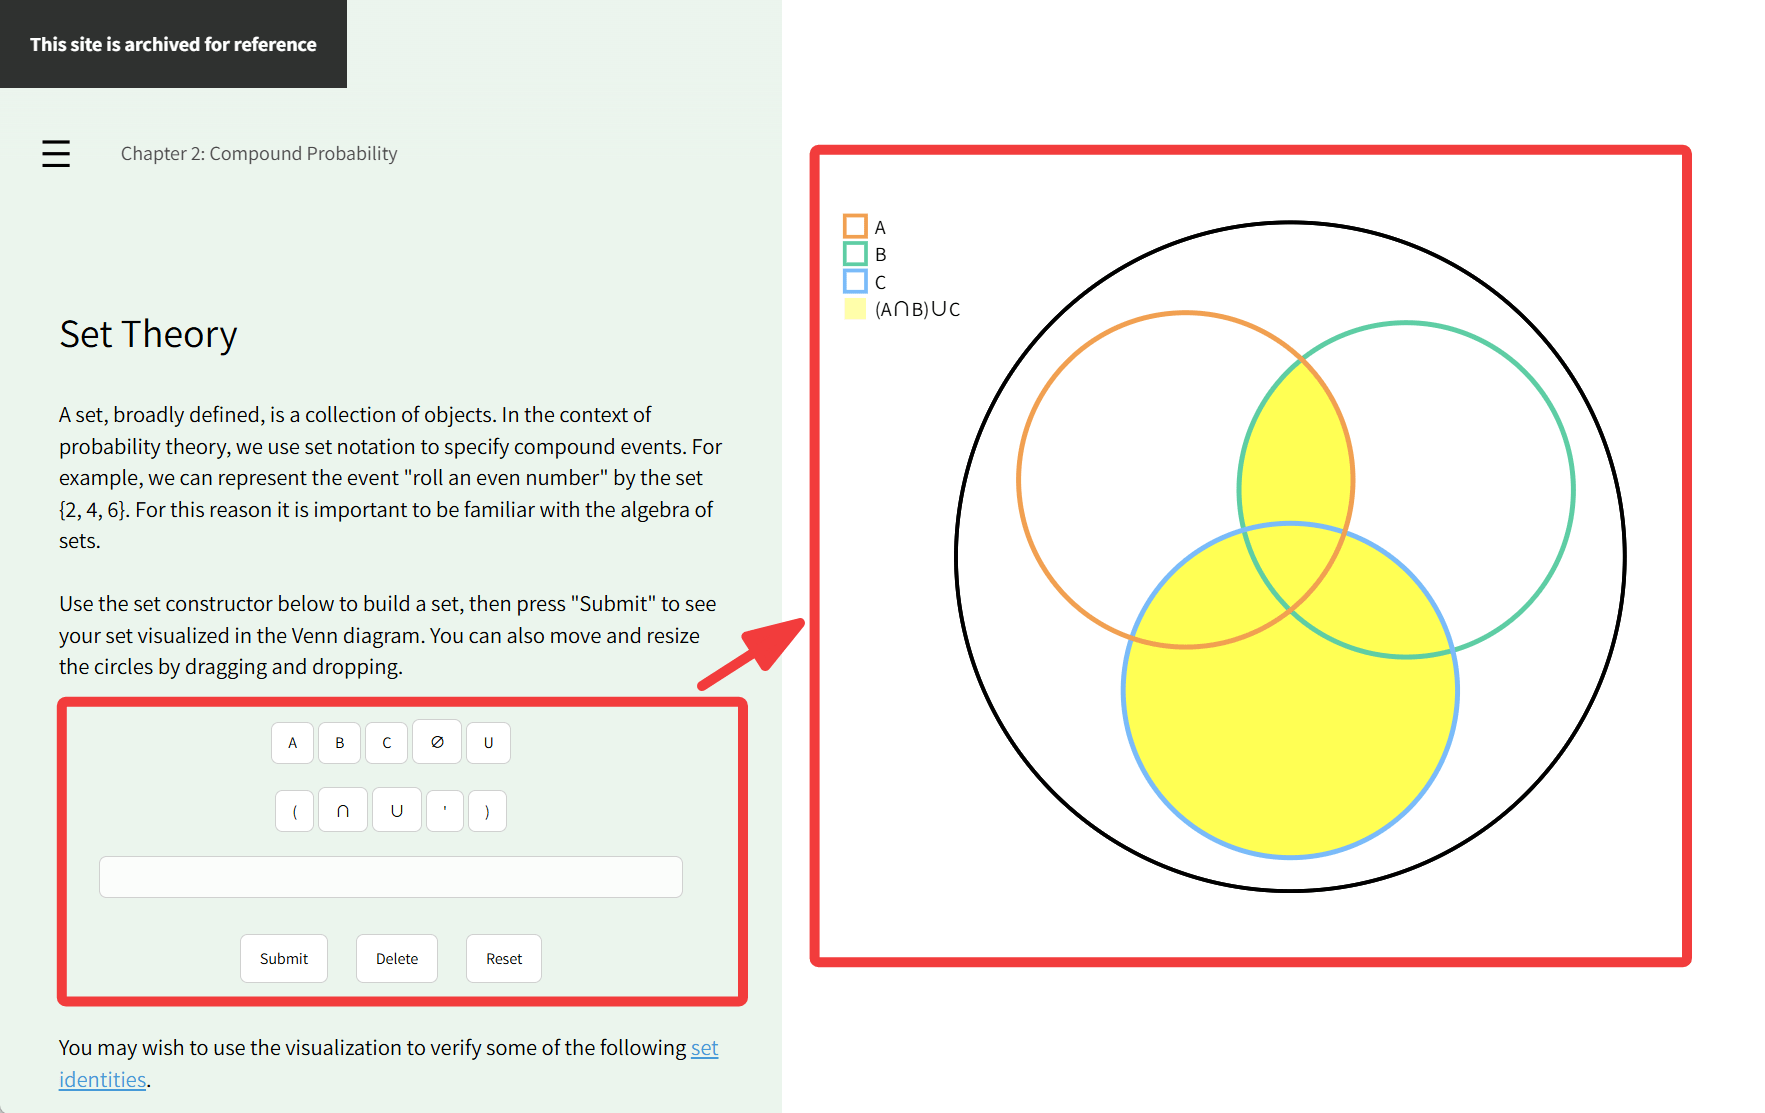
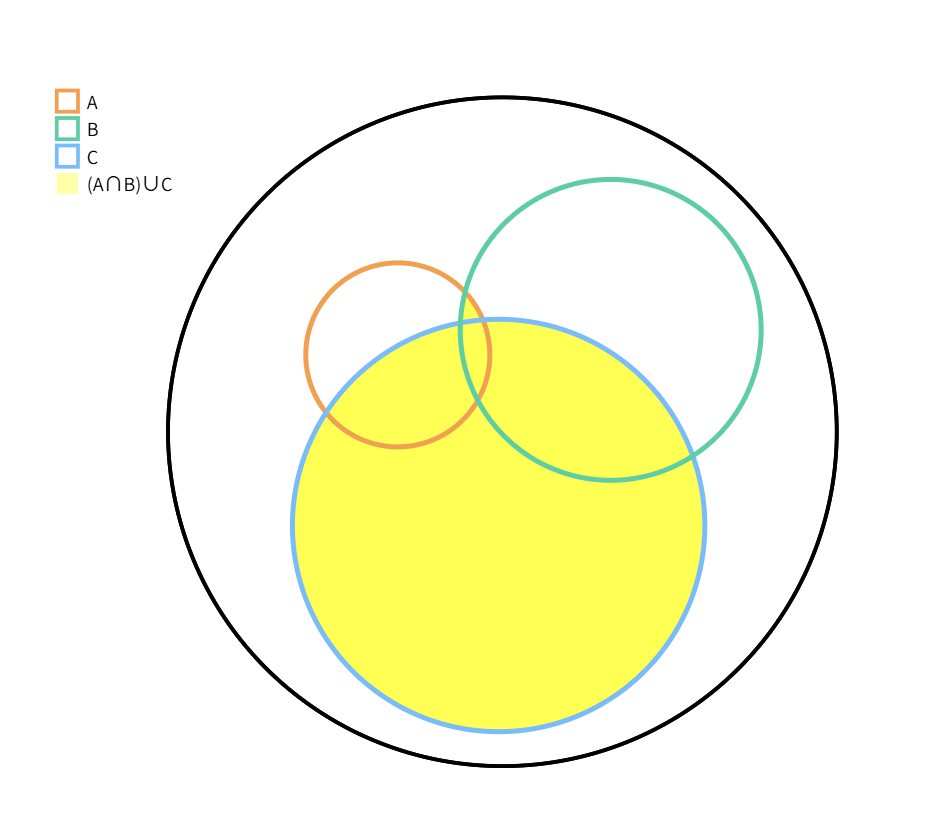
円をドラッグ&ドロップで操作することで集合の包含関係・和集合・積集合といった関係性を直感的に把握することができ、後述する集合恒等式の理解に役立ちます。
・計数
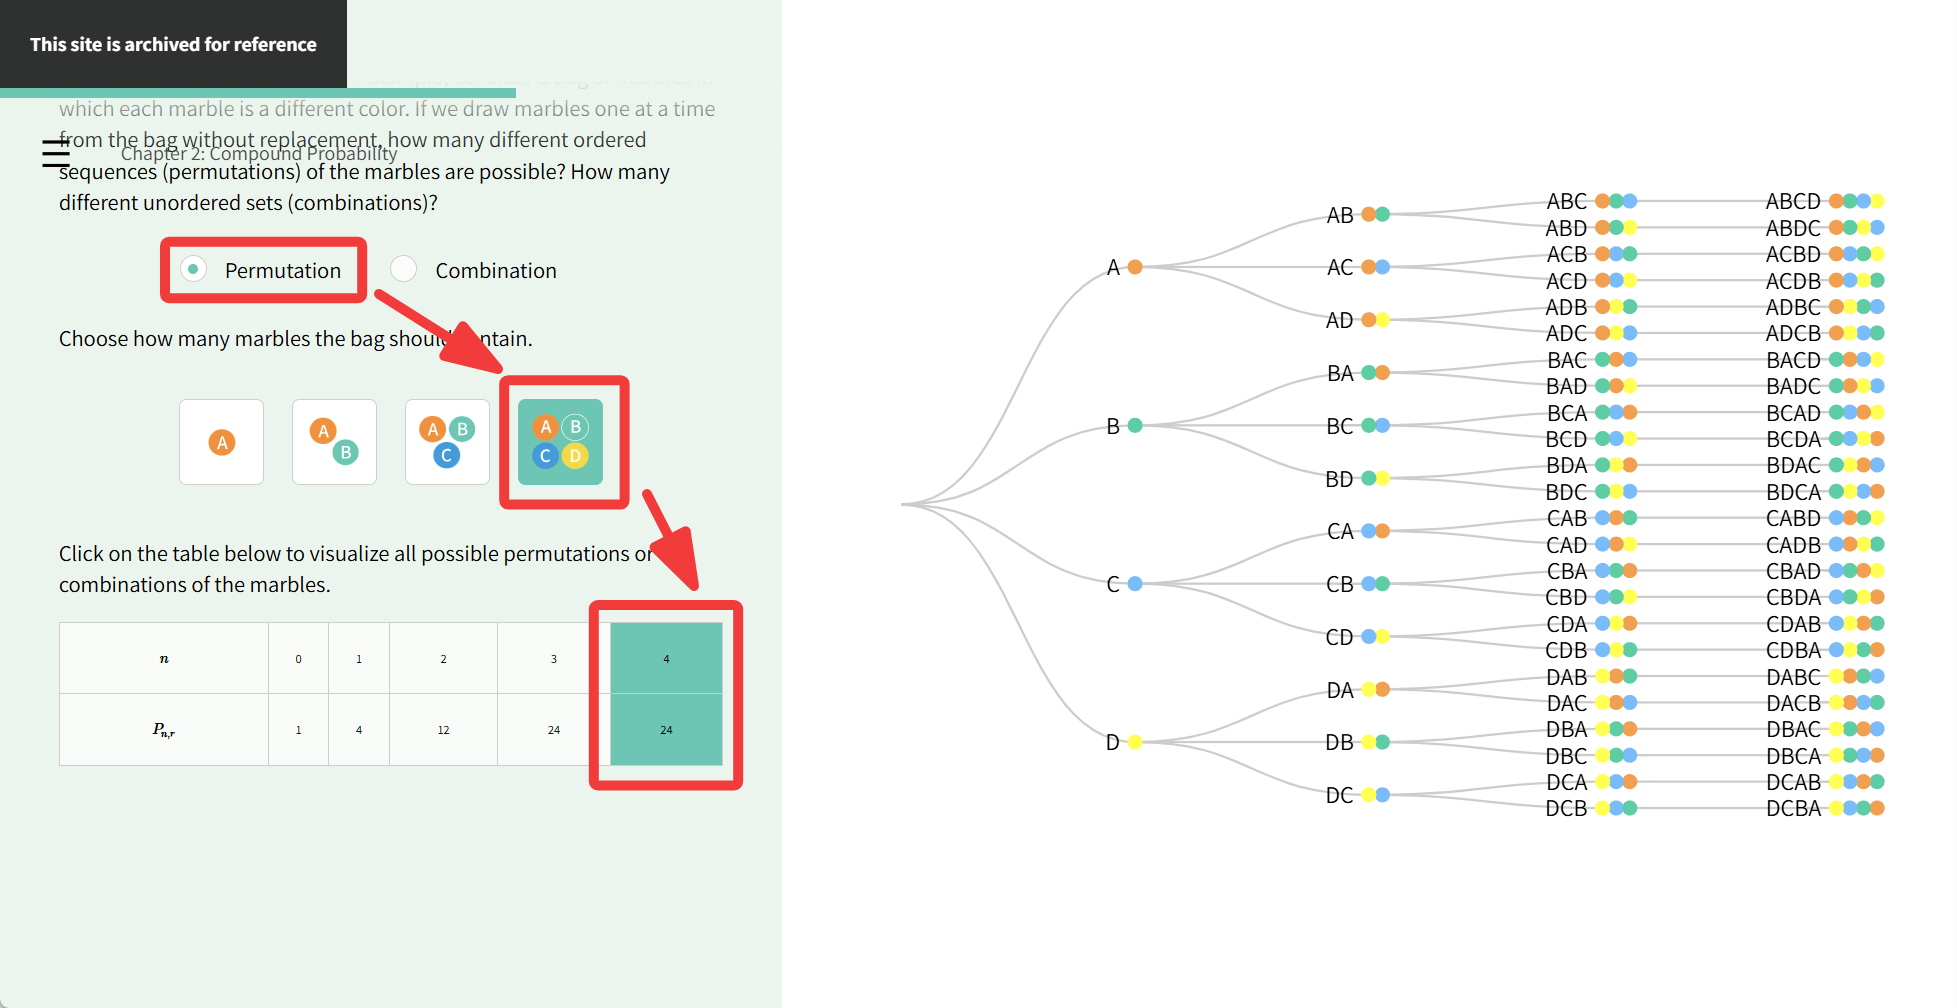
特定の条件を満たす並びや集合の数を正確に数える「計数」が複雑な問題となる場合があります。本節では順列(順序付けられた並び)と組み合わせ(順序なしの集合)の概念を導入しています。ユーザーは袋に入れるビー玉の数を指定することで、順列と組み合わせの概念をインタラクティブに探索できます。以下はビー玉4つの順列。
以下はビー玉4つの組み合わせです。
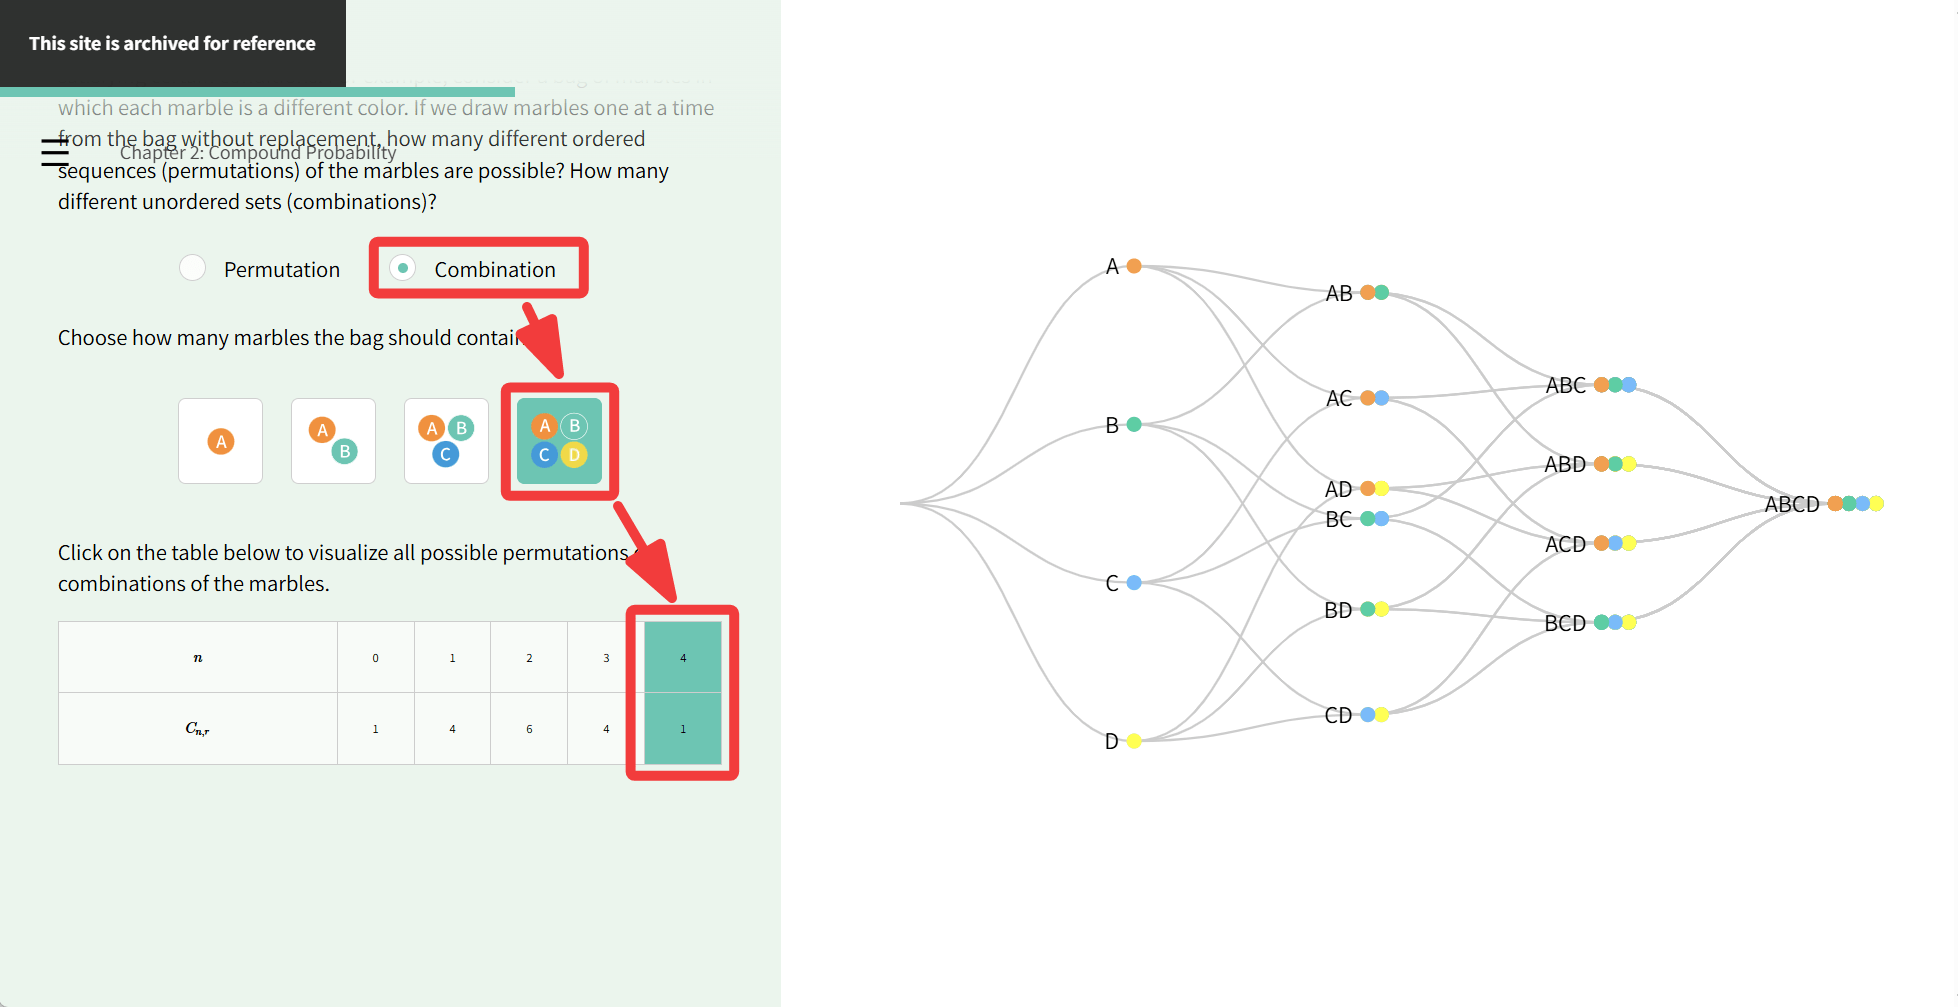
提供されるツールはすべてのビー玉の可能な順列または組み合わせを視覚化するために使用でき、計数の基本原理を体験的に学ぶことができます。
・条件付き確率
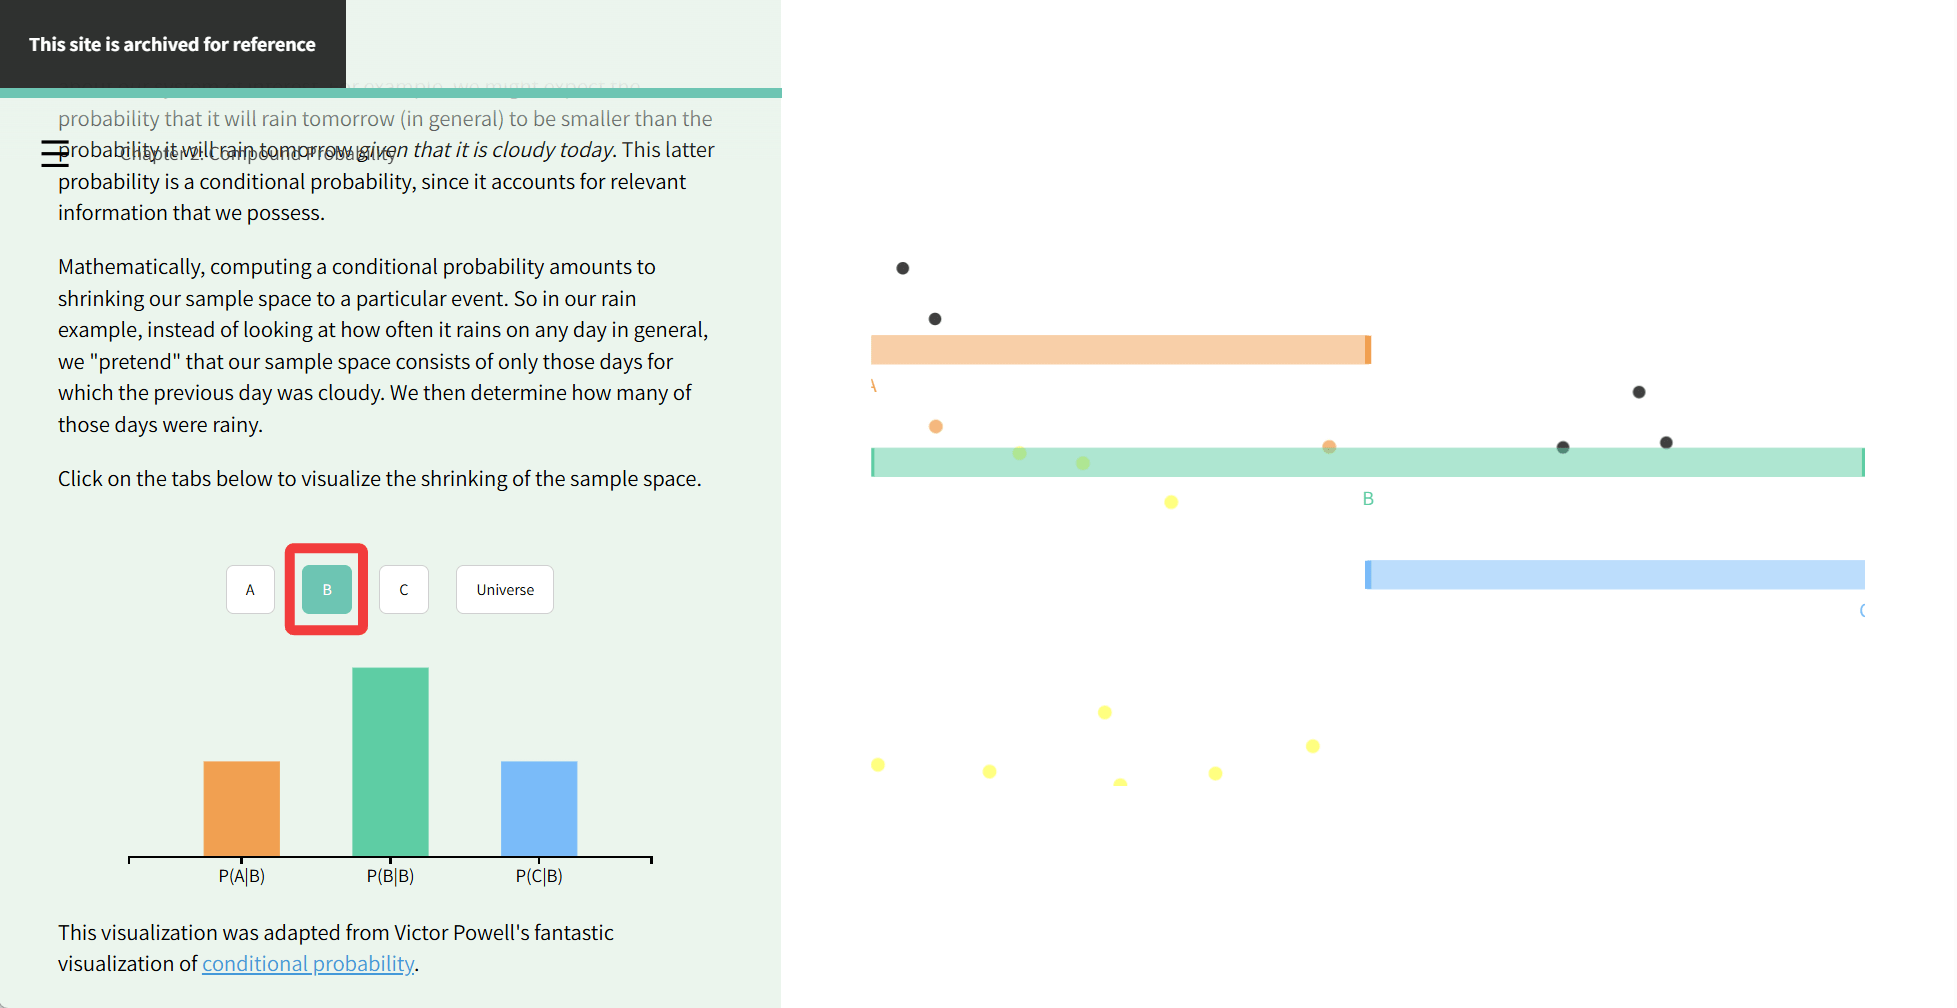
「条件付き確率」は既存の情報を考慮に入れて、特定のイベントが発生する確率をより正確に評価することを可能にします。例えば、明日の降水確率は「今日が曇りである」という情報がある場合とない場合とでは異なると予想されます。「今日が曇りである」という情報がある場合の降水確率は関連情報を考慮に入れているため、条件付き確率であるといえます。数学的には、条件付き確率は標本空間を特定のイベントに絞り込むことに相当します。雨の例では、一般的な日の降水頻度を見るのではなく、前の日が曇りであった日のデータのみに焦点を当て、その中で雨が降った日の割合を計算します。
本節で提供されている視覚化ツールは、標本空間の絞り込みという概念を理解するのに役立ちます。A・B・Cというイベントを選択することにより絞り込みをおこなうことができます。
◆第3章:確率分布
確率分布の基本的な概念である確率変数・離散分布・連続分布・中心極限定理に焦点を当て、ある事象において起こりうる全ての可能性のある結果と、結果の相対的な尤度(ゆうど:起こりやすさ)について解説しています。
・確率変数
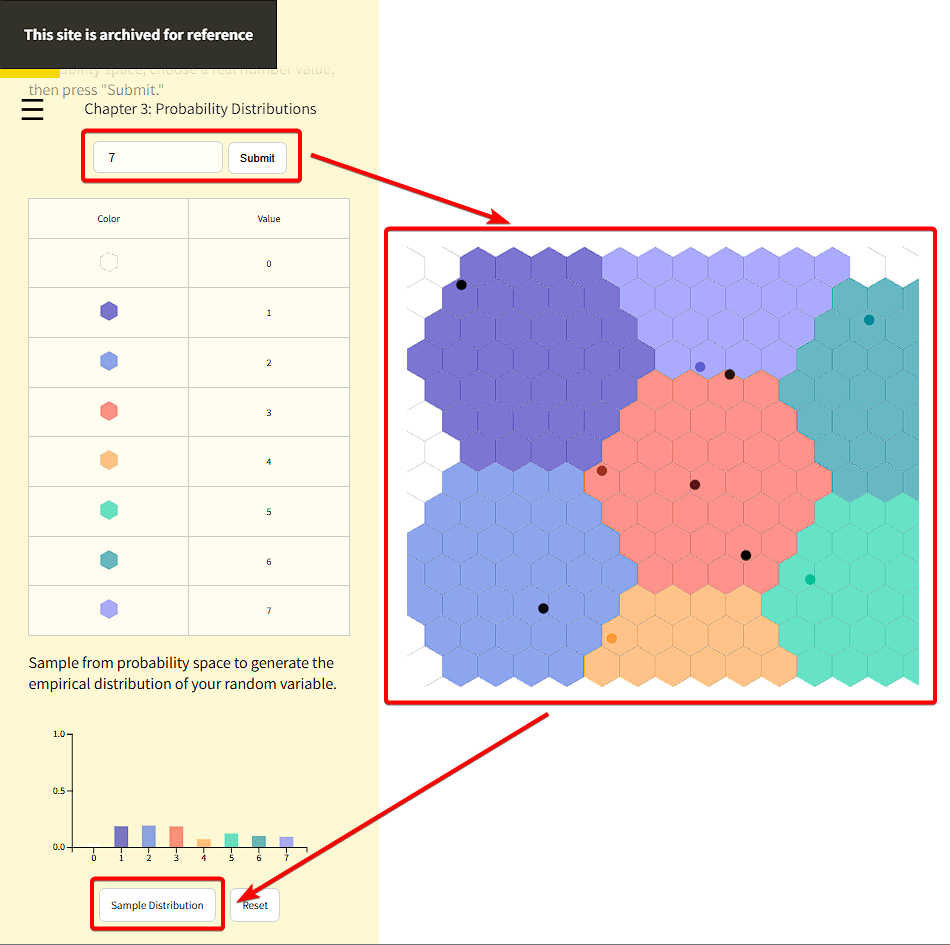
「確率変数」とは確率空間における各事象に実数を割り当てる関数として定義されます。
当節で提供されている視覚化ツールは、均一確率空間において自身で離散確率変数を定義し、サンプリングを実行することで経験分布を視覚的に確認することができます。
・離散分布と連続分布
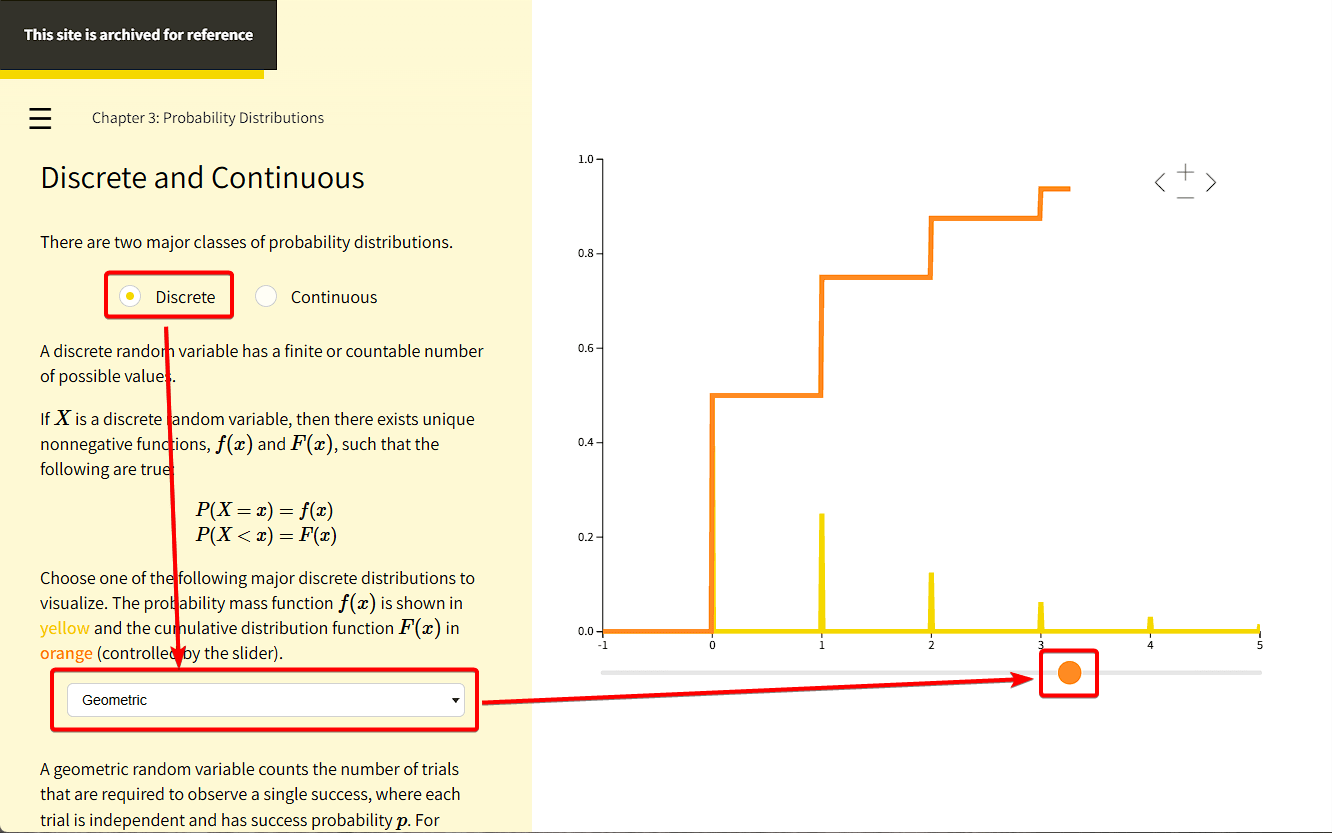
「離散分布」は有限または可算個の可能な値をとる確率変数に対応します。離散確率変数\( X \)が存在する場合、以下の条件を満たす非負関数\( f(x) \)(確率質量関数)と\( F(x) \)(累積分布関数)が存在します。
\( P(X = x) = f(x) \)
\( P(X < x) = F(x) \)
ユーザーは確率質量関数\( f(x) \)(黄色のグラフ)と累積分布関数\( F(x) \)(オレンジ色のグラフ、スライダーで操作可能)を、以下の主要な離散分布を選択することで視覚化できます。
・ベルヌーイ分布:結果が「成功(1)」または「失敗(0)」の2つしかない試行の分布
・二項分布:成功確率\( p \)のベルヌーイ試行を独立に\( n \) 回行ったときの「成功回数」の分布
・幾何分布:成功確率\( p \)のベルヌーイ試行を繰り返し、はじめて成功するまでに何回失敗するか(または何回試行するか)の分布
・ポワゾン分布:非常に確率が低い現象が一定の時間や空間内で起きる回数の分布
・負の二項分布:成功確率\( p \)のベルヌーイ試行を行い、あらかじめ決めた\( k \)回の成功を得るまでに何回失敗するかを表す分布
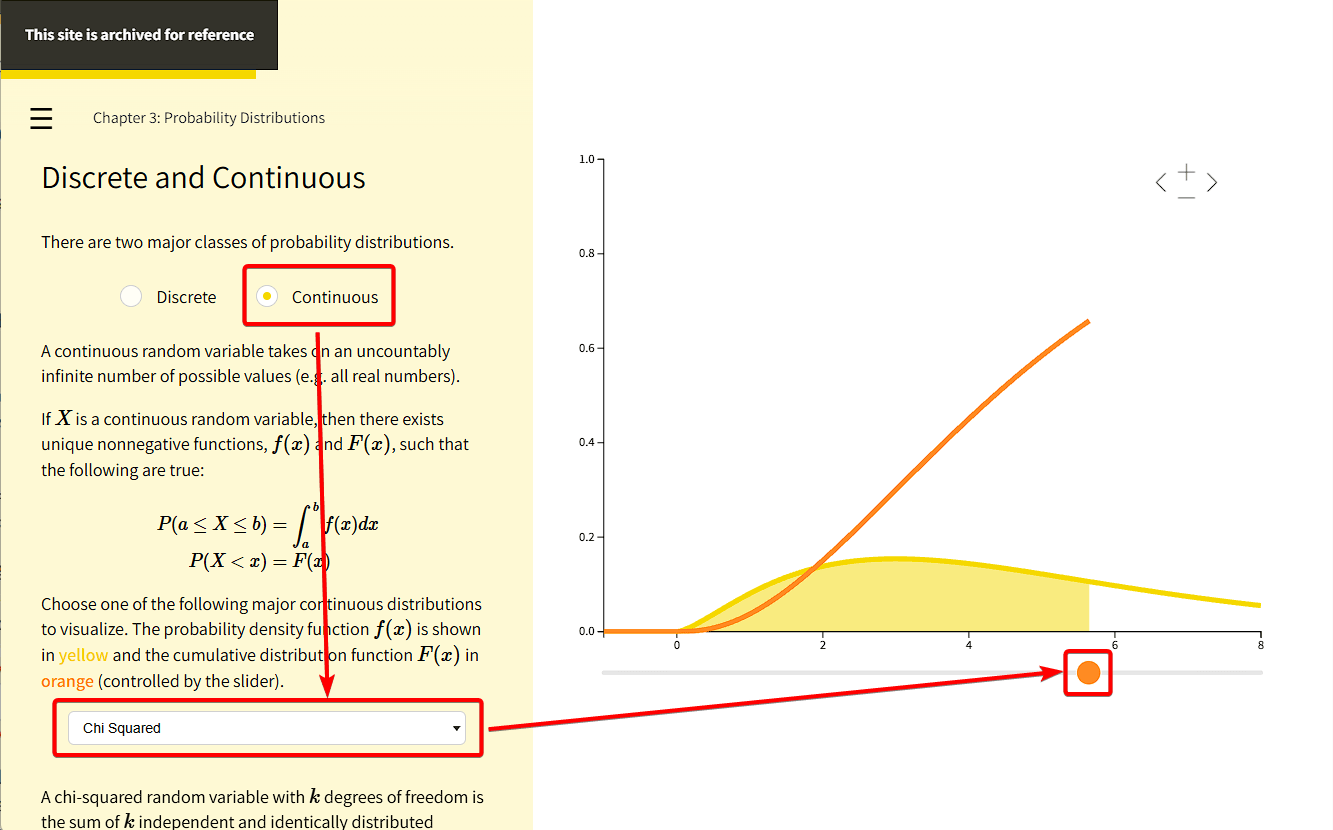
「連続分布」は可算無限個ではない数の値(例えばすべての実数)をとる確率変数に対応します。連続確率変数\( X \)が存在する場合、以下の条件を満たす非負関数\( f(x) \)と\( F(x) \)が存在します。
\( P(a\leq X\leq b) = \int^b_a f(x) dx \)
\( P(X < x) = F(x) \)
以下の主要な連続分布の中から1つを選択することで視覚化できます。確率密度関数\( f(x) \)は黄色で、累積分布関数\( F(x) \)はオレンジ色で表示されスライダーで制御できます。
・一様分布:指定された範囲\( [a, b] \)内でどの値をとる確率も等しい分布
・正規分布:ベル型の左右対称な、自然界や社会現象で最もよく現れる分布
・t分布:正規分布よりすそ野(両端)が少し厚いベル型の分布、正規分布の平均を推測する際に使用
・カイ二乗分布:標準正規分布に従う独立な確率変数をn個二乗して足し合わせた分布、統計的検定に使用
・指数分布:ランダムに起きる事象の発生間隔を表す分布
・F分布:2つのカイ二乗分布の比から作られる分布、分散分析(ANOVA)などで使用
・ガンマ分布:指数分布を一般化したもので、あるイベントがk回起きるまでの時間を表す
・ベータ分布:確率や比率など、値が0から1の間に収まる現象をモデル化する際に使用
・中心極限定理(CLT)
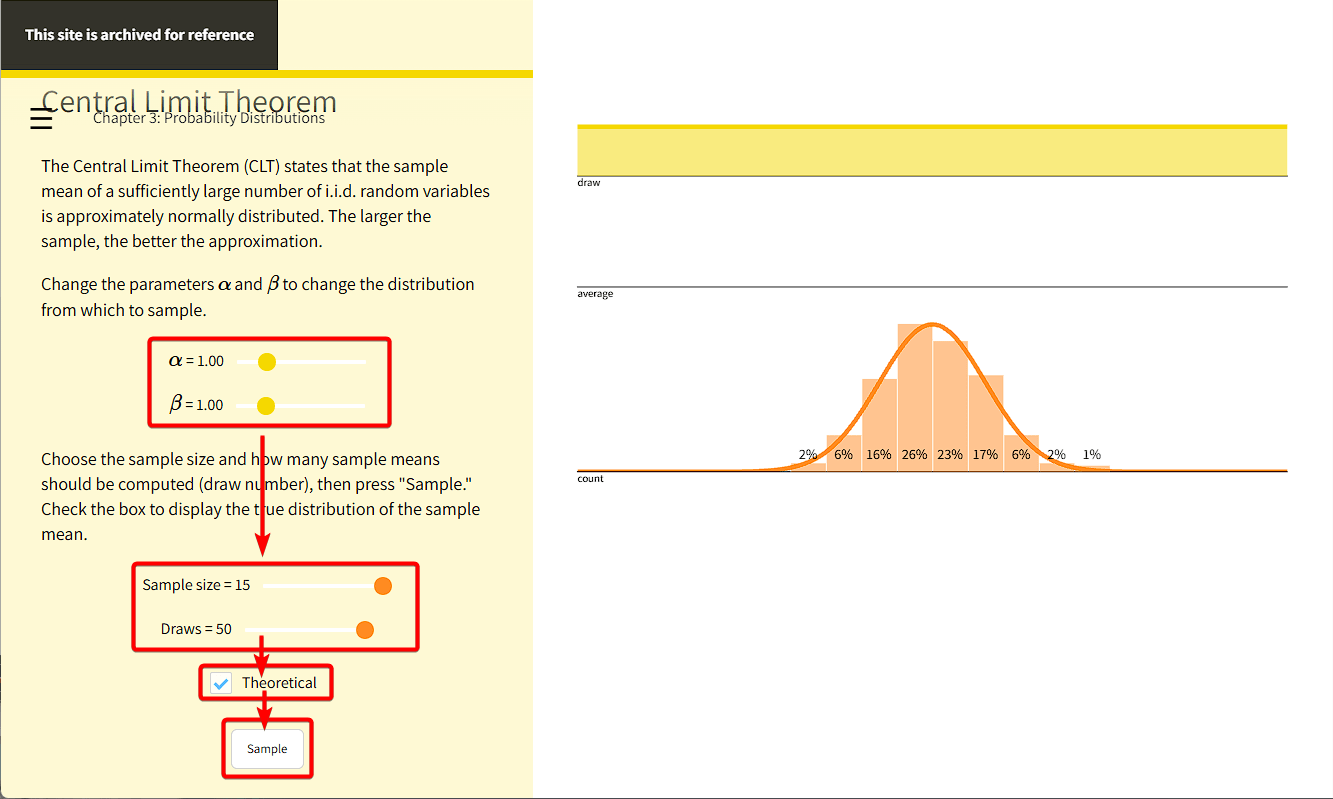
「中心極限定理(CLT)」は十分に大きな数の独立同分布(i.i.d.)確率変数の標本平均が近似的に正規分布に従うという重要な定理です。標本サイズが大きくなるほど正規分布への近似精度は向上します。
CLTの視覚化ツールではサンプリング元の分布を調整するためのパラメータ(α、β)を黄色のスライダーで設定できます。また、標本サイズや計算する標本平均の数(ドロー数)を橙のスライダーで調節してサンプリングを実行できます。標本平均の真の分布を表示するチェックボックスも提供されています。
◆第4章:頻度論的推論
観測データから基盤となる分布の特性を決定する「頻度論的推論」の基本的な概念である手法、点推定・区間推定・ブートストラップ法に関する解説です。
・点推定
統計学における重要な目的の一つは未知のパラメータを推定することです。この目的を達成するために「推定量」と呼ばれる統計量が用いられます。推定量はランダムに抽出された観測値から計算される関数です。
例えば円周率(\( \pi \))の推定が挙げられます。正方形の中に内接する円を考え、正方形内にランダムに点を投下します。
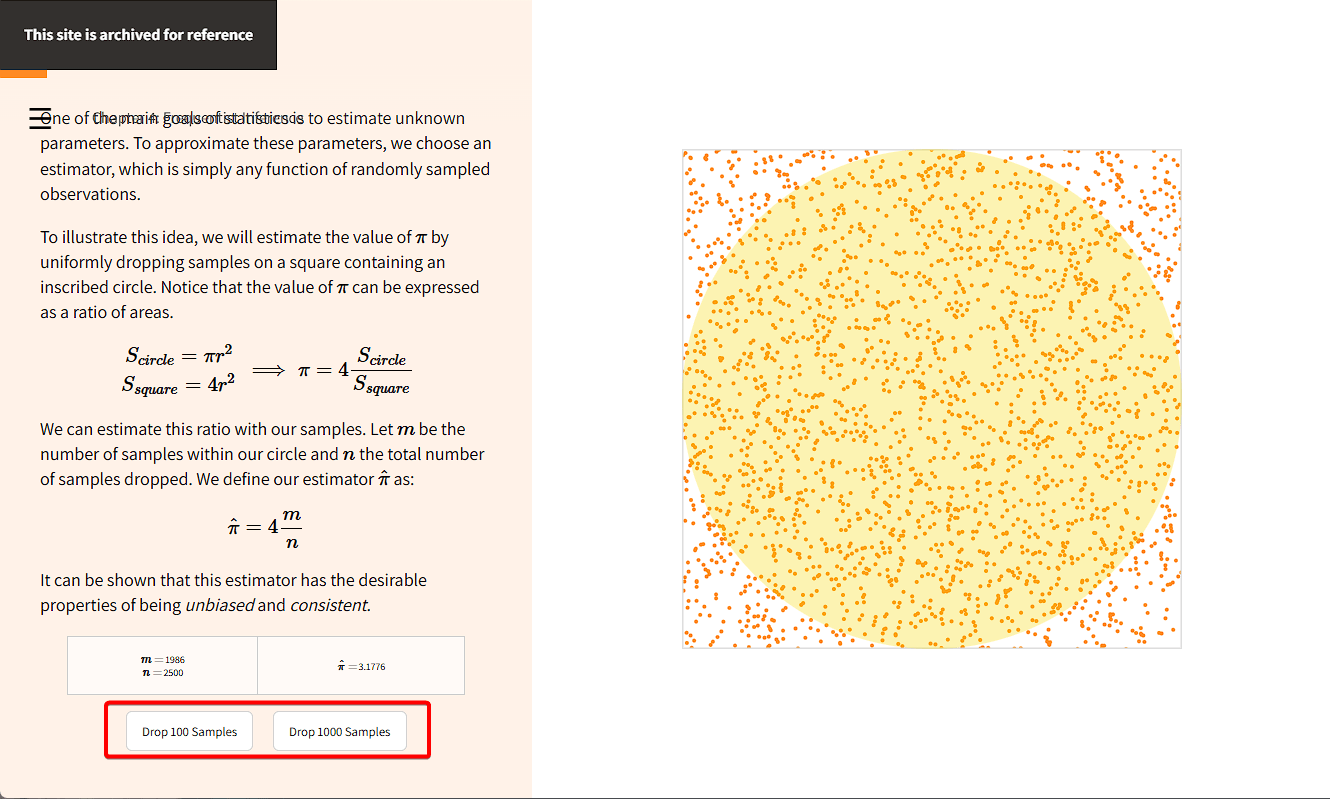
\( \pi \)は円の面積と正方形の面積の比率として定義できます。円の面積が\( S_{circle} = \pi r^2 \)、正方形の面積が\( S_{square} = 4r^2 \)であるとすると、\( \pi = 4 \frac{S_{circle}}{S_{square}} \)という関係が得られます。この面積比は投下した点の数を用いて推定できます。円内に入った点の数を\( m \)、投下した点の総数を\( n \)とすると、円周率の推定量\( \hat{\pi} \)は次のように定義されます。
\( \hat{\pi} = 4 \frac{m}{n} \)
この推定量は「不偏性」および「一貫性」という統計学的に望ましい性質を持つことが示されています。
・信頼区間
点推定が単一の値を推定するのに対し、「信頼区間」はパラメータが存在する可能性のある値の範囲を示します。信頼区間には「信頼水準」が伴います。信頼水準とは、信頼区間を生成する手法が真のパラメータを含む区間を生成する確率のことです。
信頼区間を生成する手順はまずサンプリングに使用する確率分布を選択し、次にサンプルサイズ(\( n \))と信頼水準(\( 1 - \alpha \))を設定します。その後「Start Sapmling」ボタンを押すと設定に基づき、信頼区間を生成するためにサンプリングを実行します。
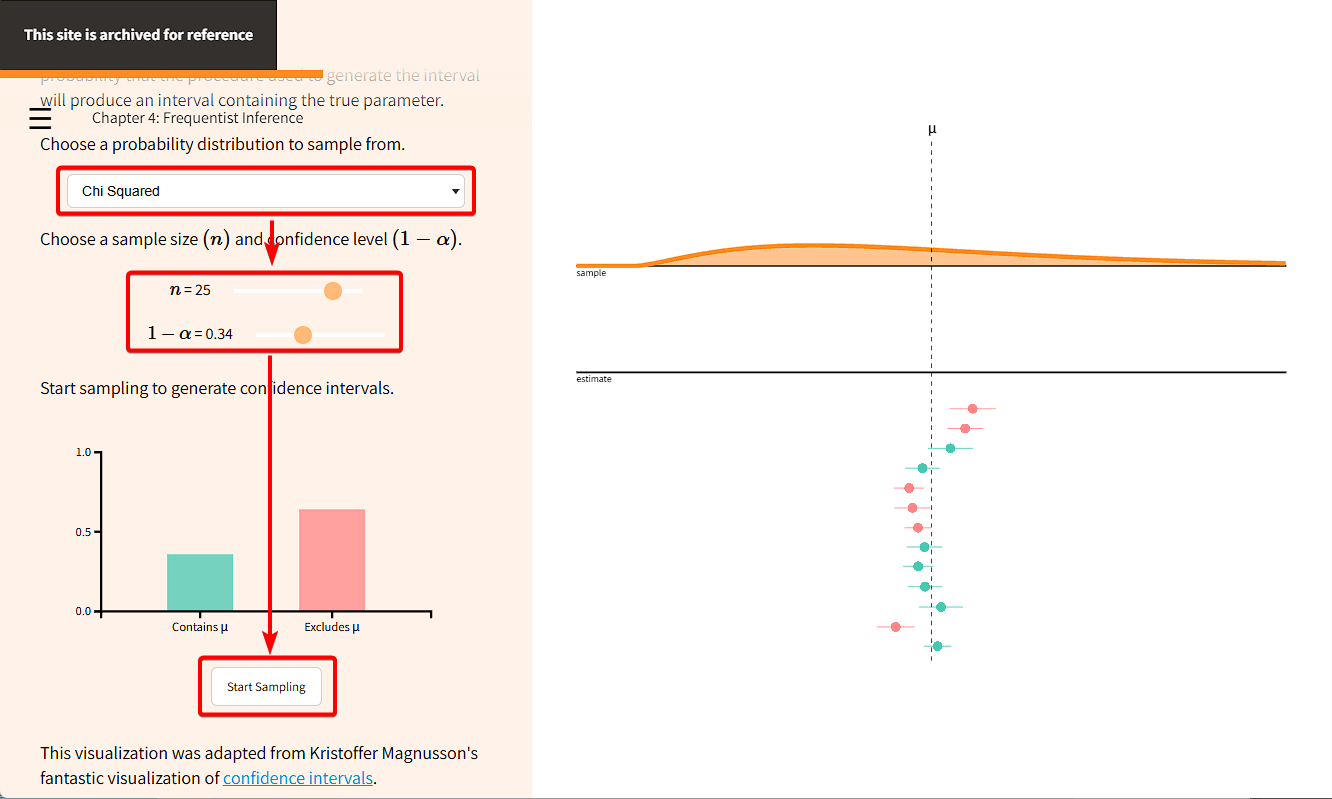
上記の手順により、信頼区間が真の平均 (\( \mu \)) を含む場合と含まない場合が存在することが視覚的に示されています。
・ブートストラップ法
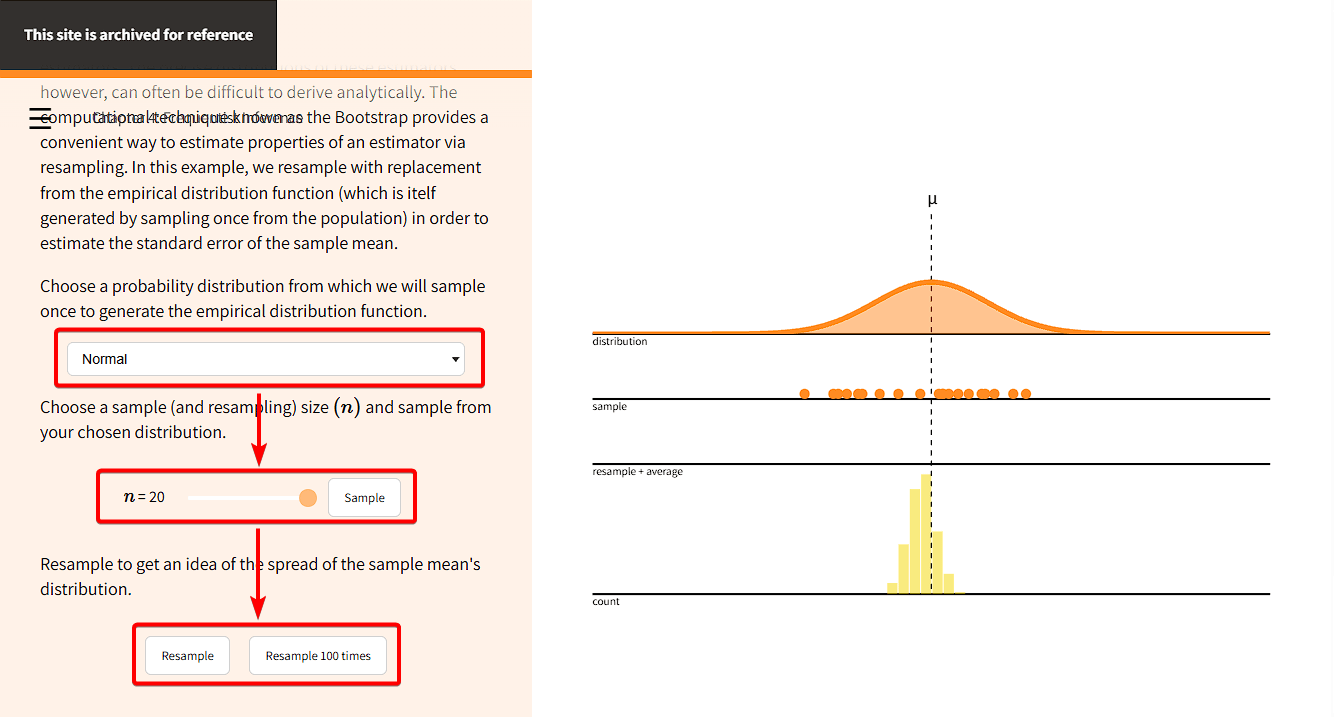
頻度論的推論の多くは優れた性質を持つ推定量を利用することに焦点を当てています。しかし、推定量の正確な分布を解析的に導出することは常に簡単というわけではありません。そこで「ブートストラップ法」という計算手法が役立ちます。ブートストラップ法はリサンプリングを繰り返すことで推定量の特性を近似的に評価することを可能にします。例えば、観測データから得られる経験分布関数から置換ありでリサンプリングを行い、標本平均の標準誤差を推定できます。
ブートストラップ法の手順は、まず経験分布関数を生成するためサンプリングする確率分布を選択し、次にサンプルサイズ(およびリサンプリングサイズ)(\( n \)) を選択して選択した分布からサンプリングし、最後に標本平均の分布のばらつきを把握するためリサンプリングを複数回実施します。
◆第5章:ベイズ推定
ベイズ推定は新たなデータが得られた際に既存の信念を更新していく統計学的な手法です。ベイズ推定の主要な構成要素としてベイズの定理・尤度関数・事前分布から事後分布への移行を解説しています。
・ベイズの定理
「ベイズの定理」は新たな情報に基づいて確率的な信念を更新するための強力なツールです。例えば、病気の検査で陽性結果が出た場合に「検査結果が陽性であったという条件の下で、実際にその病気にかかっている確率はどれくらいか?」といった疑問に答えることができます。
\( P(\text{Disease}|+) = \frac{P(+|\text{Disease})P(\text{Disease})}{P(+)} \)
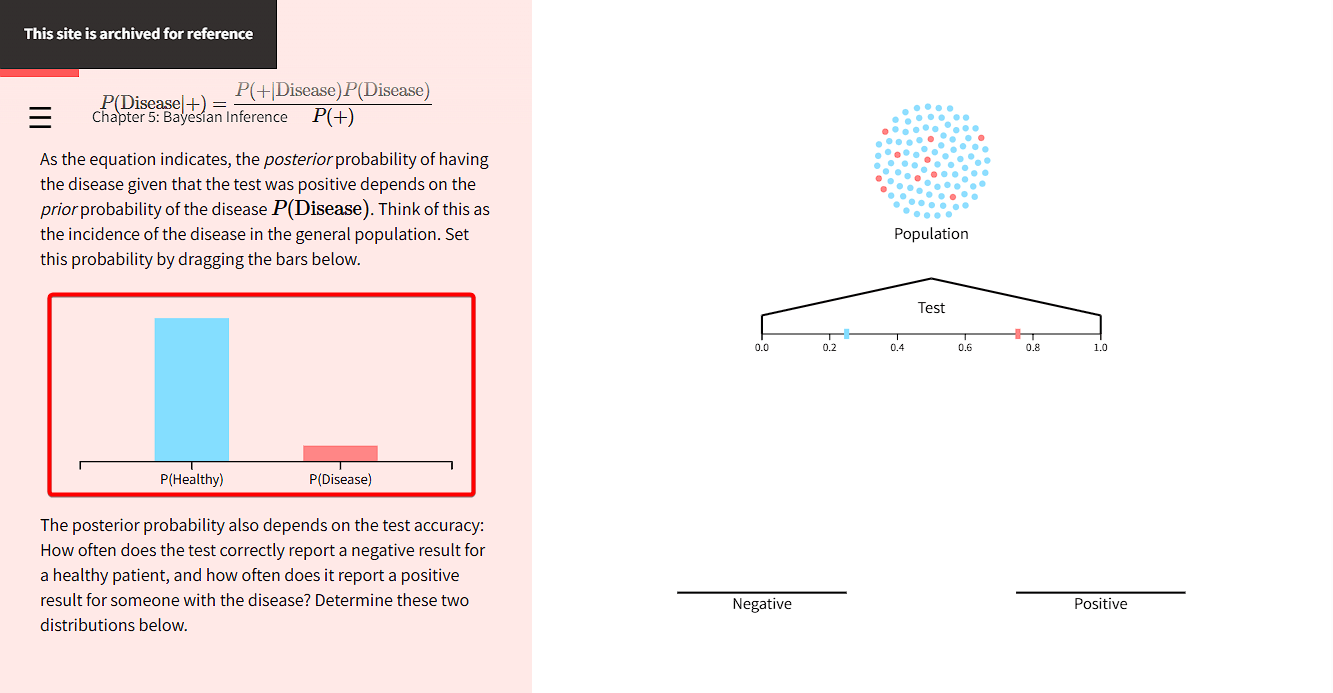
上記の式が示すように、検査結果が陽性であった場合に疾患を患っている事後確率は、その疾患の事前確率\( P(\text{Disease}) \)に依存します。視覚化ツールの使い方は、まず初めに\( P(\text{Healthy}) \)と\( P(\text{Disease}) \)のグラフをドラッグして確率を設定します。
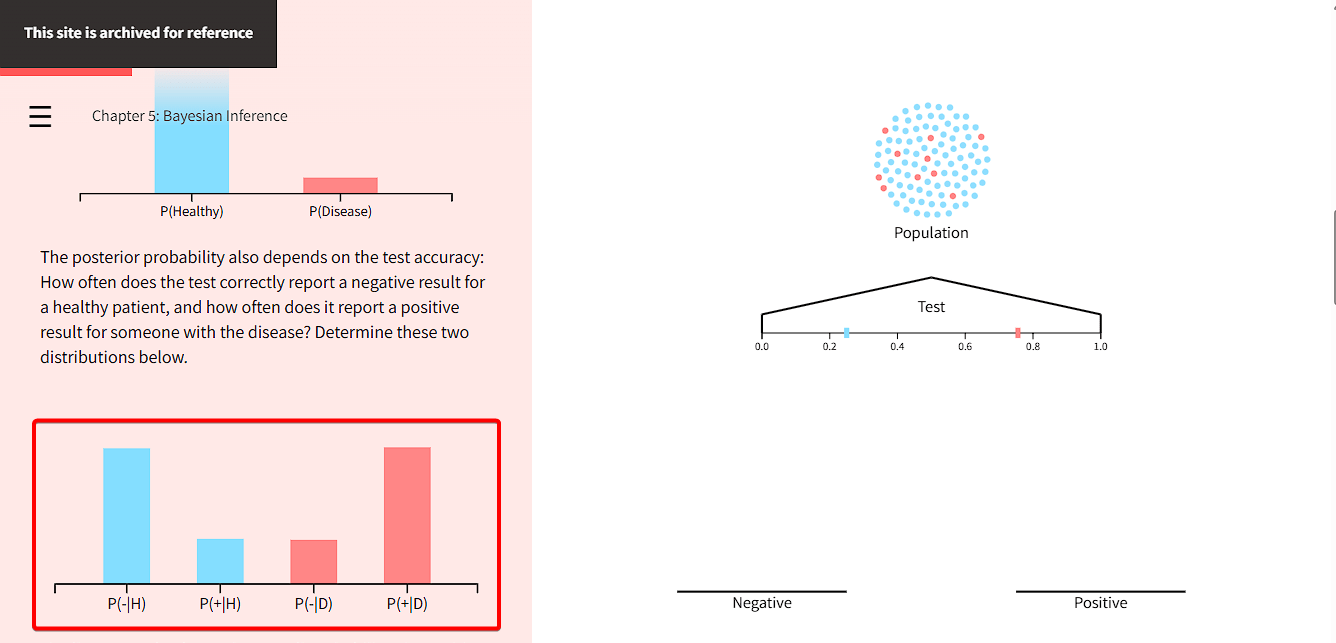
事後確率も検査の精度に依存します。つまり、健康な患者に対して検査が陰性結果を正しく示す頻度\( P(-|\text{Healthy}) \)、疾患を持つ患者に対して陽性結果を正しく示す頻度\( P(+|\text{Disease}) \)を同様にグラフをドラッグして設定します。
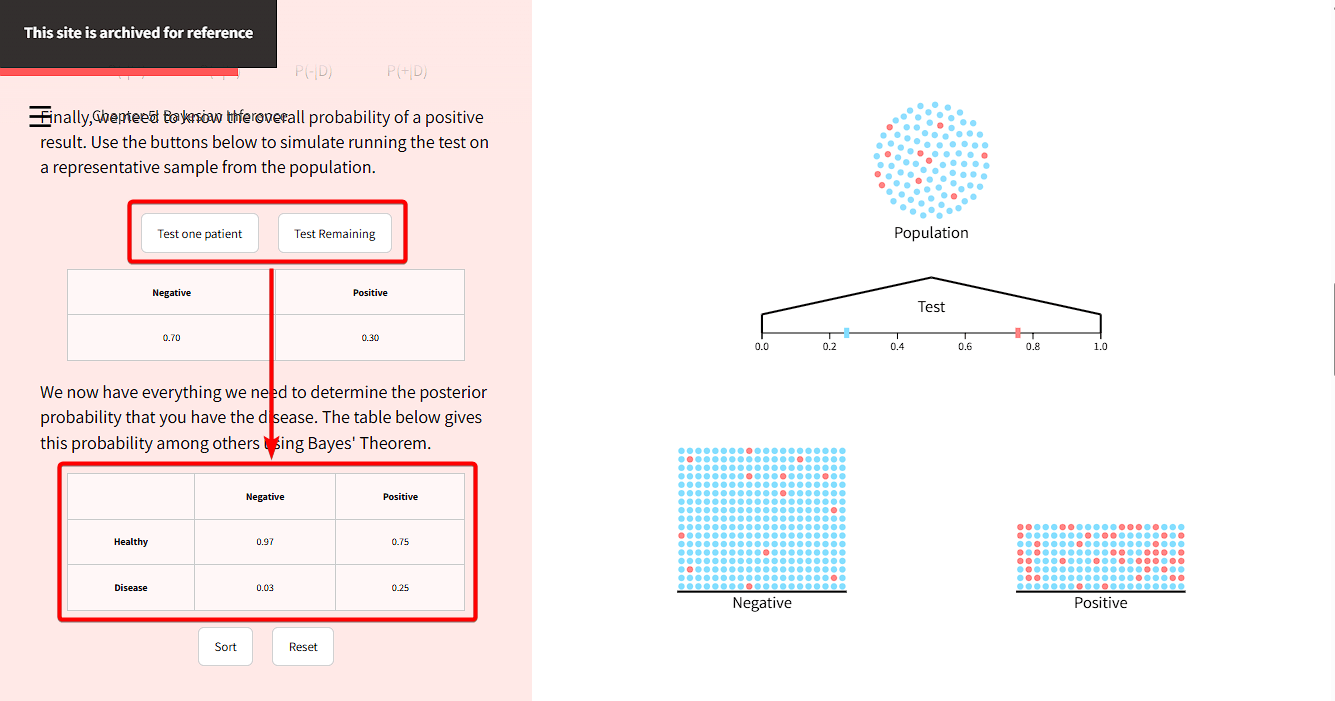
最後に、陽性結果が出る全体的な確率を把握する必要があります。「Test one patient」もしくは「Test remaining」のボタンをクリックすると母集団から抽出した代表的な標本に対して検査を実施するシミュレーションが実行されます。シミュレーションが完了すると「その病気にかかっている」という事後確率を算出するために必要な情報はすべて揃い、下の表にベイズの定理を用いて算出した各種確率が表示されます。
・尤度関数
統計学において「尤度関数」には非常に厳密な定義があります。尤度の概念はベイズ統計と頻度論統計の両方で基本的な役割を果たします。
\( L(\theta | x) = P(x | \theta) \)
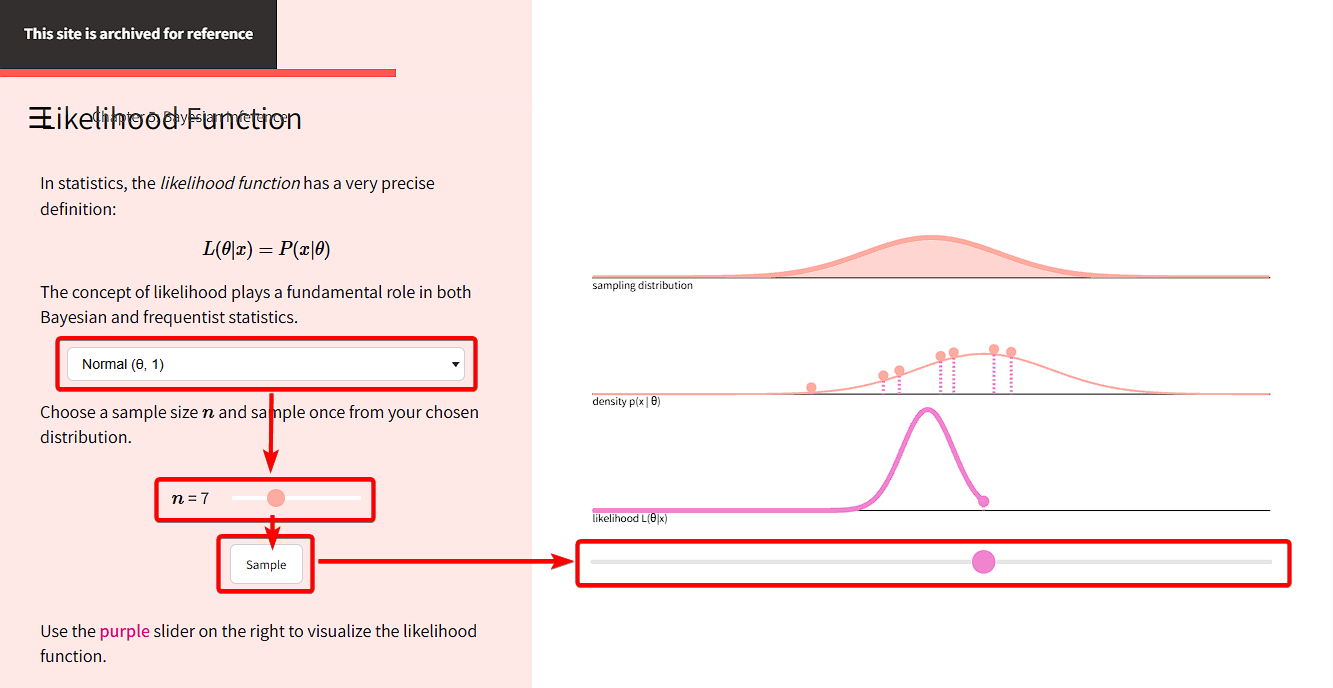
視覚化ツールの使い方は、まず標本の分布を選択し、次にサンプルサイズ\( n \)を指定し「Sample」ボタンをクリックします。最後に紫色のスライダーを操作すると尤度関数\( L(\theta | x) \)を可視化することができます。
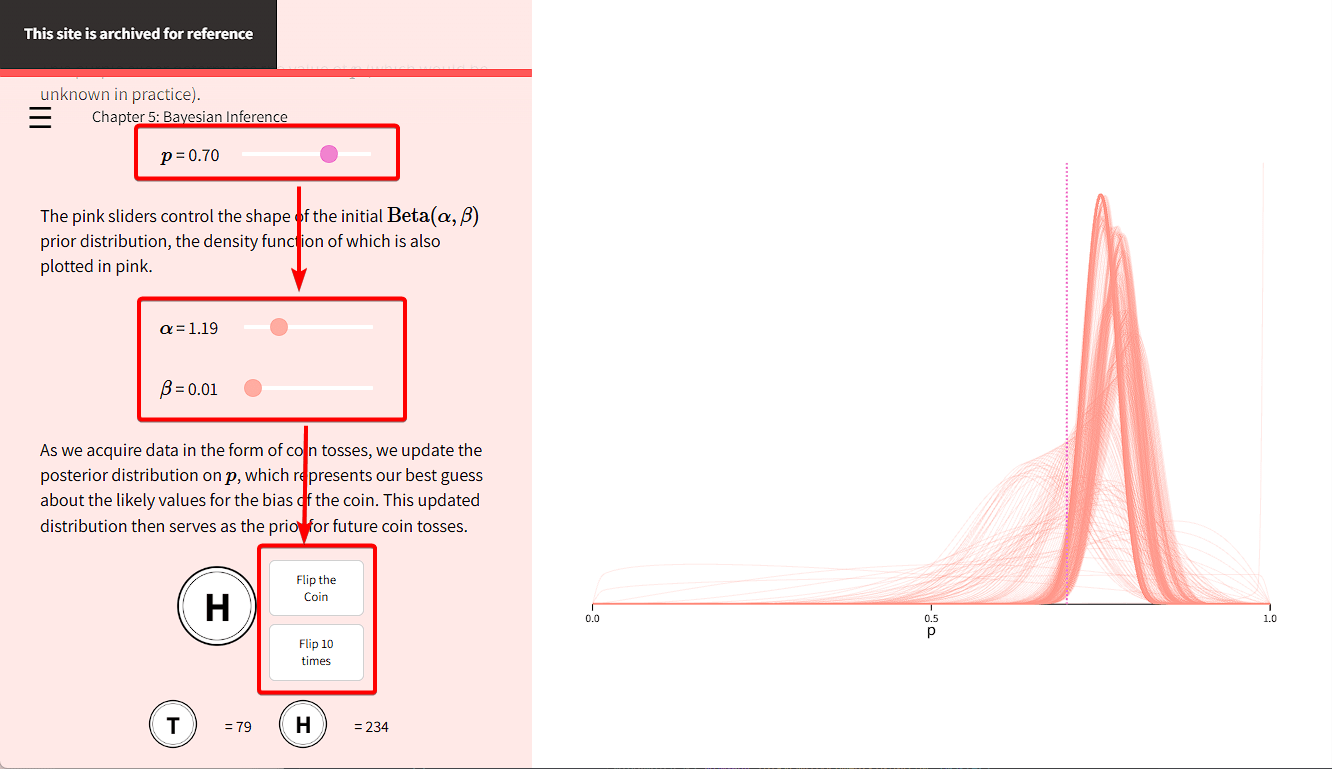
・事前分布から事後分布へ
ベイズ統計学の核心は、データが蓄積されるにつれて事前(あらかじめ持っていた)信念が更新され、事後(更新された)信念へと変化していくプロセスにあります。
例として、表が出る確率\( p \)が未知のコインを考えます。\( p \)の値はスライダーで調整可能であり、初期の「事前分布」が\( \text{Beta}(\alpha, \beta) \)として設定され、その確率密度関数が可視化されます。コイン投げのボタンをクリックして結果のデータが得られるたびに\( p \)に関する「事後分布」が更新されます。更新された分布はコインの偏りに関する最も可能性の高い値の推測となり、さらに次の推論のための「事前分布」として機能します。
◆第6章:回帰分析
統計学においてデータ間の関係性を理解し分析するために不可欠な、回帰分析・相関・分散分析(ANOVA)といった手法の概要についての解説です。
・最小二乗法(OLS)
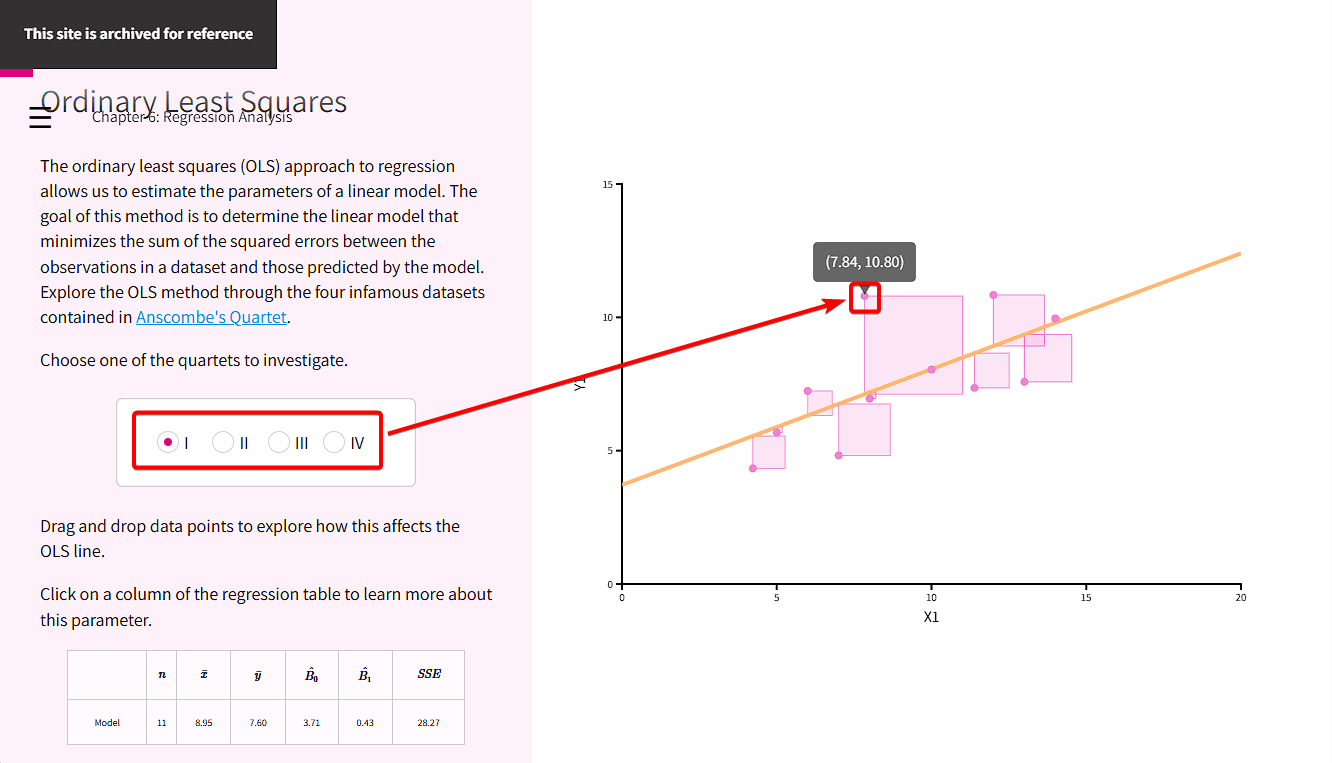
線形回帰分析は2つの変数間の直線的な関係性をモデル化する手法です。特に、「最小二乗法(OLS)」は線形モデルのパラメータを推定するための手法としてよく用いられます。OLSの目的は実際の観測値とモデルによって予測された値との間の誤差の二乗和を最小化するような線形モデルを見つけ出すことです。
線形回帰分析やOLSの概念は「アンスコムの例」として知られる4つのデータセットを通して、データポイントを操作しながらOLS直線への影響を視覚的に確認することで、より深く理解することができます。
調査対象として4つのデータセットから1つを選択します。各データセットの分布図には違いがあるものの、OLS直線は等しくなることがわかります。また、データセットに含まれるデータをドラッグアンドドロップすることで、OLS直線がどう変化するのかを確認することもできます。
・相関
「相関」は2つの変数間の直線的な関係性の強さと方向を示す尺度です。相関係数\( r \) はサンプルデータを計算することにより得られる値で\( +1 \)から\( -1 \)の範囲を取ります。相関係数は以下の式で定義されます。
\( r = \dfrac{s_{xy}}{\sqrt{s_{xx}} \sqrt{s_{yy}}} \)
また\( s_{xy} \)・\( s_{xx} \)・\( s_{yy} \)はそれぞれ以下の式で計算される共分散および分散の測度です。
\( \begin{align*} s_{xy} &=\sum^n_{i=1}
(x_i-\bar{x})(y_i-\bar{y})\\ s_{xx} &=\sum^n_{i=1}
(x_i-\bar{x})^2\\ s_{yy} &=\sum^n_{i=1}
(y_i-\bar{y})^2 \end{align*} \)
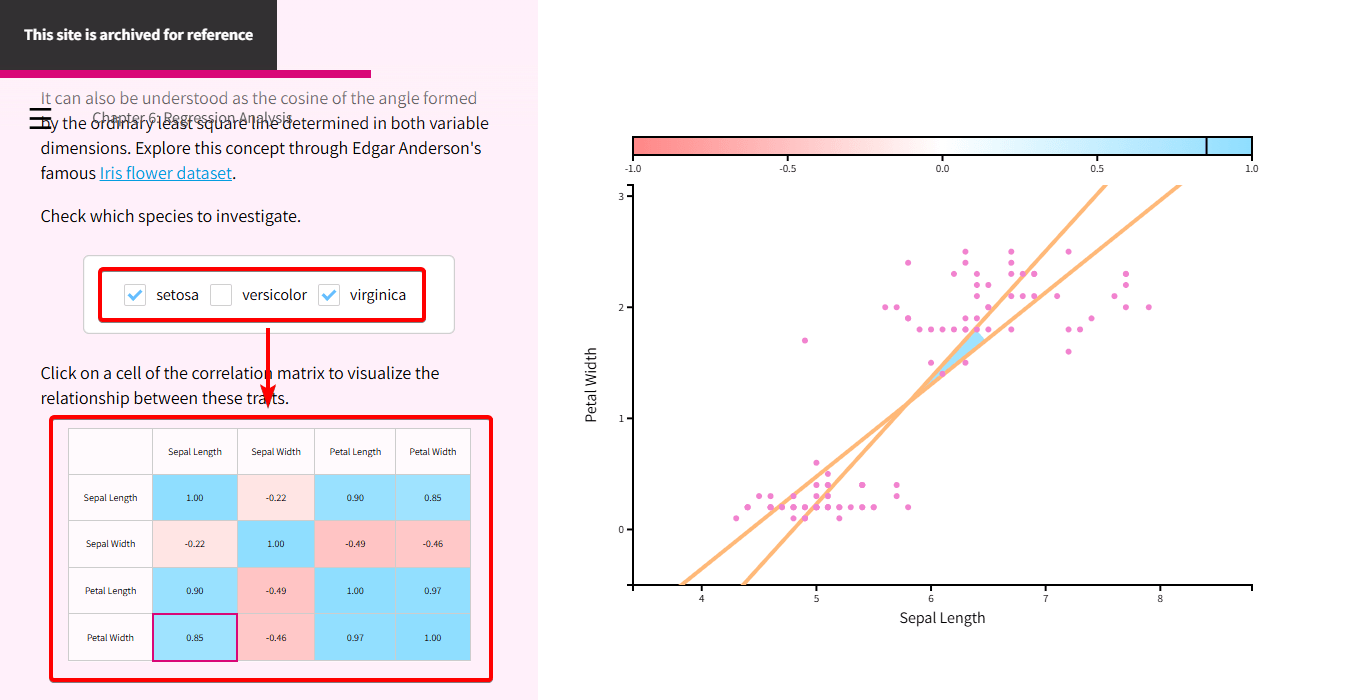
相関は両方の変数軸において決定された最小二乗直線が形成する角度のコサインとしても解釈することができ、「アヤメの花データセット」を用いることで探求することが可能です。まずアヤメをヒオウギアヤメ・ヘンショクアヤメ・バージニアアヤメから1種もしくは複数種選択します。次にアヤメの花の形質(がくの長さ・がくの幅・花びらの長さ・花びらの幅)の相関行列から任意のセルをクリックすると、形質間の関係が視覚化されます。
・分散分析(ANOVA)
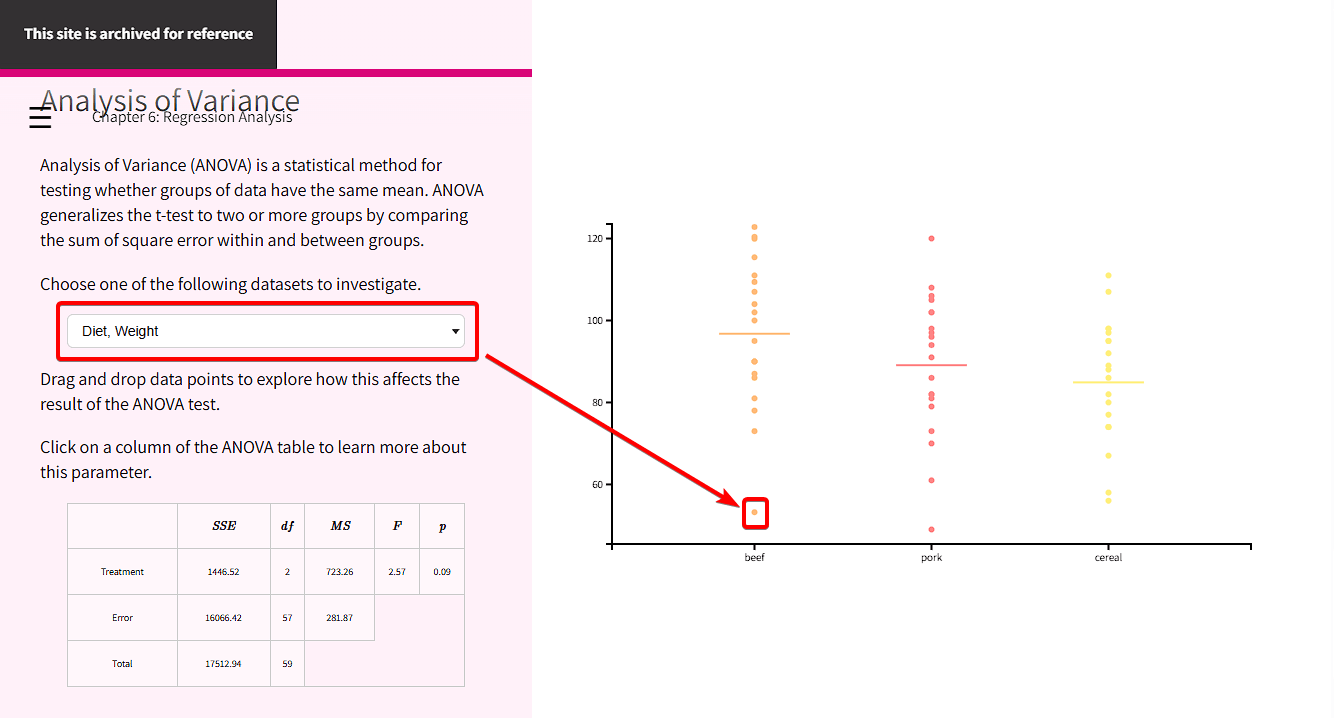
「分散分析(ANOVA)」は複数のグループ間で平均値に統計的に有意な差があるかどうかを検定するための手法です。ANOVAはグループ内の変動(平方和誤差)とグループ間の変動を比較することで、2つのグループを比較するt検定を3つ以上のグループに拡張したものです。
データポイントの操作がANOVA検定の結果にどのように影響するかをインタラクティブに探求することができます。まずは調査対象のデータセットを1つ選択します。データセットの各データはドラッグアンドドロップ可能なので、データの変更がANOVA検定の結果にどのような影響を与えるかを目視で確認することができます。
・まとめ
「Seeing Theory」は、インタラクティブな視覚化を通じて、確率と統計への理解の足掛かりとし、学習体験を豊かにすることを目指しています。インタラクティブ要素を排して教科書としての役目を見据えたドラフト版PDFもダウンロード可能ですので、確率や統計に興味を持った方は入手してさらなる深みにはまってください。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.