Как измерять видимость сайта в ответах ChatGPT и почему одна итерация вопросов ничего вам не скажет
Вчера поиск ChatGPT сослался на сайт, сегодня на тот же вопрос ссылки нет. Позиции потеряны? Скорее всего, нет: в эксперименте SparkToro и Gumshoe 600 добровольцев прогнали 12 промптов через ChatGPT, Claude и Google AI, и один и тот же список брендов почти не выпадал.
Видимость сайта в ChatGPT — это вероятность попасть в ответ, поэтому разовая проверка не годится как замер. Отчёт о видимости без числа повторов на вопрос и разброса результата нельзя считать надёжным. Считать надо долю ответов с сайтом на серии повторов одного и того же вопроса и вместе с ней погрешность.
Почему поиск ChatGPT на один и тот же вопрос даёт разные ответы
Поиск ChatGPT не отправляет вопрос как есть. По документации OpenAI, он обычно переписывает его в один или несколько запросов к поисковым партнёрам, а после первых результатов может отправить ещё более конкретные. Такие внутренние запросы называют fan-out: один вопрос человека расходится на несколько поисковых. На них влияют сохранённая память и местоположение, поэтому у разных людей запросы могут различаться.
Что именно меняется при повторе: запросы в поиск, найденные страницы или только текст ответа? Точного ответа нет, зато сам разброс измеряли. В эксперименте SparkToro было 2961 запуск, и, по пересказу RivalHound, список брендов совпал меньше чем в одном прогоне из 100, а совпадение ещё и по порядку встретилось реже чем в одном из 1000. Я думал, совпадений будет больше. Страницы-источники SparkToro не считал, зато аудит Uberti-Bona Marin и коллег на arXiv показал похожее на товарах: рекомендации часто меняются при повторных запросах.
Что считать видимостью сайта в ChatGPT, если ответы всё время разные
Вероятность напрямую не увидеть, поэтому считают её оценку: долю ответов на серии повторов одного вопроса, где сайт есть среди источников ChatGPT. Похоже устроена метрика Seer Interactive: ответы, где назван бренд, делятся на все отслеживаемые ответы на вопросы покупателей. Seer считает бренд по всем таким вопросам, здесь же считается сайт на повторах одного вопроса. В собственном замере ответов ИИ-моделей я тоже повторял одни и те же вопросы и сохранял логи.
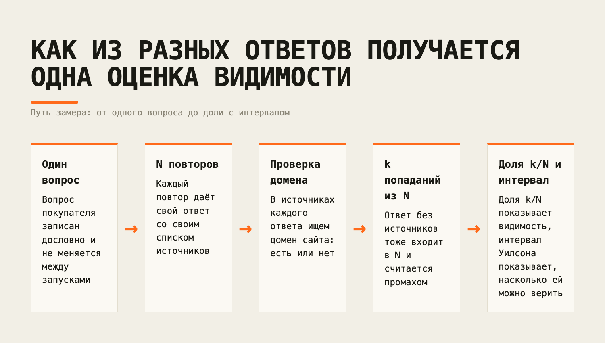
Допустим, настоящая доля сайта 30%, число условное. Тогда в каждом отдельном запуске его нет с вероятностью 70%: вчера был, сегодня нет, и это обычное дело. По одному запуску не заметить и падение с 30% до 10%: оба раза вы увидите только есть или нет.
В обычном чате видны только ссылки в ответе, их и считайте. Если снимать ответы через API, то есть программно, без окна чата, можно считать и все страницы, которые ChatGPT просмотрел: поле sources отдаёт их полный список, и он обычно длиннее списка цитат. Критерий между замерами менять нельзя, иначе доли не сравнить.
Как посчитать долю ответов с сайтом и погрешность: код на Python
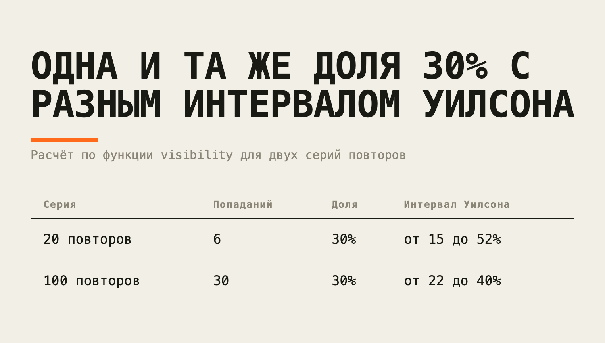
Одной доли мало: 6 попаданий из 20 и 30 из 100 дают те же 30%, но второй результат надёжнее, не правда ли? Погрешность показывает интервал Уилсона: диапазон, в котором при таком числе повторов с большой вероятностью лежит настоящая доля. Обычная формула p ± z·√(p(1−p)/n) может дать невозможные границы: при 1 попадании из 20 нижняя уходит ниже нуля. Поэтому NIST, американский институт стандартов, приводит формулу Уилсона, предложенную ещё в 1927 году. В statsmodels она уже есть.
from urllib.parse import urlparse
from statsmodels.stats.proportion import proportion_confint

def has_site(urls, domain):
    hosts = ((urlparse(u).hostname or "").removeprefix("www.") for u in urls)
    return any(h == domain or h.endswith("." + domain) for h in hosts)

def visibility(answers, domain, alpha=0.05):
    # answers: список ответов, в каждом — список URL источников
    n = len(answers)
    k = sum(has_site(urls, domain) for urls in answers)
    low, high = proportion_confint(k, n, alpha=alpha, method="wilson")
    return k / n, low, high
Вызов выглядит так:
# answers: по одному списку URL источников на каждый повтор вопроса, например:
answers = [
    ["https://itl.nist.gov/div898/handbook/prc/section2/prc241.htm", "https://www.statsmodels.org/v0.13.5/generated/statsmodels.stats.proportion.proportion_confint.html"],  # повтор 1: два источника
    ["https://itl.nist.gov/div898/handbook/prc/section2/prc241.htm"],  # повтор 2: один источник
    [],            # повтор 3: источников нет
]
# domain: ваш домен
p, low, high = visibility(answers, domain)
Функция вернёт долю p и границы интервала low и high: при 6 попаданиях из 20 это 30% и примерно от 15 до 52%. Функция has_site засчитывает поддомены за сайт: поддомен идёт в зачёт основному домену, а домен передаётся в нижнем регистре и без www. Ответ без источников тоже входит в n и считается промахом. С обоими порогами можно спорить.
При 6 попаданиях из 20 получается 30% и интервал примерно от 15 до 52%: сайт может оказаться и редким гостем, и появляться почти в каждом втором ответе. При 30 из 100 те же 30% дают интервал примерно от 22 до 40%.
Сколько раз повторять вопрос ChatGPT, чтобы результату можно было верить
Для ошибки в 10 процентных пунктов в обе стороны нужно 97 повторов одного вопроса, для 20 пунктов хватит 25. Пункты считаются в самих процентах: при доле 30% ошибка ±10 пунктов значит диапазон примерно от 20 до 40%. Считается это по консервативной оценке с долей 0,5: по NIST, она даёт наибольший необходимый размер выборки, так что при любой настоящей доле повторов хватит.
from math import ceil

def repeats_needed(margin, z=1.96):
    return ceil(z**2 * 0.25 / margin**2)
Значения при уровне доверия 95%, ему соответствует z = 1,96:
Допустимая ошибка | Повторов на вопрос |
|---|---|
±20 пунктов | 25 |
±15 пунктов | 43 |
±10 пунктов | 97 |
±5 пунктов | 385 |
Рэнд Фишкин из SparkToro советует спрашивать обычно не менее 60–100 раз и усреднять. Верхняя граница его совета, 100 повторов, как раз даёт ошибку около 10 пунктов, нижняя грубее. Точность дорого стоит: ради ±5 пунктов один вопрос придётся задать 385 раз. При меньше чем 25 повторах ошибка больше 20 пунктов, и падение с 30% до 10% уже не отличить от случайности. Если доля у сайта низкая, интервал будет уже, чем в таблице: функция visibility покажет его на ваших данных.
Как проверить видимость сайта в ChatGPT и не обмануть себя случайным результатом
Выбрать вопрос, который задают покупатели, и записать его дословно.
Закрепить, что считается попаданием: ссылка в ответе или, при сборе через API, любая просмотренная страница.
Задать вопрос нужное по таблице число раз в одних условиях: на запросы поиска влияют память и местоположение.
Посчитать долю и интервал функцией visibility.
Сравнивать замеры по интервалам: если они не пересекаются, разнице можно верить, если пересекаются, падение может быть случайным.
Отчёту подрядчика, где вопрос задан один раз, верить нельзя. Авторы аудита на arXiv пишут, что отдельные ответы нельзя считать тем, что реально видит покупатель. Верить можно отчёту, где для каждого вопроса есть число повторов, доля и интервал, а условия, в которых снимали ответы, не менялись.
Ответы через API расходятся с тем, что человек видит в чате ChatGPT
Код считает то, что вы сняли, и замер через API не равен тому, что видит пользователь. По аудиту Uberti-Bona Marin и коллег на arXiv, домены-источники в API и в интерфейсе одной системы пересекаются в среднем всего на 12,0% у ChatGPT и на 14,8% у Gemini. Цифры API-замера нельзя выдавать за видимость для людей. К тому же в API ИИ-модель сама решает, искать ли в сети, и такой ответ без поиска код засчитает как промах.
Что в этих цифрах неточно. SparkToro измерял списки брендов, страницы могут вести себя иначе. Интервалы и число повторов здесь моя арифметика по формулам NIST, в исследованиях этих чисел нет. Для сайта, которого в ответах почти нет, таблица повторов грубовата.
Поэтому исчезновение сайта из одного ответа само по себе ничего не значит: важно, пересекаются ли интервалы двух замеров. Считаете ли вы интервал на своих замерах и сколько повторов на вопрос ставите?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.