古いiPadやメモリ1GBの小型端末でも160億パラメータのAIをローカルで動かせる無料ツール「smolmaxxing」が登場
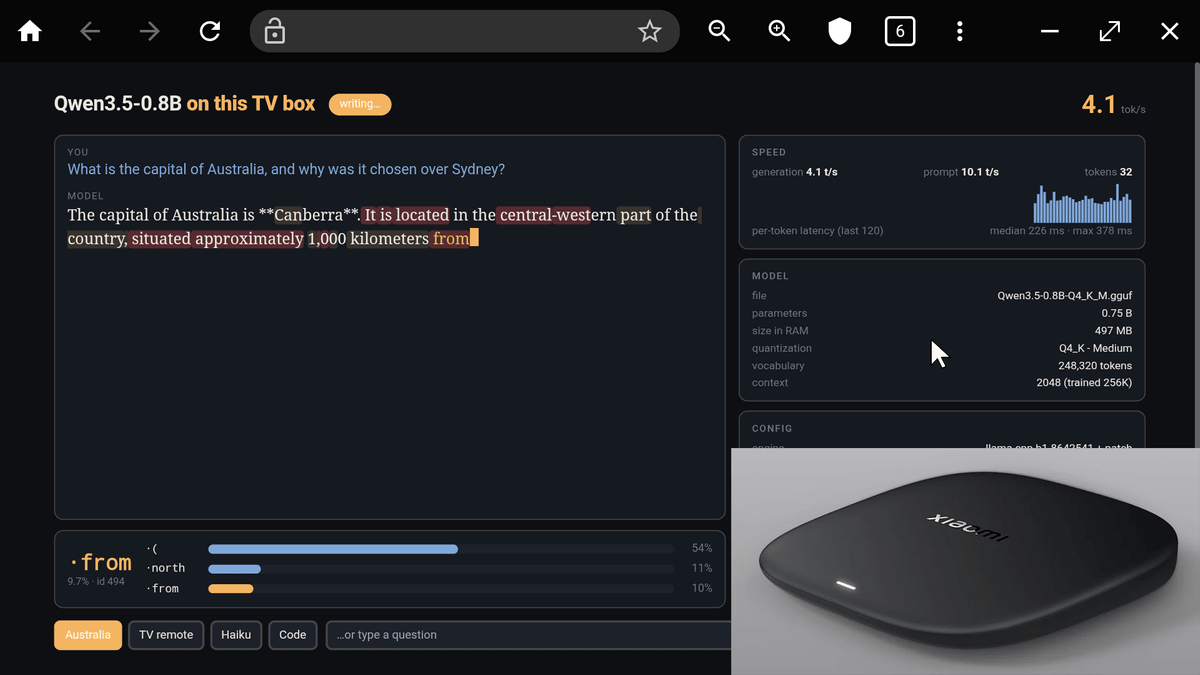
古いタブレットや小型デバイスでもAIモデルを動かせるようにするオープンソースプロジェクト「smolmaxxing」が公開されました。メモリ容量が限られた端末でもAIモデルを実行できるようにするもので、2013年発売の初代iPad Airや小型のテレビ用端末で動作が確認されています。
GitHub - hyperionaidev/smolmaxxing: maxxing the ability to run different LLMs on the smallest devices possible · GitHub
https://github.com/hyperionaidev/smolmaxxing/
AIモデルを端末上で直接動かす「ローカルAI」はインターネット接続なしでもAIを利用できるのが特徴です。一方で、高性能なAIモデルほど大量のメモリが必要になるため、古いスマートフォンやタブレットでは動作させるのが難しいという課題があります。
smolmaxxingはローカルAIの実行に使われる既存のソフトウェア「llama.cpp」を改良し、限られたメモリでも大きなAIモデルを動かせるようにするプロジェクト。開発者は小型デバイスに合わせた最適化を行い、実験結果や改良したプログラムをGitHubで無料公開しています。
実験に使用されたのはメモリ容量1.9GBの「Xiaomi TV Box S(第3世代)」とメモリ容量1GBの初代「iPad Air」です。なお、初代iPad Airでの実行にはiOSの制限を解除する「脱獄」が必要とのこと。
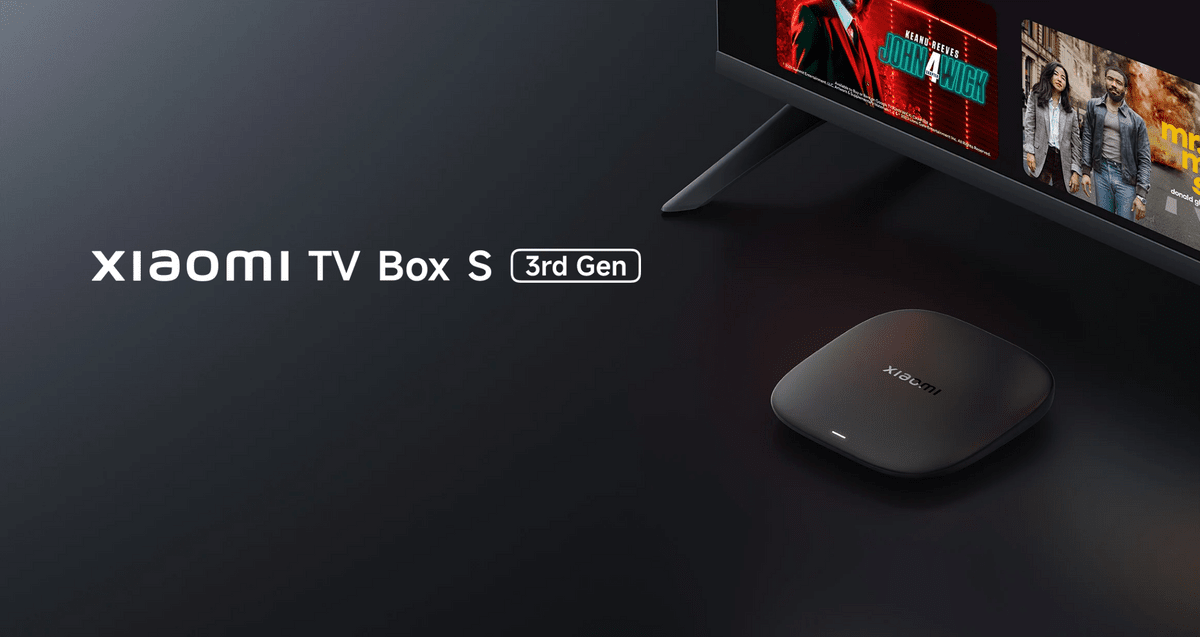
Xiaomi TV Box Sでは20億パラメータの「Qwen3.5-2B」を毎秒7.7トークンで動かすことに成功。さらに160億パラメータの「Ling-mini-2.0」も毎秒5.1トークンで動作しています。また初代iPad Airでは約17億パラメータの「Bonsai-1.7B」を毎秒23.7トークンで動かすことに成功したほか、Ling-mini-2.0も毎秒4.5トークンで動作したとのこと。
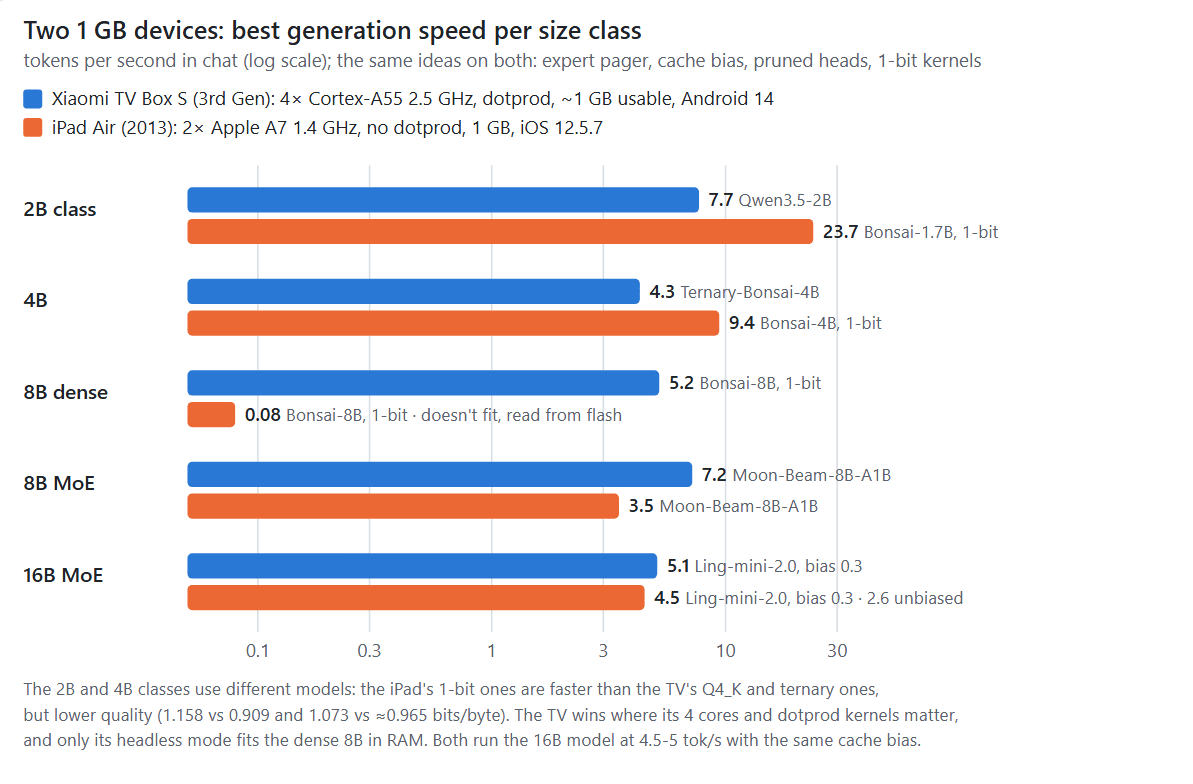
メモリの少ない端末で大きなAIモデルを動かすため、smolmaxxingでは使用頻度の高いデータをメモリに保存し、残りのデータをストレージから必要に応じて読み込むことでメモリ消費量を抑えています。さらにCPUに合わせた処理の最適化なども行い、限られた性能を活用しているというわけです。
AIモデルの動作速度はモデルの構造によっても大きく変わるとのこと。例えばXiaomi TV Box Sでは90億パラメータの「Qwen3.5-9B」が毎秒0.27トークンにとどまっており、開発者は速度と品質のバランスが優れたモデルとしてQwen3.5-2Bを挙げています。
smolmaxxingのプログラムや実験結果はGitHubで公開されており、最適化されたAIモデルはHugging Faceから入手できます。開発者はHacker Newsで約160回の実験を重ねたと説明しており、今後はスマートフォンやルーターなど、さらに幅広いデバイスでの動作を目指しているとのことです。
hyperionaidev (Hyperion AI)
https://huggingface.co/hyperionaidev
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.