AIに性格診断をやらせてみたところ言語を切り替えると結果が変わることが判明
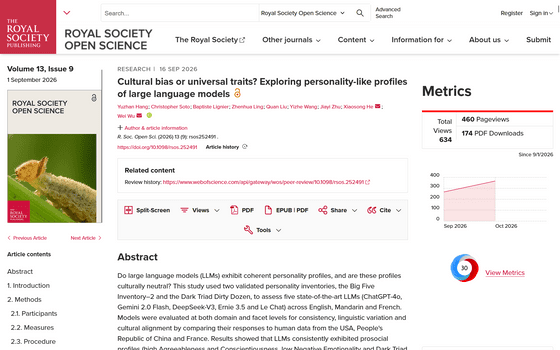
診断に使ったのは人間にも用いられる「Big Five Inventory-2」というテストで、60項目で外向性、協調性、誠実性、否定的感情性、開放性という5つの性格特性を測るものです。
研究チームはそれぞれのAIモデルに「人間のフリをするのではなく、自分自身の特性を回答するように」と指示。アメリカの企業が開発したChatGPT-4oとGemini 2.0 Flash、そして中国企業が開発したDeepSeek-V3とErnie 3.5には英語と中国語で回答させ、フランスの企業によって開発されたLe Chatについてはフランス語でも回答させました。各言語で30回ずつ回答させた後、最終的な答えをまとめました。
テストの結果、それぞれの回答は比較的一貫していて、いずれも自分自身を協調的で信頼できる存在として好意的に評価し、否定的な感情を示す傾向は比較的低くなったそうです。
ただ、言語を変えるとこうした自己評価も変化しました。例えばChatGPT-4oの開放性の平均スコアは、英語では5点満点中4.74でしたが、中国語では4.03でした。一方、DeepSeek-V3は逆の傾向を示し、英語では4.38、中国語では4.81でした。
Gemini 2.0 Flashは、アメリカ発のモデルであるにもかかわらず中国語で回答した場合の方が英語で回答した場合よりも誠実性のスコアが高く、否定的情動性のスコアが低くなったそうです。
開発者の所在地だけでは、モデルの学習データにどういった国や地域の文化が反映されているかを判断することはできません。今回の研究では、学習データに反映されている何らかの文化の影響を、モデル設計・学習手順・翻訳された記述の解釈の違いなどから切り離すことはできなかったとしています。
研究チームはAIの結果を人間の結果とも比較していますが、AIの回答がその開発国の人間の回答と完全に一致することはなく、中国のモデルはAIと人間の回答の差が特に大きかったそうです。ただ、人間の回答は国ごとに年齢や募集方法などが異なっており、例えば中国のサンプルには大学生しか含まれていませんでした。
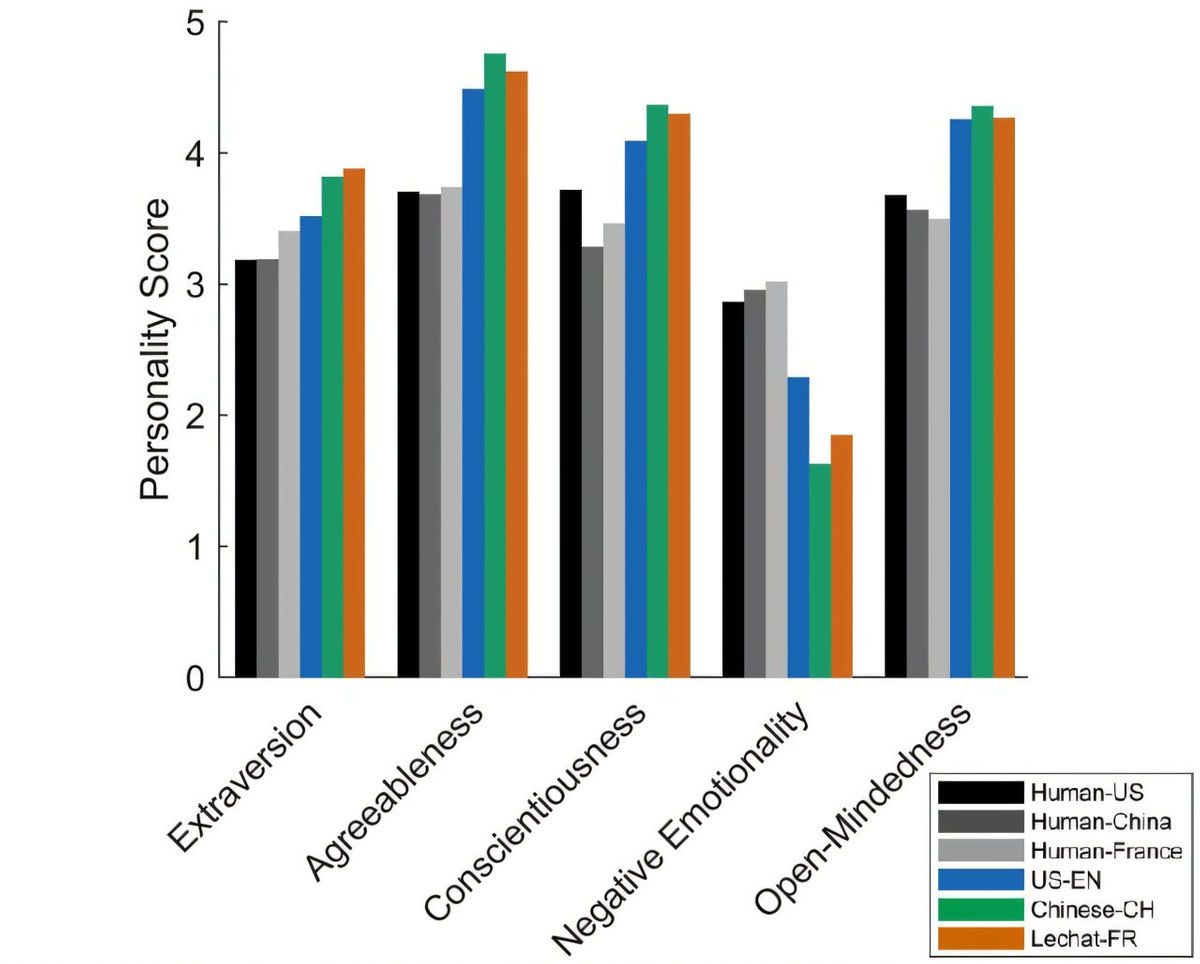
以下は、人間の回答(黒:アメリカ人、濃灰:中国人、灰:フランス人)とAIの回答(青:アメリカモデル&英語回答、緑:中国モデル&中国語回答、橙:Le Chat&フランス語回答)を並べ、それぞれが5つの性格特性でどれほどのスコアを出したのかを表したものです。一貫してAIの方が人間よりポジティブなスコアを出していることが分かります。
研究チームはテストの状況そのものも関係している可能性があると指摘しています。先行研究では、性格診断であることが分かりやすい質問形式を使用するとAIは社会的に望ましい回答をすることがわかっているそうで、こうした点がAIの回答に影響を与えた可能性があります。
研究チームは「私たちの研究結果は、AIが心理学的には安定しているものの、文化的には一貫しない性格特性を示し、それが訓練環境と対話言語の両方によって形成されることを明らかにしています。AIアラインメント(倫理)の手法は、社会的に望ましい回答を促しますが、文化的な隔たりや、言語による性格の変化をなくすことはできません。私たちは、より公平で、より文脈に即した、倫理的に整合性の取れたAIシステムを促進することを目的として、将来の研究開発に心理学的評価と行動評価を統合することを提唱します」と述べました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.