AIを低遅延実行するための推論エンジン「Liquid RIPL」が登場、検索や決済などの低遅延が重要な場面で役立つ
AI開発企業のLiquid AIが低遅延性を重視した推論エンジン「Liquid RIPL」を発表しました。
RIPL: Real-time Intelligence When Every Millisecond Counts | Blog | Liquid AI
https://www.liquid.ai/blog/low-latency
「検索ランキング生成」「商品レコメンドシステム」「決済承認」といった処理にAIを用いる場合は、いかに遅延を小さくするかが重要となります。Liquid RIPLは低遅延性を重視して開発された推論エンジンで、Liquid AI製モデルと組み合わせて高速な応答を実現します。
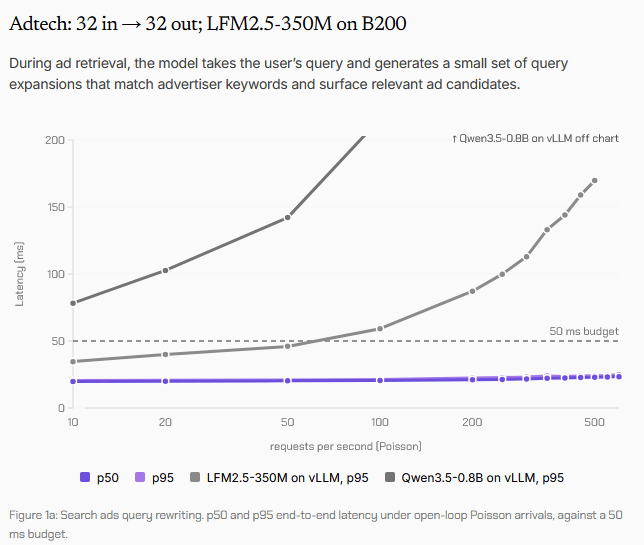
以下のグラフは「LFM2.5-350MをLiquid RIPLで実行(青および紫)」「LFM2.5-350MをvLLMで実行(灰色)」「Qwen3.5-0.8BをvLLMで実行(黒)」という条件での遅延を比較したグラフで、横軸が秒間リクエスト数、縦軸が遅延の長さを示しています。LFM2.5-350M同士で比較しても、Liquid RIPLの方が遅延を低く抑えられていることが分かります。
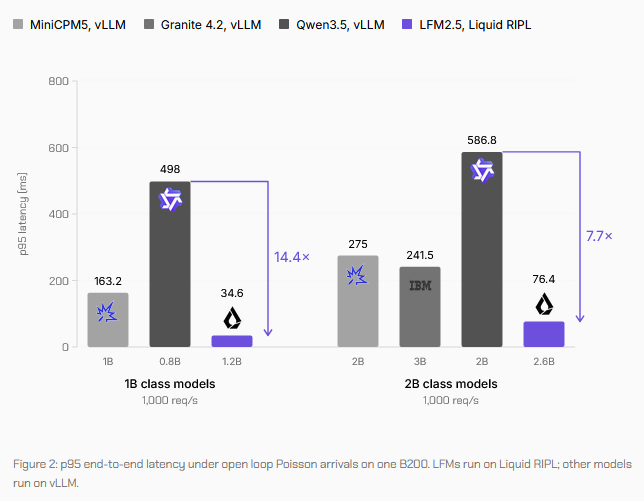
「MiniCPM5をvLLMで実行」「Granite 4.2をvLLMで実行」「Qwen3.5をvLLMで実行」「LFM2.5をLiquid RIPLで実行」という条件の遅延を比較した結果が以下。LFM2.5-1.2BをLiquid RIPLで実行した場合、Qwen3.5-0.8BをvLLMで実行するよりも遅延を14.4分の1に抑えることができます。
Liquid RIPLはH200やRTX Pro 6000といったNVIDIA製GPU上でLiquid AI製モデルを実行する用途に活用可能。料金の詳細は明らかにされておらず、利用を検討する企業がLiquid AIの営業チームに問い合わせる必要があります。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.