Profile‑Guided Optimization в.NET runtime: как это устроено и чем отличается от Go compiler и HotSpot
Компилятор может многое узнать о программе, даже не запуская её. Но есть вещи, которые становятся понятны только под реальной нагрузкой — например, какой конкретный класс обычно скрывается за интерфейсом или какая ветка условия выполняется чаще.
Profile‑Guided Optimization (PGO) позволяет учитывать эту информацию при оптимизации. Компилятор получает профиль выполнения и на его основе решает, куда стоит потратить время и ресурсы, а какой код лучше оставить как есть. Разумеется, за это приходится платить: сбор статистики создаёт накладные расходы, а профиль не всегда точно отражает будущую нагрузку.
Меня зовут Дима Егоров. Раньше я разрабатывал на.NET, сейчас пишу на Java в Яндекс 360. Мне интересно, как устроены рантаймы и какие решения принимают JIT‑компиляторы: иногда знание этих деталей помогает разобраться с производительностью вполне обычного сервиса.
В статье покажу, что именно.NET узнаёт о работающем коде и как использует эти сведения. Затем сравню его подход с PGO в Go и с перекомпиляцией в Java HotSpot. По пути разберём девиртуализацию, инлайнинг, счётчики и on‑stack replacement — механизм, позволяющий переключиться на оптимизированный код, не дожидаясь следующего вызова метода.
Что такое Profile‑Guided Optimization
Сначала напомню, как работает JIT‑компилятор.NET. Он переводит промежуточный код IL во внутреннее представление (IR), выполняет оптимизации, затем переходит к более низкоуровневым преобразованиям: lowering, распределению регистров, размещению блоков и генерации машинных инструкций. В реальности этапов больше, но для нашей темы такой упрощённой схемы достаточно.
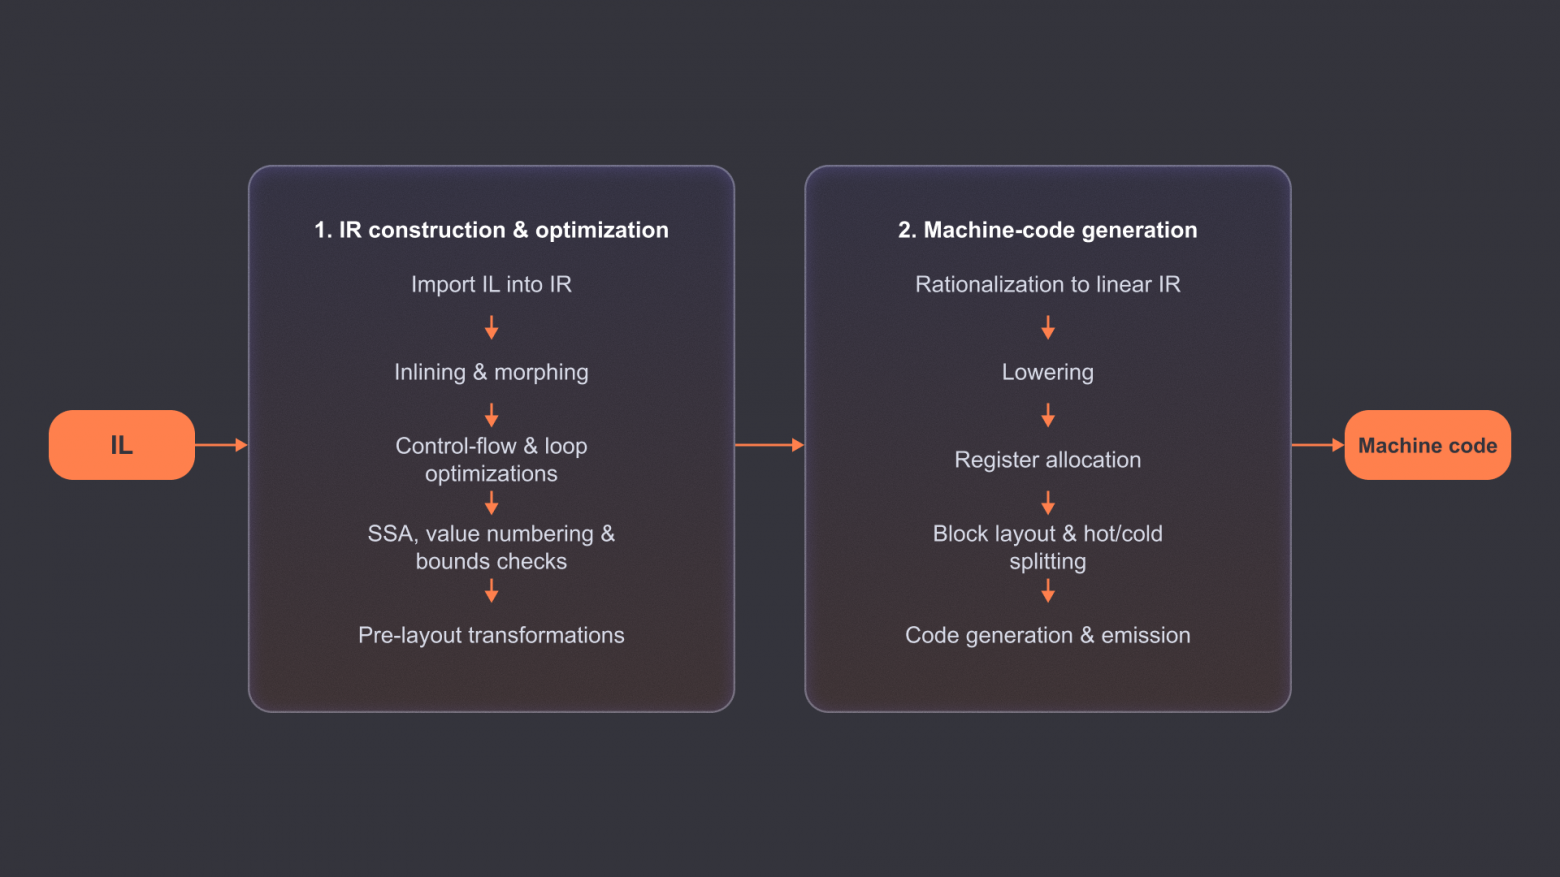
PGO не заменяет эти этапы и не добавляет отдельный «волшебный оптимизатор». При выборе оптимизаций компилятор может учесть, как часто выполняются разные участки кода.
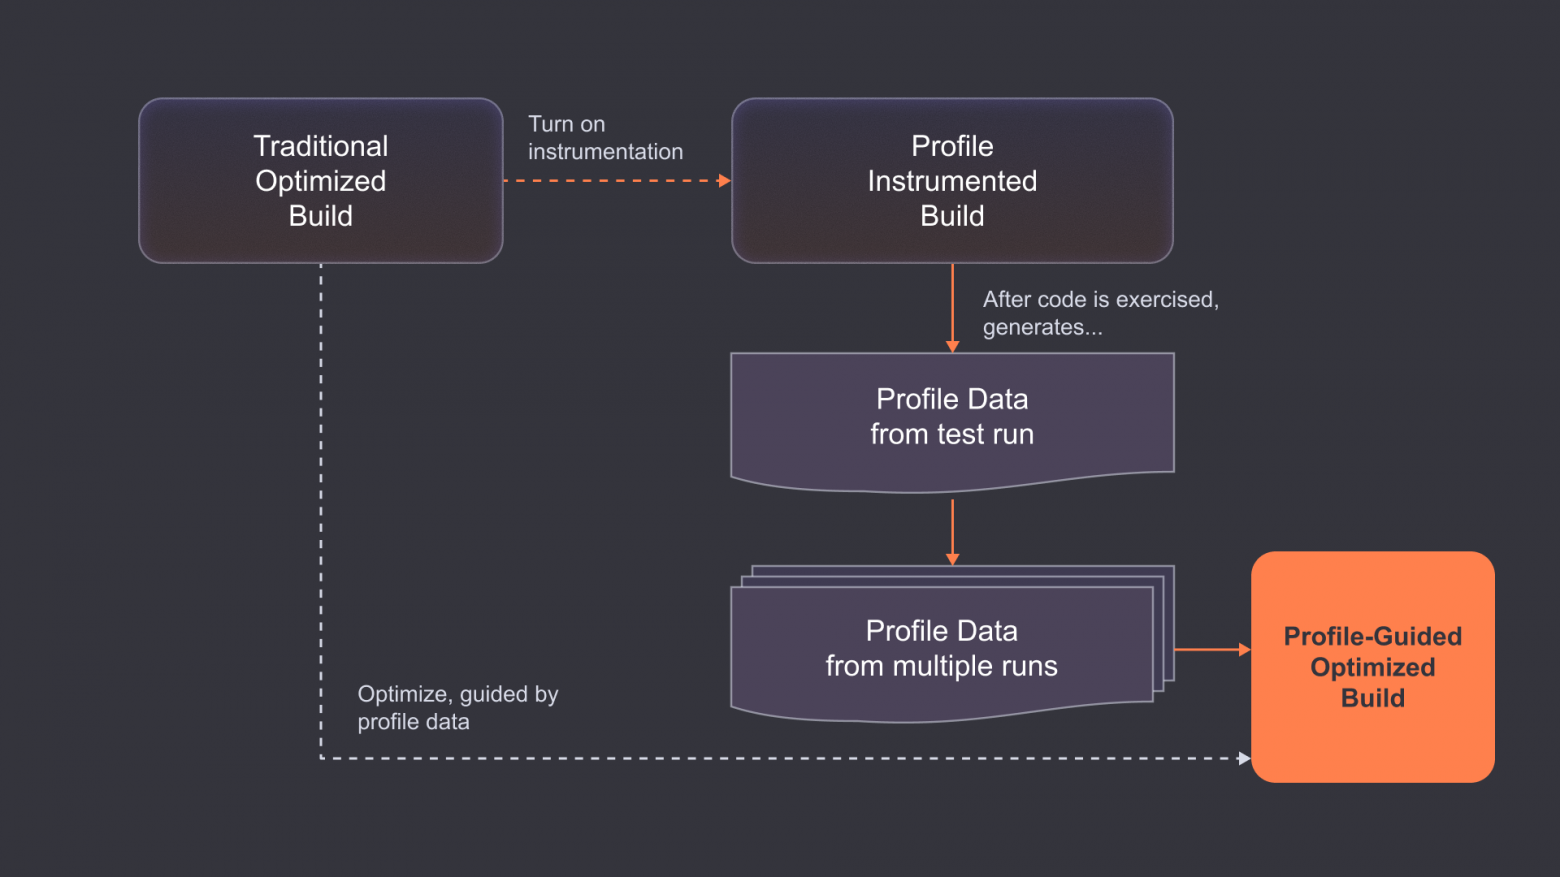
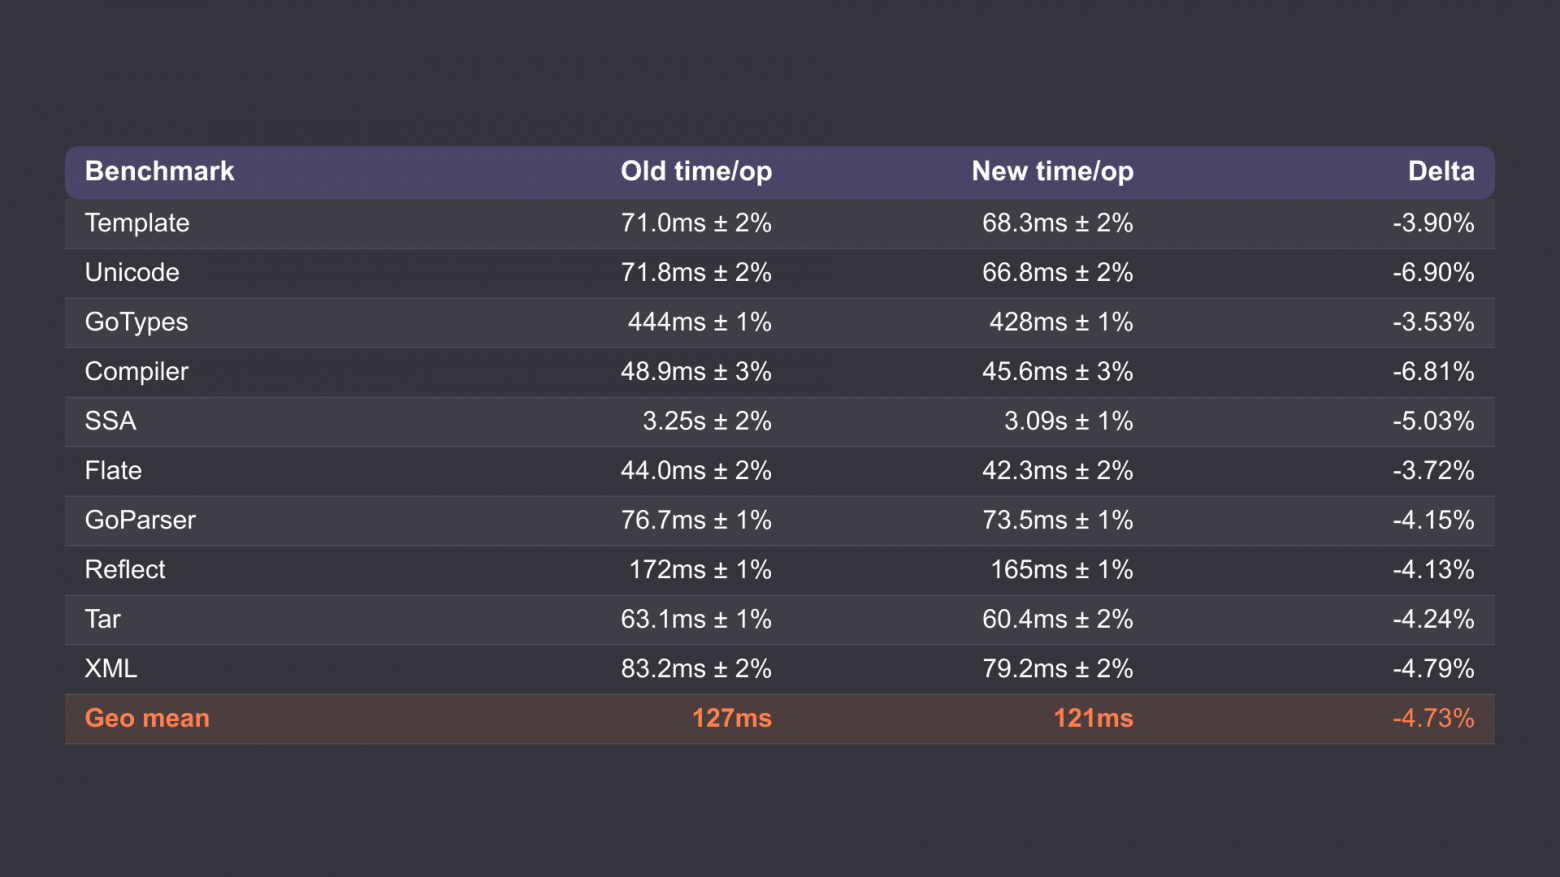
В бенчмарках компилятора Go сборка с PGO дала ускорение в нескольких сценариях. Но эффект зависит от программы и от того, насколько точно профиль отражает реальную нагрузку. Дополнительные примеры собраны в awesome‑pgo на GitHub.
Почему статического анализа недостаточно
Разработчик знает, как используется его приложение. При статическом анализе компилятор опирается на свойства, которые может вывести из кода. Например, мы можем знать, что два Span ссылаются на непересекающиеся области памяти. Для компилятора это не всегда очевидно: ему нужно сохранить правильное поведение и в остальных случаях.
Профиль отвечает на другой вопрос: не «что возможно?», а «что чаще всего происходит?». По профилю видно, какие ветки выполняются чаще и с объектами каких типов обычно происходит вызов через интерфейс. Даже если мы хорошо понимаем нагрузку на сервис, распределение типов в конкретном библиотечном методе может оказаться неожиданным.
Представим, что мы копируем данные:
[MethodImpl(MethodImplOptions.NoInlining)]
static void Copy(ReadOnlySpan<int> source, Span<int> destination)
{
    source.CopyTo(destination);
}
Допустим, в большинстве вызовов копируются десять чисел, то есть 40 байт.
Представим, что JIT собирает статистику о том, сколько байтов копирует Span.CopyTo. Тогда он мог бы выделить быстрый путь для 40 байт и оставить универсальное копирование для остальных размеров.
// Псевдокод гипотетической специализации
if (byteCount == 40)
{
    // Копируем фиксированные 40 байт несколькими SIMD-инструкциями.
}
else
{
    // Используем общий Memmove для произвольного количества байтов.
}
На что потратить бюджет оптимизаций
Компилятор не может бесконечно встраивать методы друг в друга. У него есть ограничения по времени компиляции и размеру итогового машинного кода. Из‑за инлайнинга код может разрастись и хуже помещаться в кеш инструкций.
Это похоже на задачу о рюкзаке: нужно выбрать самые полезные преобразования, которые укладываются в бюджет. Только в компиляторе решения взаимосвязаны. Встроили один метод — появились новые возможности для свёртки констант. Упростили выражение — часть дальнейших оптимизаций стала не нужна.
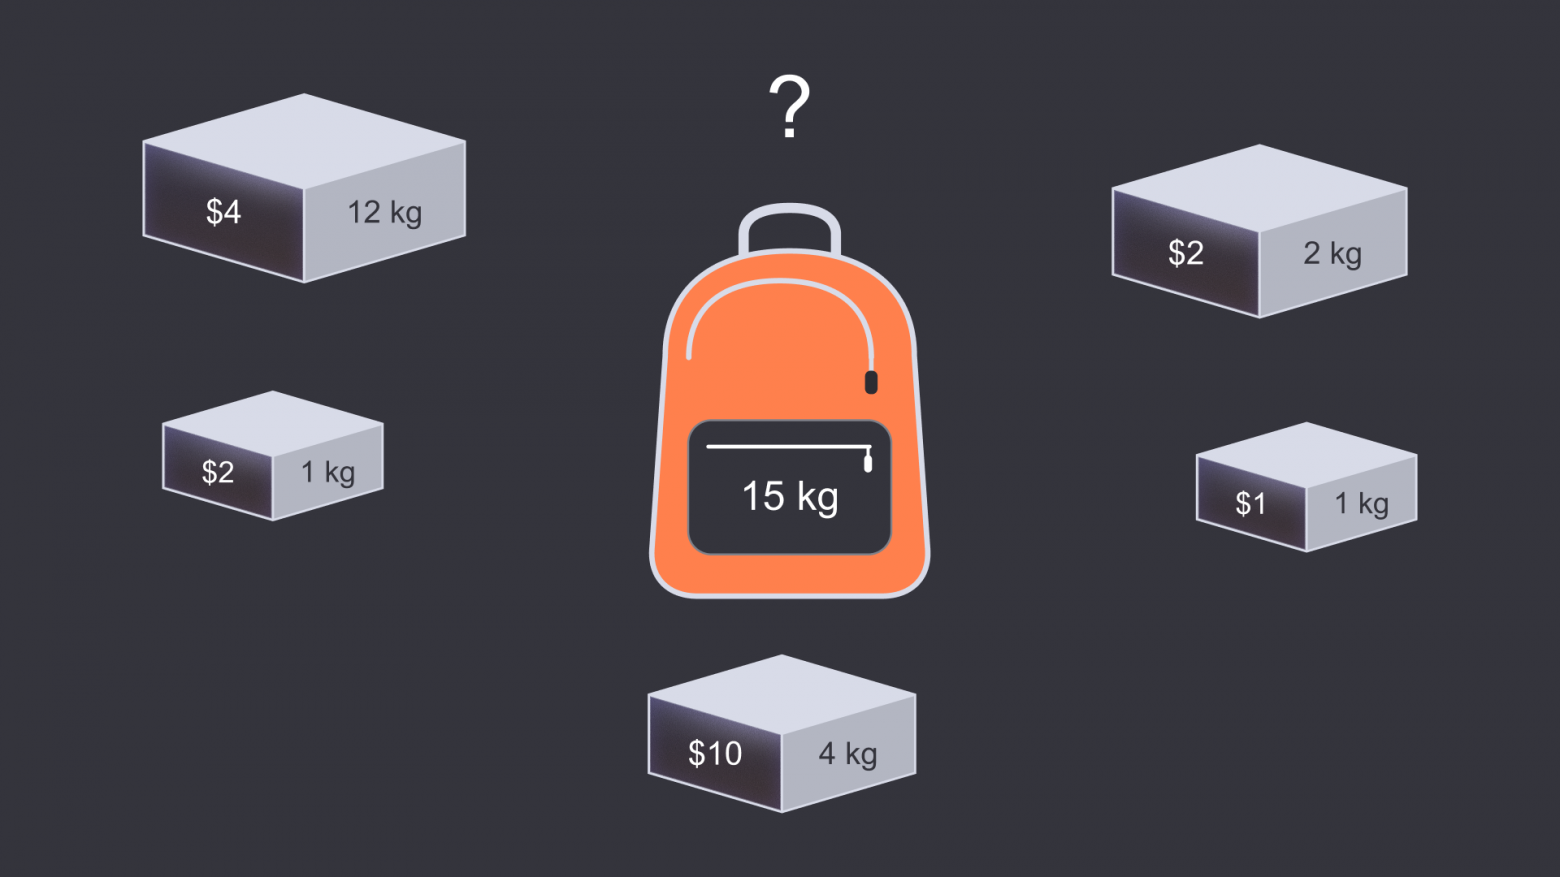
Профиль не принимает решения за компилятор. Зато помогает понять, где более дорогая оптимизация может окупиться.
Что JIT может оптимизировать по профилю
Девиртуализация и инлайнинг
Рассмотрим небольшой пример на C#:
public interface IWorker
{
    int Work(int x);
}

public sealed class Hot : IWorker
{
    public int Work(int x) => ((x + 1) * 3) - 7;
}

static int Run(IWorker worker, int n)
{
    int sum = 0;
    for (int i = 0; i < n; i++)
        sum += worker.Work(i);

    return sum;
}
Из сигнатуры Run известно только, что worker реализует IWorker. Профиль может показать, что в точке вызова worker.Work(i) почти всегда встречается Hot.
Тогда JIT может применить guarded devirtualization: сначала проверить фактический тип, а при совпадении перейти к специализированному коду. Для остальных объектов сохранится интерфейсный вызов.
if (ExactType(worker) == typeof(Hot))
{
    // Реализация известна: вызов девиртуализирован,
    // а тело Hot.Work встроено прямо сюда.
    sum += ((i + 1) * 3) - 7;
}
else
{
    // Для остальных типов сохраняется интерфейсный вызов.
    sum += worker.Work(i);
}
    // Для остальных типов сохраняется интерфейсный вызов.
    sum += worker.Work(i);
}
Здесь работают две разные оптимизации. После проверки типа JIT знает, что на быстром пути worker.Work(i) вызовет Hot.Work. Это результат девиртуализации. Инлайнинг позволяет вставить тело Hot.Work прямо в цикл. Сам вызов исчезает, а JIT может оптимизировать встроенный код с учётом того, что известно в Run. Например, если аргументы — константы, результат можно вычислить ещё при компиляции:
// До инлайнинга:
int result = Multiply(10, 3);

// После:
int result = 10 * 3;

// После свёртки констант:
int result = 30;
Инлайнинг возможен не всегда, и сам по себе он ещё не гарантирует свёртку констант.
Быстрая проверка типа
Похожая идея пригодится для проверки obj is B. Предположим, C наследуется от B, а профиль показывает, что чаще всего в этом месте встречается именно C. Если точный тип объекта — C, можно сразу вернуть true:
// Псевдокод. C наследует B.
if (obj == null)
    return false;
if (ExactType(obj) == typeof(C))
    return true;
// Для остальных типов нужна общая проверка.
return GeneralTypeCheck(obj, typeof(B));
Даже на быстром пути, кроме cmp, могут понадобиться загрузки и переходы. Общая проверка нужна, когда быстрый путь не сработал.
От интерфейсного вызова к устранению аллокации
Возьмём перечисление через IEnumerable<int>:
static int Sum(IEnumerable<int> values)
{
    int sum = 0;
    foreach (int value in values)
        sum += value;

    return sum;
}
За foreach здесь стоят GetEnumerator, последовательные вызовы MoveNext и Current, а в конце — Dispose. Если конкретный тип коллекции неизвестен компилятору, перечислитель в некоторых сценариях создаётся в куче или требует упаковки (boxing).
PGO может подсказать тип коллекции и перечислителя. Дальше JIT использует девиртуализацию, инлайнинг и анализ того, выходит ли объект за пределы метода (escape analysis). В отдельных сценариях это позволяет разместить перечислитель в стеке или вообще разложить его состояние по регистрам. Примеры таких преобразований есть в документе команды.NET о de‑abstraction и conditional escape analysis.
Возможность убрать аллокацию зависит от типа коллекции, доступной информации и версии рантайма. В документации приводятся как примеры успешного устранения аллокаций, так и случаи, где они сохраняются.
Другие практические примеры можно найти в разборах улучшений производительности.NET, которые публикует Стивен Туб.
Когда Go,.NET и HotSpot используют профиль
Главное различие между рассматриваемыми реализациями — когда собирают профиль и когда используют его для оптимизации.
Go обычно компилирует приложение заранее, в машинный код (AOT). CPU‑профиль собирают во время работы уже выпущенной версии сервиса. Затем передают его компилятору при следующей сборке, и оптимизации попадают в новый бинарный файл. Текущий процесс от этого сам по себе не меняется.
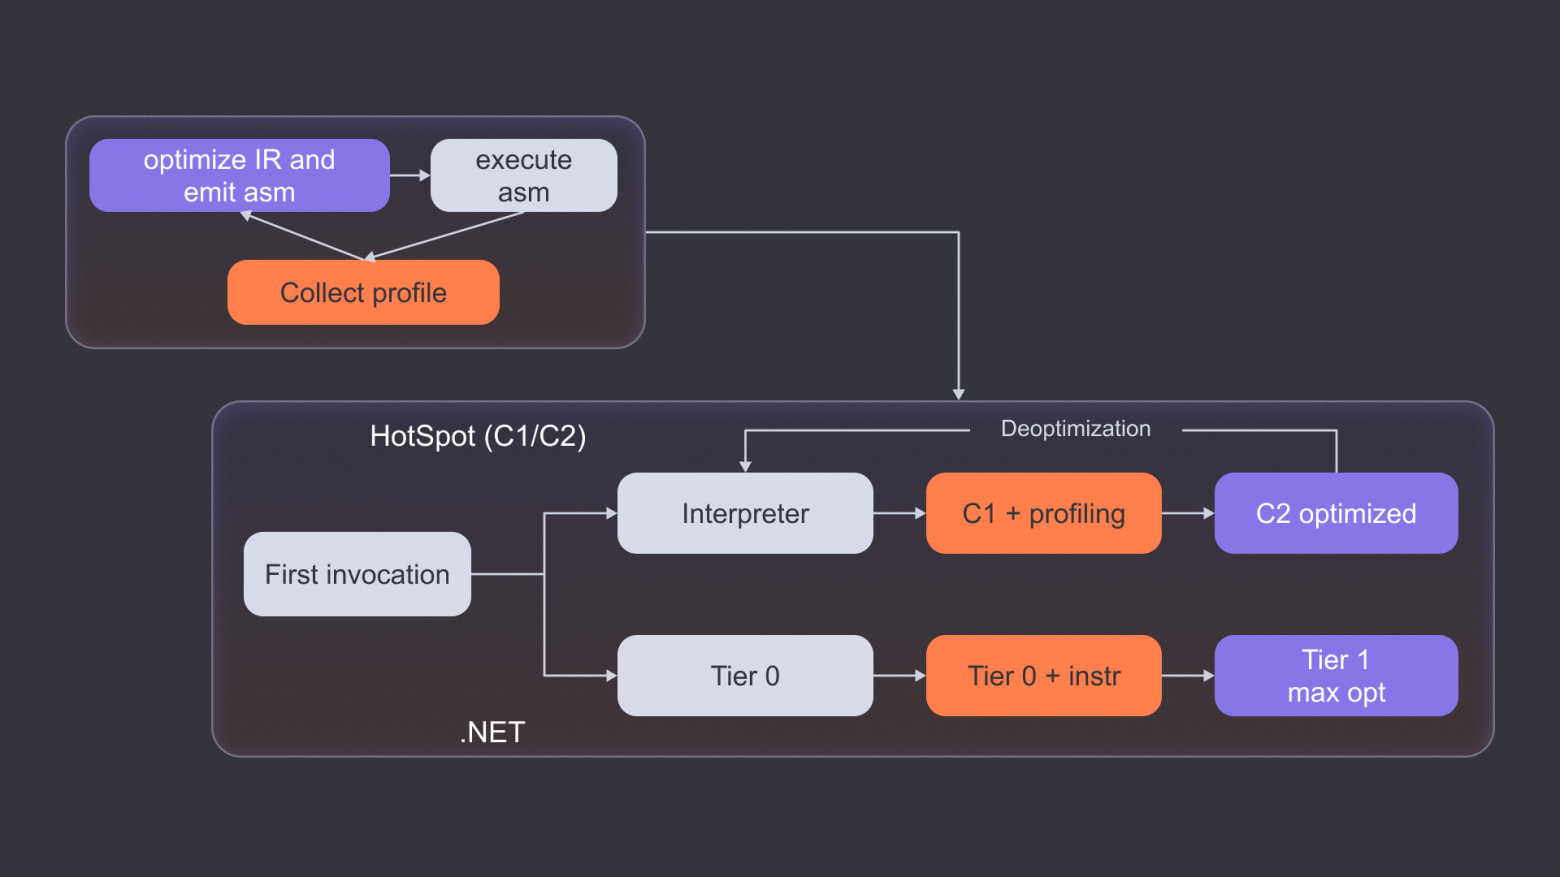
NET CoreCLR умеет использовать JIT‑компиляцию во время выполнения. Сначала метод может исполняться в более простой версии, затем рантайм собирает статистику и готовит более оптимизированную. В Java HotSpot тоже есть многоуровневая компиляция, а деоптимизация устроена иначе.
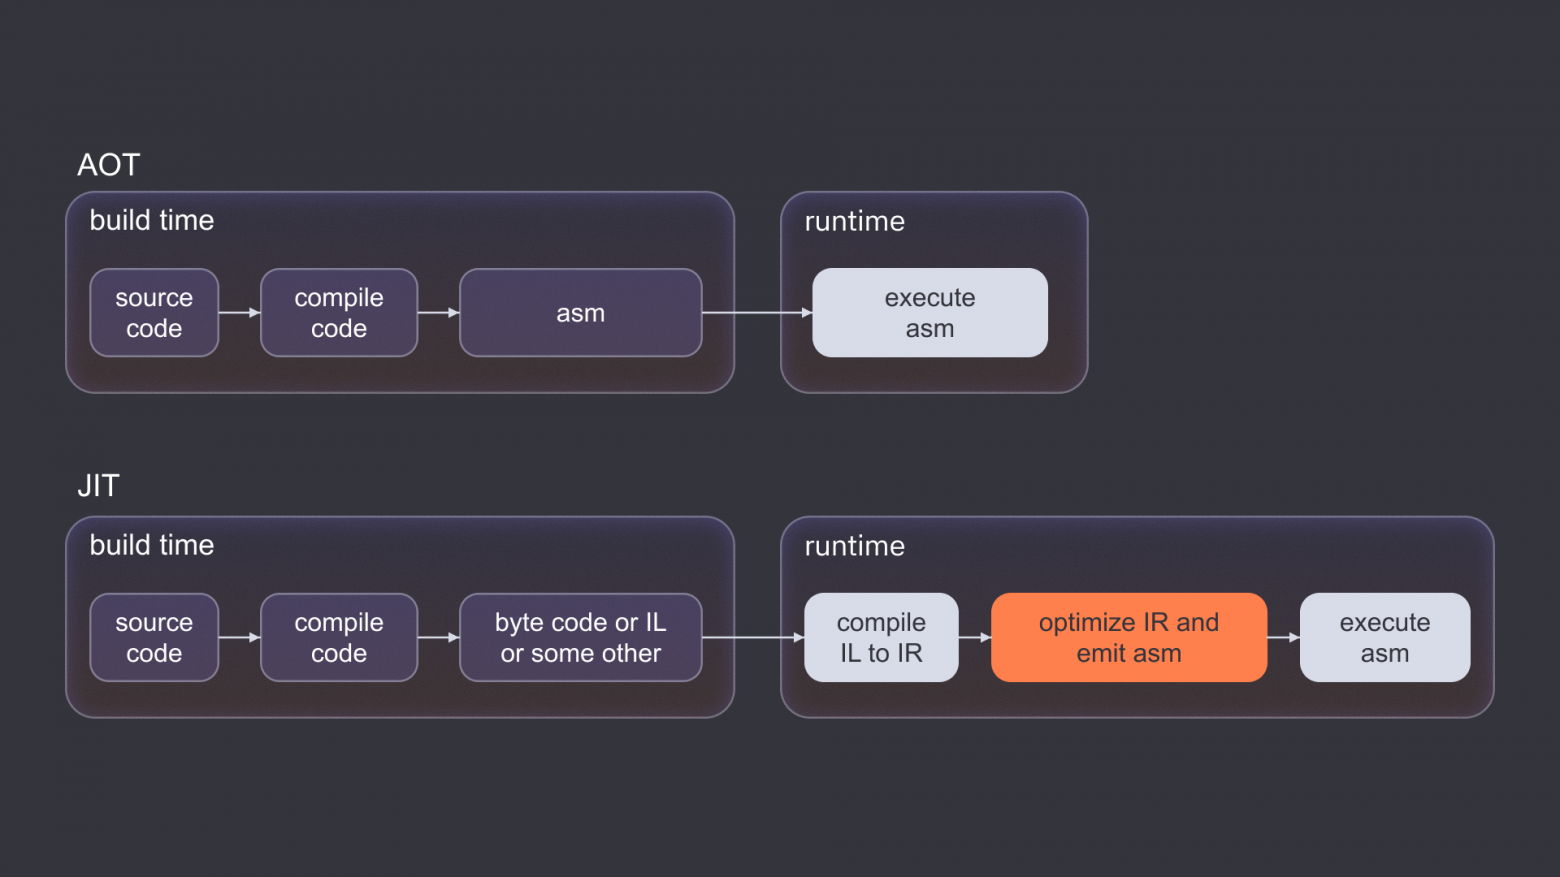
На схеме показаны типичные конфигурации Go, CoreCLR и HotSpot. У.NET есть и Native AOT, а у Java — другие варианты исполнения и предварительной компиляции. Подробнее о Native AOT — в докладе «Native AOT. Возможности и ограничения».
Сборка с профилем в Go
Для PGO в Go используется CPU‑профиль в формате pprof. Снимаем профиль работающего сервиса под типичной нагрузкой. При следующей сборке go build подхватит default.pgo из каталога пакета main. Путь к другому файлу можно указать флагом -pgo.
Профиль строится по выборкам, поэтому можно обойтись без инструментирования каждой ветки. В выборках есть статистическая погрешность, а качество профиля зависит от того, под какой нагрузкой его сняли. Подробнее этот процесс описан в официальной документации Go.
Dynamic PGO в.NET: Tier 0 и Tier 1
В.NET профиль для Dynamic PGO собирается прямо в работающем процессе. Рантайм может отследить, какие участки кода выполняются чаще и какие типы там встречаются. Эти данные JIT использует при компиляции оптимизированной версии метода.
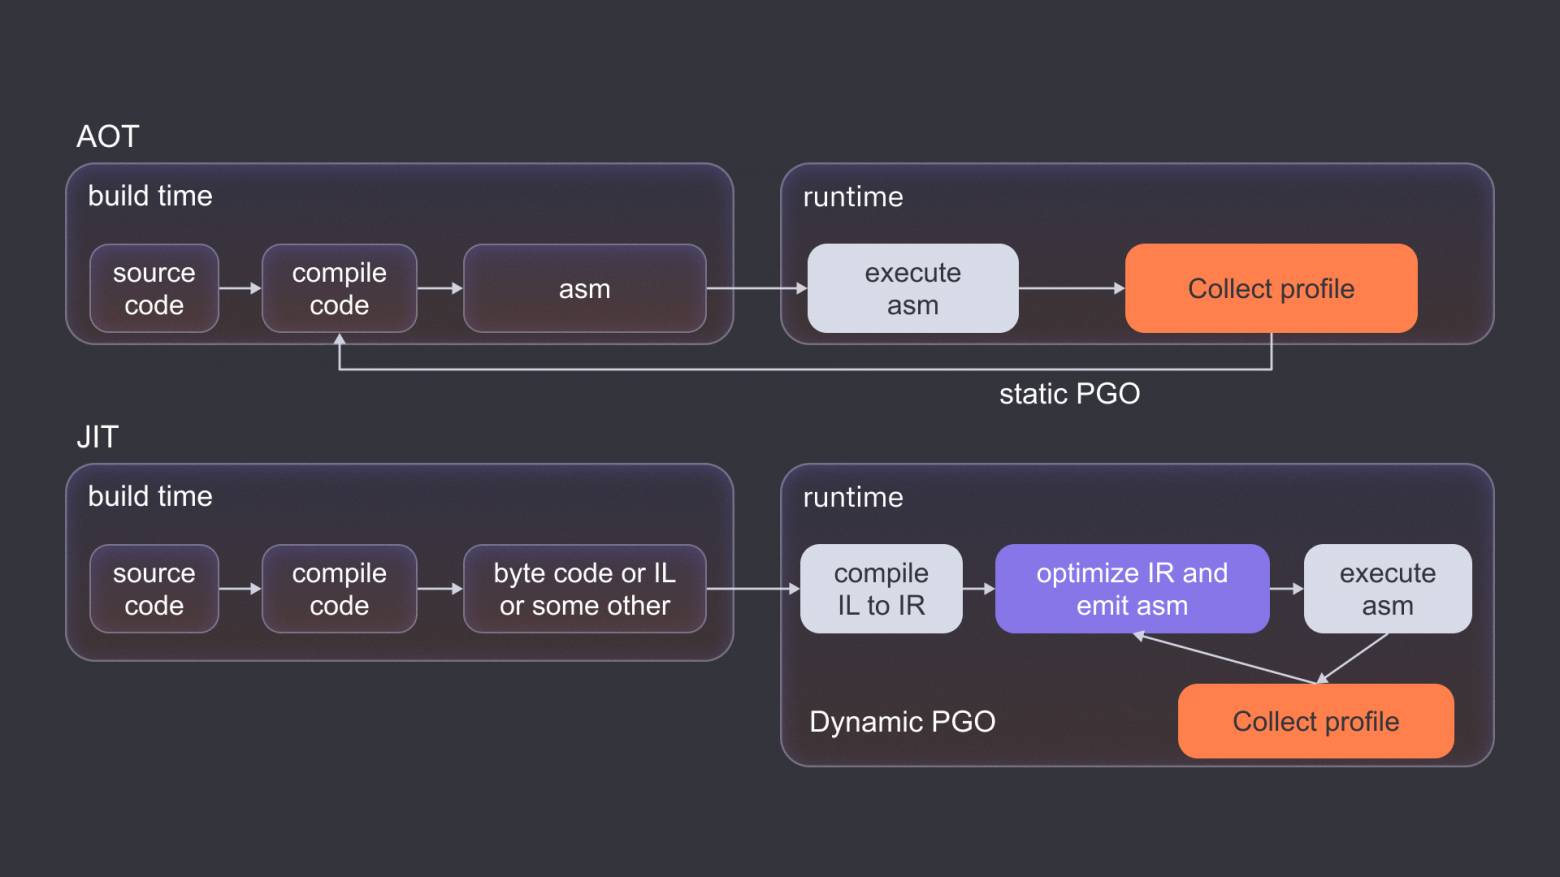
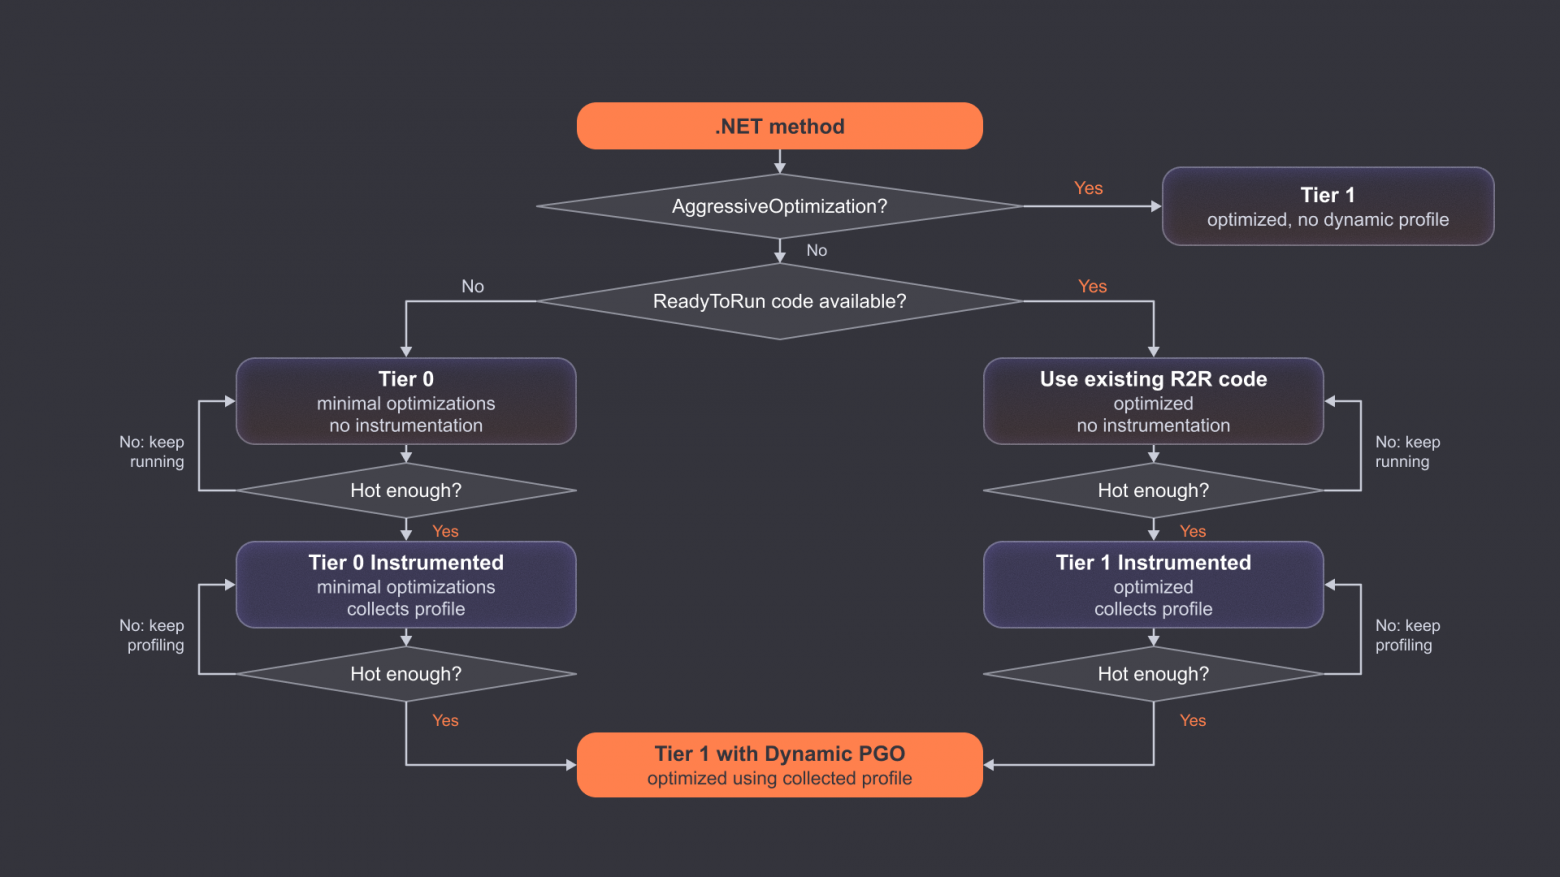
При многоуровневой компиляции (tiered compilation) JIT обычно сначала быстро компилирует метод в Tier 0, чтобы тот мог начать выполняться без долгой оптимизации. Если метод вызывается часто, рантайм может собрать профиль и скомпилировать оптимизированную версию Tier 1.
Порядок не всегда одинаков. На него влияют настройки рантайма, наличие ReadyToRun‑кода и то, собирается ли профиль для этого метода.
Сравним ARM64-код двух версий метода: Tier 0 Instrumented и Tier 1 Instrumented. Обе версии ещё собирают статистику, но во второй JIT уже применил больше оптимизаций.
Tier 0 Instrumented:
G_M000_IG02:                 ;; offset=0x0018
    ldr     x0, [fp, #0x20]
    str     x0, [fp, #0x18]
    ldr     x0, [fp, #0x18]
    movz    x1, #0x6EC0
    movk    x1, #0xBB2 LSL #16
    movk    x1, #1 LSL #32
    bl      CORINFO_HELP_CLASSPROFILE32
    ldr     x0, [fp, #0x18]
    str     x0, [fp, #0x10]
    ldr     x0, [fp, #0x10]
    movz    x11, #464
    movk    x11, #0xA4B LSL #16
    movk    x11, #1 LSL #32
    ldr     xip0, [x11]
    blr     xip0
Tier 1 Instrumented:
G_M000_IG02:                 ;; offset=0x0010
    mov     x0, x19
    movz    x1, #0x9CB0
    movk    x1, #0x8E5 LSL #16
    movk    x1, #1 LSL #32
    bl      CORINFO_HELP_CLASSPROFILE32
    mov     x0, x19
    movz    x11, #208
    movk    x11, #0x782 LSL #16
    movk    x11, #1 LSL #32
    ldr     xip0, [x11]
    blr     xip0
В первом фрагменте заметно больше обращений к стеку: по обращениям [fp, #...] видно, где ldr читает из стека, а str пишет в него.
В обеих версиях остался вызов CORINFO_HELP_CLASSPROFILE32. Эта функция собирает сведения о типе объекта в точке вызова. Обе версии инструментированы: они собирают профиль для дальнейшей оптимизации.
Чем отличается Java HotSpot
Допустим, JIT в.NET уже подготовил оптимизированную версию Tier 1 с учётом собранного профиля. При обычной многоуровневой компиляции она не будет автоматически пересобираться при каждом изменении распределения типов. Если проверка типа не проходит, код выполняется по общему пути.
HotSpot может действовать иначе: если тип объекта оказался другим, чем предполагал JIT, рантайм способен деоптимизировать код, восстановить состояние выполнения и позднее скомпилировать метод повторно с учётом нового профиля.
Вернёмся к IWorker, теперь на Java:
interface IWorker {
    int work(int x);
}

final class Hot implements IWorker {
    public int work(int x) {
        return ((x + 1) * 3) - 7;
    }
}

static int run(IWorker worker, int n) {
    int sum = 0;
    for (int i = 0; i < n; i++) {
        sum += worker.work(i);
    }
    return sum;
}
Предположим, во время прогрева run получал только объекты типа Hot, и компилятор C2 решил встроить Hot.work. Вот как может выглядеть run после такого встраивания:
int run(IWorker worker, int n) {
    int sum = 0;
    if (n <= 0)
        return sum;

    if (worker == null || worker.getClass() != Hot.class) {
        uncommon_trap_and_deopt();
    }

    for (int i = 0; i < n; i++) {
        sum += ((i + 1) * 3) - 7; // inlined Hot.work(i)
    }
    return sum;
}
Что будет, если вместо объекта Hot передать Cold? Проверка не пройдёт. HotSpot может деоптимизировать код, восстановить состояние вызова и продолжить выполнение в интерпретаторе. Если метод скомпилируют заново, компилятор сможет учесть обновившийся профиль — например, подготовить специализированные ветки для двух типов:
// Псевдокод возможной новой специализации.
if (worker.getClass() == Hot.class) {
    // Быстрый путь для Hot.
} else if (worker.getClass() == Cold.class) {
    // Быстрый путь для Cold.
} else {
    // Общий путь или деоптимизация.
}
Число типов, которые HotSpot может сохранить в профиле одной точки вызова, ограничивает параметр TypeProfileWidth. В.NET количество проверок для guarded devirtualization также настраивается, например параметром DOTNET_JitGuardedDevirtualizationMaxTypeChecks.
CoreCLR чаще сохраняет общий путь рядом с быстрым, а HotSpot способен отменить спекулятивную оптимизацию и заново скомпилировать метод с обновлённым профилем. Это не значит, что один рантайм всегда быстрее другого: цена и выгода зависят от поведения приложения.
Откуда берётся профиль: инструментирование и семплирование
Инструментирование в.NET
Для динамической PGO JIT может вставлять в выполняемый код дополнительные операции: счётчики переходов и вызовы помощников, которые записывают типы объектов. Разберём это на знакомом примере:
public static int Run(IWorker worker, int n)
{
    int sum = 0;
    for (int i = 0; i < n; i++)
    {
        sum += worker.Work(i);
    }

    return sum;
}
После инструментирования в промежуточном представлении JIT перед worker.Work(i) появляется вызов помощника, который записывает тип worker. Ниже — сокращённое дерево IR для этого участка метода:
STMT
└── STORE_LCL_VAR int V02 loc0
    └── ADD int
        ├── LCL_VAR int V02 loc0
        └── CALLV stub int IWorker:Work(int):int:this
            ├── COMMA ref [this]
            │   ├── STORE_LCL_VAR ref V05 tmp1
            │   │   └── LCL_VAR ref V00 arg0
            │   └── COMMA ref
            │       ├── CALL help void CORINFO_HELP_CLASSPROFILE32
            │       │   ├── LCL_VAR ref V05 tmp1 [arg0]
            │       │   └── CNS_INT long 0x10b5bd920 [arg1]
            │       └── LCL_VAR ref V05 tmp1
            └── LCL_VAR int V03 loc1 [arg1]
Здесь этот помощник обозначен как CORINFO_HELP_CLASSPROFILE32. Перед интерфейсным вызовом этот помощник получает ссылку на объект и данные, необходимые для записи профиля. Так рантайм узнаёт, какого типа объект в этой точке вызова.
Дополнительные узлы IR превращаются в машинные инструкции. Пока метод собирает профиль, он выполняет эти инструкции при каждом проходе через инструментированный участок. Последующая оптимизация может окупить эти затраты.
Почему неточные счётчики бывают полезнее точных
Пусть JIT хочет знать, сколько раз выполнялся участок кода. Самый простой вариант — count++. Он дешёвый, но, если несколько потоков пишут в одну переменную без синхронизации, часть инкрементов потеряется.
Interlocked.Increment обновляет счётчик атомарно, поэтому инкременты не теряются. lock тоже обеспечивает синхронизацию, однако добавляет свои расходы. Потоки могут конкурировать за одну строку кеша, даже если атомарная операция обходится без блокировки в ядре ОС.
Потоки могут конкурировать за одну строку кеша, даже если атомарная операция обходится без блокировки в ядре ОС.
А нужна ли компилятору точность до единицы? Для выбора горячих и холодных путей чаще достаточно хорошей оценки. Поэтому в.NET описан механизм scalable approximate counting: когда значение счётчика растёт, его обновляют реже, но а одно обновление прибавляют больше.
Текущее значение | Сколько прибавляем | Вероятность обновления,% |
Меньше 8192 | 1 | 100 |
8192–16 383 | 2 | 50 |
16 384–32 767 | 4 | 25 |
32 768–65 535 | 8 | 12,5 |
При таком выборе вероятности математическое ожидание прибавки за один вызов остаётся равным единице. Зато потоки реже записывают новое значение счётчика.
Упрощённая реализация идеи на C#:
static void Count(ref uint sharedCounter)
{
    uint currentCount = Volatile.Read(ref sharedCounter);
    uint delta = 1;

    if (currentCount >= 8192)
    {
        int logCount = 31 - (int)uint.LeadingZeroCount(currentCount);
        delta = 1u << (logCount - 12);

        uint random = (uint)Random.Shared.NextInt64(
            0, uint.MaxValue + 1L);

        if ((random & (delta - 1)) != 0)
            return;
    }

    Interlocked.Add(ref sharedCounter, delta);
}
В листинге показана только вероятностная часть алгоритма CoreCLR.
В эксперименте получились такие результаты:
Interlock => Expected: 1,200,000,000
             Actual:   1,200,000,000
             Elapsed:  20185.548 ms

Racy      => Expected: 1,200,000,000
             Actual:   138,526,798
             Elapsed:  987.4997 ms

Scalable  => Expected: 1,200,000,000
             Actual:   1,193,541,836
             Elapsed:  1082.8471 ms
В этом запуске вероятностный вариант оказался почти таким же быстрым, как несинхронизированный, но заметно ближе к ожидаемому значению. Не стоит переносить эти миллисекунды на любую программу: результаты зависят от оборудования, числа потоков и характера нагрузки. Подробности алгоритма — в дизайн‑документе Scalable Approximate Counting.
Как сократить количество счётчиков
Ещё одна возможность сэкономить — не измерять то, что можно вычислить. Если в блок управления вошли тысячу раз и девятьсот раз ушли по ветке true, для простой развилки число переходов по false можно восстановить: 1000 − 900 = 100.
Та же идея работает и на уровне графа потока управления. Частоты рёбер связаны балансом входящих и исходящих переходов. JIT может оставить счётчики только на части рёбер, а остальные значения восстановить по этим соотношениям. Для выбора измеряемых рёбер JIT строит остовное дерево графа. Часть счётчиков можно убрать: число переходов по этим рёбрам JIT восстановит по остальным..
Go: выборки стека вместо счётчика на каждой ветке
В Go для PGO обычно используют CPU‑профили pprof. Во время профилирования рантайм периодически собирает стеки выполнения. Вот фрагмент обработчика SIGPROF в рантайме Go на Unix‑платформах:
if sig == _SIGPROF {
    if !delayedSignal && validSIGPROF(mp, c) {
        sigprof(c.sigpc(), c.sigsp(), c.siglr(), gp, mp)
    }
    return
}
Счётчики показывают, сколько раз программа прошла по ветке. Выборки стеков помогают оценить, где она проводит процессорное время.
On‑stack replacement: новый код посреди цикла
Что, если метод вызывают всего один раз, но работает он очень долго? Обычная смена версии между вызовами тут не поможет. On‑stack replacement (OSR) позволяет перейти на оптимизированный код прямо во время этого вызова.
Возьмём тот же Run:
public static int Run(IWorker worker, int n)
{
    int sum = 0;
    for (int i = 0; i < n; i++)
        sum += worker.Work(i);

    return sum;
}
Run может вызываться один раз, а затем пройти огромное количество итераций. Не хотелось бы ждать завершения цикла, чтобы получить преимущества JIT‑оптимизации.
Сначала собираем профиль
При определённых условиях рантайм сразу готовит инструментированную версию метода. В цикле появляются счётчики, профиль типов и точка, в которой можно проверить возможность перехода к новому коду:
// Псевдокод Tier 0 Instrumented.
int Run(IWorker worker, int n)
{
    int sum = 0;
    int i = 0;
    int patchCountdown = 1000; // Условное значение для примера.

    while (true)
    {
        if (--patchCountdown <= 0)
            CORINFO_HELP_PATCHPOINT(ref patchCountdown, /* ... */);

        if (i >= n)
            break;

        ProfileCount(loopBody);
        ProfileType(worker);

        sum += worker.Work(i);
        i++;
    }

    ProfileCount(loopExit);
    return sum;
}
Здесь ProfileType обозначает сбор сведений о типе объекта, ProfileCount — подсчёт выполнения участков кода. CORINFO_HELP_PATCHPOINT передаёт управление рантайму, чтобы тот мог проверить, пора ли переключиться на оптимизированный код. ProfileCount и ProfileType — условные обозначения в псевдокоде.
Затем продолжаем с того же места
Когда появляется оптимизированная OSR‑версия, запускать Run заново нельзя: мы потеряем уже накопленную сумму и повторно пройдём обработанные элементы. Нужно перенести состояние выполняющегося метода, в том числе значения i и sum.
Вот как это выглядит в псевдокоде:
// Псевдокод. Параметры i и sum обозначают переданное
// состояние текущего вызова, а не реальную сигнатуру OSR.
int Run_Tier1_OSR(IWorker worker, int n, int i, int sum)
{
    if (i >= n)
        return sum;

    if (worker != null && ExactType(worker) == typeof(Hot))
    {
        do
        {
            sum += ((i + 1) * 3) - 7;
            i++;
        }
        while (i < n);

        return sum;
    }

    // Общий путь дан в сокращённом виде.
    while (i < n)
    {
        sum += worker.Work(i);
        i++;
    }

    return sum;
}
Профиль указал на Hot, проверка типа ограничила быстрый путь объектами Hot, девиртуализация и инлайнинг позволили убрать интерфейсный вызов из горячего цикла, а OSR дал возможность использовать новый код, не дожидаясь завершения текущего вызова.
Для новых вызовов рантайм может использовать обычную оптимизированную версию метода Tier 1.
Цена динамической PGO
Прогрев. Новому процессу нужно время, чтобы собрать статистику и скомпилировать горячие методы. В первые секунды или минуты работы поведение приложения может отличаться от установившегося режима.
Повторная работа в нескольких экземплярах. Если сервис запущен в десятках контейнеров, каждый экземпляр может собирать собственный профиль и оптимизировать те же методы независимо от соседних.
Стоимость ранних версий кода. JIT тратит меньше времени на компиляцию Tier 0, поэтому на этом уровне код оптимизирован слабее. В инструментированной версии к этому добавляются расходы на сбор профиля.
Что показывают бенчмарки.NET
На графике ниже сравниваются варианты выполнения простого HTTP‑обработчика:
app.MapGet("/plaintext", () => "Hello, World!");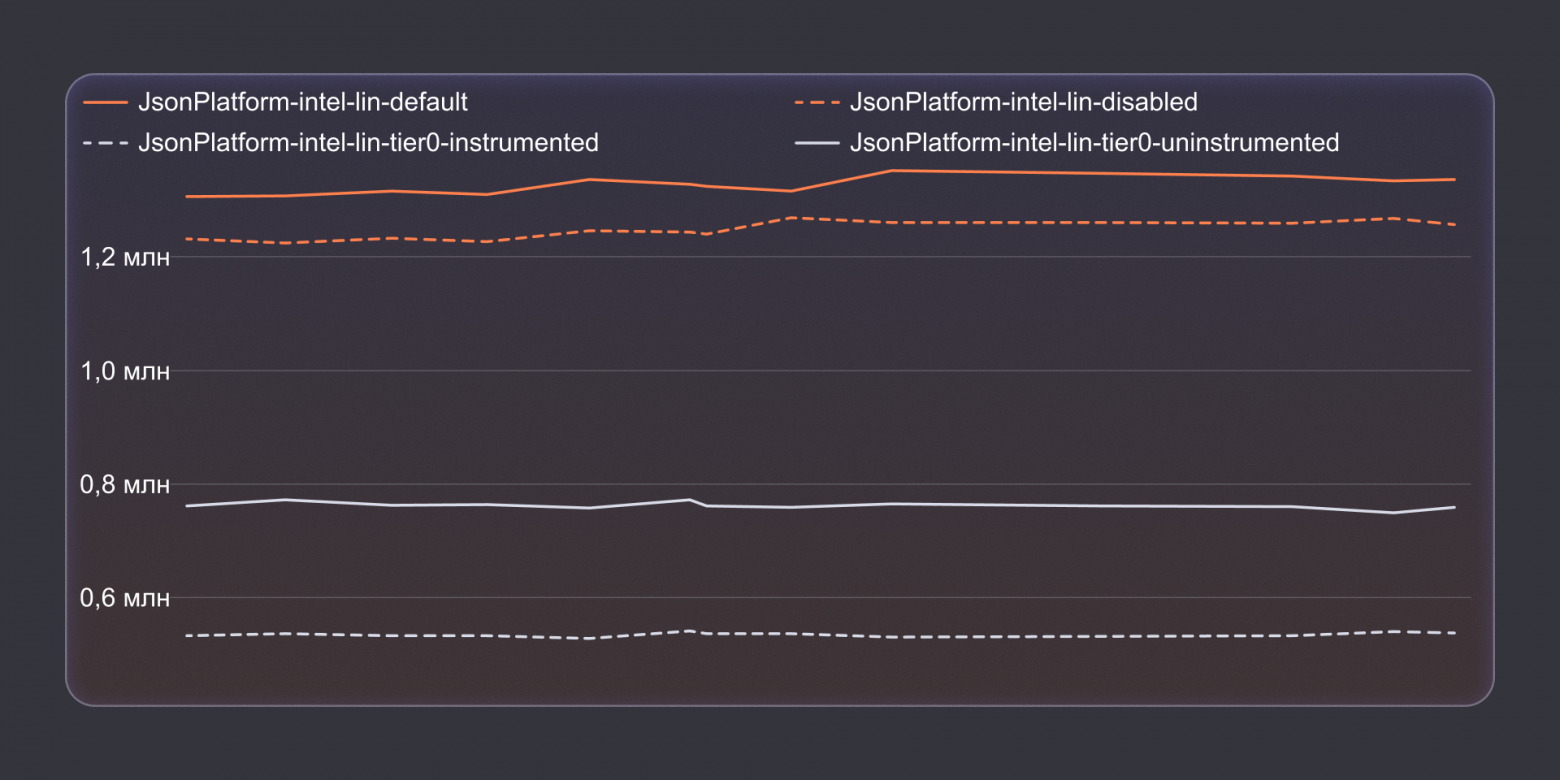
В этом конкретном измерении инструментированный Tier 0 заметно уступает оптимизированным версиям. А разница между двумя вариантами Tier 1 — с PGO и без — намного меньше. Но это результат одного сценария, а не общая оценка пользы PGO: в других тестах влияние профиля может быть существенно больше или почти отсутствовать.
На графике один сценарий — обработчик /plaintext. Под другой нагрузкой эффект PGO может быть заметнее или почти исчезнуть.
Выводы о работе с PGO
Мне в PGO интересен момент, когда наблюдение за программой меняет решение компилятора. В примере с IWorker предположили, что в точке вызова чаще всего встречается Hot. Если профиль это подтвердит, JIT может проверить тип, встроить Hot.Work и убрать интерфейсный вызов из горячего цикла.
В Go CPU‑профиль обычно пригодится при следующей сборке. CoreCLR может использовать собранные данные в том же процессе, а с OSR — переключиться на оптимизированный код прямо посреди цикла. HotSpot тоже работает с профилем во время выполнения. Если предположение JIT о типе объекта перестаёт выполняться, HotSpot может деоптимизировать код и позже скомпилировать метод заново.
Когда я смотрю на бенчмарк JIT, первым делом проверяю, успело ли приложение прогреться к началу замеров. Сразу после запуска и после прогрева рантайм может выполнять разные версии одного и того же метода. А если хочется понять, сколько дал именно профиль, в нашем примере с ASP.NET я бы смотрел на две линии Tier 1 — с PGO и без него.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.