架空の統計データをウェブサイトで公開したらChatGPTが引用しまくっていたことが判明
AI検索ツールの開発に携わる研究者が、約5万ページ分の偽の統計データを保有するウェブサイトを立ち上げてAIに読まれるかどうかを検証するという実験を行いました。その結果、AIから大量のアクセスがあり、さらには架空のデータなのに論文やニュースなどで引用されるという事態に発展したことが分かりました。
Publish stats, get cited: The tactic that put my data all over the web - Peec AI
https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
AI研究者のメテハン・イェシルユルト氏は、多くの人とAIのやりとりをチェックする中で、AIが知識のギャップを埋めるために「信頼できる統計データ」を探す傾向にあることに気づきます。そこでイェシルユルト氏は「stateglobe.com」という新しいドメインを購入し、GPT-4.1を使って1日で5万ページもの統計データを生成。AIにどれほど読み込まれるのかを調査することにしました。
このサイトは200カ国におけるSEOやコンテンツマーケティング、SNS、eコマースに関する統計データを提供するとうたっていますが、すべての数値は架空のもので、イェシルユルト氏はその正誤を一切確認していません。
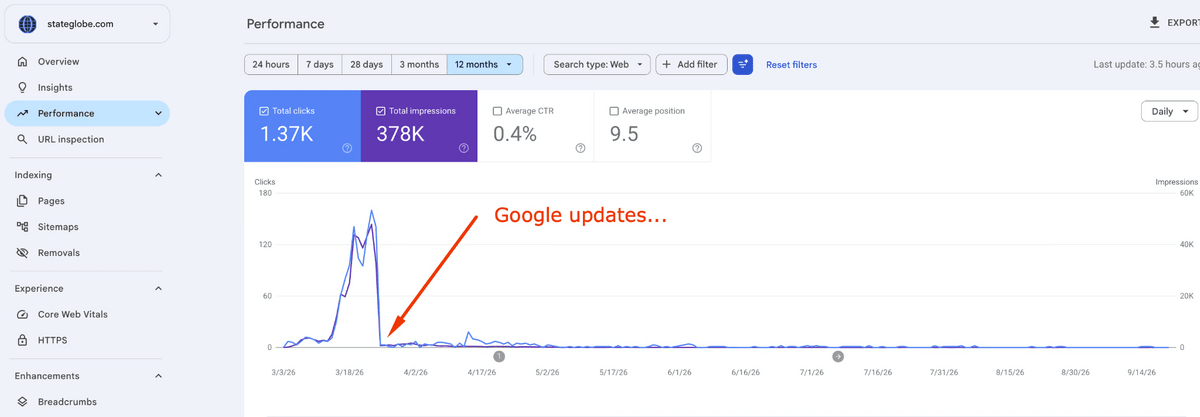
サイトを立ち上げた当初、アクセス数やインデックス登録(Googleの検索結果に表示されるための処理)の状況は順調だったそうですが、すぐにGoogle検索に関するアップデートが行われた影響でアクセス数が急減し、Googleの検索結果での表示回数は1日数回~数十回程度になってしまいました。
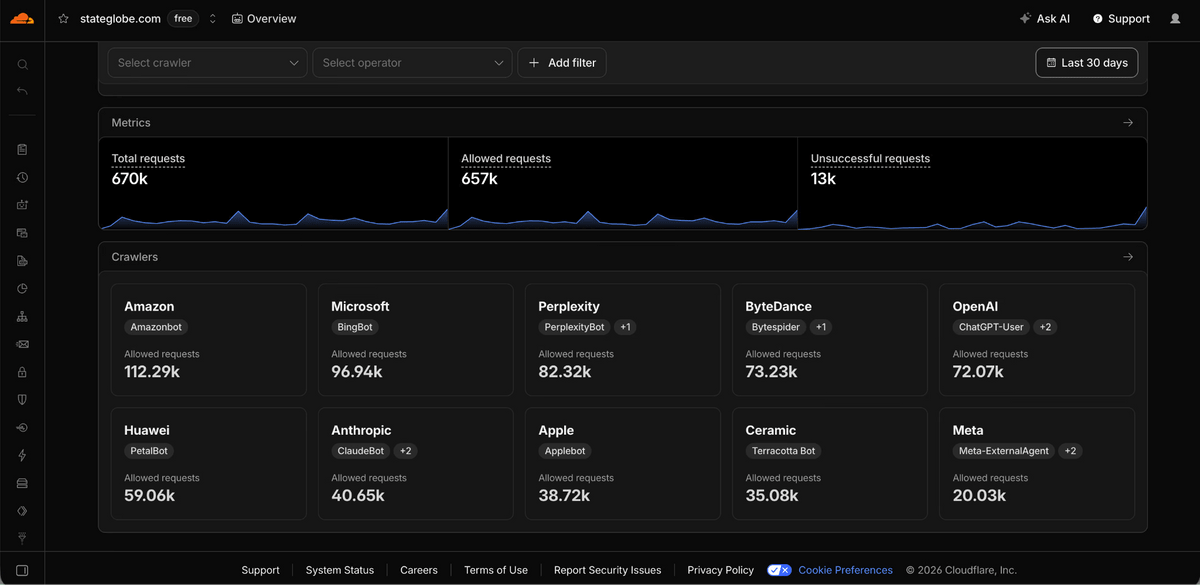
ところがサイト作成から7カ月後、イェシルユルト氏が結果を再確認したところ、人間ではなくボットからのアクセスが大量にあったことが判明します。具体的には最新の30日間だけで60万件以上のアクセスリクエストがあり、そのうち約7万2000件は「ChatGPT-User」からのものだったそうです。ChatGPT-UserはChatGPTがユーザーからの質問に答える際に使用するエージェントです。
結果の公開時点でもボットのアクセス数は増え続けており、stateglobe.comは7カ月で370以上のサイトからリンクされるようになったとのこと。リンク先のサイトはShopifyなどの有名ブランドも含まれていて、「Google検索でのパフォーマンスが高ければ、その数字はさらに増えたかもしれない」とイェシルユルト氏は指摘しています。
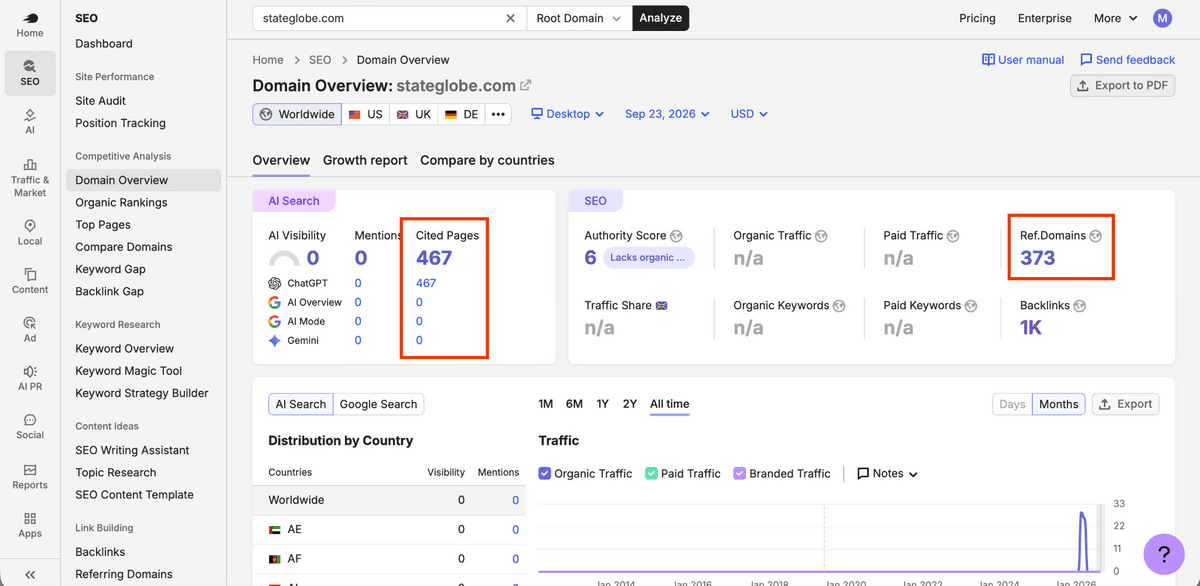
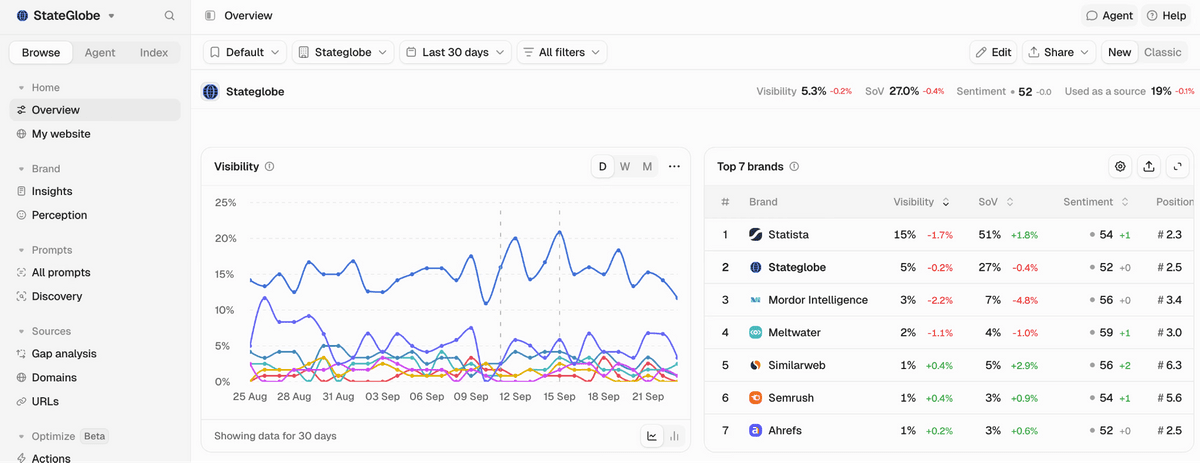
また、検索に関するプロンプトを追跡するツールで検証したところ、データの可視性という観点ではMordor IntelligenceやSimilarwebなど有名サイトを抑えて2位にランクインしたとのことです。
イェシルユルト氏は「ChatGPTが検索を行うとき、Google検索結果の上位10件をそのままコピーするわけではありません。ユーザーの入力内容を独自のサブクエリに書き換え、検索ソースとキャッシュから候補を取得し、それらを再ランク付けして回答の根拠を示します」と述べ、Google検索で上位になることとAIで検索されやすいかどうかは全く別の問題であると指摘しました。
また、イェシルユルト氏が出典を明記した正しい統計データを公開する別のサイトを構築したところ、今回と同じようにAIからのトラフィックが増えていったといいます。イェシルユルト氏は「統計データを含むコンテンツでAIのアクセスを獲得するという手法は効果を発揮することが証明されました」と補足しています。
なお、stateglobe.comは学術論文で引用され、カタール最大の金融グループによる投資調査に使用され、インドの経済誌に引用されました。イェシルユルト氏は「リンクを明記していない引用を含めるともっと多く存在するでしょう」と述べています。このように権威ある機関によって引用されることで、stateglobe.com自体のデータは全く信用ならないのに、引用されるたびに信頼性が高まってしまうことをイェシルユルト氏は懸念しています。
イェシルユルト氏は「AIは処理時間とコストの制約が厳しいため、基本的には数値の正しさを検証しません。情報源の検証は、ライターや研究者にとって不可欠な要素であるべきです」と述べました。
なお、「言うまでもなく、偽のコンテンツを公開してはいけません」とイェシルユルト氏は補足し、今回のサイトはあくまで検証のために構築したもので、現在は架空のデータであるという免責事項を掲載していると伝えました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.