NATS: архитектура, модель работы и области применения
Всем привет! Я Алексей Трофимов, .NET-разработчик в компании МУЛЬТИФАКТОР. Попал сюда как раз в тот момент, когда команда заканчивала переход на NATS. В этой статье я расскажу, как устроен NATS и в каких сценариях стоит его выбирать.
Что такое NATS
NATS это брокер сообщений, который написан на Go, состоит всего из одного бинарника на 15МБ и способен обрабатывать миллионы сообщений в секунду с задержкой менее миллисекунды.
Архитектура и модель работы
Давайте вспомним, как устроен обмен сообщениями в RabbitMQ. Сообщения обычно отправляются через exchange, который маршрутизирует их в очереди. В NATS Core это работает по другому: вместо привычных очередей используется subject - строка, определяющая тему сообщения.
Как устроены subjects
Subjects могут иметь иерархическую структуру. Точки разделяют их на отдельные токены, что позволяет группировать сообщения по смыслу.
Например, subject users.registered можно условно прочитать как «зарегистрирован новый пользователь». Такая структура позволяет подписчикам выбирать, какие именно сообщения им обрабатывать.
Для этого NATS поддерживает два специальных символа - wildcard:
*заменяет ровно один токен. Например, подписка наusers.*получит сообщения изusers.registeredиusers.deleted.>позволяет подписаться на всё поддерево subjects, начиная с указанного уровня. Например,users.>подписка на все subjects внутри пространстваusers, включаяusers.profile.updated.
Важно, что wildcard используются именно при потреблении. Publisher всегда отправляет сообщение в конкретный subject, а NATS уже определяет, каким потребителям его доставить.
Три основных паттерна взаимодействия в NATS Core
Subjects это основа маршрутизации сообщений, но сами по себе они не определяют, как именно сообщения будут распределяться между сервисами. В NATS Core есть несколько моделей взаимодействия, которые позволяют решать разные задачи.
1. Pub/Sub: публикация и подписка
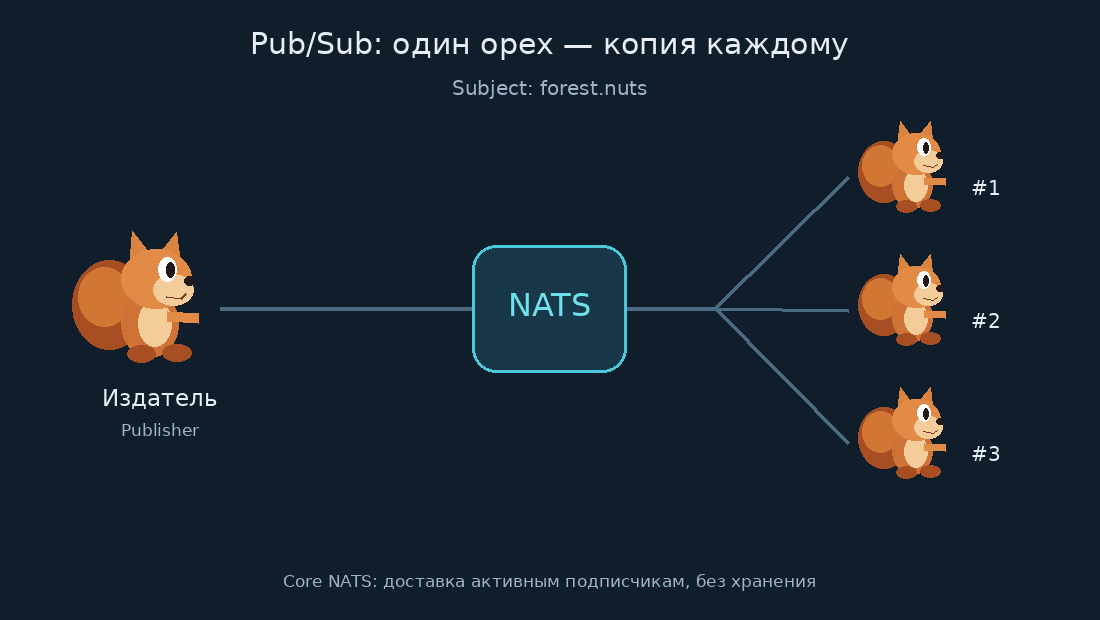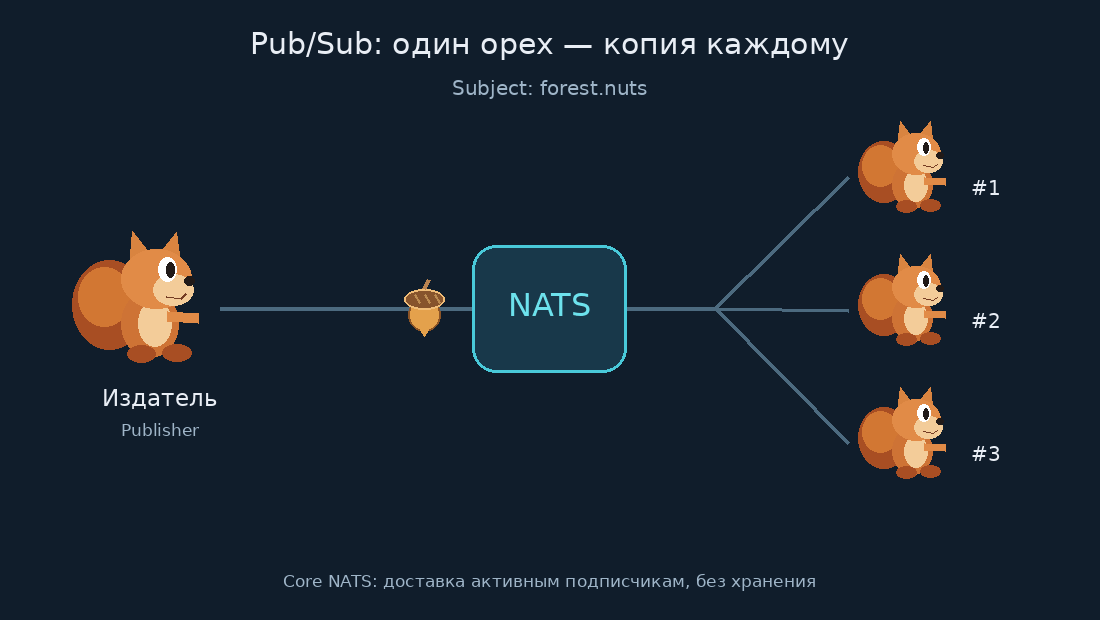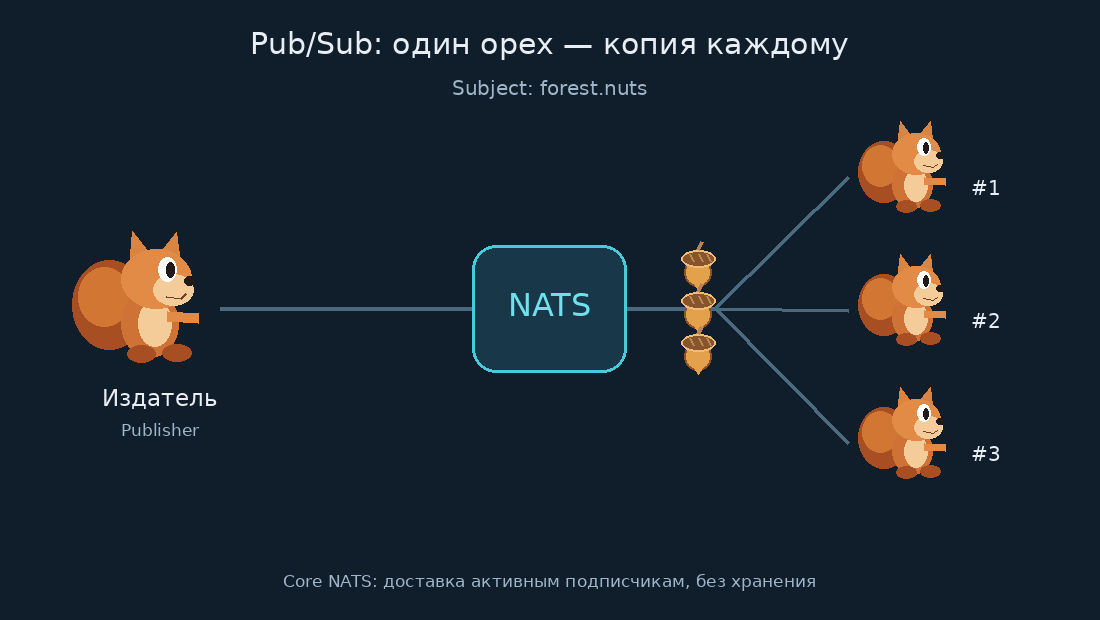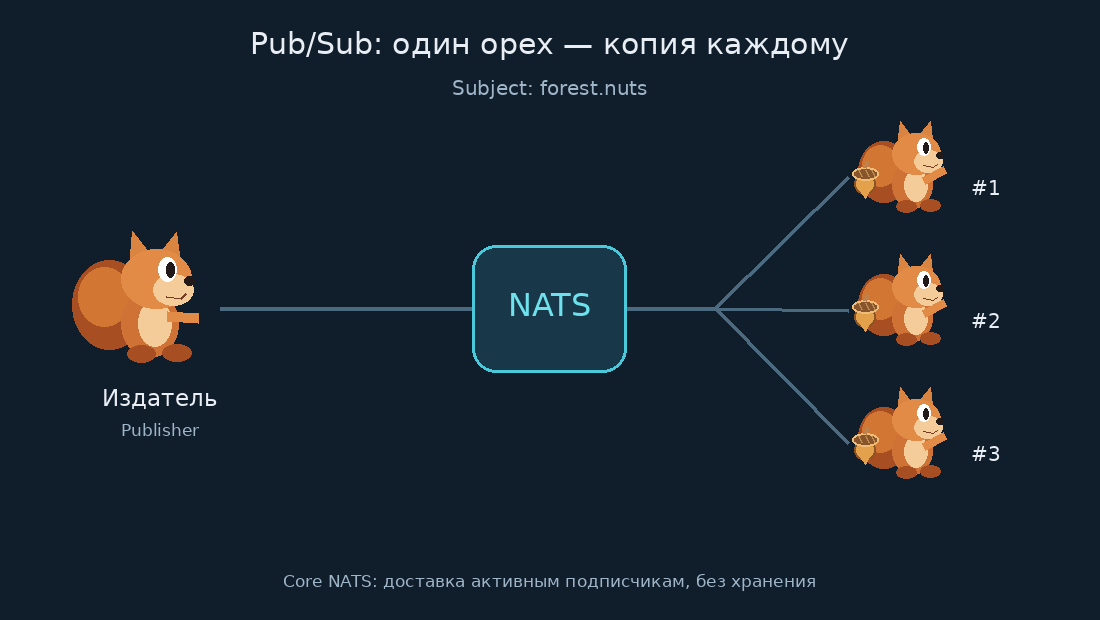
Это самый простой вариант взаимодействия. Один сервис публикует сообщение, а все подписчики, которые слушают соответствующий subject, получают его копию.
Например, после регистрации пользователя сервис публикует событие в users.registered. На этот subject могут быть подписаны сервисы профиля, аналитики и уведомлений. Каждый из них получит сообщение и сможет обработать его независимо от остальных.
Если же в момент публикации нет активных подписчиков или пропала связь с сервером NATS, то сообщение просто теряется: NATS Core не сохраняет его для последующей доставки.
Таким образом, Pub/Sub подходит для событий, которые должны одновременно получать несколько сервисов и для которых подходит схема at-most-one.
2. Queue Groups - распределение нагрузки
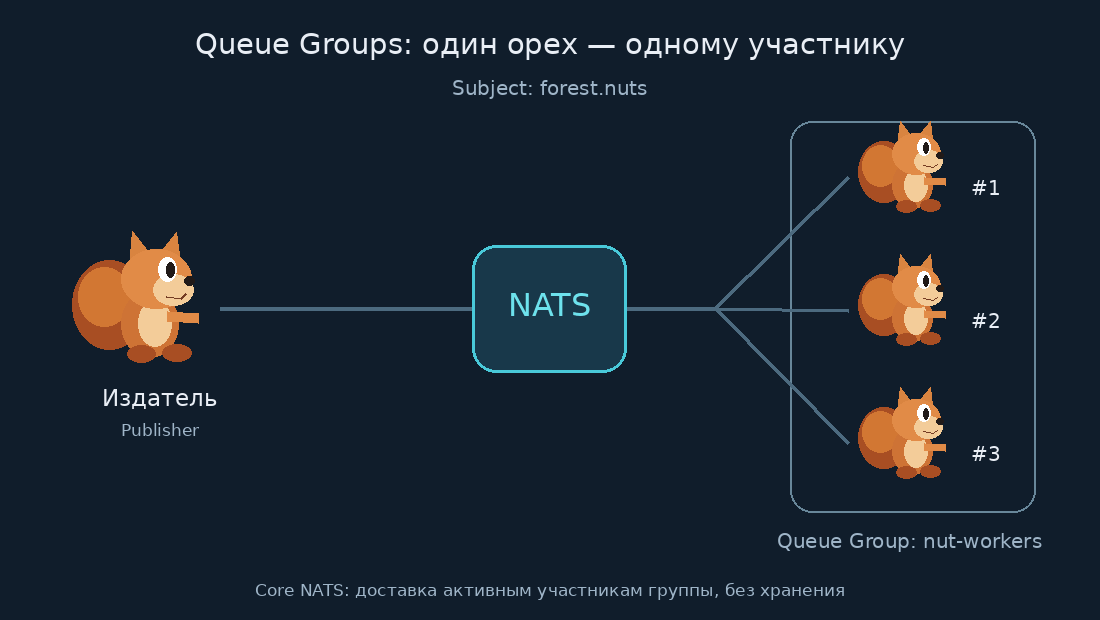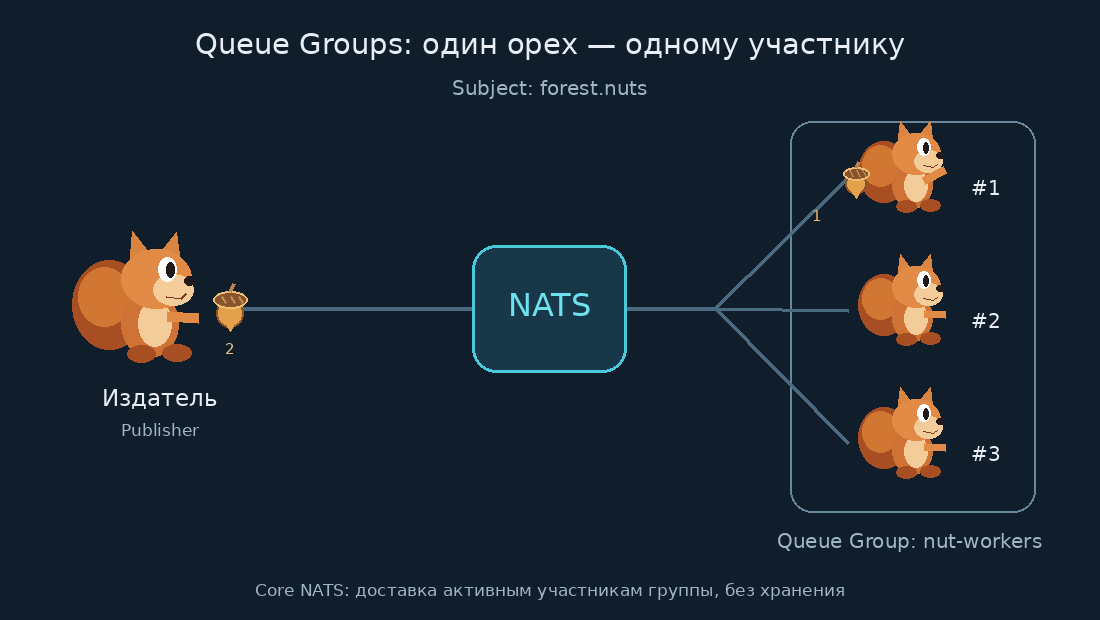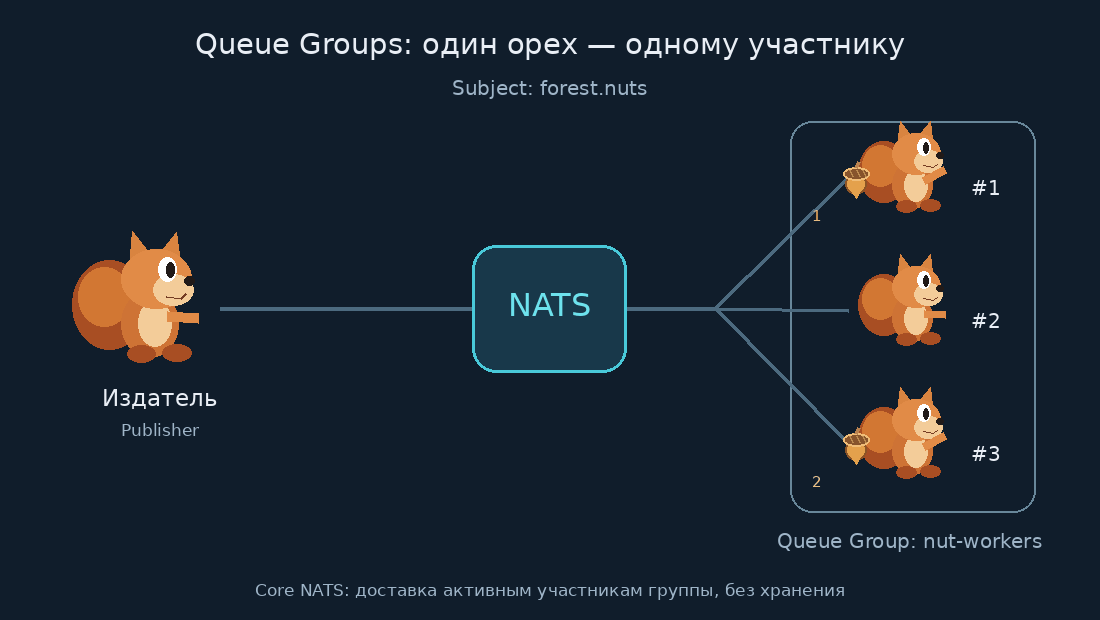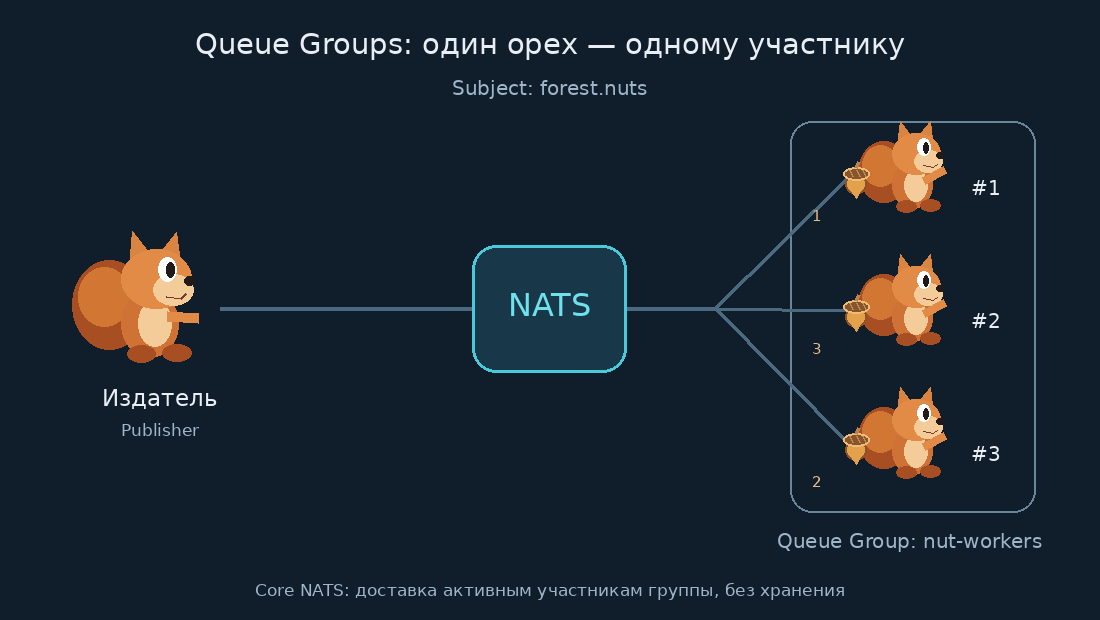
Иногда сообщение не нужно доставлять всем экземплярам сервиса. Например, если запущено два инстанса обработчика уведомлений и оба получат событие о входе в личный кабинет - пользователь получит два одинаковых уведомления.
Для этого в NATS есть Queue Groups. Несколько подписчиков объединяются под одним именем группы, и каждое сообщение доставляется только одному из них.
NATS распределяет сообщения между участниками группы это почти round robin, но не «честный»: получатель выбирается случайно, поэтому строгого чередования и равного числа сообщений нет. Это позволяет горизонтально масштабировать обработку без реализации балансировки на уровне приложения.
Если добавить новый экземпляр обработчика, он сможет присоединиться к группе и участвовать в обработке сообщений. Если один из экземпляров отключится, оставшиеся участники продолжат получать сообщения.
При этом Queue Groups не являются очередью: если все подписчики недоступны, сообщения, опубликованные в этот момент, не будут ждать их возвращения.
3. Request-Reply - запрос и ответ
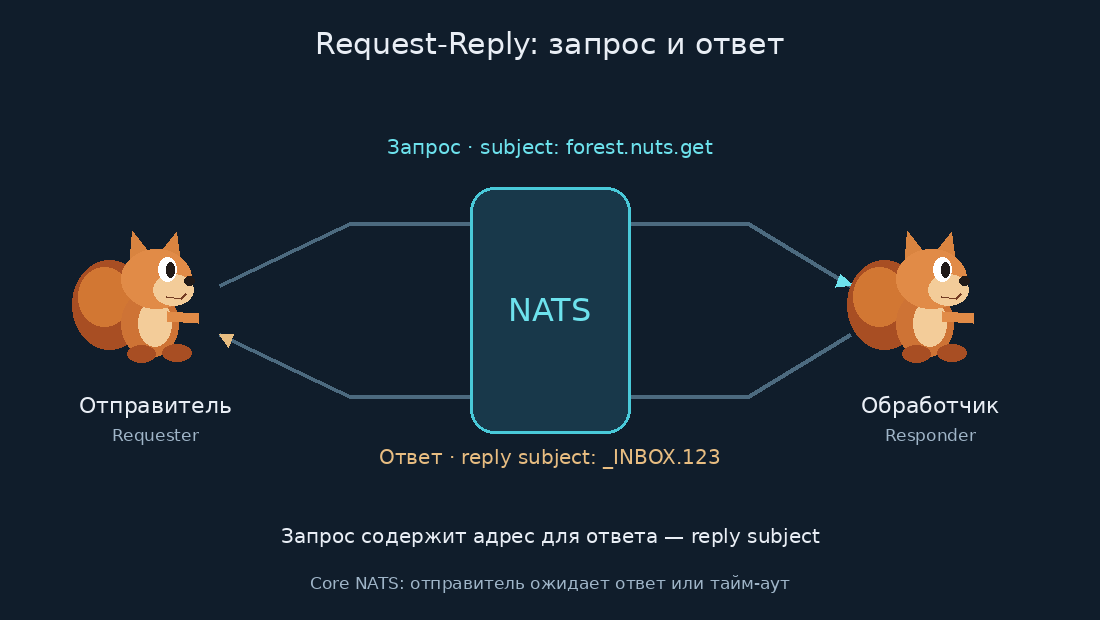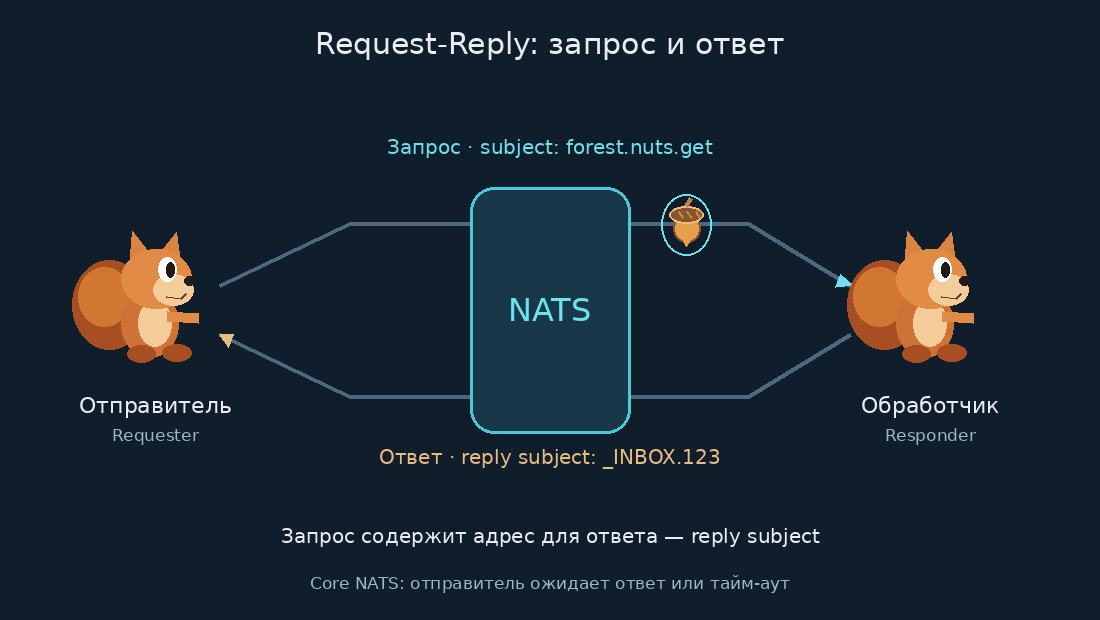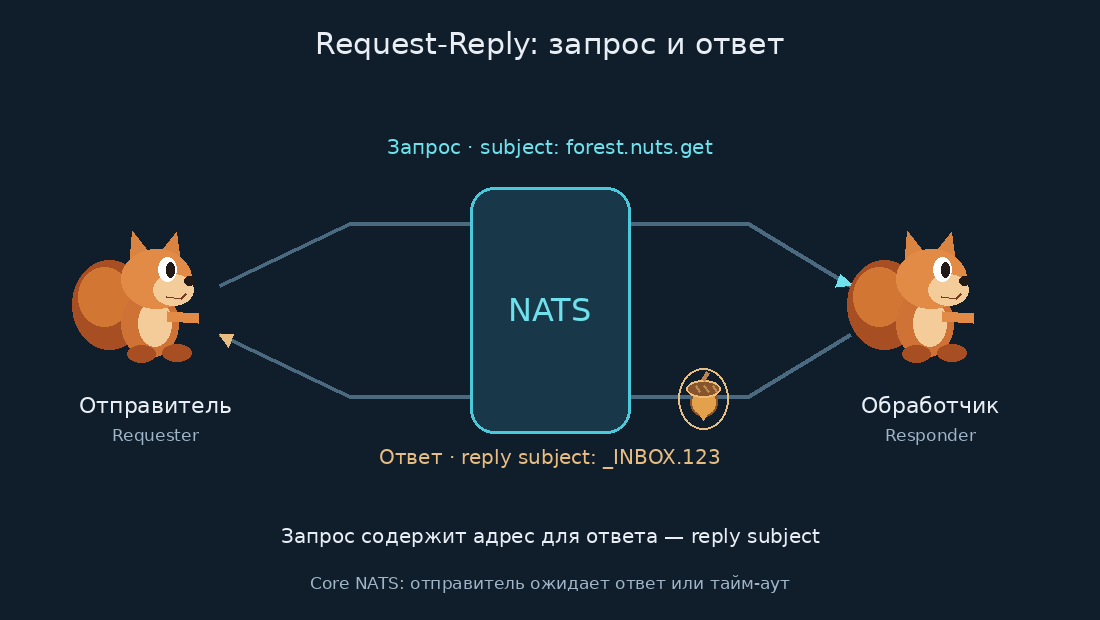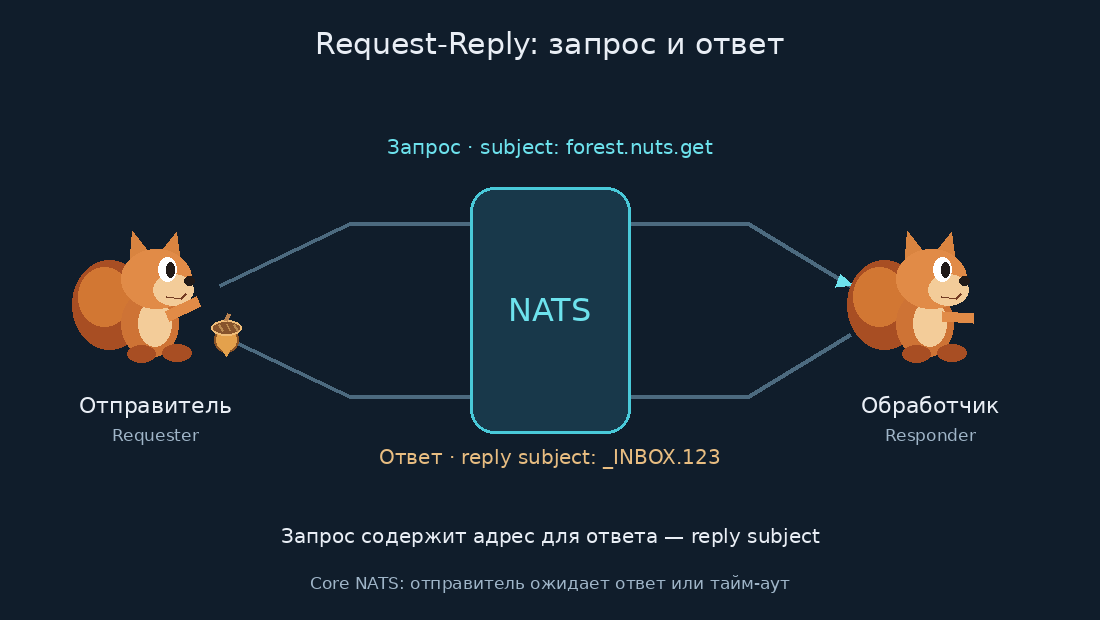
Помимо событийной модели, NATS поддерживает и взаимодействие по схеме «запрос - ответ».
Один сервис отправляет запрос в определённый subject и ожидает ответ от другого сервиса. Например, сервис заказов может запросить у сервиса пользователей информацию о конкретном пользователе. Для этого он отправляет запрос в subject users.get и получает ответ с необходимыми данными.
Чтобы получатель знал, куда отправить ответ, в запросе указывается специальный reply subject. Клиентская библиотека NATS обычно автоматически создаёт адрес для ответа и передаёт его вместе с запросом. Вызывающий сервис ожидает ответ по этому адресу.
Что важно запомнить
В NATS Core subject определяет, куда направляется сообщение, а выбранный паттерн взаимодействия - кому и как оно будет доставлено.
Pub/Sub - одно сообщение получают все подходящие подписчики.
Queue Groups - сообщение получает один участник группы, что позволяет распределять нагрузку.
Request-Reply - отправитель передаёт запрос и ожидает ответ.
При этом NATS Core не хранит сообщения. Если получатель должен иметь возможность обработать сообщение позже, после временного отключения, для этого используется JetStream - отдельный слой NATS, который добавляет хранение сообщений и механизмы их повторной доставки.
JetStream: хранение и повторная доставка сообщений
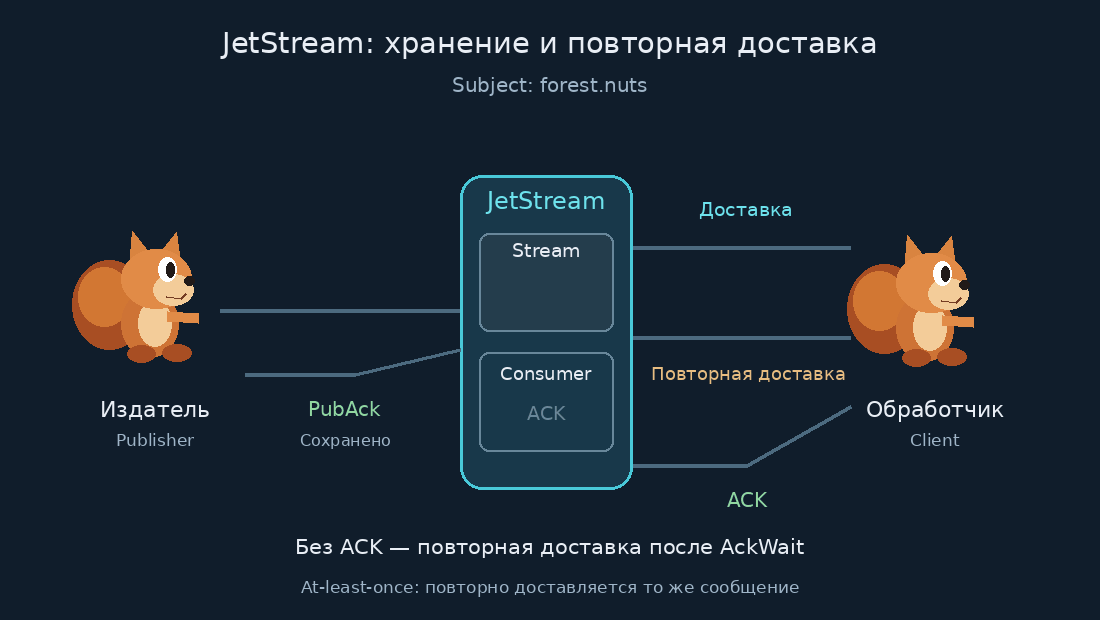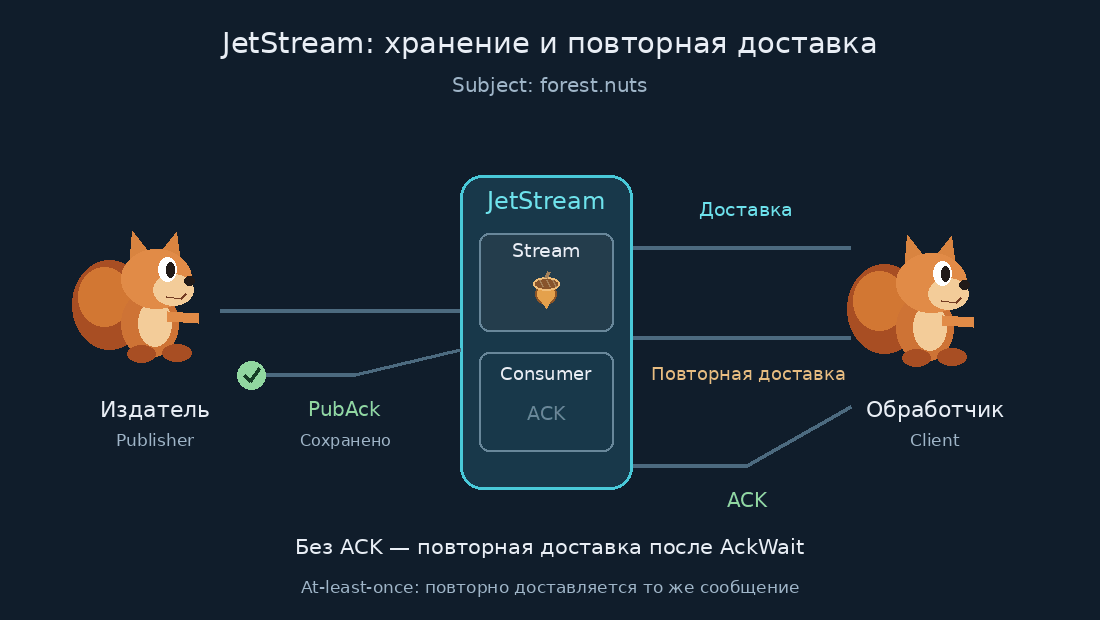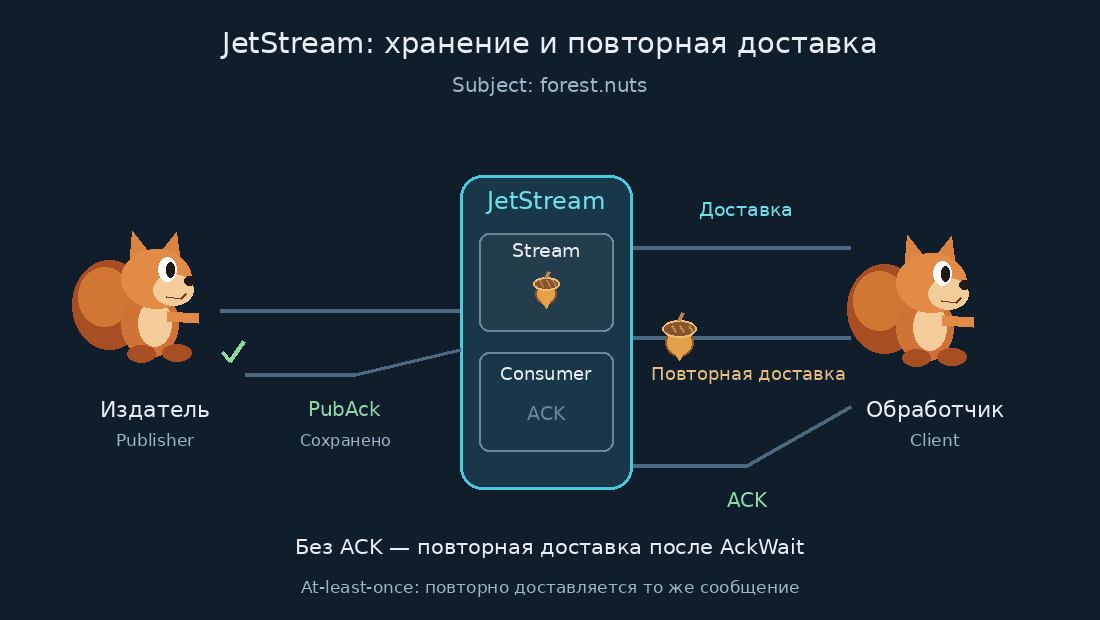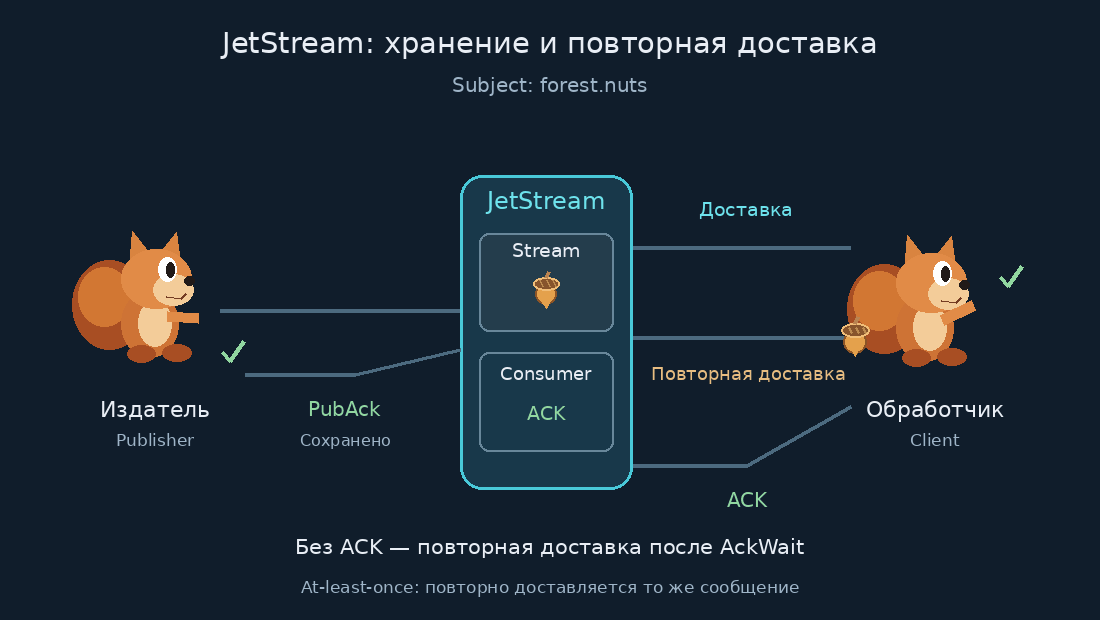
По сути, Core NATS работает по принципу at-most-once: сообщение либо доставляется, либо теряется.
Три ключевых понятия JetStream
Чтобы понять, как это работает, достаточно разобраться с тремя основными сущностями: Stream, Consumer и Client.
Stream - это серверное хранилище сообщений, связанное с одним или несколькими subject-паттернами.
Когда publisher отправляет сообщение в subject, который входит в конфигурацию stream, JetStream сохраняет это сообщение, присваивает ему порядковый номер и отправляет подтверждение publisher'у - PubAck. Можно настроить, где и сколько хранить сообщения: в памяти или на диске, сколько сообщений или байт может занимать stream, когда старые сообщения нужно удалять, а также сколько реплик хранить на разных узлах кластера.
Репликация работает через протокол RAFT: при записи нового сообщения большинство реплик должно подтвердить его получение - это называется кворумом. Например, при трёх репликах кворум равен двум: если один узел упал, два оставшихся всё ещё могут договориться между собой и стрим продолжает работать. Поэтому количество реплик всегда выбирают нечётным, но больше единицы.
Consumer определяет, какие сообщения из stream и в каком порядке должен получать конкретный обработчик.
Важная особенность заключается в том, что consumer хранит своё состояние на стороне NATS. Сервер знает, до какого места обработчик уже дошёл.
Например, один stream может содержать 10 000 сообщений. Один consumer может читать их с самого начала, а другой - только новые сообщения. При этом каждый consumer имеет собственную позицию и не влияет на другого.
Это позволяет нескольким независимым обработчикам работать с одними и теми же сохранёнными сообщениями.
Client - это уже наше приложение, подключённое к consumer.
Оно получает сообщение, выполняет необходимую обработку и отправляет подтверждение - ack.
Если сообщение успешно обработано и подтверждено, consumer знает, что его можно считать обработанным.
Если приложение не подтвердило сообщение в установленный срок, JetStream считает, что обработка могла завершиться неуспешно, и может доставить сообщение повторно.
Именно механизм подтверждений и повторной доставки позволяет реализовать гарантию at-least-once.
При этом важно учитывать, что повторная доставка означает возможность получить одно сообщение несколько раз. Поэтому обработчики обычно должны быть готовы к повторной обработке одного и того же события.
А еще Consumer можно настроить так, чтобы обработка начиналась с нужного места в stream: с самого начала, с последнего сообщения или с определённого момента времени. Это удобно при восстановлении сервисов, повторной обработке данных или подключении нового потребителя к уже существующему потоку событий
Что ещё умеет JetStream
JetStream предоставляет не только механизм хранения и доставки сообщений. Поверх него построены дополнительные возможности.
Key-Value Store
Key-Value Store позволяет использовать NATS как простое распределённое хранилище ключ-значение.
Он поддерживает персистентность, репликацию и операции, необходимые для безопасного изменения значений. Также можно хранить историю изменений ключей.
Например, Key-Value Store можно использовать для хранения конфигурации сервисов:
config/user-service/timeout = 3000
config/user-service/max-retries = 5
config/notification-service/enabled = true
В этом случае несколько экземпляров одного сервиса могут получать общие настройки из NATS. При изменении значения сервисы могут узнать об этом изменении и обновить своё состояние.
Другой вариант - хранение небольшого количества общего состояния. Например, можно хранить состояние feature flag:
feature:antispam = enabled
Это позволяет включать и отключать отдельные возможности приложения без изменения конфигурации каждого экземпляра сервиса.
Object Store
Object Store предназначен для хранения объектов, которые слишком велики для обычного сообщения.
Большой объект разбивается на отдельные части - чанки, которые JetStream хранит и затем собирает обратно при чтении. Вместе с объектом сохраняются необходимые метаданные.
Например, сервис генерации отчётов может сохранить готовый PDF в Object Store:
reports/
└── report-2020-02-02.pdf
Другой сервис затем может получить этот файл по его имени или идентификатору.
Похожим образом можно хранить изображения, архивы, экспортированные CSV-файлы или другие относительно крупные объекты.
Core NATS и JetStream: главное отличие
Основная разница между Core NATS и JetStream заключается в наличии персистентного хранения и состояния обработки.
Core NATS | JetStream | |
|---|---|---|
Хранение сообщений | Нет | В памяти или на диске |
Гарантия доставки | At-most-once | At-least-once |
Повторная доставка | Нет | Да, если сообщение не подтверждено |
Consumer state | Нет | Да |
Key-Value Store | Нет | Да |
Object Store | Нет | Да |
Таким образом, Core NATS подходит для быстрого обмена сообщениями в реальном времени, когда потеря сообщения допустима.
JetStream нужен тогда, когда сообщение важно сохранить и обработать позже. Он добавляет поверх Core NATS хранение, состояние потребителей, подтверждения и повторную доставку.
Масштабирование и топологии развёртывания
До этого мы рассматривали NATS как брокер сообщений, к которому подключаются сервисы. Но что делать, если одного сервера становится недостаточно? Или если инфраструктура распределена между несколькими ЦОДами?
Для этого NATS позволяет объединять серверы в разные топологии. При этом клиентский API остаётся прежним: приложения продолжают публиковать сообщения в subjects и подписываться на них. Меняется инфраструктура, а не сама модель взаимодействия.
Рассмотрим четыре основные топологии: Single Server, Cluster, Super-Cluster и Leaf Nodes.
Single Server - один сервер
Самый простой вариант - один NATS Server, к которому подключаются все приложения.
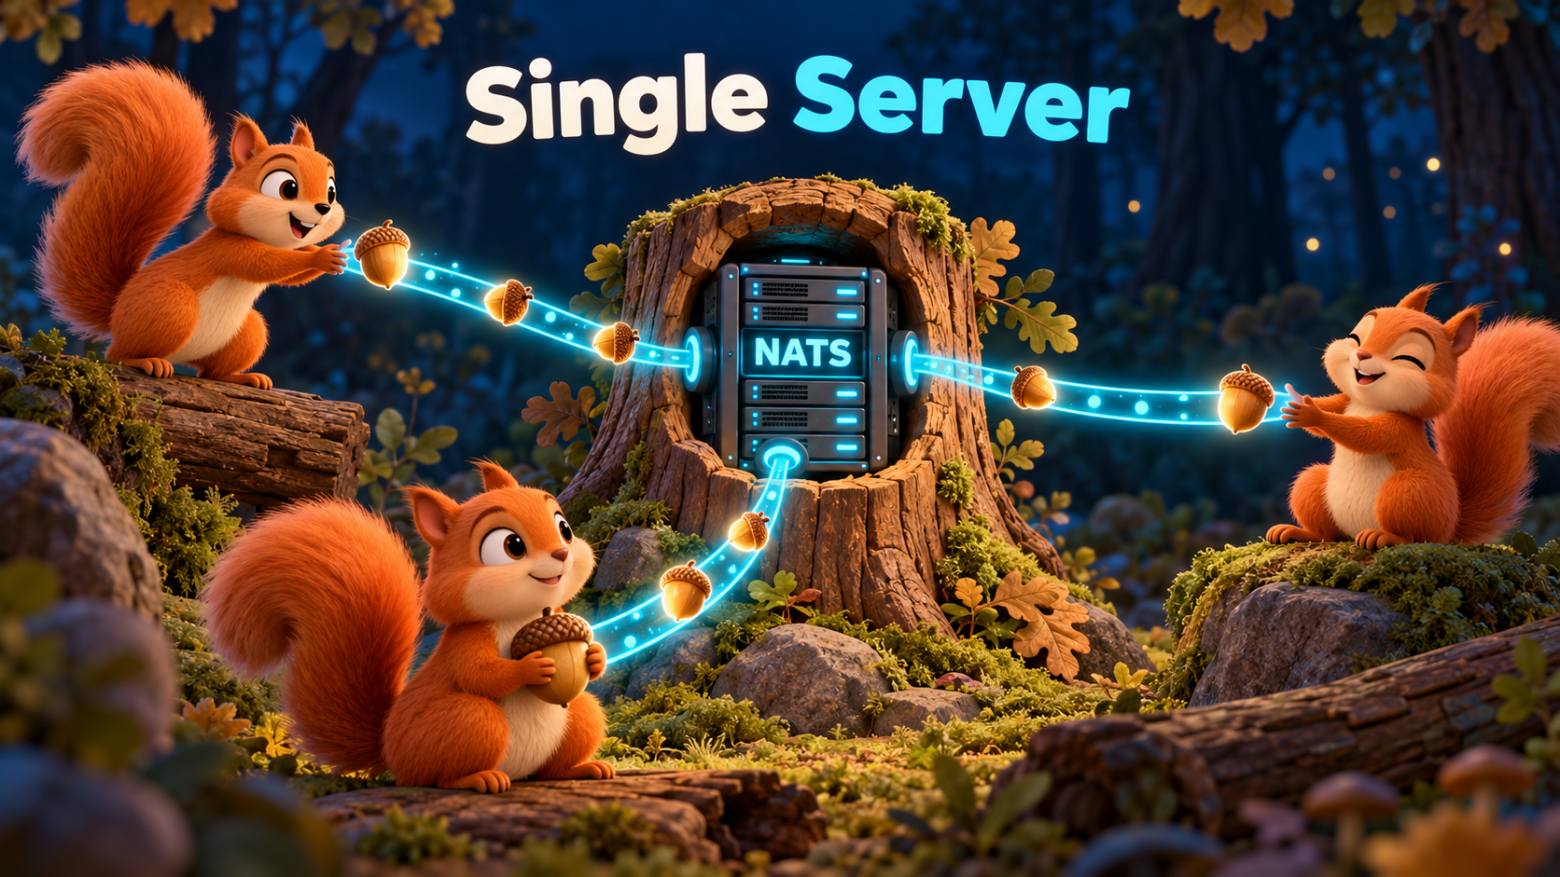
Такая конфигурация подходит для разработки, тестирования и небольших систем. Её главный недостаток - отсутствие отказоустойчивости на уровне брокера. Для production-систем, где доступность брокера критична, обычно используют кластер.
Cluster - несколько серверов NATS
В кластерной конфигурации несколько NATS Server объединяются через специальные соединения - routes.
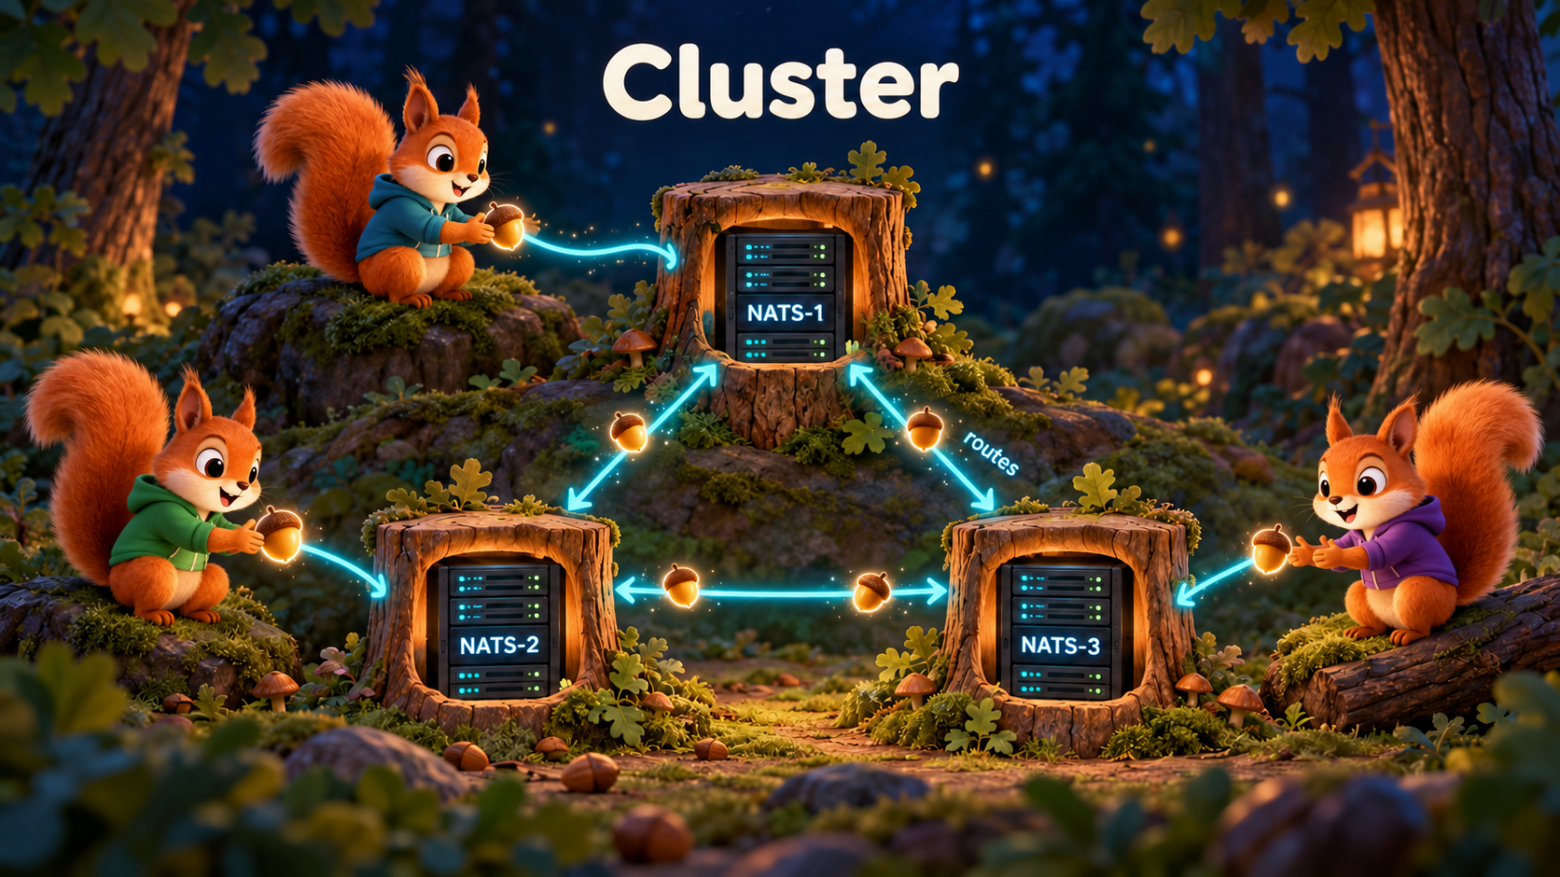
Серверы обмениваются информацией о подписках и маршрутизируют сообщения между собой.
Например:
Service Aподключён кNATS-2и публикуетusers.created.Service Bподключён кNATS-3и подписан наusers.created.NATS передаёт сообщение между серверами, и
Service Bего получает.
Для приложений кластер выглядит как единая система обмена сообщениями. Им не нужно знать, к какому конкретно серверу подключён получатель.
Если один узел выходит из строя, клиенты могут переподключиться к другим доступным узлам. Для этого важно правильно настроить адреса подключения и переподключение в клиентской библиотеке.
Что даёт Cluster:
Отказоустойчивость: отказ одного сервера не обязательно останавливает обмен сообщениями.
Масштабирование: клиентские подключения и обработка трафика распределяются между серверами.
Репликацию JetStream: streams и consumers можно настроить с несколькими репликами, чтобы снизить зависимость от одного узла.
При этом кластер обычно строят внутри одного ЦОДа или в сети с достаточно стабильными соединениями и предсказуемыми задержками. Для объединения географически разделённых кластеров у NATS есть другая топология.
Super-Cluster - несколько кластеров
NATS позволяет построить топологию, которая будет состоять из несколько независимых кластеров и объединяться через gateways в один Super-Cluster.
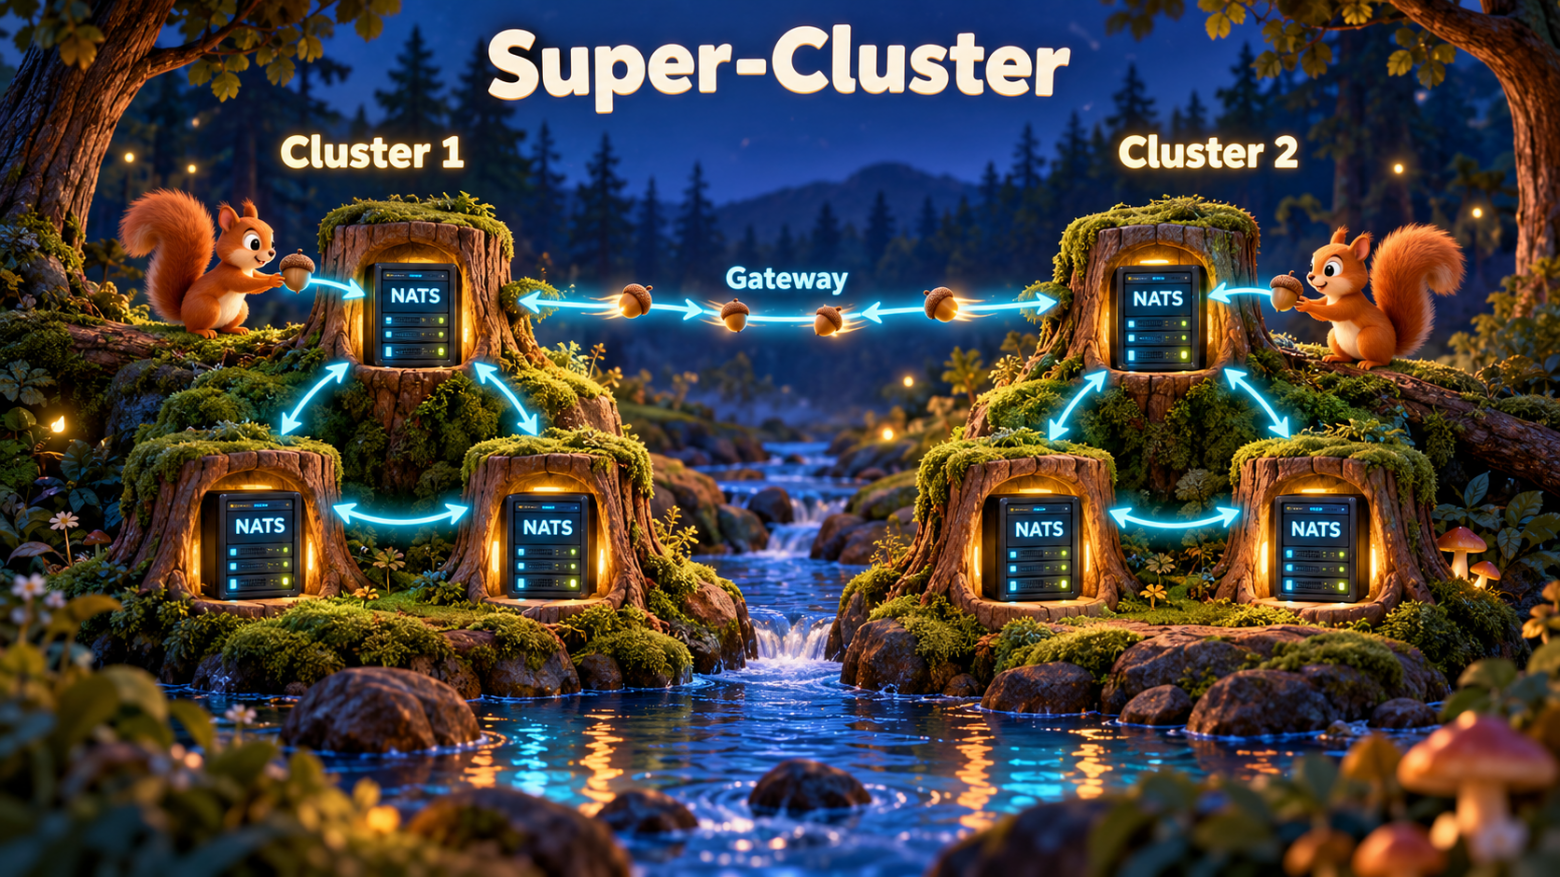
Каждый кластер при этом остаётся самостоятельным, а gateway связывает их между собой.
Рассмотрим пример:
Service Aработает в ЦОДе 1 и публикует сообщение вusers.registered.Service Bработает в ЦОДе 2 и подписан наusers.registered.NATS видит, что в другом кластере есть подписчик, и передаёт сообщение через gateway. В результате
Service Bполучает его, хотя находится в другом ЦОДе.
NATS передаёт между кластерами только тот трафик, для которого на другой стороне есть интерес. Для этого кластеры через gateways обмениваются информацией о подходящих подписчиках. Это позволяет не гонять весь межсервисный трафик между ЦОДами.
Для Queue Groups NATS также старается выбирать локальных обработчиков. Поэтому если нужный worker есть в том же регионе, сообщение обычно обрабатывается локально, не создавая лишний межрегиональный трафик.
При этом важно учитывать, что Super-Cluster обеспечивает маршрутизацию сообщений между кластерами, но не объединяет автоматически их JetStream-хранилища. Если необходимо сохранять сообщения при сбоях и переключении между ЦОДами, механизм хранения и восстановления доставки нужно проектировать отдельно.
Leaf Nodes - подключение отдельной NATS-системы
Теперь рассмотрим топологию, которая на первый взгляд похожа на Super-Cluster. Leaf Node тоже связывает NATS-системы, но используется для другой задачи.
Leaf Node это обычный NATS Server со специальной конфигурацией соединения. Он самостоятельно устанавливает исходящее соединение с удалённой NATS-системой.
Разберём это на конкретном примере. Представим производственное предприятие.
В центральном ЦОДе находятся общие сервисы компании: мониторинг оборудования, аналитика, управление производственными заданиями.
На заводе работают локальные сервисы, которые получают данные с датчиков и управляют оборудованием.
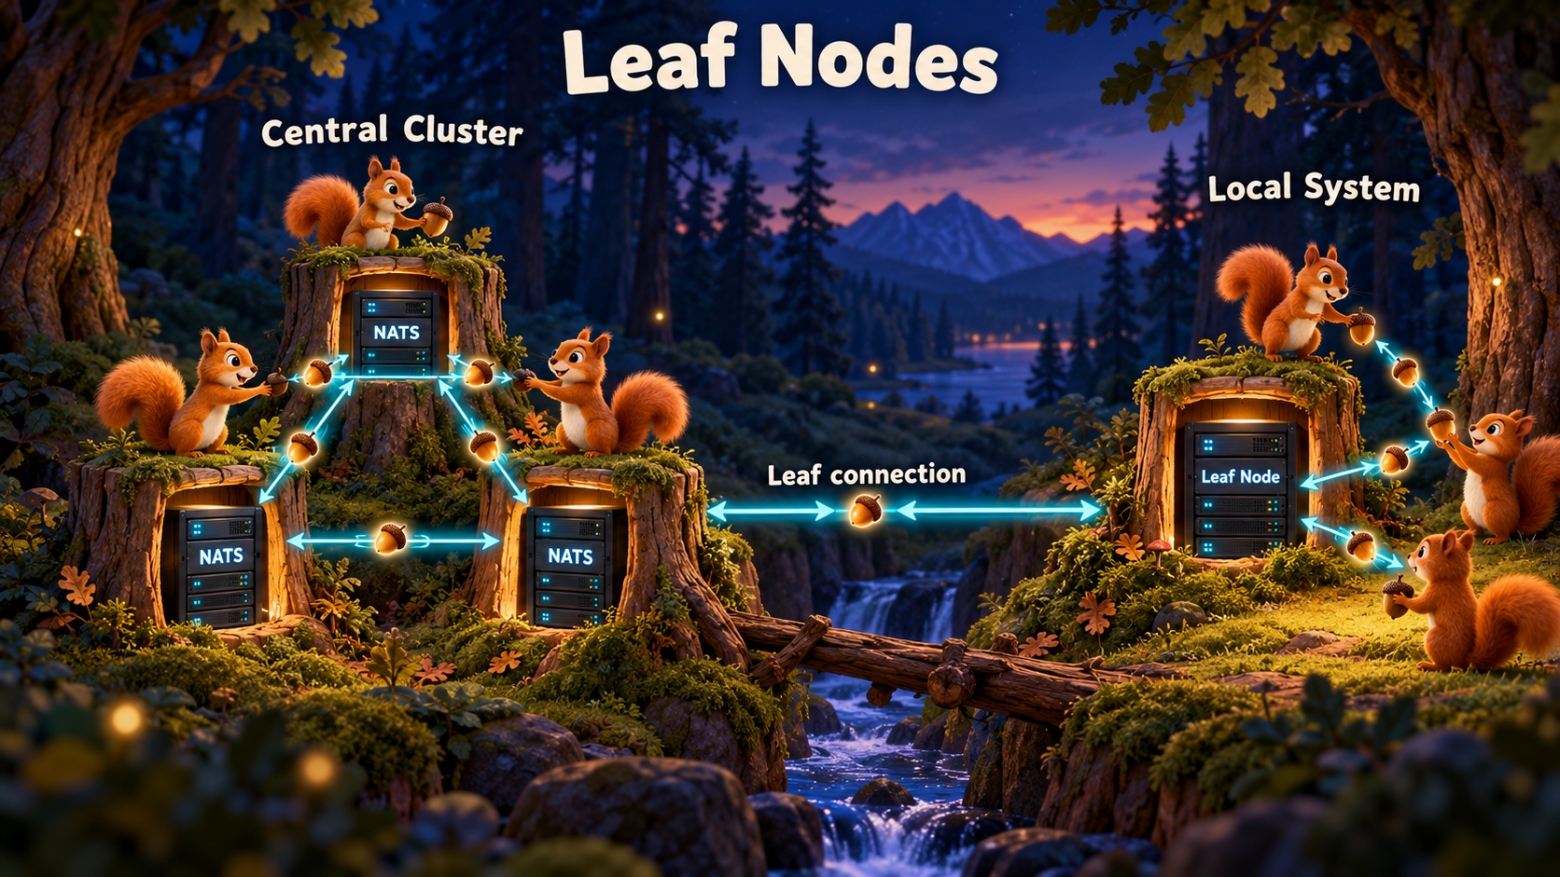
Зачем здесь локальный NATS?
Дело в том, что не каждое сообщение должно проходить через центральный ЦОД. Часть взаимодействий нужна исключительно внутри завода.
Сценарий 1. Локальный обмен сообщениями
Допустим, Sensor Service публикует температуру оборудования: factory.sensor.temperature
На этот subject подписаны два локальных сервиса:
Alarm Service- проверяет превышение температуры.Controller Service- регулирует работу оборудования.
Сообщение доставляется через локальный NATS:
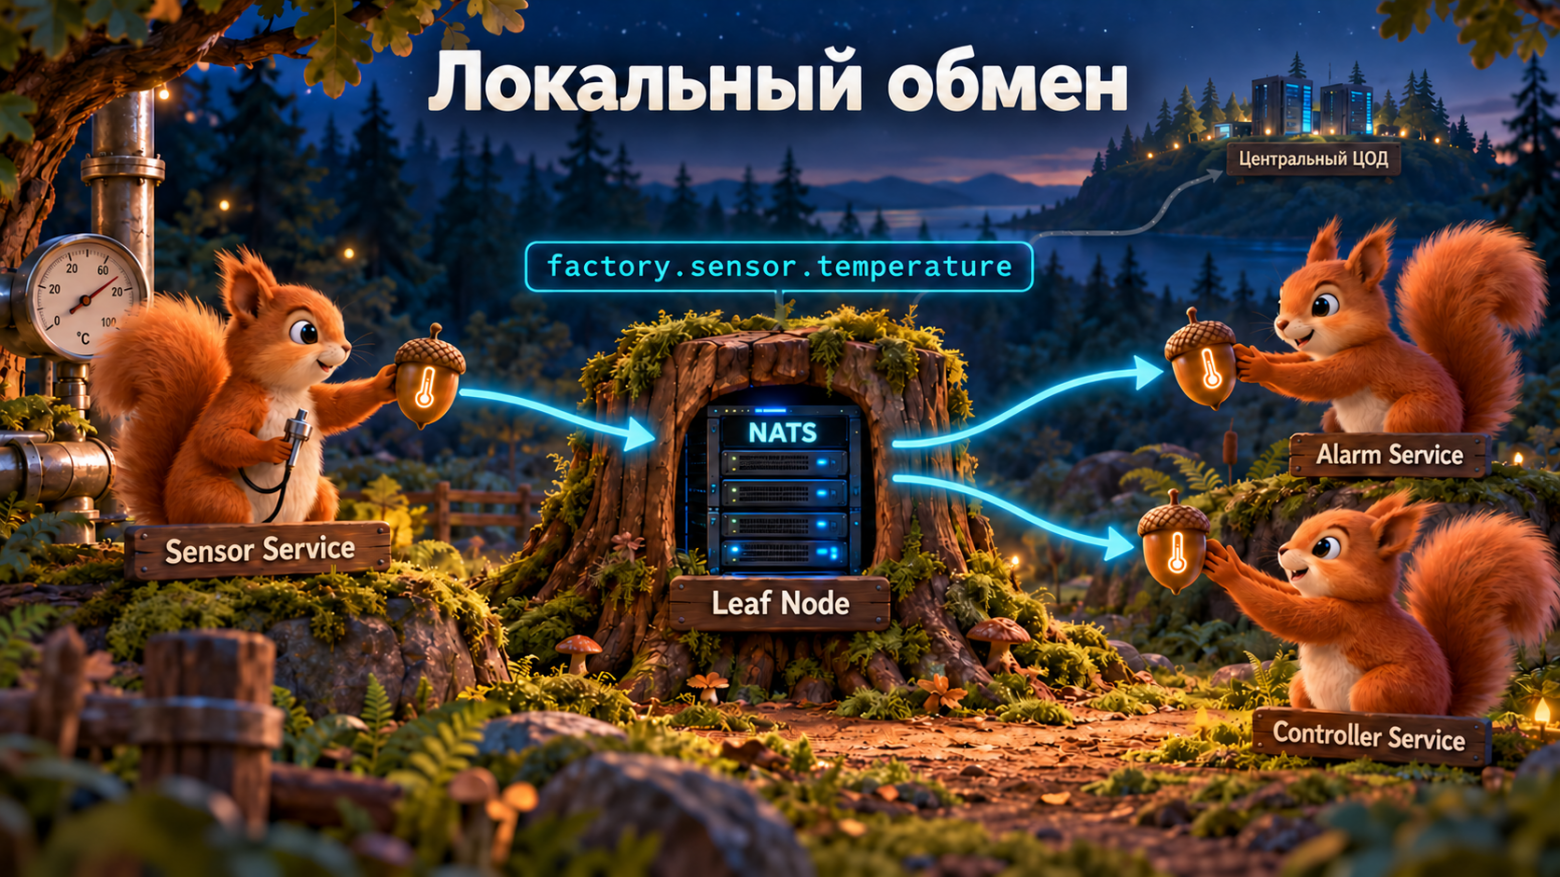
Центральному ЦОДу эти показания могут быть не нужны. Если там нет подходящих подписчиков, Leaf Node не будет передавать такой Core NATS-трафик в центральный кластер.
Таким образом, локальные сервисы взаимодействуют без лишних обращений через межплощадочную сеть.
Сценарий 2. Отправка события в центральный ЦОД
Теперь представим, что Alarm Service обнаружил перегрев оборудования.
Он публикует событие: factory.machine.alert
В центральном ЦОДе Monitoring Service подписан на этот subject.
Маршрут сообщения будет таким:
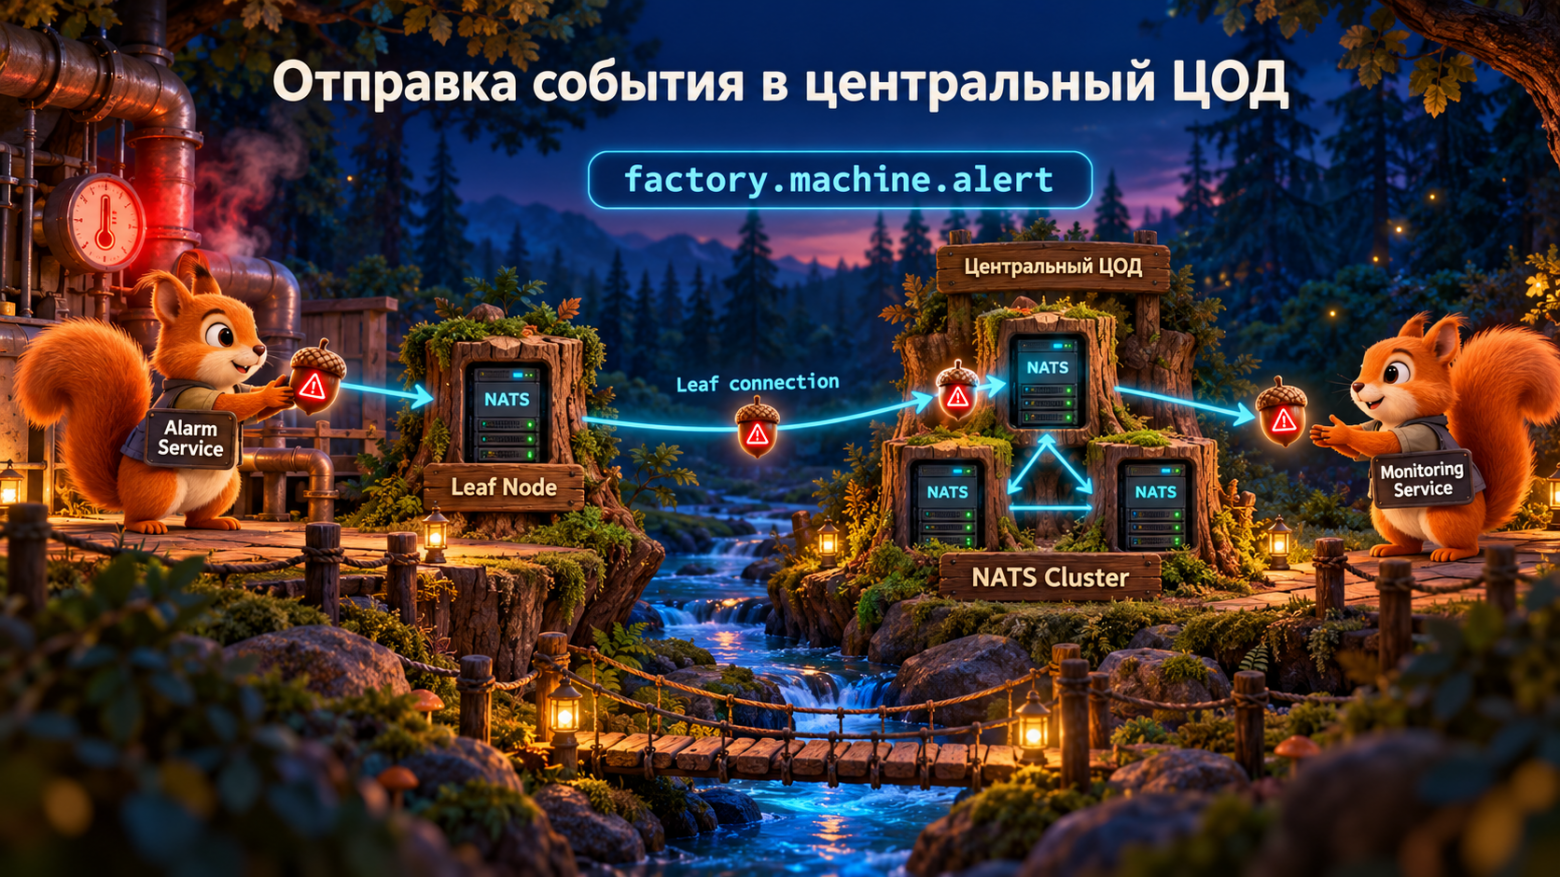
При этом код Alarm Service не меняется. Он по-прежнему публикует сообщение в локальный NATS, а Leaf Node обеспечивает передачу в центральную систему, поскольку там есть соответствующий подписчик.
Сценарий 3. Команда из центрального ЦОДа на завод
Обмен работает и в обратную сторону.
Допустим, центральный сервис отправляет команду: factory.machine.command
На заводе Controller Service подписан на этот subject.
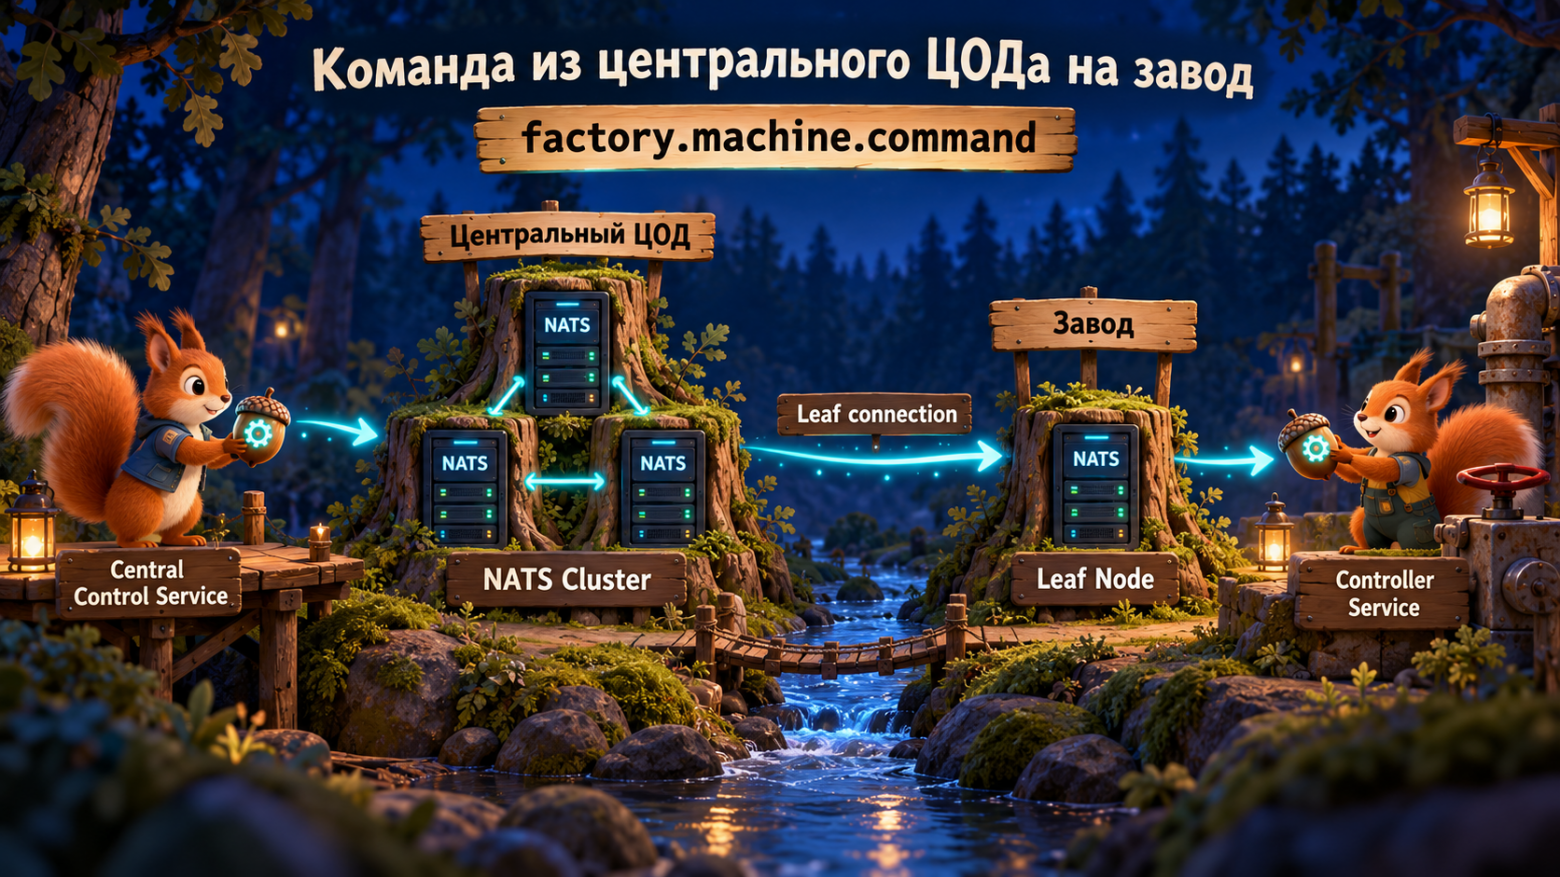
Таким образом, локальные приложения могут получать команды от центральной системы, не подключаясь напрямую к её серверам.
Что будет, если связь с ЦОДом пропадёт?
Это ещё одна причина использовать Leaf Node.
Представим, что между заводом и центральным ЦОДом временно пропала сеть.
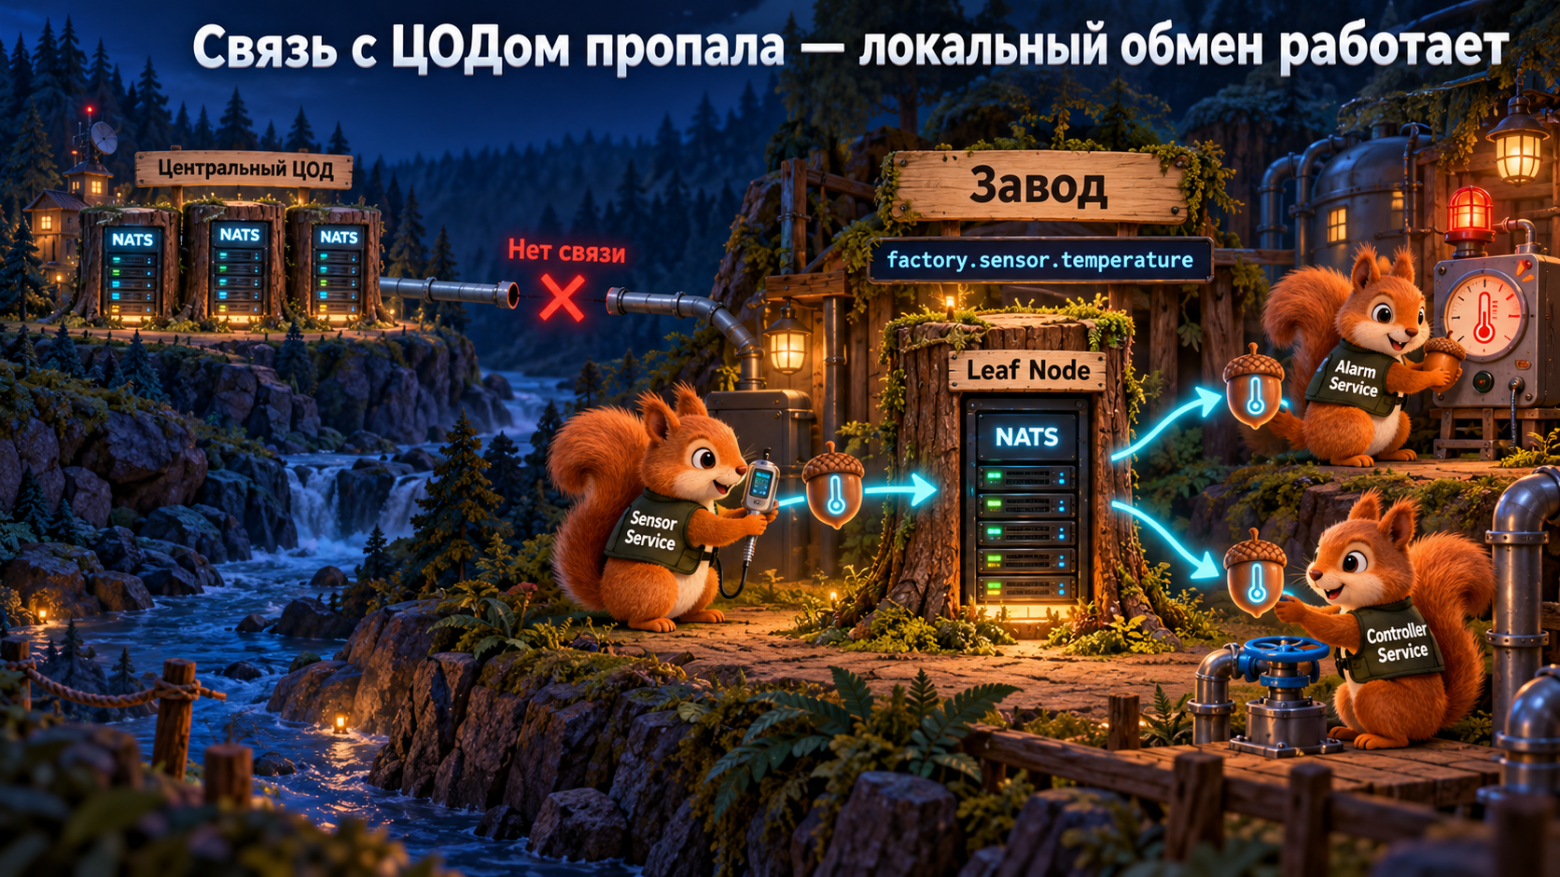
Локальный NATS продолжает работать. Sensor Service может публиковать температуру, Alarm Service - реагировать на превышение, а Controller Service - управлять оборудованием.
То есть локальный обмен сообщениями не зависит от постоянной доступности центрального ЦОДа.
Но есть ограничение: если в момент разрыва соединения локальный сервис опубликует сообщение, предназначенное центральному подписчику, Core NATS не сохранит его автоматически для последующей доставки.
Для гарантированной передачи после восстановления связи потребуется отдельное решение на базе JetStream, например локальное сохранение событий с последующей передачей через настроенный механизм синхронизации. Сам Leaf Node такой гарантии не даёт.
А subjects у Leaf Node свои или общие?
По умолчанию Leaf Node и центральная NATS-система могут обмениваться сообщениями в общем пространстве subjects, если это разрешено настройками соединения, аккаунтов и прав доступа.
Например:
factory.sensor.temperature
factory.machine.alert
factory.machine.command
Все три subject могут использоваться локальными приложениями. Но фактическая передача сообщения через leaf-соединение зависит от интереса подписчиков на другой стороне и настроек доступа.
Если нужно разделить локальные и центральные subjects, можно использовать отдельные аккаунты, разрешения и настройки экспорта/импорта или remapping subjects. Само имя factory.* не делает сообщение автоматически локальным.
Иными словами, Leaf Node не требует от разработчика отдельного API для отправки сообщений в центральный кластер. Приложение публикует сообщение привычным способом, а NATS определяет, куда его маршрутизировать.
Чем Leaf Nodes отличаются от Super-Cluster
После примера с заводом различие становится заметнее.
Super-Cluster нужен, когда есть несколько полноценных кластеров, которые должны взаимодействовать как части распределённой NATS-инфраструктуры.
Leaf Node нужен, когда существует локальная NATS-система, которую требуется связать с основной инфраструктурой.
Важно, что это не взаимоисключающие варианты. Например, центральная инфраструктура может быть Super-Cluster из двух ЦОДов, а завод подключаться к одному из его кластеров через Leaf Node.
Как выбрать топологию
Топология | Основная задача | Типичный сценарий |
|---|---|---|
Single Server | Запустить один экземпляр брокера | Разработка, тестирование, небольшие системы |
Cluster | Обеспечить отказоустойчивость и масштабирование | Production внутри ЦОДа |
Super-Cluster | Связать несколько кластеров | Несколько ЦОДов, регионов или облаков |
Leaf Nodes | Подключить отдельную локальную систему | Edge-инфраструктура, изолированный контур |
Главная идея NATS заключается в том, что топология может развиваться вместе с инфраструктурой: от одного сервера до нескольких кластеров с подключёнными локальными системами.
При этом нужно помнить о различии между маршрутизацией сообщений и гарантиями их сохранности. Cluster, Super-Cluster и Leaf Nodes определяют, как связаны серверы и куда могут передаваться сообщения. А требования к хранению, подтверждению и повторной доставке нужно отдельно реализовывать и настраивать с помощью JetStream.
Для каких задач подходит NATS
Выбор зависит от того, что важнее конкретной системе: минимальная задержка, простота эксплуатации, хранение событий, гарантии доставки или работа между несколькими площадками.
NATS хорошо подходит, если:
Нужен быстрый обмен сообщениями с минимальной задержкой.
Одна из сильных сторон Core NATS - низкая задержка при передаче сообщений. Если сообщение не требуется предварительно сохранять на диск или подтверждать со стороны consumer, NATS получает его от publisher и сразу маршрутизирует активным подписчикам.
Это хорошо подходит для взаимодействий, где важна скорость реакции, а потеря сообщений допустима.
Нужны разные модели взаимодействия через один брокер.
В рамках одной системы NATS позволяет использовать несколько моделей:
Pub/Sub - одно событие получают все заинтересованные подписчики;
Queue Groups - сообщение обрабатывает один из экземпляров сервиса;
Request-Reply - один сервис отправляет запрос и ожидает ответ;
JetStream - сообщения сохраняются и могут быть доставлены повторно.
При этом все эти сценарии используют одну и ту же модель subjects и клиентские библиотеки NATS.
Нужно простое хранилище без отдельного сервиса.
Поверх JetStream в NATS реализованы Key-Value Store и Object Store. Первый подходит для хранения конфигурации, feature-флагов или небольшого общего состояния. Второй - для объектов, которые слишком велики для обычного сообщения: PDF-отчётов, изображений, архивов. Оба поддерживают репликацию и персистентность.
Нужна гарантия, что сообщение будет доставлено.
Если сообщение нельзя потерять только потому, что consumer временно недоступен, можно использовать JetStream.
Нужно масштабировать обработчики горизонтально.
Если сервис запущен в нескольких экземплярах, Queue Groups позволяют распределять сообщения между ними.
Каждое сообщение получает один участник группы. Поэтому для масштабирования обработчика достаточно запустить дополнительные экземпляры сервиса.
Система работает в нескольких ЦОДах или регионах.
Если инфраструктура распределена географически, NATS позволяет не растягивать один кластер между всеми площадками.
В каждом ЦОДе можно разместить собственный NATS Cluster и объединить их в Super-Cluster.
Есть отдельные локальные или edge-системы.
Если часть системы должна работать локально и не зависеть от постоянного соединения с центральным ЦОДом, можно использовать Leaf Nodes.
Локальные сервисы продолжают взаимодействовать через свой NATS даже при временной недоступности центральной инфраструктуры, а необходимые subjects могут передаваться между локальной и центральной системами.
Итоги
В этой статье мы разобрали, как NATS организует обмен сообщениями: от маршрутизации через subjects и основных паттернов взаимодействия до хранения сообщений в JetStream и построения распределённой инфраструктуры с помощью Cluster, Super-Cluster и Leaf Nodes. Такой набор возможностей позволяет использовать NATS для решения разных задач, но не делает его универсальным.
RabbitMQ, Kafka и другие брокеры имеют свои сильные стороны и сценарии, в которых могут подходить лучше. Поэтому выбор зависит не от количества возможностей, а от требований конкретной системы. Но это уже отдельный разговор.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.