Критерии приемки AI/ML-проекта: как определить качество результата и что закрепить в договоре
В разработке большую часть функционала оценивают бинарно — либо кнопка работает, либо нет. А вот в алгоритмах с нейросетями результат всегда остается вероятностным и зависит от n-го числа параметров.
Я Евгений Макутин, ML-инженер в веб-продакшене Далее. В статье расскажу, как договориться о способах измерения качества и условиях, при которых результат AI/ML-решения считается принятым.
Главные судьи в оценке качества AI/ML-продуктов — измеримые показатели
Если приступить к AI/ML-проекту, имея только абстрактные требования, то в конце они могут трактоваться по-разному и откладывать продакшн. Например: «модель должна хорошо распознавать дефекты». Что значит «хорошо»?
У «хорошо» должны быть четко описанные способы расчета и допустимые значения. Не примерные и не выдуманные по ходу реализации, а указанные точными числами в ТЗ с развернутыми условиями их достижения. Поэтому еще до старта разработки нужно согласовать:
какую задачу решает AI и по каким метрикам будет оцениваться качество,
при каких показателях и условиях результат считается принятым.
В договоре прописываем предмет работ, ответственности сторон и критерии приемки со ссылками на ТЗ, в котором обозначены все детали.
Как выбрать метрики и числовые пороги
Все и всегда в разработке начинается с понимания задачи. В первую очередь нам нужно:
верно определить желаемый бизнес-эффект — что максимизируем или минимизируем с помощью AI;
подобрать метод решения и экспериментально проверить, подходит ли он вообще.
И только после теста можно переходить к метрикам и замеру качества. Тогда у нас будет чистая математика, без предположений. В идеале для точки отсчета опробовать наиболее простые варианты:
вместо AI-ассистента запустить чат-бот на заданных правилах;
для прогнозирования спроса собрать расчет в Excel на исторических данных;
в крайнем случае — протестировать гипотезу на предобученных нейросетях.
Базовое решение (baseline) очень полезно для AI/ML-проекта. Если механика даст нужный эффект, то мы быстрее подтвердим гипотезу и начнем измерять результат в числах.
Только не берите для расчета все возможные метрики. Ни вам, ни клиенту не нужны 20–30 косвенных показателей. Согласуйте и пропишите 1–3 метрики, которые хорошо интерпретируют решение задачи. Ниже покажу, какими они могут быть на AI/ML-проектах.
Метрики классификации помогают определить, как точно модель распределяет объекты по категориям
Представим, что нам нужно распознать по фото, есть ли у деталей дефекты. Возьмем 100 деталей: 20 с браком и 80 исправных. При проверке с AI получили 25 отметок «брак»: 15 верных и 10 ложных. Еще 70 исправных определили правильно, а 5 дефектных деталей нейросеть вовсе пропустила.
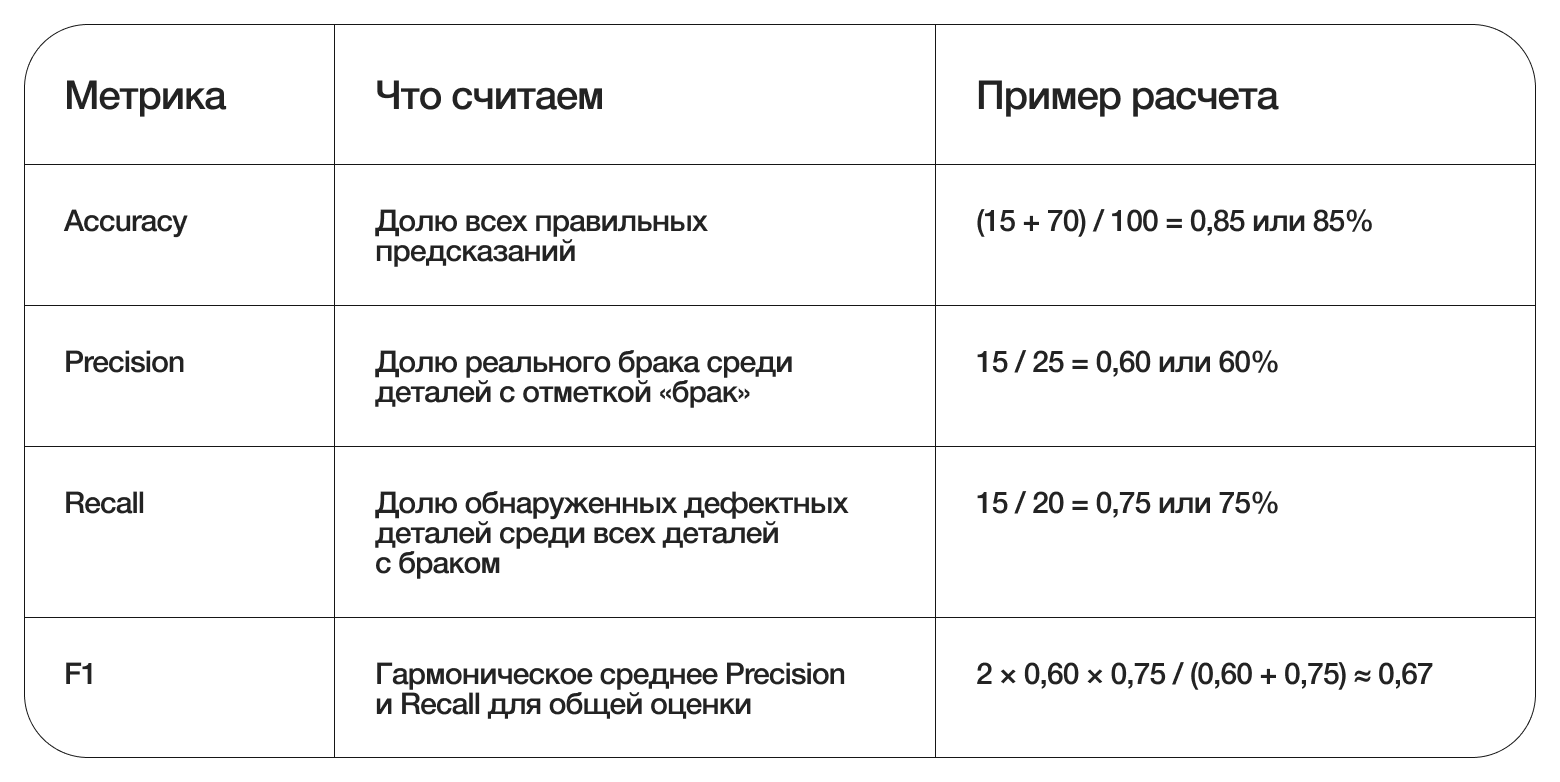
Если брать в учет только Accuracy, то 85% — вроде как «хорошо». Но, изучив другие метрики, видим, что результат получился средним, хотя и не самым плохим. Зависел ли он от качества изображений? Возможно. В любом случае пропущенный дефект — это риск выпустить массовый брак, а ложное срабатывание — лишняя ручная проверка.
Заранее обсуждаем с клиентом форматы, последствия ошибок и при необходимости задаем отдельные пороги Precision и Recall. Хорошее объяснение формул можно посмотреть в учебнике по машинному обучению от ШАД Яндекса.
Метрики регрессии показывают, насколько модель ошибается, когда предсказывает число
Допустим, модель прогнозирует стоимость квартир. Мы проверяем ее на объектах, которые уже куплены.
Первая квартира была продана за 10 млн ₽, а модель спрогнозировала 12 млн ₽ — ошибка составила 2 млн ₽. Вторая была продана за 20 млн ₽, модель спрогнозировала 16 млн ₽ — ошибка составила 4 млн ₽.
Для сравнения предположим, что прогноз без AI для обеих квартир — 15 млн ₽.
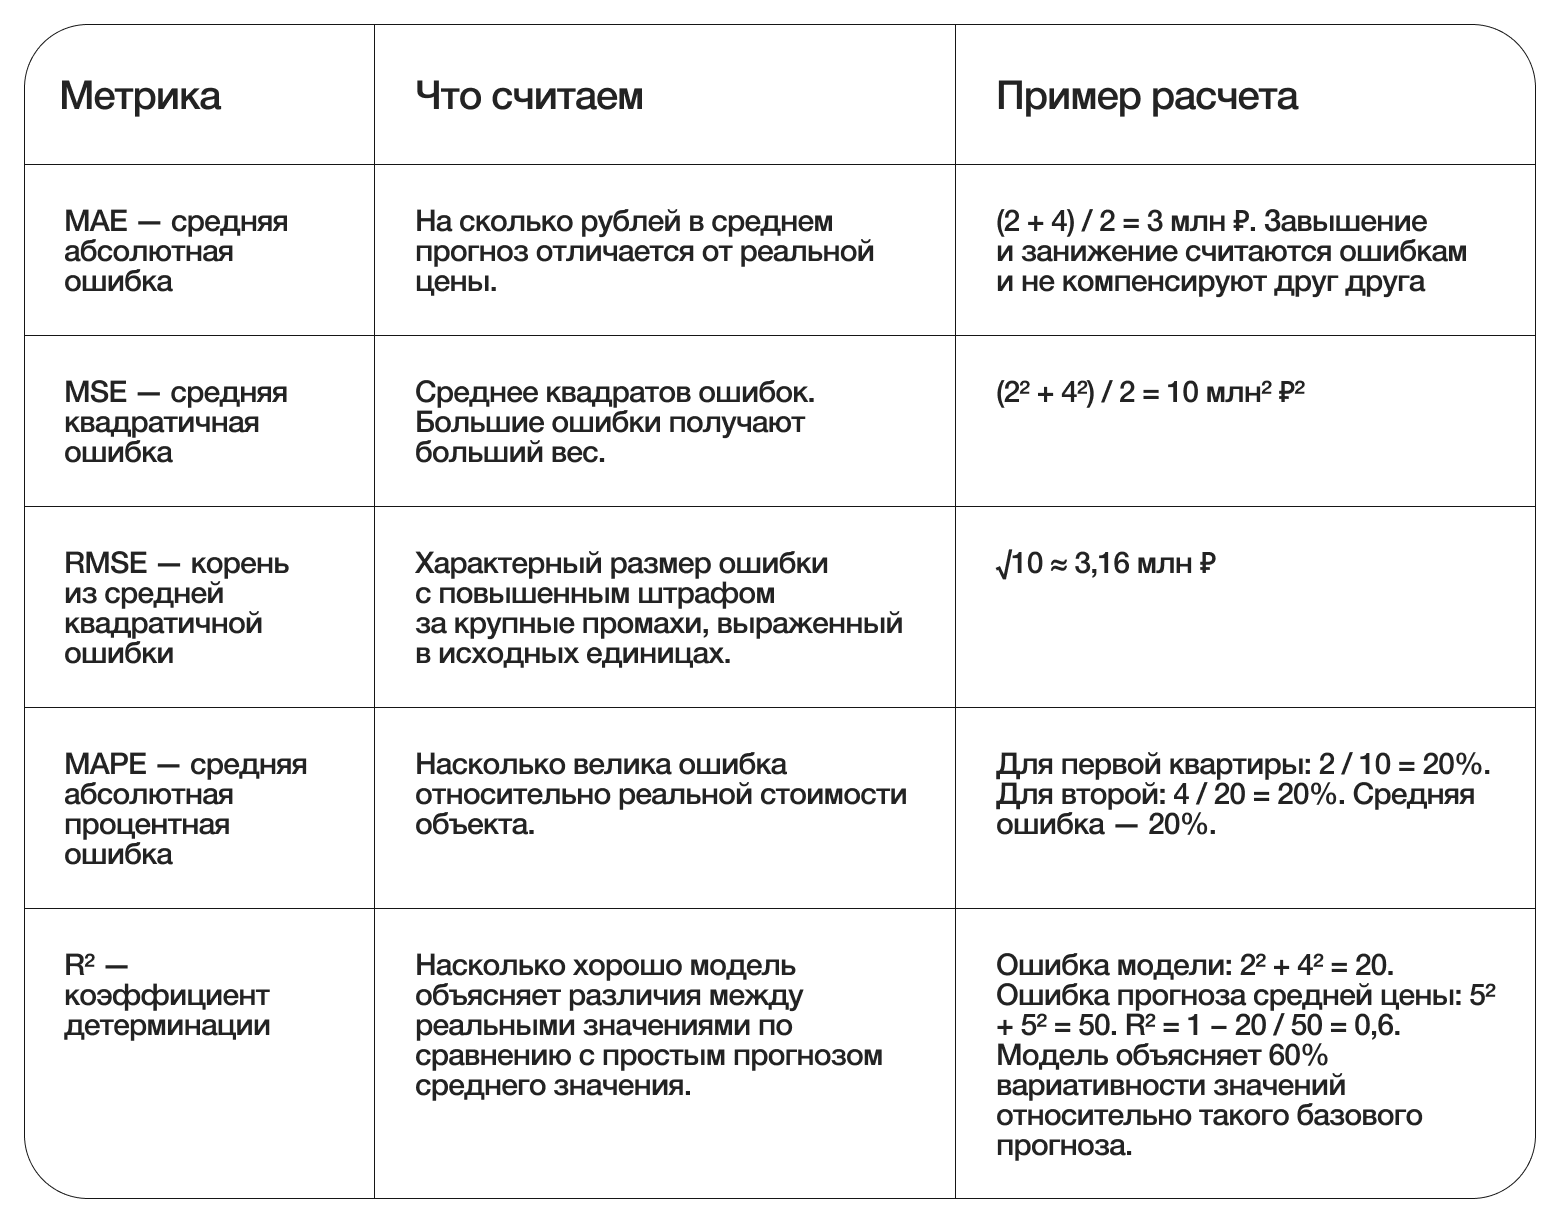
Заказчик должен определить, какая ошибка допустима для его бизнеса. Тогда можно сравнить полученный результат с этим требованием.
Еще стоит учитывать, что MAPE плохо подходит для нулевых и близких к нулю величин, а R² не равен доле верных ответов. Подробнее о метриках регрессии.
С помощью метрик поиска и рекомендаций проверяем релевантность выдачи
В поиске подбираем документы под запрос, в рекомендациях — товары или контент под интересы пользователя. Смотрим, сколько результатов подходят и насколько высоко они расположены.
Хотите в отпуск? Давайте попробуем его «оформить» и посмотрим, как поможет модель.
Эксперты заранее отметили в базе 8 подходящих документов. В первых 5 результатах поиска оказались 4 подходящих и 1 посторонний. Посторонний документ стоит первым, подходящие — на местах ниже.
K — количество первых результатов, которые оцениваем. Здесь K = 5, поэтому в названиях метрик используем запись @5. Все подходящие документы в этом примере считаем одинаково полезными.
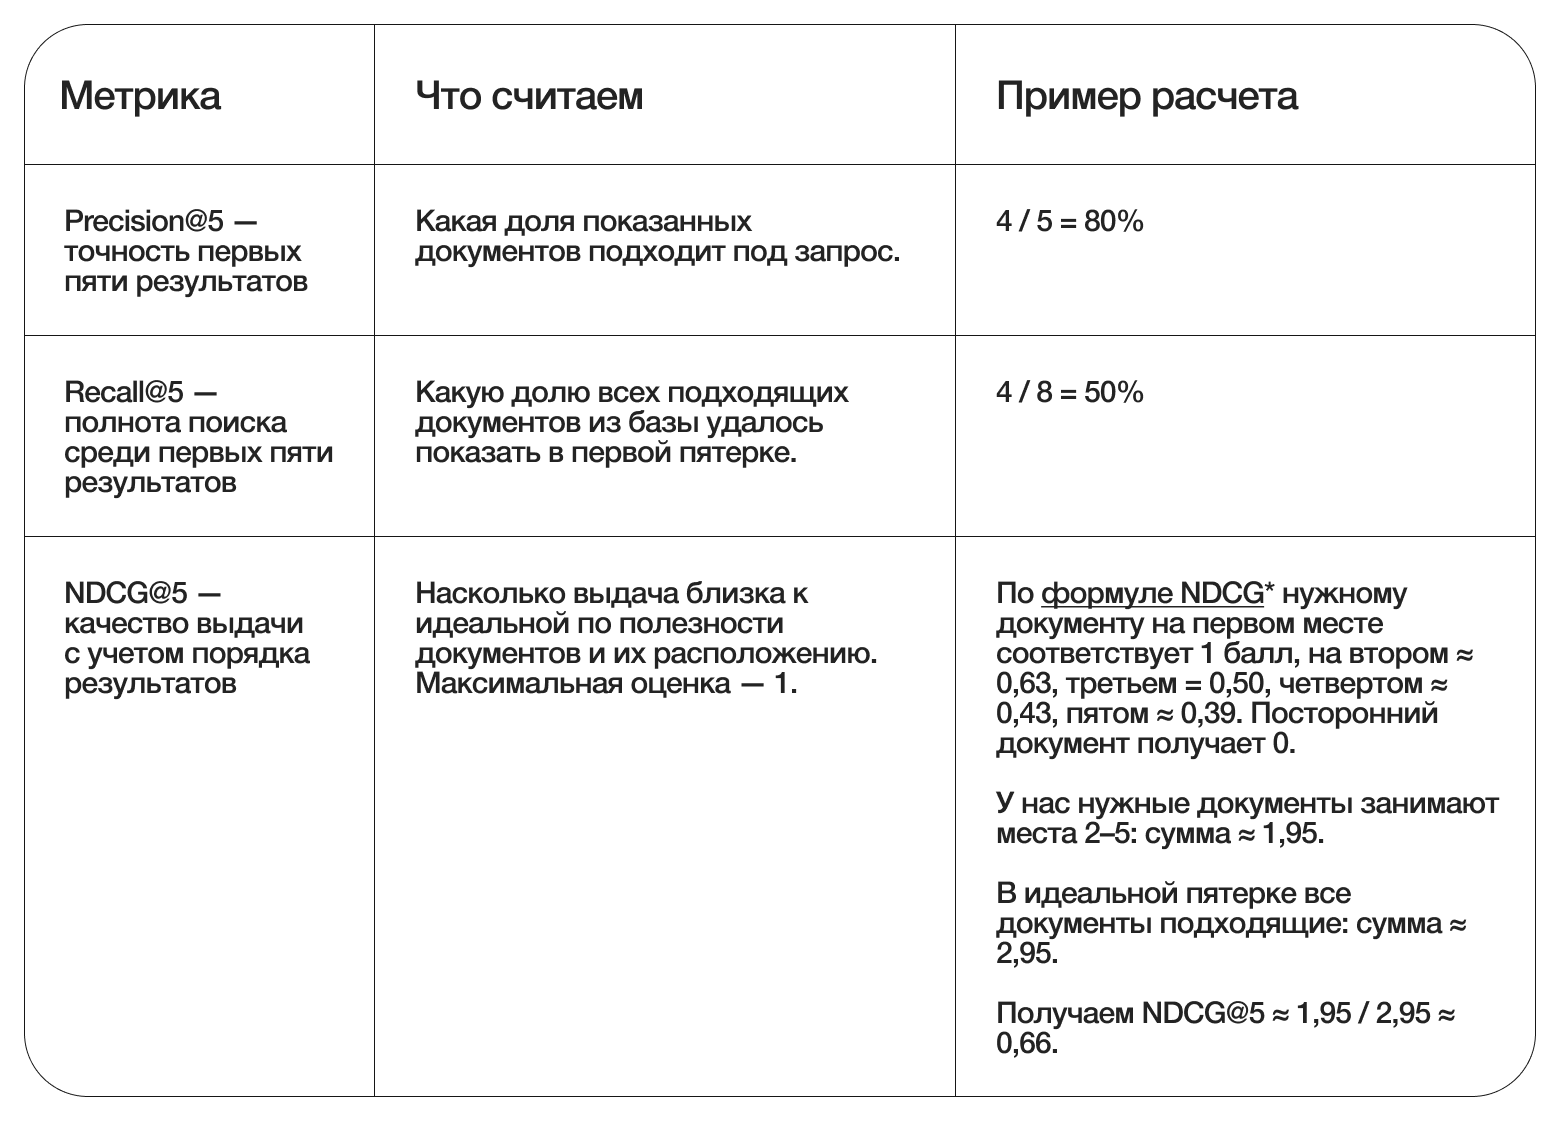
Если переместить посторонний документ с первого места на пятое, NDCG@5 вырастет примерно до 0,87. Precision@5 и Recall@5 сохранятся, ведь количество подходящих документов осталось прежним, изменился их порядок.
Для рекомендаций принцип тот же, но на старте определяем, какие предложения считать подходящими. Например, при подборе аксессуаров к кофемашине проверяем совместимость с конкретной маркой и моделью кофемашины.
Метрики ответов LLM — насколько хорошо модель переводит текст, составляет пересказ или отвечает на вопросы
Пользователь просит: «Переведи на русский: Your order will arrive on Friday».
Эталон от переводчика: «Ваш заказ доставят в пятницу» — 5 слов.
Ответ модели: «Ваш заказ доставят в пятницу утром» — 6 слов.
В ответе сохранились все 5 слов эталона, но появилось уточнение «утром», которого в исходнике нет.
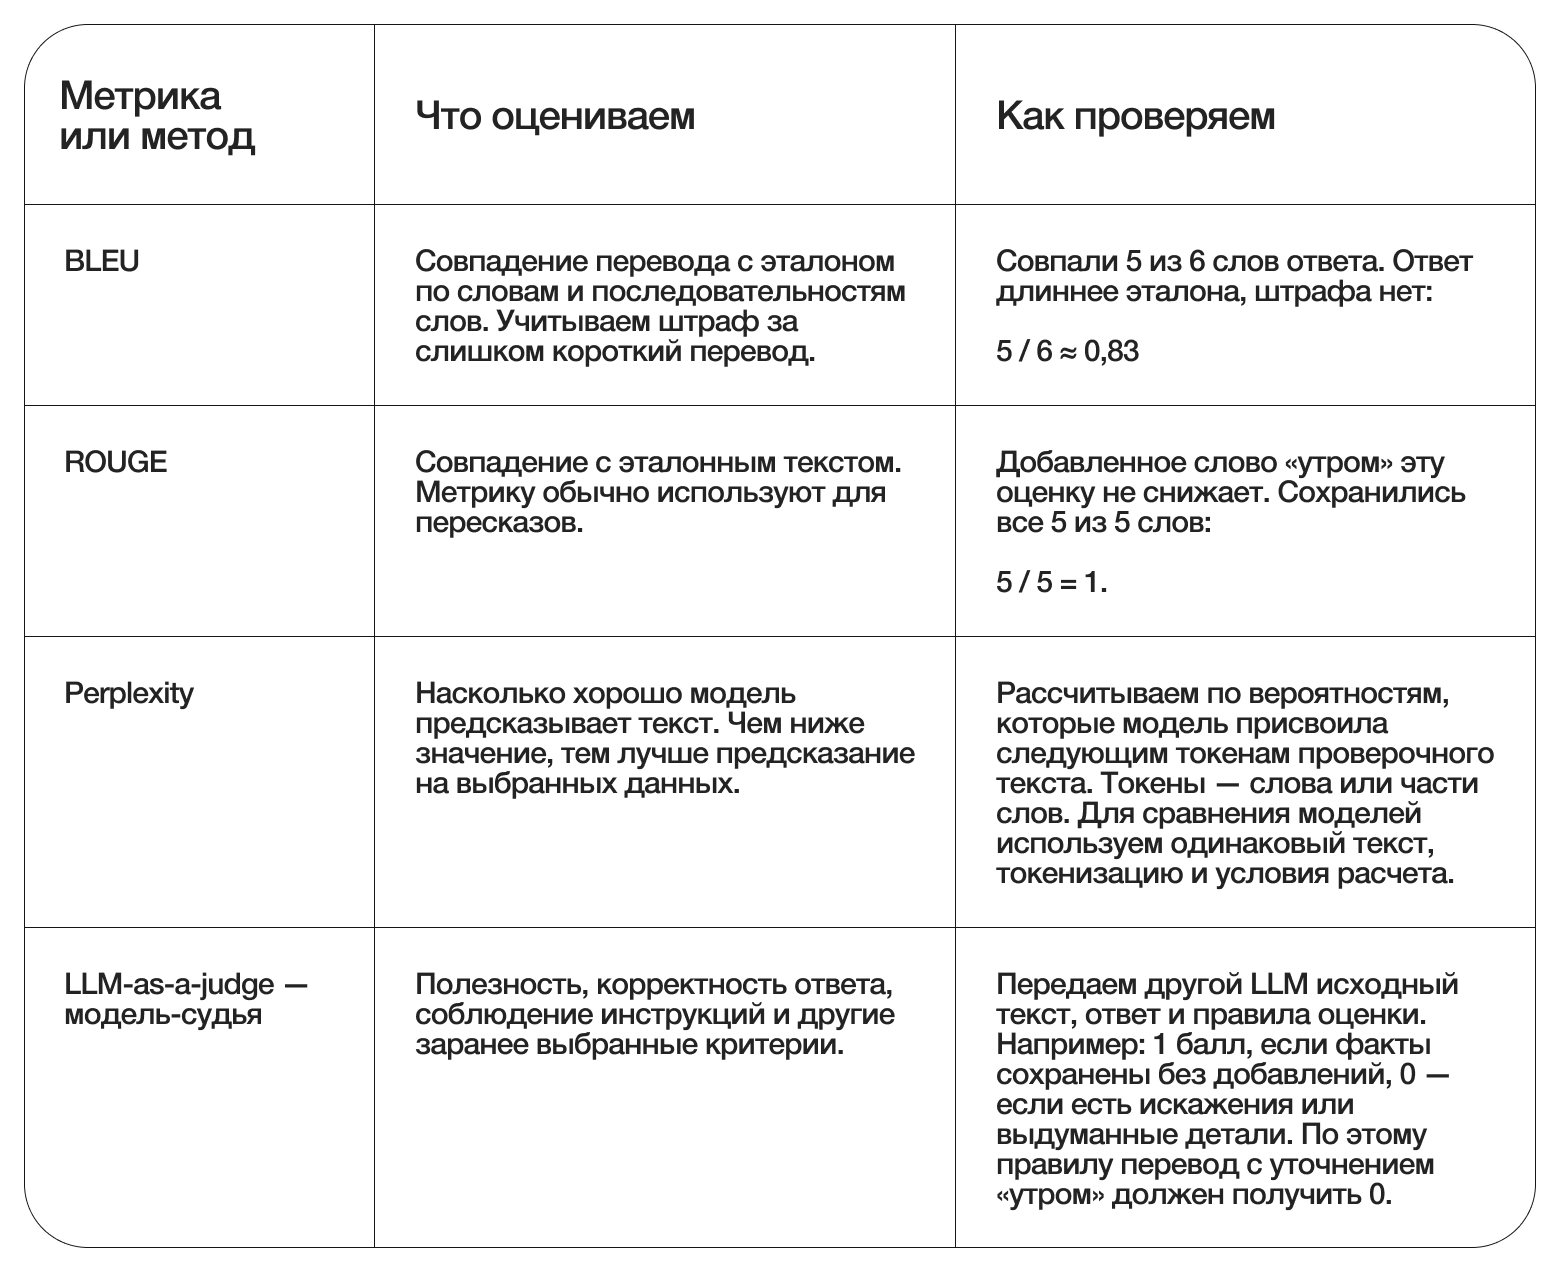
В нашем примере ROUGE-1 Recall равен единице, хотя модель добавила неподтвержденное время доставки. Поэтому совпадение слов дополняем проверкой фактов. Оценки модели-судьи тоже сверяем с экспертными. Она может пропустить ошибку.
Оффлайн-метрики — не единственные критерии приемки. Однако вопросы скорости, производительности, потребления ресурсов, безопасности и прочих стандартных для IT-проектов параметров остаются за рамками данной статьи, хотя их оценка и оптимизация, безусловно, важны для любой системы.
Кроме того, существуют онлайн- и косвенные показатели — так называемые прокси-метрики. Их тоже выбирают под задачу и ожидаемый эффект, обязательно разграничивают ответственность между клиентом и разработчиком. В продакшене мы продолжаем контролировать качество ответов, скорость, доступность сервиса и ошибки. Бизнес оценивает конверсию, выручку, возвращаемость пользователей, снижение ручной работы — то, что не проверить в день подписания акта.
В договоре ссылаемся на детальное описание условий для достижения показателей
Рядом с метриками в ТЗ фиксируем все, что влияет на работу модели. Если договорились о качестве 90%, то уточните, на каких данных, в каких сценариях и с какими ограничениями это значение будет проверяться.
Так, в дневное время система компьютерного зрения (CV) может показывать 80–90%, а в темное — 60–70%. Без требований к освещению заказчик будет ожидать одинакового результата в обоих случаях.
Возможные требования к проектам CV
В разработке решений с компьютерным зрением очень многое зависит от условий съемки, вплоть до освещения пространства, в котором установлена камера. И все это желательно не обговорить, а закрепить письменно.
Угол съемки. Указываем, что отклонение камеры от перпендикуляра к поверхности — не более 30°. Если при большем угле показатель качества снижается на 15–20 процентных пунктов, это ограничение фиксируют по результатам тестов.
Расстояние до объекта. Фиксируем: рабочий диапазон — 50–150 см. Для расстояний менее 30 см или более 3 м нужны отдельные проверки. Если такие условия входят в задачу, можно согласовать допустимое снижение показателя — например, не более чем на 10 процентных пунктов.
Фон и посторонние предметы. На однородном фоне доля корректных распознаваний может составлять 95%, а при появлении 5–10 посторонних предметов — снижаться до 85% или даже 70%. Нужно уточнить, какой фон допустим и на каких сценах проверяют качество.
Частота обработки кадров. Если система анализирует 2 кадра в секунду, видеопоток в 30 FPS не означает, что она проверяет каждый кадр. Для работы в реальном времени отдельно согласуют частоту анализа и максимальную задержку результата.
Освещение. Фиксируют диапазон освещенности в люксах, допустимые источники света и ограничения: например, прямой солнечный свет в объектив, блики или глубокие тени.
Требования к скорости и качеству сверяем с клиентом. Может быть так, что одна версия модели дает 95–98% по выбранной метрике, но обрабатывает кадры слишком медленно. Ускоренная версия укладывается в нужную задержку, но дает 70–75%. Приемлемый вариант согласовываем до приемки.
Возможные требования к проектам LLM
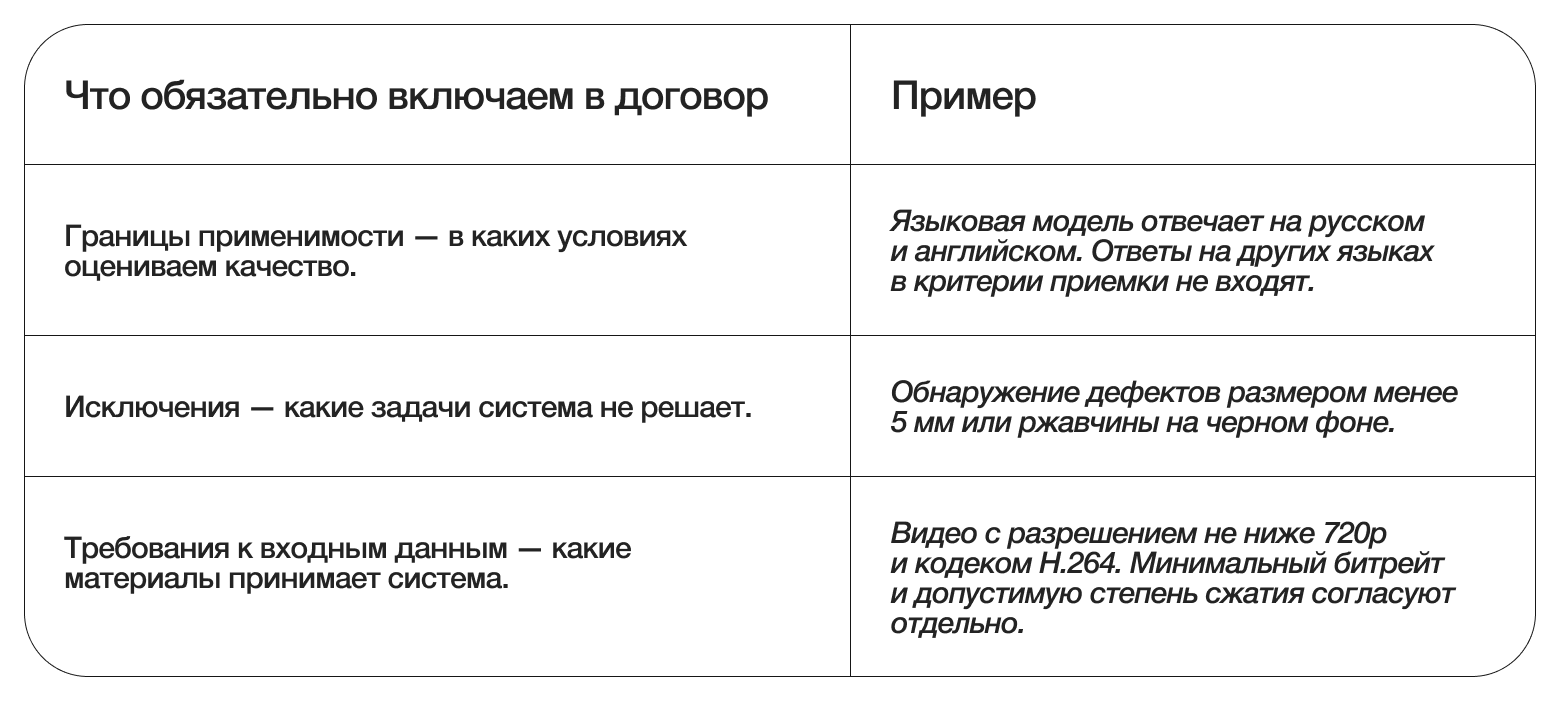
Для LLM-проектов отдельно ограничивают размер входного сообщения и общий контекст. Например, сообщение пользователя — до 500 символов, а контекст с инструкциями, историей диалога и документами — до 8 000 токенов. Кроме того, нужно подробно описать допустимые запросы и ожидаемые ответы:
Тематика и языки. Например, помощник отвечает на русском и английском по документации конкретного продукта. На вопросы вне этой темы сообщает об ограничении.
Форматы запросов. Указывают, принимает ли система только текст или умеет работать с изображениями, голосовыми сообщениями и файлами. Для каждого поддерживаемого формата задают ограничения.
Поведение при неясном вопросе. Например, помощник один раз просит уточнение. Если информации по-прежнему недостаточно, объясняет, каких данных не хватает, и завершает попытку ответа.
Исключенные задачи. Например, помощник по продукту не дает медицинских рекомендаций и не оценивает кредитоспособность. Перечень зависит от назначения системы.
Структура ответа. Например, 1–3 предложения, без эмодзи и маркированных списков. Если ответ передается другой системе, задают формат JSON и обязательные поля. Для отображения пользователю можно согласовать Markdown.
Подтверждение фактов. Для ответов по документации можно установить правило: каждое фактическое утверждение сопровождается ссылкой на источник, который его подтверждает. Отсутствие подтверждения считается ошибкой по согласованным критериям.
Токсичность. Определяют, какие ответы считаются недопустимыми: например, содержащие оскорбления или нецензурную лексику. Затем задают способ проверки и допустимый порог ошибок.
Стабильность. Например, при 10 повторениях одного вопроса как минимум 9 ответов должны совпадать по фактам и выводам. Если требуется дословное совпадение, это указывают отдельно.
Для повторных проверок фиксируют версию модели, инструкции и настройки генерации. Иначе расхождение результатов может быть связано с изменением конфигурации.
Ограничения сценариев влияют и на скорость, и на расходы. Если агент рассчитан на последовательность из 3 расчетных операций, сценарий из 50 операций требует отдельной оценки. Для него нельзя автоматически обещать прежнее время ответа и стоимость обработки.
В процедуре приемки прописываем последовательность действий
Запустить систему на тестовой выборке — например, на 50 случайных примерах, выбранных заказчиком.
Сформировать отчет по метрикам.
Проверить скорость и другие эксплуатационные показатели в согласованных условиях.
Зафиксировать результаты и подписать акт, если все критерии выполнены.
В договоре нужно раскрыть, что именно проверяет клиент, какие ответы считает ошибочными и сколько таких ошибок допустимо.
Отдельно описываем порядок изменения требований
Новый формат данных, другая камера, добавление классов объектов или функции могут потребовать дополнительного обучения модели, пересмотра метрик и бюджета.
Если модель обучили различать 2 класса — людей и собак, то включение третьего класса меняет задачу и требует другой проверки.
В ТЗ нужно установить, как влияют и отрабатываются все изменения. Проверять результат следует по той версии требований, которую согласовали обе стороны. Для утверждения формулировок в договоре стоит привлекать юристов.
Проверяем, остались ли в договоре абстрактные места
Формулировки типа «модель должна работать качественно». Прописываем название метрики, способ расчета и допустимое значение. Иначе даже после нескольких доработок результат может быть недостаточно «хорошим».
Метрика есть, но без условий измерений. Обязательно учитывайте, утверждайте и прописывайте все обстоятельства, которые влияют на работу модели. Замена камеры или формата данных может потребовать дообучения. Без согласованного порядка изменений придется отдельно говорить о сроках и оплате этих работ.
Бизнес-метрика без разделения ответственности. Отказы из-за того, что что-то сломалось, например, выдача стала нерелевантна — это зона ответственности команды разработки. Но если дело в стоимости или отсутствии товара — разработчик это не исправит. Надо разграничить ответственность за показатели.
В договоре нет исключений. На приемке могут проверить сценарий, на который модель не рассчитана. Условия описывают, при каких данных и обстоятельствах проверяем качество. Исключениями дополняем задачи, которые не входят в объем разработки, даже если все условия соблюдены. Например: «Помощник объясняет порядок возврата товара, но самостоятельно оформить возврат и перечислить деньги не может — такие действия не предусмотрены».
«Точность 90%» без описания выборки. Разработчик и заказчик могут получить разные результаты на разных данных. Если готовой выборки пока нет, заранее согласуйте, кто собирает и размечает примеры, как утверждают их состав и какие данные используют для обучения, настройки и приемки.
Начать можно с небольшого набора и дополнять датасет в ходе проекта. Нужный объем примеров определяем после аудита данных и анализа задачи. Финальные пороги метрик в договоре могут изменяться до получения baseline-решения.
В договоре устанавливаем срок, к которому стороны утвердят приемочную выборку и окончательные показатели качества. Например, за 2 месяца до завершения проекта — если этого достаточно для доработок и повторной проверки.
Пороговая приемка вместо бинарной
Для AI/ML-проекта можно заранее согласовать несколько зон результата, указав для каждой свои последующие действия. Например, возьмем условную метрику M, для которой большее значение означает лучшее качество.
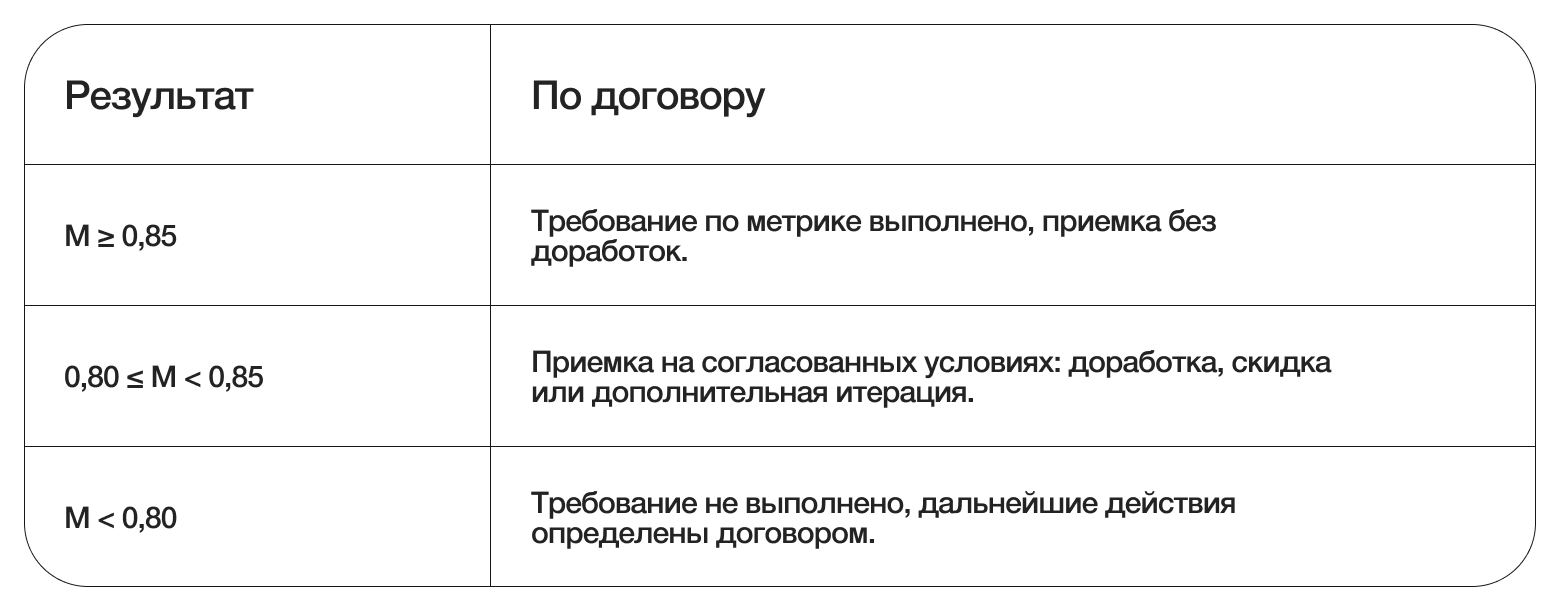
Если вы согласовали с заказчиком, что при среднем показателе, в нашем случае от 0,80 до 0,85, предусмотрена доработка проекта, то зафиксируйте ее объем, срок и порядок повторной проверки.
После сдачи пилота все используемые метрики помогут развивать продукт. С их помощью можно сравнивать версии модели, проверять изменения промптов и базы знаний, находить ошибки на реальных запросах. По результатам продакшна проводят последующие доработки и проверяют уже их эффект.
А какие шаги перед разработкой AI/ML-проектов выполняете вы? Приходилось сталкиваться со спорными моментами при приемке/сдаче работ?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.