Как узнать, сколько сообщений в чате Telegram. Проверил способы из интернета на своих чатах
Стало интересно, сколько сообщений мы с женой написали друг другу за всё время.
Оказалось, что в Telegram нет счётчика сообщений. Совсем: ни в профиле собеседника, ни в настройках, ни в поиске. Статистика есть у каналов, но она про охваты и подписчиков, а не про переписку с женой.
Странно, правда? Приложение хранит каждое сообщение и при этом не может сказать, сколько их. Я полез искать способы и нашёл три, которые советуют чаще всего. Введи в поиск точку. Посмотри номер последнего сообщения. Выгрузи чат и посчитай. Ни один из них не выглядит сложным, поэтому я решил не верить на слово и проверить на своих чатах: шесть личных и две группы, 192 тысячи сообщений за семь лет. Потом добавил четвёртый способ, через API.
Про итог скажу сразу, чтобы не томить: точно считает один способ, и это не тот, что обычно все советуют. Ещё один считает почти точно, если вычесть лишнее.
Поиск
Тут всё упирается не в Telegram, а в логику. Поиск работает по тексту, а в переписке очень много сообщений без текста: голосовые, кружки, стикеры, фото без подписи. Я посчитал, в какой доле сообщений каждого чата вообще есть хоть одно слово. Это потолок, выше которого поиск не поднимется, даже если найдёт всё, что умеет.
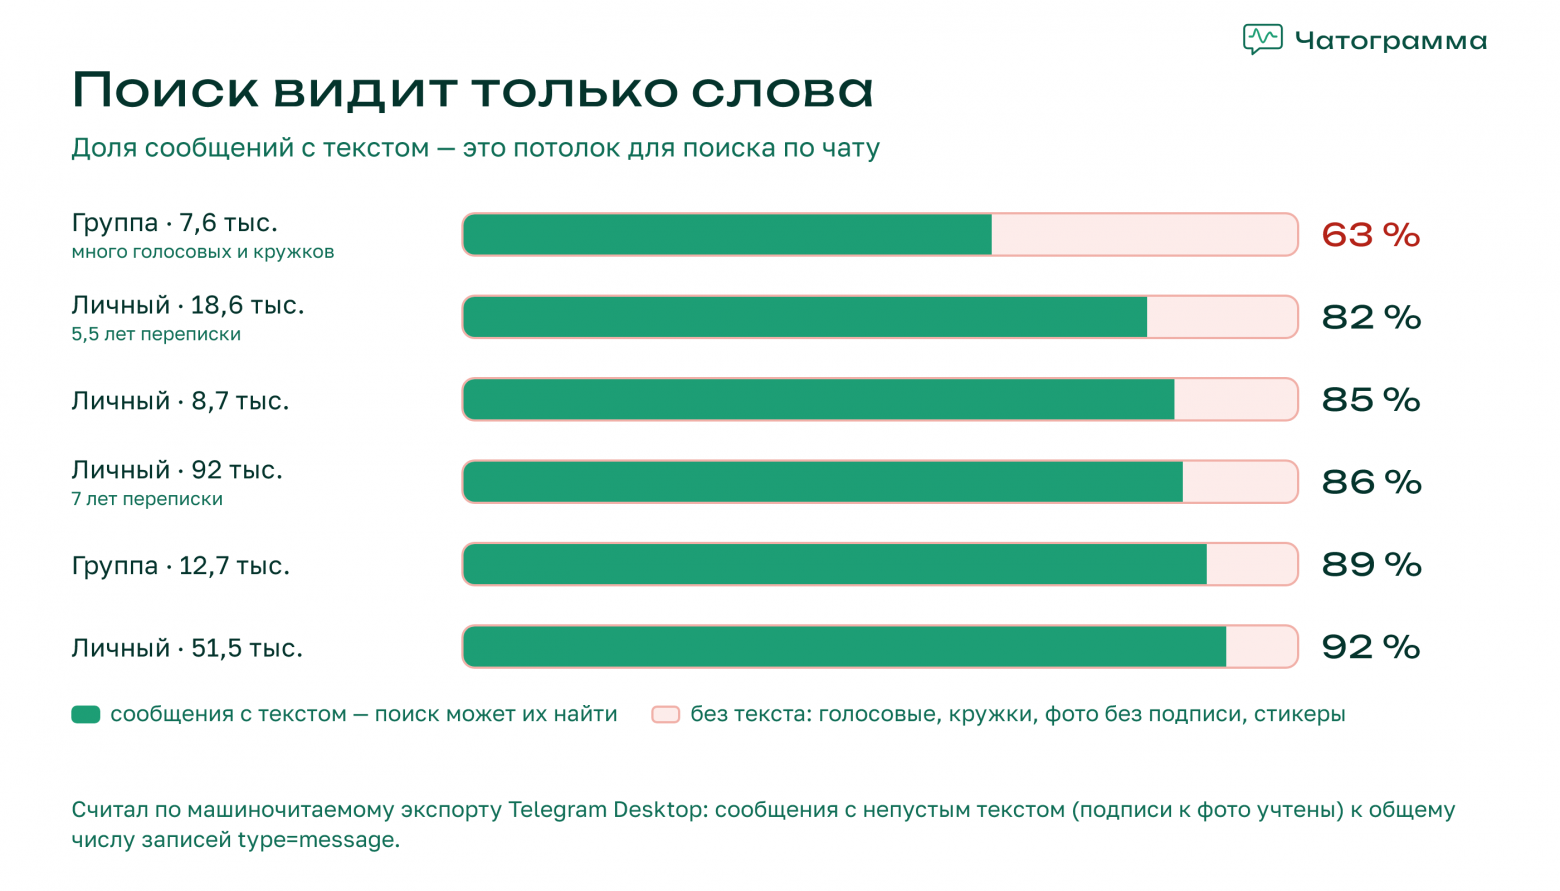
В личных чатах потолок от 82 до 95%. А в группе на 7,6 тысячи только 63%: там почти 1 400 голосовых и 600 кружочков, текста мало. Про совет «поищи точку» отдельно: в моём самом активном чате она есть примерно в 5% сообщений. Если поиск вообще принимает такой запрос (я не проверял), он найдёт двадцатую часть переписки. Да и кто в наше время ставит точки?
Номер сообщения
Идея простая и понятная: сообщения нумеруются по порядку, значит, номер последнего и есть количество. Вот это я проверял с особым интересом, потому что звучит очень правдоподобно. Но оказалось всё не так радужно.
В экспорте у каждого сообщения есть поле id. Я взял разницу между самым большим и самым маленьким номером и поделил на настоящее число сообщений.
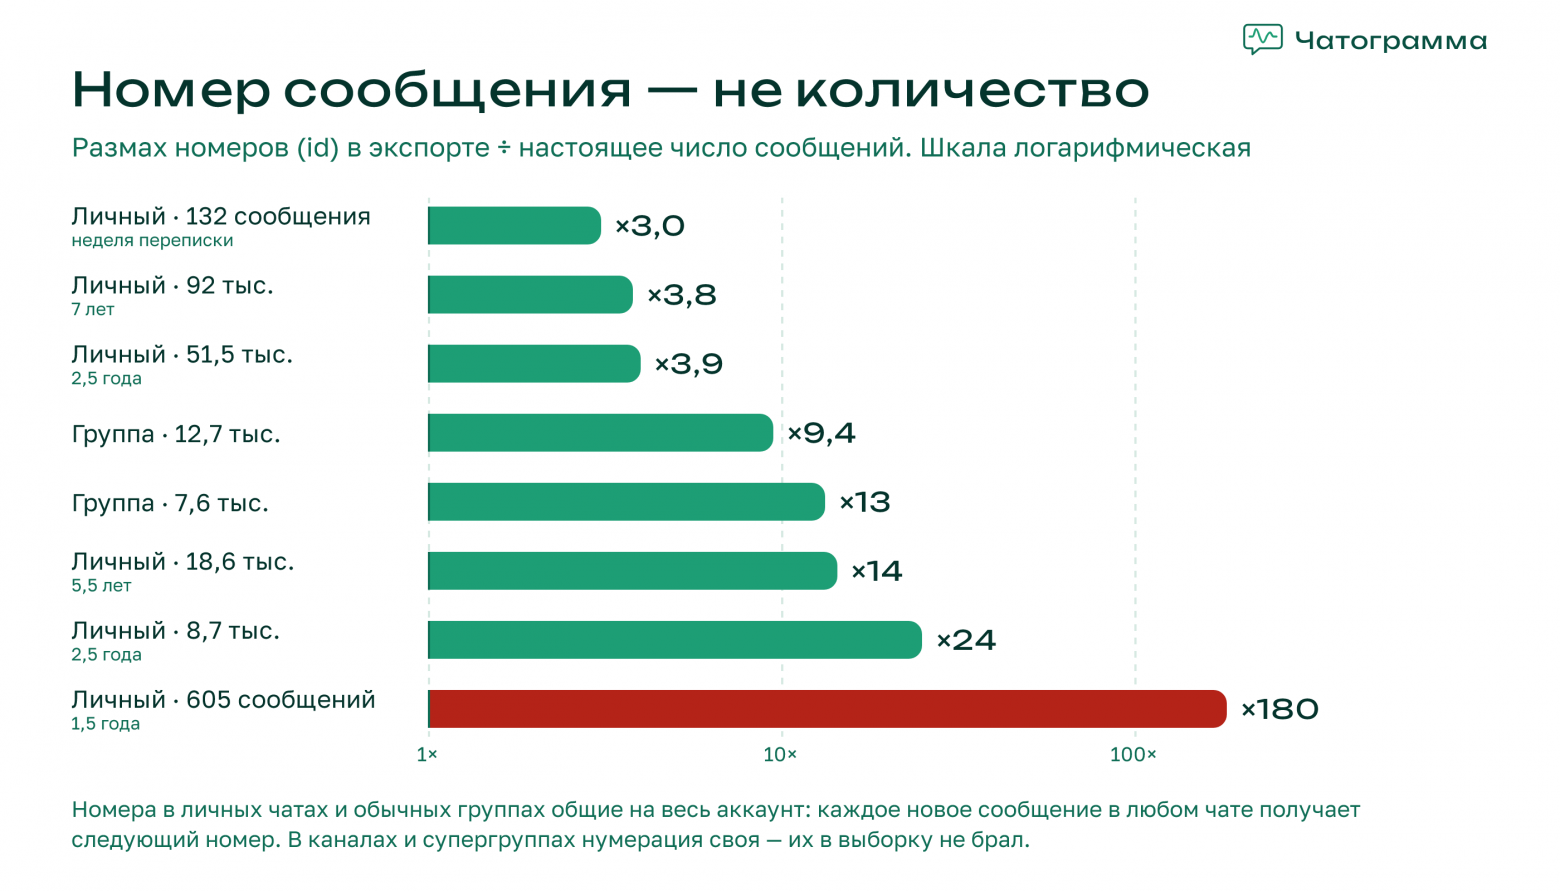
В чате на 51 тысячу номеров почти в четыре раза больше, чем сообщений. В чате на 605 сообщений в 180 раз. Я удивился такой разнице и первым делом решил, что тут где‑то баг.
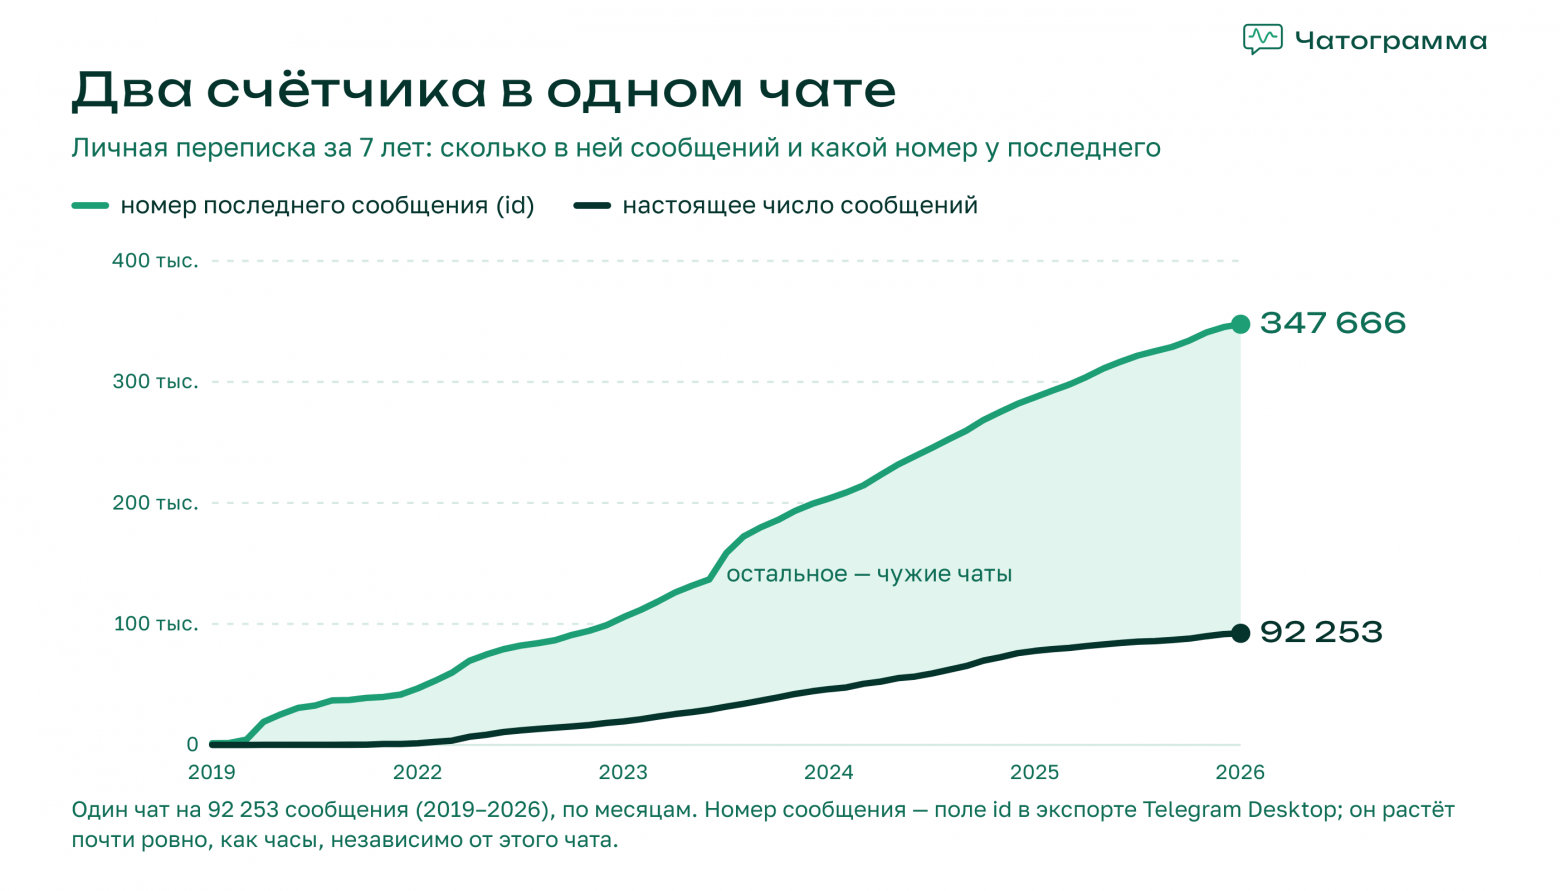
Причина в том, что у личных чатов и обычных групп счётчик общий на весь аккаунт. Каждое новое сообщение в любом из моих чатов, от кого угодно, получает следующий номер. В самом большом чате из 346 тысяч подряд идущих номеров занято только 92 тысячи, каждый четвёртый. Остальные достались другим людям. Получается, что id работает как часы: растёт почти ровно, примерно по 6 тысяч в месяц, то есть сотни сообщений в день проходят через аккаунт, которых я даже не вижу. То есть такой способ оказался самым неэффективным.
В каналах и публичных супергруппах нумерация своя, там совет, скорее всего, работает. У меня таких в выборке не было, так что не проверял.
Экспорт: grep, Python и один неприятный сюрприз
Telegram Desktop умеет выгружать чат в JSON (⋮ → «Экспорт истории чата», фото и видео можно не отмечать). В файле каждое сообщение отдельная запись с полем type. Сообщения там message, а звонки и закрепы service. Если просто взять len(data["messages"]), получится на 0,1–0,2% больше настоящего. Ерунда, но неприятно, когда цифра «почти».
Правильно так:
import json

with open("result.json", encoding="utf-8") as f:
    data = json.load(f)

messages = [m for m in data["messages"] if m["type"] == "message"]
print(len(messages))
На файле в 23 МБ (51 тысяча сообщений) подсчет занимает 0,27 секунды, на 43 МБ чуть больше полсекунды. А если питона под рукой нет, пригодится грубый, но рабочий трюк. Экспорт пишется с отступами, и строка "type": "message" встречается ровно один раз на сообщение:
grep -c '"type": "message"' result.json
В PowerShell то же самое делает (Select-String -Path result.json -Pattern '"type": "message"' -SimpleMatch).Count. На всех восьми файлах grep совпал с питоном до единицы. Конечно, это завязано на форматирование экспорта, и если Telegram его поменяет, всё сломается. Но для одной цифры, наверное, сойдёт.
Теперь про сюрприз. Когда я полез считать что‑то про сами тексты, оказалось, что поле text бывает двух видов. Обычно это строка, но если в сообщении есть ссылка, жирный или упоминание, это список кусков вроде ["Привет, ", {"type": "link", "text": "…"}]. У меня таких около 3%. Наивный len(m["text"]) для них считает куски, а .lower() просто падает. Ещё одно сообщение из 92 тысяч вообще пришло без поля text. Поэтому у меня теперь такая функция:
def text_of(m):
    t = m.get("text", "")
    if isinstance(t, str):
        return t
    return "".join(p if isinstance(p, str) else p["text"] for p in t)
API
Можно вообще не выгружать файл. Сервер Telegram число знает, интерфейс его просто не показывает: в ответе messages.getHistory есть поле count. В Telethon это выглядит так:
from telethon.sync import TelegramClient

with TelegramClient("session", API_ID, API_HASH) as client:
    chat = client.get_entity("username")
    print(client.get_messages(chat, limit=0).total)
api_id и api_hash берутся на my.telegram.org, а файл сессии даёт доступ к аккаунту целиком, так что хранить его надо как пароль и после замера удалять. Я проверил на чате, в котором с лета 2 025 ничего не менялось: в экспорте 18 640 сообщений и ещё 37 служебных записей. API ответил 18 677. То есть count считает всё, что лежит в истории, звонки и закрепы тоже. Чистое число получается вычитанием, и вот тут я немного удивился: ждал, что оно будет точнее экспорта, а оно ровно такое же, как «просто длина списка».
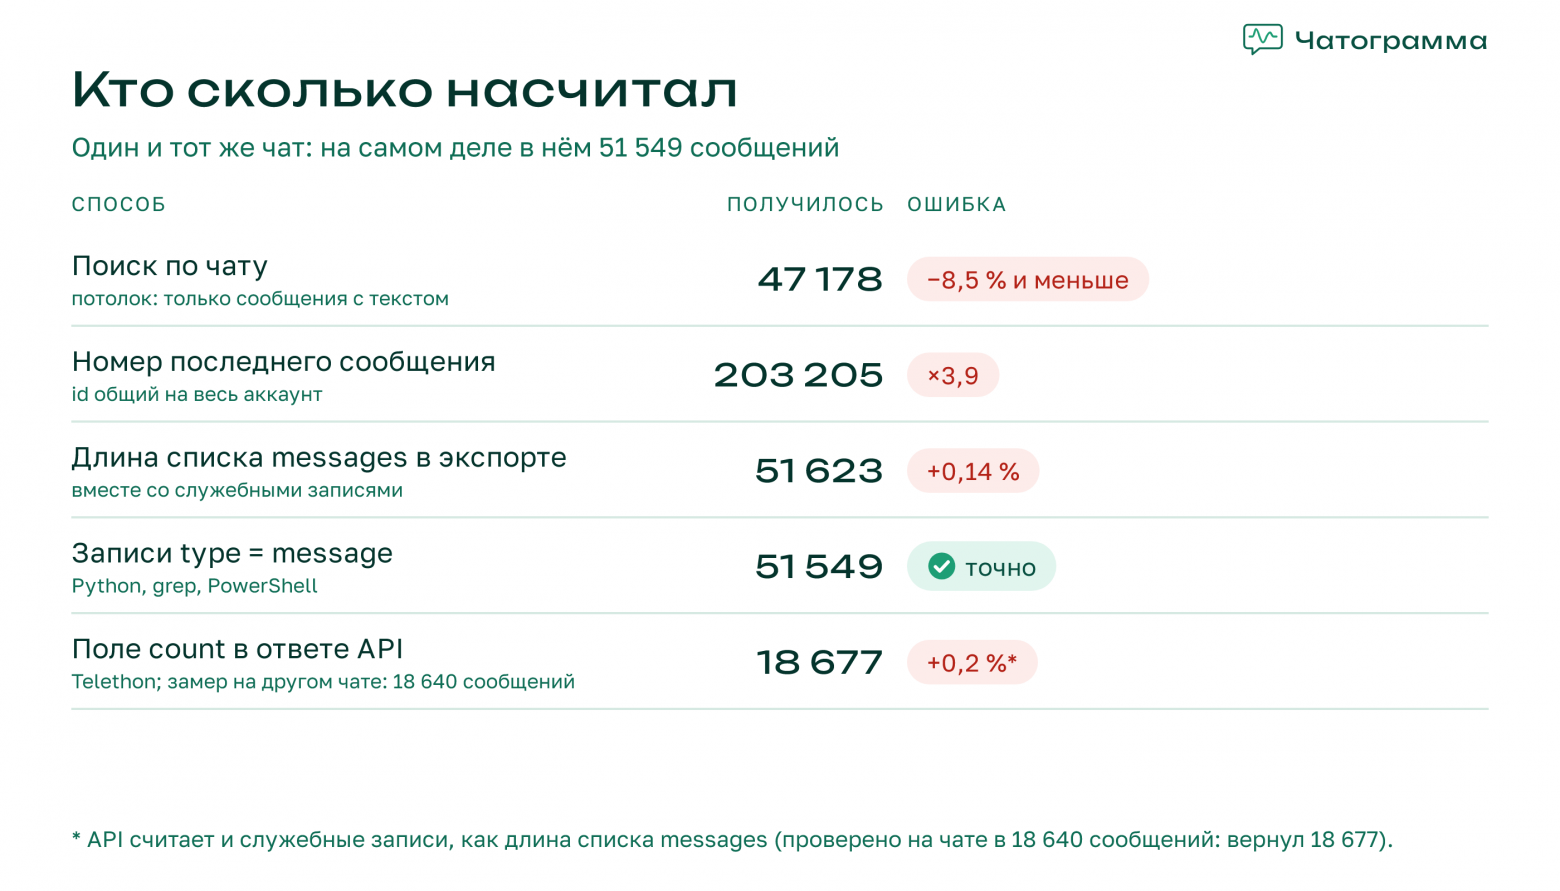
Итоговая раскладка для чата на 51 549 сообщений (по API замер на другом чате):
Способ | Что вышло | Ошибка |
|---|---|---|
Поиск, потолок по тексту | не больше 47 178 | −8,5% и ниже |
Номер последнего сообщения | 203 205 | ×3,9 |
Длина списка в экспорте | 51 623 | +0,14% |
Записи | 51 549 | 0 |
API | 18 677 при 18 640 | +0,2% со служебными |
Что считать сообщением, остаётся вопросом отдельным. Правка не создаёт нового, пересланное считается, удалённое у обоих пропадает совсем. В моём чате на 51 тысячу 4% пересланных и 14% отредактированных, так что даже «точное» число зависит от того, что вы под этим понимаете.
Так что ответ на мой исходный вопрос: на двоих с женой мы написали больше 50 тысяч сообщений, и мне было интересно это узнать. По месяцам заодно стало видно, когда жена перешла на удалёнку: переписка резко просела. До января 2 026 выходило в среднем около 1 900 сообщений в месяц, после неё около 800, а в самом январе вообще 412.
Потом захотелось узнать, кто из нас больше пишет в чате с другом. Но это уже совсем другая история.
Дальше хочу написать про то, чем форматы экспорта Telegram, ВКонтакте и WhatsApp отличаются друг от друга, там тоже хватает сюрпризов. Напишу в следующей статье.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.