[Перевод] Изоляция ИИ-агента: измеряем накладные расходы gVisor и Kata по сравнению с Docker
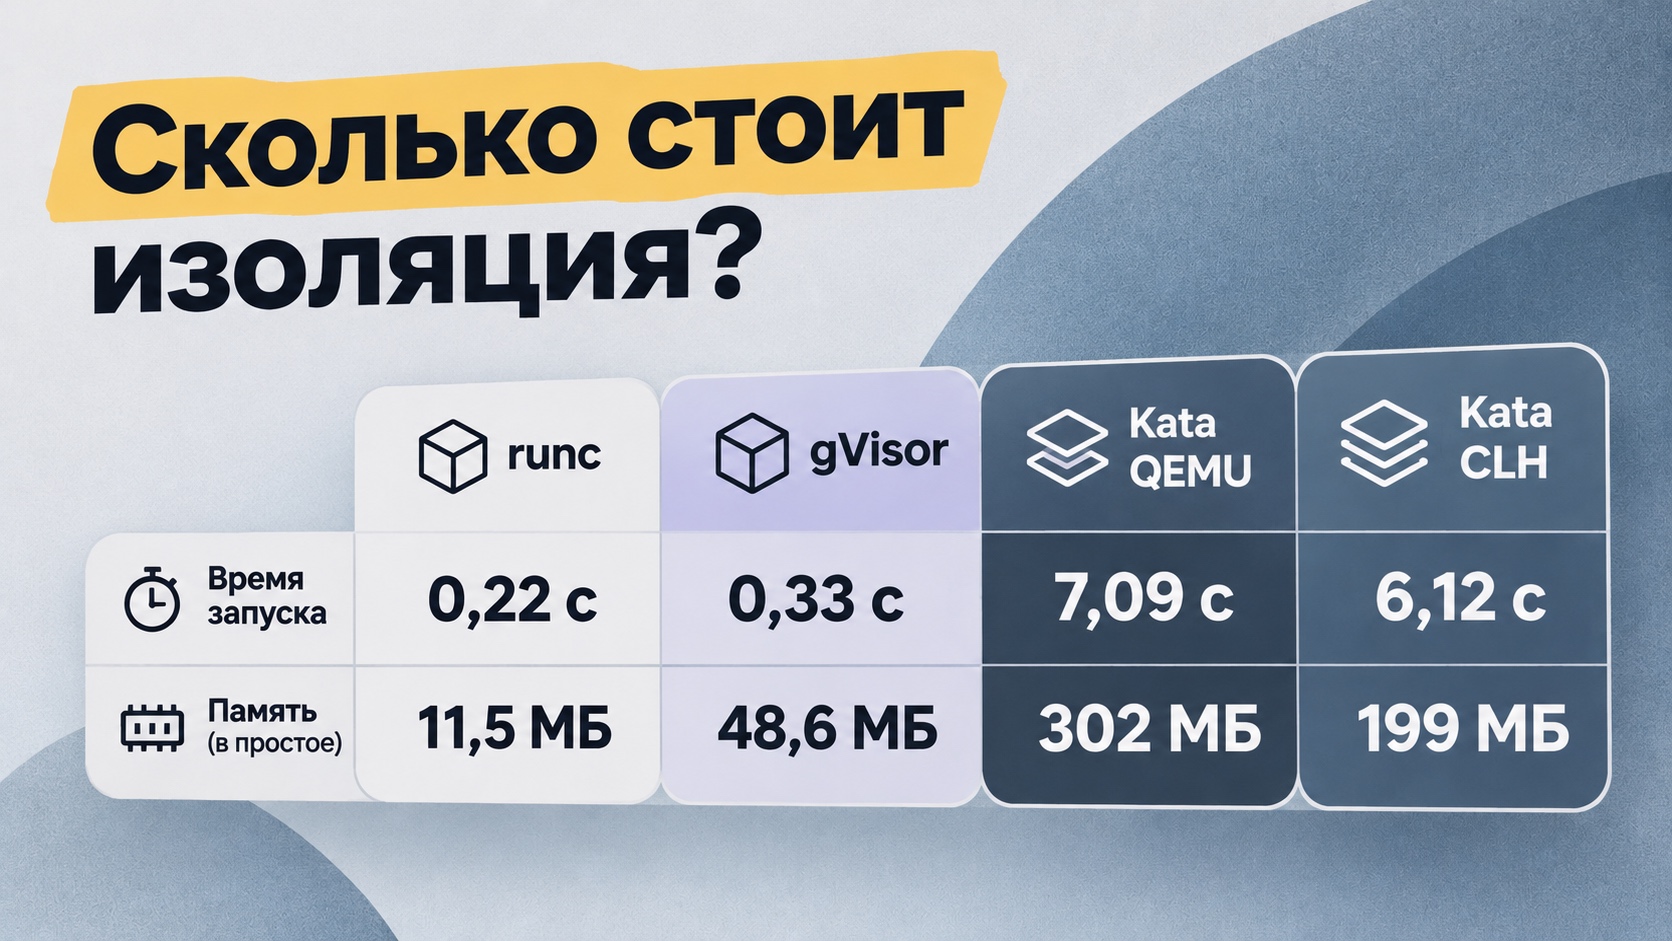
Я решил измерить, во что обходится запуск задач ИИ-агента для программирования в изолированных средах gVisor и Kata Containers 4.3 (с QEMU и Cloud Hypervisor) по сравнению с обычным Docker-контейнером. Kata запускает контейнер за 6–7 секунд против 0,22 секунды у runc, а потребление памяти в простое составляет 199–302 МиБ на контейнер против 11,5 МиБ. gVisor запускается за 0,33 секунды, потребляет 48,6 МиБ памяти и показывает сопоставимые с runc результаты на тестовой нагрузке с тысячами мелких файлов.
Я разрешаю ИИ-агентам для программирования выполнять команды на своих машинах. И чаще всего, когда речь заходит о безопасности такого подхода, люди опасаются одного: агент может что-нибудь сломать за пределами своей рабочей папки.
Обычное решение – усилить изоляцию. Вместо простого Docker-контейнера можно использовать песочницу вроде gVisor, которая ставит между агентом и ядром хоста собственное ядро, работающее в пространстве пользователя. Или Kata Containers, где каждый контейнер запускается в легковесной виртуальной машине с собственным ядром. Мне захотелось выяснить, каких накладных расходов по времени и памяти потребует такая изоляция при выполнении задач агента, если тестировать всё на одной машине с одинаковыми ограничениями.
Я не проверял, можно ли выйти за пределы этих песочниц. Это тема для отдельного исследования. Здесь меня интересовала только цена дополнительной защиты.
В ролике ядро хоста представлено как платформа с четырьмя отсеками, по одному на каждую песочницу. Каждый отсек показывает контейнер таким, каким его видит хост. Потребление памяти в простое – от 11,5 до 302 МиБ, сравнение скорости запуска в реальном времени (0,22 секунды у runc против 7,09 секунды у Kata с QEMU) и тест с 5000 мелких файлов, в котором gVisor показывает сопоставимый результат с runc.
Что я измерял и по каким правилам
Ещё до первого запуска я составил документ, в котором сформулировал исследовательский вопрос, три гипотезы и критерии оценки результатов. Впоследствии я четыре раза вносил изменения в протокол эксперимента, каждый раз письменно объясняя причину.
Машина: ноутбук Lenovo с Intel Core i5-8250U (4 ядра, 8 потоков), 11 ГиБ оперативной памяти и SATA SSD. Операционная система – NixOS с ядром Linux 6.18 и KVM.
Варианты эксперимента: Docker 29.8 со стандартным рантаймом runc 1.5.1 (базовый вариант для сравнения). gVisor (runsc 20260406.0, сборка из nixpkgs) с платформой по умолчанию. Kata Containers 4.3.0 с официальными статическими бинарниками и конфигурацией по умолчанию, использующей QEMU 11.0. А также, после изменения протокола эксперимента, о котором расскажу ниже, та же Kata с официальной конфигурацией для Cloud Hypervisor v54.
Ограничения: для каждого контейнера заданы
--cpus 2 --memory 2g --network none.Тестовые нагрузки: пять сценариев, в каждом из которых использовался один и тот же образ для всех четырёх вариантов:
Запуск:
docker run --rmс минимальным образом, выполняющим командуtrue. Время измерялось на хосте. По 30 запусков для каждого варианта.Память: запуск контейнера в простое (
sleep 300). Через 10 секунд измерялась суммарная пропорциональная доля резидентной памяти (Proportional Set Size, PSS) его процессов на хосте. По 10 запусков.Повторное выполнение команд агента: команды, которые реальные агенты выполняли в другом моём, пока не опубликованном эксперименте, последовательно запускались внутри нового контейнера. По 10 запусков.
Компиляция: полная сборка Lua 5.4.7 с помощью
make, затемmake clean. По 10 запусков.Множество мелких файлов: создание виртуального окружения Python, установка JupyterLab из локального индекса пакетов без доступа к сети и распаковка дерева из 5000 файлов. По 10 запусков.
Критерии оценки: для каждого варианта рассчитывались медиана и отношение результата к runc с 95%-м доверительным интервалом, рассчитанным методом бутстрэпа (10 000 повторных выборок, начальное значение генератора случайных чисел – 17). Результат считался «медленнее», если доверительный интервал не включал 1, а отношение превышало 1,10. Результаты признавались сопоставимыми только в том случае, если весь доверительный интервал находился в диапазоне от 0,95 до 1,05.
Запуск: Kata требуются секунды
Время выполнения docker run --rm true в реальном времени (медиана по 30 запускам)
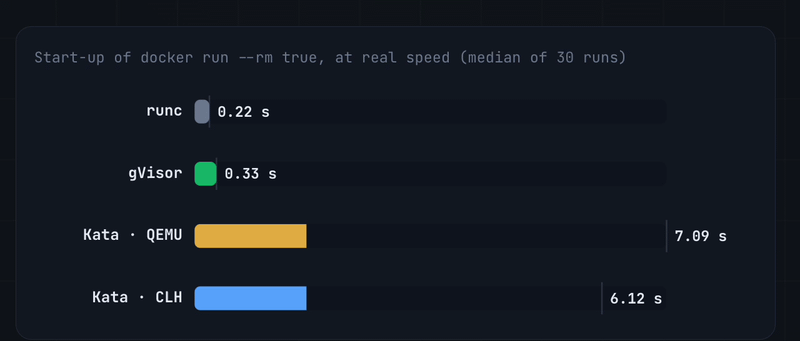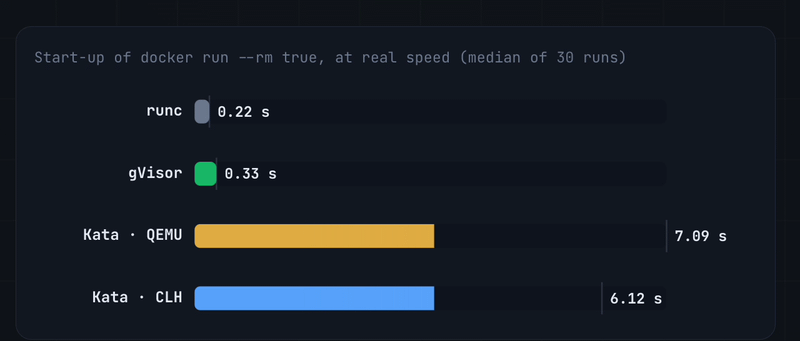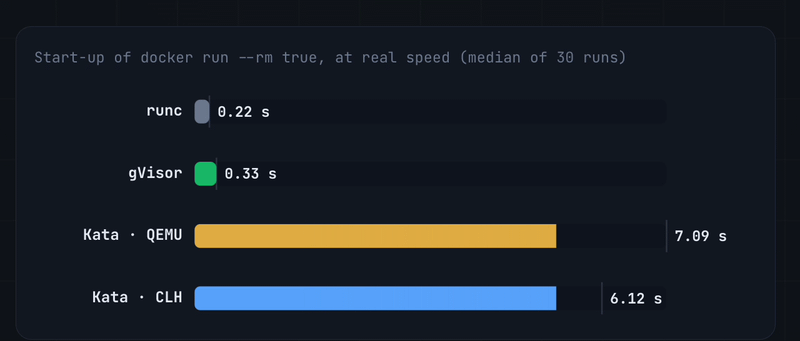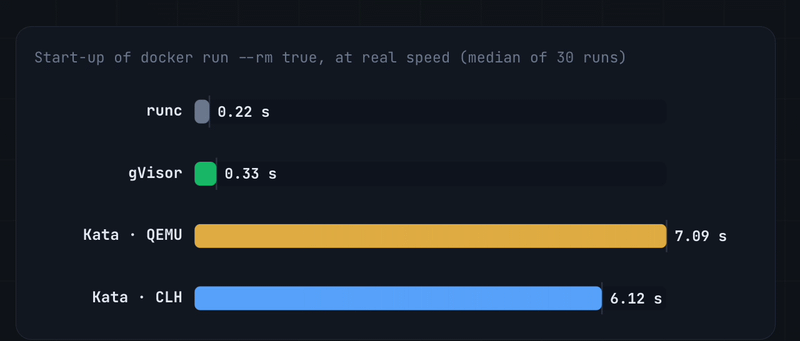
У runc запуск и завершение контейнера заняли 0,22 секунды, у gVisor – 0,33 секунды, то есть в 1,48 раза дольше. Kata с QEMU потребовалось 7,09 секунды (в 31,7 раза дольше, чем runc), а с Cloud Hypervisor – 6,12 секунды (в 27,3 раза дольше). Первая гипотеза о том, что запуск Kata будет занимать как минимум втрое больше времени, подтвердилась с огромным запасом.
Именно эти семь секунд у QEMU стали причиной первого изменения протокола эксперимента. Те, кто всерьёз использует Kata, обычно переходят на другие гипервизоры, поэтому я добавил вариант с Cloud Hypervisor. Тесты запуска и компиляции для него проводились уже после остальных трёх вариантов, без чередования. В остальных тестовых сценариях запуски разных вариантов чередовались.
Полная таблица результатов
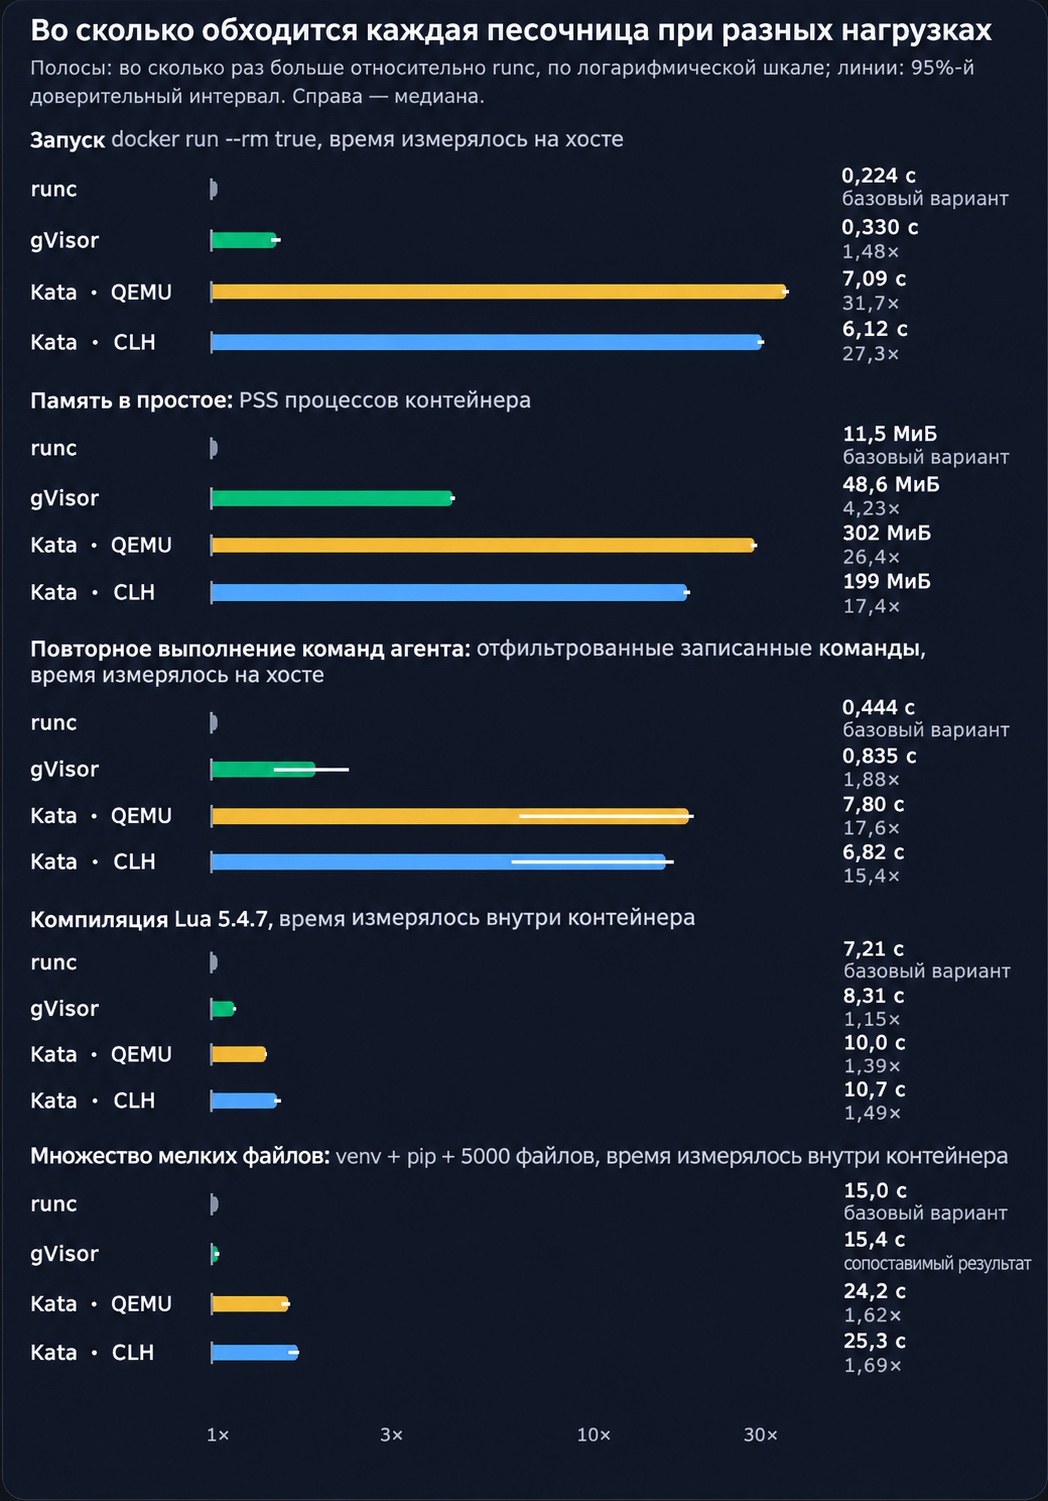
Тестовая нагрузка (медиана) | runc | gVisor | Kata · QEMU | Kata · CLH |
|---|---|---|---|---|
Запуск ( | 0,224 с | 0,330 с (1,48×) | 7,09 с (31,7×) | 6,12 с (27,3×) |
Память в простое (PSS) | 11,5 МиБ | 48,6 МиБ (4,2×) | 302 МиБ (26,4×) | 199 МиБ (17,4×) |
Повторное выполнение команд агента | 0,444 с | 0,835 с (1,88×) | 7,80 с (17,6×) | 6,82 с (15,4×) |
Компиляция, время внутри контейнера | 7,21 с | 8,31 с (1,15×) | 10,04 с (1,39×) | 10,70 с (1,48×) |
Мелкие файлы, время внутри контейнера | 14,98 с | 15,44 с (сопоставимый результат) | 24,21 с (1,62×) | 25,34 с (1,69×) |
По установленным критериям все результаты относительно runc попали в категории «медленнее» или «больше потребление памяти», кроме одного: в тесте с мелкими файлами gVisor показал сопоставимый результат при измерении времени внутри контейнера. Отношение составило 1,03, а доверительный интервал – от 0,97 до 1,03.
Память: что хост видит у каждого контейнера
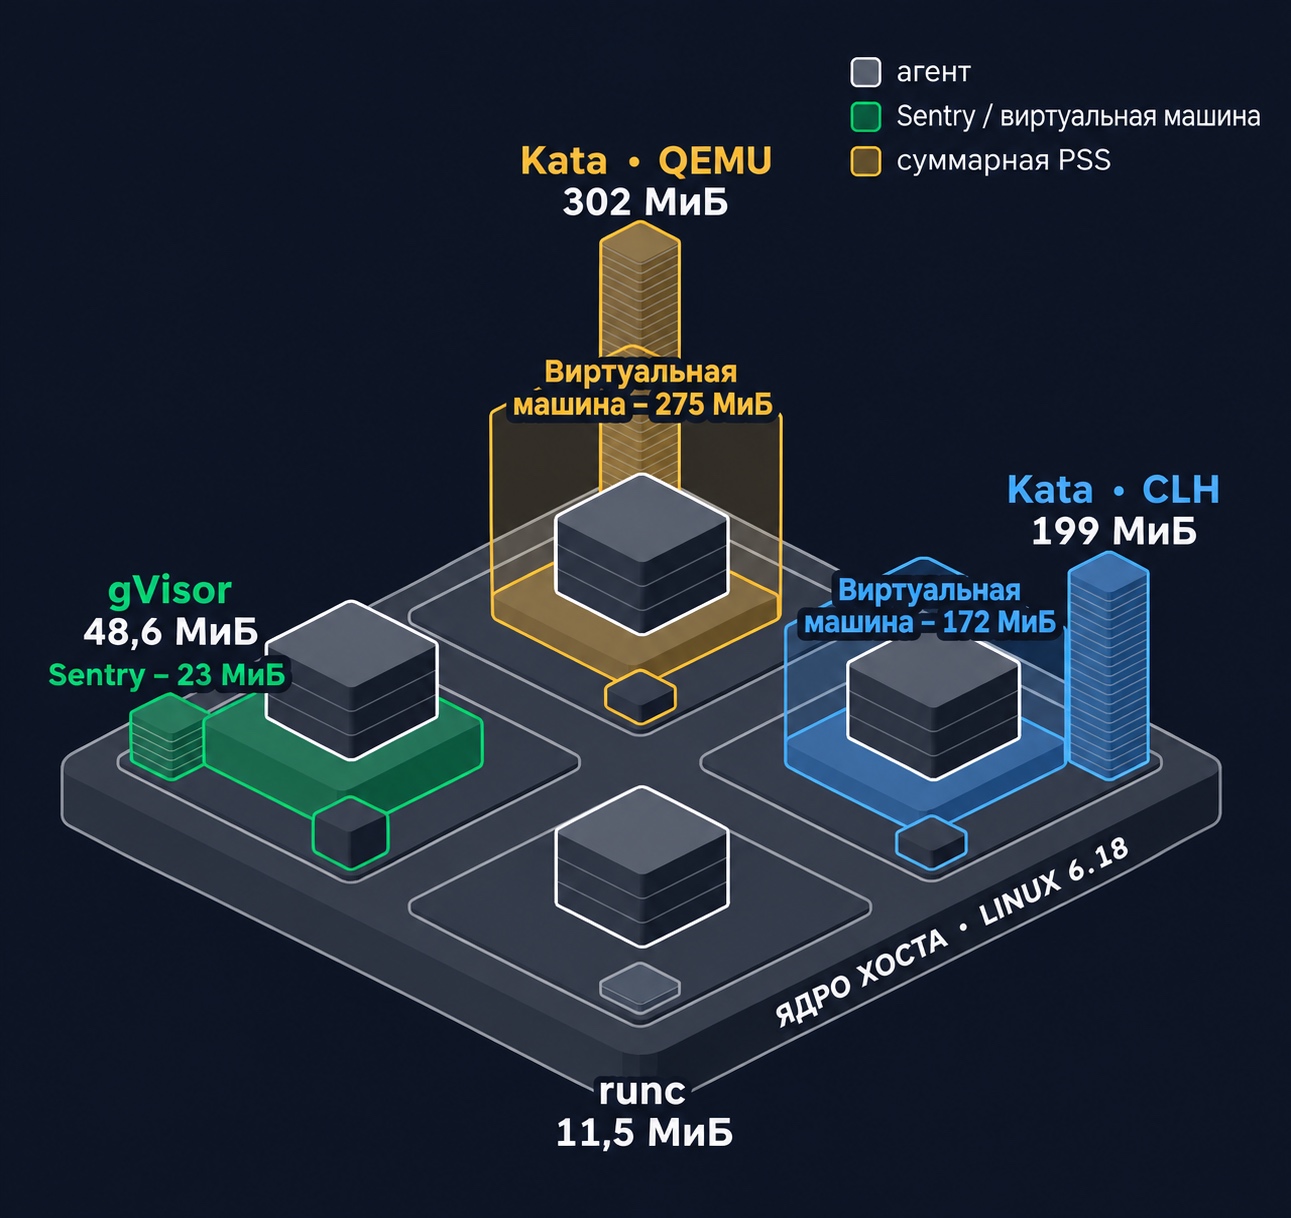
В случае с runc хост видит процесс контейнера и shim-процесс containerd. В сумме они занимают 11,5 МиБ. gVisor добавляет два собственных процесса: sandbox (ядро в пространстве пользователя, 22,5 МиБ) и Gofer, который обслуживает файловые операции (13,9 МиБ). В итоге получается 48,6 МиБ. У Kata основная часть памяти приходится на виртуальную машину: один только процесс QEMU занимает 275 МиБ, а Cloud Hypervisor – 172 МиБ. К этому добавляются shim-процесс Kata (24 МиБ) и два процесса virtiofsd.
На схеме показана измеренная PSS процессов, которые моя тестовая обвязка отнесла к каждому контейнеру. Это процессы из его cgroup, потомки его init-процесса и вспомогательные процессы рантайма, в командной строке которых указан этот контейнер. Для каждого процесса я сохранял полную командную строку и причину, по которой включил его в расчёт. Это не полный объём памяти, который расходует машина: здесь не учитываются ядро хоста и кеши.
Повторное выполнение команд агента
Этот тестовый сценарий оказалось сложнее всего реализовать корректно, и его результаты требуют особенно внимательной интерпретации. Я взял логи команд из шести запусков агентов в другом эксперименте, сохранил их побайтно и последовательно воспроизвёл в новом контейнере, в Git-репозитории с начальным коммитом, как и в оригинале. Тестовая обвязка исключает команды, которые затрагивают собственную конфигурацию агента, поэтому часть реальных действий в тест не попала (например, запуски pytest в одной из сессий). Некоторые команды завершаются с ошибкой, как и в исходной сессии. Запуск засчитывается только в том случае, если каждый шаг возвращает тот же код завершения, что и в runc. Все 40 запусков прошли эту проверку.
Поэтому я не рассматриваю эти результаты как оценку накладных расходов полноценной рабочей сессии агента. Они показывают лишь стоимость повторного выполнения отфильтрованного набора его команд. В этом тесте gVisor потребовалось в 1,88 раза больше времени, чем runc, а Kata – в 15–18 раз больше. Причина в том, что сама работа контейнера занимает меньше секунды, а запуск виртуальной машины съедает практически всё остальное время. Согласно второй гипотезе, gVisor и Kata должны были укладываться менее чем в 1,5 времени runc. В этом тесте гипотеза не подтвердилась, но и сам тест не совсем соответствует той рабочей сессии, которую я имел в виду при её формулировке.
Компиляция и работа с файлами: измерения внутри контейнера
Если измерять время на хосте, в результат попадает и запуск контейнера. Для Kata это дополнительные 6–7 секунд. Поэтому во втором изменении протокола эксперимента я добавил измерение времени непосредственно внутри контейнера, чтобы учитывать только выполнение самой задачи. При таком подходе компиляция Lua в gVisor занимала в 1,15 раза больше времени, чем в runc, в Kata с QEMU – в 1,39 раза, а с Cloud Hypervisor – в 1,48 раза. Если измерять время на хосте, показатели Kata вырастают до 2,27 и 2,15 соответственно.
Настоящим сюрпризом оказался тест с мелкими файлами. Согласно третьей гипотезе, именно операции с большим количеством мелких файлов должны были давать максимальные накладные расходы в gVisor. Но получилось иначе: при измерении времени внутри контейнера gVisor показал сопоставимый с runc результат. А вот Kata потребовалось в 1,6–1,7 раза больше времени. Для gVisor самыми затратными оказались повторное выполнение коротких команд и запуск контейнера, а не работа с файловой системой. При измерении времени на хосте результаты gVisor в тесте с файлами не позволили сделать однозначный вывод: отношение составило 0,98, но доверительный интервал находился в диапазоне от 0,72 до 0,99.
Что пришлось изменить по ходу эксперимента
Базовый вариант без контейнера: изначально протокол предусматривал запуск тестовых нагрузок прямо на хосте, чтобы определить нижнюю границу времени выполнения. Но на NixOS такое сравнение оказалось некорректным: на хосте не было инструментов из Debian-образов, при воспроизведении сессии возникали ошибки из-за путей, а для компиляции использовался другой GCC. В третьем изменении протокола я исключил этот вариант и оставил runc в качестве базового для сравнения.
Три тестовых сценария пришлось переделать: внешняя проверка выявила проблемы в первых версиях трёх тестов. При повторном выполнении команд агента ошибки оставались незамеченными: репозиторий не был Git-репозиторием, а некоторые команды неправильно экранировались при повторном запуске. В тесте с мелкими файлами могли возникать ошибки, которые тестовая обвязка не обнаруживала. А в тесте памяти были ошибки при отборе процессов. В четвёртом изменении протокола я исправил все три сценария и полностью провёл тесты заново, чередуя запуски всех четырёх вариантов. После повторной проверки потребовалось ещё кое-что доработать: ошибки при поиске процессов не должны были теряться, а для каждого учтённого процесса нужно было указывать причину его включения в расчёт. Я ещё раз провёл измерения памяти и получил те же результаты.
Зависания Kata: при первом повторном прогоне некоторые команды в Kata зависали в ожидании данных из стандартного ввода и так и не завершались. Теперь каждый шаг выполняется с закрытым стандартным вводом и ограничением по времени в 120 секунд.
Факторы, ограничивающие достоверность выводов (Threats to validity)
Все тесты проводились на одной машине – ноутбуке с SATA SSD. Абсолютные значения нельзя напрямую переносить на серверы. Гораздо важнее соотношение результатов разных вариантов.
У каждой технологии есть несколько вариантов конфигурации, а я тестировал настройки по умолчанию (плюс Cloud Hypervisor). У gVisor есть другие платформы, а Kata позволяет настраивать память и CPU виртуальной машины или использовать шаблоны для ускорения запуска. Эти возможности я не проверял.
Одинаковые ограничения не означают, что контейнерам доступны одинаковые ресурсы. Внутри контейнера команда
nprocпоказывает 8 для runc, 2 для gVisor и 3 для Kata.Тесты запуска и компиляции с Cloud Hypervisor проводились без чередования с остальными вариантами.
При повторном выполнении команд агента использовался отфильтрованный набор команд без обращений к модели: шесть сессий, распределённых по десяти повторениям.
Потребление памяти оценивалось по PSS выбранных процессов, а не по общему расходу памяти на хосте.
Я не фиксировал состояние дискового кеша и дайджест образа для каждого замера.
Я не измерял уровень безопасности и не пытался выйти за пределы какой-либо из песочниц.
Вывод
Если агент запускает отдельный контейнер для каждой команды, Kata в текущем виде для такого сценария не годится: каждый запуск занимает 6–7 секунд, а контейнер потребляет 200–300 МиБ памяти. Если же агент часами работает в одном контейнере, время запуска становится разовой затратой. Тогда остаются накладные расходы на выполнение задач – в 1,4–1,7 раза больше времени по сравнению с Docker, зато контейнер получает собственное ядро.
gVisor оказывается компромиссным вариантом с небольшими накладными расходами: запуск за треть секунды, около 50 МиБ памяти, компиляция на 15% медленнее и отсутствие заметной разницы при работе с большим количеством мелких файлов.
Обычный Docker по-прежнему быстрее всех. Но из этих трёх вариантов только в нём агент использует общее с хостом ядро.
Часто задаваемые вопросы
Насколько медленнее запускается контейнер в Kata по сравнению с обычным Docker?
На моей машине выполнение docker run --rm с командой true заняло 0,22 секунды с runc, 7,09 секунды с Kata 4.3 и QEMU (в 31,7 раза дольше) и 6,12 секунды с Kata и Cloud Hypervisor (в 27,3 раза дольше). gVisor справился за 0,33 секунды, что в 1,48 раза дольше, чем runc. Это медианные значения по 30 запускам для каждого варианта.
Сколько памяти потребляют gVisor и Kata на один контейнер?
Для контейнера в простое суммарная PSS связанных с ним процессов составила 11,5 МиБ с runc, 48,6 МиБ с gVisor, 302 МиБ с Kata и QEMU и 199 МиБ с Kata и Cloud Hypervisor. В случае Kata почти вся память приходится на процесс гипервизора: 275 МиБ у QEMU и 172 МиБ у Cloud Hypervisor. Это измеренное потребление памяти конкретными процессами, а не общий объём памяти, который расходует машина.
Правда ли, что gVisor медленно работает с большим количеством мелких файлов?
В моём тесте – нет. Создание виртуального окружения Python, установка JupyterLab из локального индекса пакетов и распаковка 5000 файлов заняли 14,98 секунды с runc и 15,44 секунды с gVisor. Время измерялось внутри контейнера, а результаты оказались сопоставимыми по критериям, которые я установил ещё до начала эксперимента. Kata потребовалось 24,2 секунды с QEMU и 25,3 секунды с Cloud Hypervisor.
Cloud Hypervisor лучше QEMU для Kata?
С Cloud Hypervisor контейнер запускается быстрее (6,12 против 7,09 секунды) и потребляет меньше памяти (199 против 302 МиБ). Однако задачи внутри контейнера выполнялись немного медленнее: компиляция Lua заняла 10,70 секунды против 10,04 секунды, а тест с мелкими файлами – 25,3 секунды против 24,2 секунды. При этом тесты запуска и компиляции с Cloud Hypervisor проводились после остальных вариантов, без чередования запусков.
Проверялось ли, может ли агент выйти за пределы песочницы?
Нет. Я измерял только накладные расходы на изоляцию: время выполнения и потребление памяти. Я не пытался выйти за пределы песочниц и не оценивал защищённость каждой технологии.
Можно ли воспроизвести эксперимент?
Да. Документ с гипотезами и критериями оценки, составленный до начала измерений, все четыре изменения протокола эксперимента, тестовая обвязка, анализ и исходные данные доступны в репозитории и Gist, ссылки на которые приведены в источниках.
Выбор среды для ИИ-агента не заканчивается сравнением скорости запуска контейнеров и потребления памяти. Нужно ещё разобраться, как контейнерные runtime работают в инфраструктуре и как организовать работу самого агента над проектом. Обе темы будут разбираться на бесплатных вебинарах:
10 ноября в 20:00. «CRI — обзор контейнерных runtime»
-> Разберём взаимодействие Kubernetes с containerd, CRI-O и Kata Containers, а также влияние выбора runtime на производительность и безопасность. Записаться1 декабря в 20:00. «ИИ-агенты: настраиваем среду и организуем работу над проектом» ---> Рассмотрим настройку Cursor, Codex и Claude Code, работу с инструкциями, Skills и Hooks, сохранение контекста между сессиями. Записаться
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.