Как я научил React Native читать кириллицу на Android: OCR на Vision и PaddleOCR
Я сделал react-native-glyph-ocr: библиотеку распознавания текста на устройстве для React Native. На iOS она работает на Apple Vision, на Android — на PaddleOCR. На фото этикеток с русским составом Android-версия читает 77–83% ингредиентов, а ML Kit — 13–28%.
В статье — почему не ML Kit, как выбирал движки, как устроены API и сканер камеры, что пришлось выбросить по дороге и где библиотека пока слабее, чем хотелось бы. Пакет уже в npm: npm i react-native-glyph-ocr.
Зачем понадобилась своя библиотека
Я делаю приложение, которое читает состав продукта с этикетки и разбирает его по ингредиентам. Этикетки на русском, часто вперемешку с английским, и напечатаны на чём угодно: фольга, мятый пакет, термопечать, текст по дуге банки.
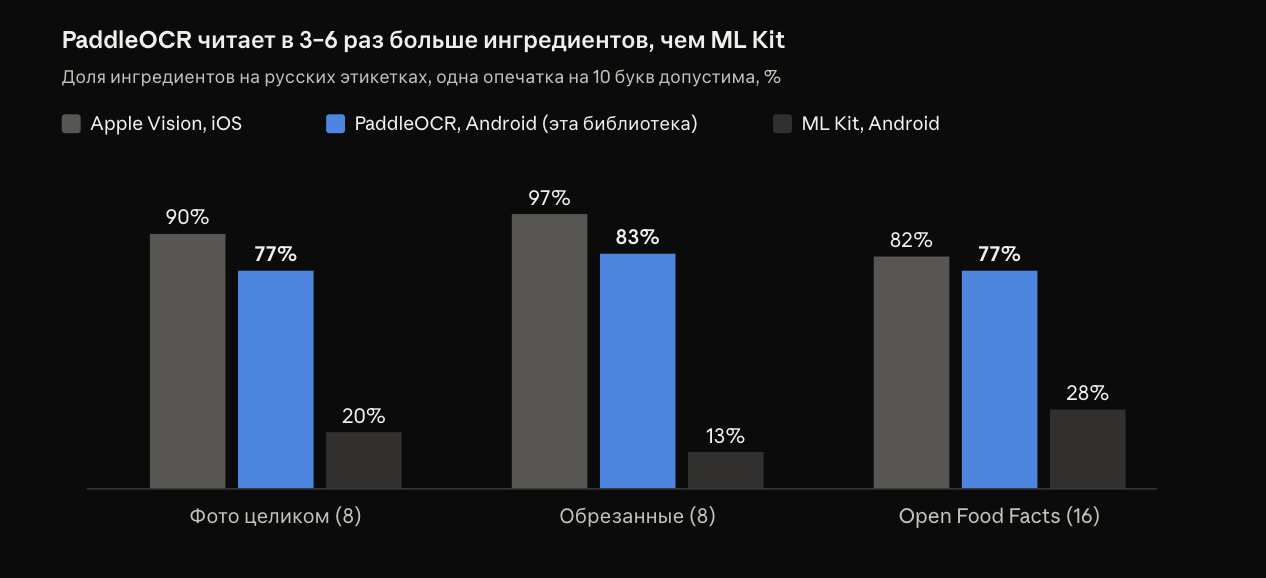
Стандартный выбор в React Native — обёртки над Google ML Kit: @react-native-ml-kit/text-recognition, react-native-vision-camera-ocr-plus и другие. Проблема в том, что у ML Kit Text Recognition v2 нет модели для кириллицы. Он читает русский текст как латиницу, подбирая похожие по написанию буквы, и большинство слов в таком тексте уже не узнать. На моём наборе фото ML Kit прочитал 13–28% ингредиентов.
На iOS проблемы нет: системный Vision с iOS 16 читает русский и украинский. Значит, нужна библиотека с разными движками на двух платформах и одним и тем же результатом для JS.
Два движка: Vision на iOS, PaddleOCR на Android
Перед тем как писать библиотеку, я сделал два спайка на одних и тех же фото и с одним ручным эталоном. На iOS — Apple Vision (VNRecognizeTextRequest, ревизия 3, .accurate, языки ru-RU и en-US). На Android — PaddleOCR PP-OCRv5 mobile на ONNX Runtime с пакетом для восточнославянских языков (eslav: ru, uk, be, en).
Apple Vision, iOS | PaddleOCR, Android | |
|---|---|---|
Ингредиенты: фото целиком / обрезанные / Open Food Facts | 90% / 97% / 82% | 77% / 83% / 77% |
Скорость, обрезанный состав | 0,15 с, iPhone 13 Pro Max | 1,1 с, Pixel 6a |
Что скачать | ничего, Vision в системе | 12,7 МБ моделей один раз |
Нативные библиотеки | нет | ONNX Runtime, 33 МБ на ABI |
Вывод простой: на iOS тащить свою модель нет смысла, Vision точнее и быстрее. На Android я взял PaddleOCR и написал весь конвейер нативно, на Kotlin и C++: есть [ppu-paddle-ocr](https://github.com/PT-Perkasa-Pilar-Utama/ppu-paddle-ocr), но там конвейер на TypeScript поверх ONNX Runtime и Skia, а мне нужны были кадры камеры и результат в форме ML Kit.
Пара наблюдений из спайков:
У Vision уровень
.fastрусского не знает, только.accurate. Ревизия 3 появилась в iOS 16 — это и стало минимумом библиотеки.Вместо ONNX Runtime я пробовал ExecuTorch в собственной минимальной сборке: 1,7 МБ вместо 33 МБ, та же точность, на медленных ядрах Cortex-A55 на 25–30% быстрее. Пока он доступен только в dev-точке входа: сначала хочу замерить его на настоящем бюджетном телефоне.
Vision читает около 30 языков. Для остальных (белорусский, казахский, болгарский, сербский, греческий, хинди…) PaddleOCR можно собрать и на iOS флагом
GlyphOcr_paddleOnIos=1.
У PaddleOCR есть пакеты и для других письменностей: cyrillic (33 языка), latin (48), арабский, деванагари, корейский, тайский, греческий, тамильский, телугу, китайский с японским. Библиотека сама выбирает пакет по списку языков в формате BCP-47: ['ru', 'en'] → eslav.
API: результат в форме ML Kit
Раз большинство приходит с ML Kit, результат устроен так же: блоки → строки → слова. У каждого узла есть текст, уверенность, рамка в долях от 0 до 1 и в пикселях, четыре угловые точки и угол наклона. Все координаты отсчитаны от верхнего левого угла целого исходного изображения после поворота по EXIF, а его размер лежит в result.image.
import { createOcr, recognize } from 'react-native-glyph-ocr';

// Один вызов: экземпляр для этих языков создаётся, готовится и кэшируется
const text = (await recognize('file:///…/label.jpg', { languages: ['ru', 'en'] })).text;

// Экземпляр: языки задаются один раз, от них зависит, какие модели в памяти
const ocr = createOcr({ languages: ['ru', 'en'] }); // Vision на iOS, пакет eslav на Android
await ocr.prepare({ onProgress: p => console.log(p.phase, p.fraction) });
const result = await ocr.recognize(uri, {
  roi: { x: 0.1, y: 0.3, width: 0.8, height: 0.4, unit: 'normalized' },
});
for (const block of result.blocks) {
  for (const line of block.lines) {
    console.log(line.text, line.confidence, line.boundingBox);
  }
}
ocr.dispose();
Что здесь сделано иначе, чем в обёртках над ML Kit:
Язык задаётся при создании экземпляра, а не при каждом вызове. У Paddle от языка зависит, какая модель загружена в память, и переключать её на каждом вызове дорого.
Любой источник: путь,
file://,content://(Android),ph://(iOS), base64,Imageиз react-native-nitro-image, кадр VisionCamera 5. Ссылкиhttp(s)отклоняются намеренно: за картинками библиотека в сеть не ходит, а изображения никуда не отправляет. Из сети она качает только модели.roiобрезает картинку до распознавания, а не фильтрует результат. У Paddle это заметно на скорости: обрезанный состав читается за 1,1 с, этикетка целиком — за 3 с. Координаты в результате всё равно относятся к полному кадру.Типизированные ошибки. Каждый отказ —
OcrErrorс одним из 17 кодов:source-not-found,language-not-supported,checksum-mismatch,cancelledи так далее. Отмена — через обычныйAbortSignal.
Модели Paddle скачиваются по манифесту: у каждого файла есть sha256 и закреплённая ревизия на Hugging Face. Загрузка возобновляется после обрыва, файл проверяется и только потом атомарно перемещается на место. Если не хочется зависеть от Hugging Face, можно указать свой сервер или встроить модели в сборку:
await configureModels({
  baseUrl: 'https://cdn.example.com/ocr-models', // файлы по путям из манифеста
  source: 'embedded-or-remote', // или 'remote', 'embedded'
});
await prepare(['ru', 'en'], { onProgress: p => setProgress(p.fraction) });
В компонентах то же делает хук useOcr: он готовит модели при монтировании и отдаёт status, downloadProgress, error и recognize.
Камера: кадр по указателю и сканер, который ждёт резкости
Для камеры библиотека работает с VisionCamera 5, но нативно с ней не связана. Метод recognizeFrame принимает не объект кадра, а число: frame.getNativeBuffer().pointer. На iOS это CVPixelBufferRef, на Android — AHardwareBuffer*. Буфер читается только во время вызова, освобождает его тот, кто вызвал.
Метод синхронный, это возможно благодаря Nitro Modules. Вызывать его нужно из AsyncRunner внутри worklet, а не прямо из onFrame, иначе секунда распознавания на Android заблокирует поток кадров.
Поверх этого сделан хук useTextScanner. Распознавать каждый кадр на Android дорого, поэтому сканер сначала ждёт хороший кадр в рамке и только потом читает его один раз.
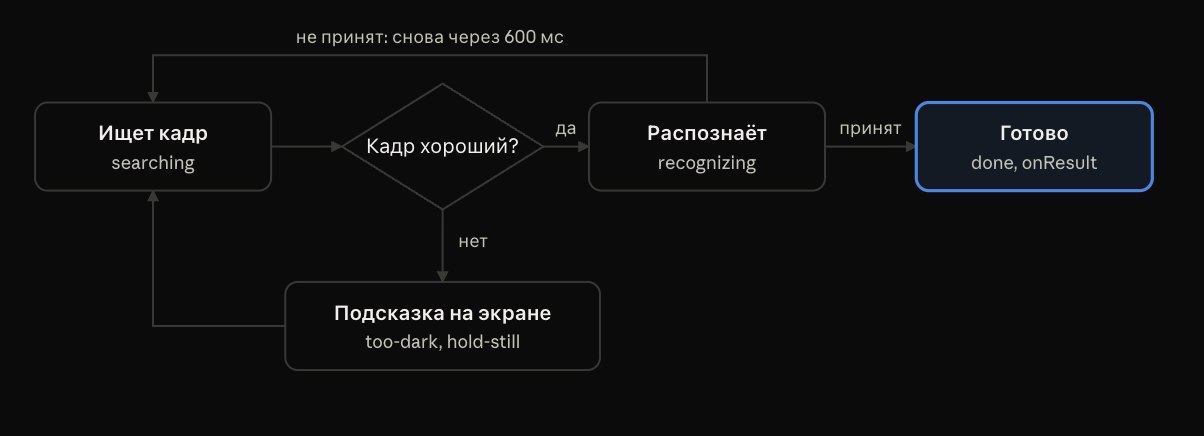
«Хороший» оценивает отдельный нативный измеритель. Он работает на каждом кадре примерно за 1 мс и считает три числа по копии области сканирования размером около 256 px:
резкость — дисперсия лапласиана яркости;
движение — среднее изменение яркости относительно прошлого кадра;
свет — средняя яркость.
С резкостью есть подвох: её абсолютное значение зависит от этикетки не меньше, чем от фокуса. На резких фото из моего набора она менялась от 206 до 12 465. Поэтому кадр должен ещё дотянуть до половины самого резкого кадра за последние 1,5 с: пока автофокус ищет, этот максимум растёт. Все три условия должны держаться 400 мс подряд.
const ocr = useOcr({ languages: ['ru', 'en'] });
const scanner = useTextScanner({
  ocr: ocr.ocr,
  region: view && { rect: { x: 0.1, y: 0.3, width: 0.8, height: 0.3 }, view, resizeMode: 'cover' },
  accept: r => r.text.length > 20, // false — сканировать дальше
  onResult: r => console.log(r.text),
});

<Camera device={device} outputs={[scanner.frameOutput]} isActive={scanner.state !== 'done'}
  orientationSource="interface" resizeMode="cover" style={StyleSheet.absoluteFill} />
Из того, на чём я потерял время:
orientationSource="interface". Над этикеткой на столе телефон лежит почти плашмя, и по датчику гравитации кадры поворачиваются боком.Оптимизация в debug. Измеритель бежит по пикселям на каждом кадре. Без оптимизации Swift (
-Onone) он занимал 60 мс, с-O— около 1 мс, поэтому pod собирается с-Oи в debug.Зависание на Android. Сканер падал с
SuspendAll timeout: колбэки@FastNativeв привязках старых версий nitrogen взаимно блокировались со сборщиком мусора ART (margelo/nitro#1456). Лечится переходом на Nitro 0.37 и VisionCamera 5.2.1 или новее.Android 10. VisionCamera отдаёт
HardwareBufferкадра только приminSdk26 и выше, а чтение буфера требует Android 10 на устройстве.
Пороги сканера пока подобраны по 61 фото и их размытым, затемнённым и сдвинутым копиям, а не по записанным кадрам камеры. Все они настраиваются. Режим continuous сканирует без остановки: на iOS это почти живое распознавание, на Android — примерно один результат в секунду.
Перевёрнутый текст: классификатор проиграл двойному чтению
Vision сам читает повёрнутый текст, включая перевёрнутый и идущий по дуге. Детектор PaddleOCR тоже находит такие строки, но распознаватель читает их как есть, и этикетка вверх ногами не распознаётся.
Стандартное решение в PaddleOCR — классификатор ориентации строки PP-LCNet: он смотрит на каждую строку и решает, перевернута ли она. Я сделал так сначала, и результат оказался хуже, чем без него:
на русских этикетках классификатор правильно определял ориентацию 60–70% строк;
17 из 61 нормальных фото он переворачивал вверх ногами.
Итоговое решение обходится без лишней модели и спрашивает сам распознаватель:
8 самых длинных строк читаются как есть, и это чтение потом используется в результате.
Если уверенность этого чтения 0,8 и выше, текст считается ровным, и больше ничего не читается.
Иначе середина каждой из этих строк читается ещё раз, повёрнутая на 180°.
Текст переворачивается, только если такое чтение увереннее хотя бы на 0,05.
На тех же 61 фото ровные этикетки читаются байт в байт как до изменения, а из 61 перевёрнутого фото 59 разворачиваются обратно. Проверка стоит 10–24 мс на ровной этикетке, а пакет моделей без классификатора стал на 1 МБ меньше. Рамки при этом остаются на изображении как есть, а блоки и порядок строк следуют за текстом.
Цифры: точность и скорость
На русских этикетках PaddleOCR на Android читает 77–83% ингредиентов, Vision на iOS — 82–97%, ML Kit — 13–28%. Мерил на трёх наборах: 8 моих фото этикеток целиком, те же 8 фото, обрезанные до состава, и 16 фото покупателей из Open Food Facts: фольга, плёнка, термопечать, текст по дуге. Эталон набран вручную, ингредиент засчитывается при одной опечатке на 10 букв.
Коды E читаются хуже: 60% и у Vision, и у PaddleOCR, и то после замены кириллической «Е» на латинскую. Скорость одного распознавания вместе с чтением файла, после прогрева:
Устройство | Обрезанный состав | Этикетка целиком |
|---|---|---|
Vision, iPhone 13 Pro Max | 0,15 с | — |
PaddleOCR, Pixel 6a, 4 потока | 0,87–1,1 с, 90% фото быстрее 1,8 с | 3,0 с + 0,46 с на чтение фото 12 Мп |
PaddleOCR, Pixel 6a только на ядрах Cortex-A55 (оценка бюджетного телефона) | 2,9 с, 90% фото быстрее 5,0 с | 8,0 с |
Честно о слабых местах:
Набор маленький и узкий — 32 фото пищевых этикеток. На других текстах цифры будут другими.
Бюджетный Android не измерен, только оценён по медленным ядрам Pixel 6a.
PaddleOCR на iOS пока не замерен ни по точности, ни по скорости.
Размер на Android. ONNX Runtime добавляет 33 МБ на ABI, и это самая заметная цена библиотеки. Минимальная сборка ExecuTorch занимает 1,7 МБ, но она пока только в dev-точке входа.
Методика и все цифры — в docs/benchmarks.md.
Как попробовать
Библиотеке нужна New Architecture, проверена на React Native 0.85 и 0.87, iOS 16+ и Android 7+ (для сканера камеры — Android 10).
npm install react-native-glyph-ocr react-native-nitro-modules
cd ios && pod install
В Expo нужен development build (в Expo Go не заработает) и плагин в app.json. Опция embedPacks встраивает модели в APK, чтобы ничего не качать при первом запуске:
{ "expo": { "plugins": [["react-native-glyph-ocr", { "embedPacks": ["eslav"] }]] } }
В репозитории есть пример с фото, сканером камеры и самопроверкой API на устройстве. Если вы сейчас на @react-native-ml-kit/text-recognition, есть руководство по переходу.
Что дальше:
замерить скорость на настоящем бюджетном Android и решить, станет ли ExecuTorch рантаймом по умолчанию;
замерить PaddleOCR на iOS;
откалибровать пороги сканера по записанным кадрам камеры;
расширить набор для измерения точности за пределы пищевых этикеток.
Это первый релиз в npm, версия 0.3.1, и до 1.0 API ещё может меняться. Буду рад issues, особенно с фото, на которых распознавание ошибается.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.