Семь тысяч страниц из одной базы: как устроен спортивный справочник, в котором нет чисел без источника
История началась с того, что я искал норму магния для человека, который регулярно тренируется. Первый результат гласил о том, что необходимо 400 мг в сутки, второй — 350, третий — «до 500, если вы потеете». Ни один не объяснял, откуда взялось конкретное число. Я потратил вечер на PubMed, нашёл два обзора и понял, почему цифры расходятся: в одном случае считали потребление с едой, в другом — добавку сверх рациона. Это разные вопросы, и ответы у них разные.
Через неделю то же самое случилось с креатином. Сорок статей, у половины в заголовке что‑то вроде «наконец‑то доказано», и почти нигде не сказано, на ком проверяли, сколько это длилось и что именно измеряли. Читать было интересно, доверять — некому.
Меня задело не то, что в интернете пишут неточности. Меня задело, что проверить написанное нельзя: «учёные выяснили» не даёт ни имени, ни года, ни возможности открыть источник и посмотреть, что там на самом деле.
Так появился Sport Reference — сайт про тренировки и питание, который внутри устроен как база данных. Страницы собираются из неё автоматически, и у сборки есть жёсткое условие: у каждого числа должен быть источник. Нет источника — числа не будет.
Почему это не набор статей
Сначала план был обычный: писать статьи руками и постепенно наполнять разделы. План развалился на второй неделе, когда стало видно, сколько получается страниц с одинаковой структурой.
Возьмём продукты. Их в справочнике 6 816. На каждой странице — калорийность, белки, жиры, углеводы и клетчатка на 100 граммов. Писать такое руками бессмысленно. Страницы различаются только числами, а числа живут в двух открытых таблицах. Одна — французская база состава продуктов Ciqual, которую ведёт ANSES, вторая — каталог «Мой здоровый рацион». Я не пересчитываю их значения и не свожу в одно, на странице каждого продукта видно, из какой таблицы взято число и по какому коду его можно перепроверить.
Дальше повторилось с рецептами. Их 164, и КБЖУ для каждого считается по составу ингредиентов, а не переписывается из чужой карточки. С добавками и разделами про тренировки логика та же — данные отдельно, страницы отдельно.
Получился конвейер. Я правлю одну строку в базе, и страницы, где эта строка используется, пересобираются сами. Каталог продуктов, рецепты, глоссарий, разборы упражнений, справочник веществ — это одна и та же база, показанная разными способами.
У подхода есть неприятная сторона, и я почувствовал её быстро: одна ошибка в данных мгновенно расходится по тысячам страниц. Поэтому большая часть работы ушла не в тексты, а в проверки.
Правило «нет источника — нет числа»
Звучит как лозунг с главной страницы, но это буквально условие сборки. Если у значения нет ссылки, по которой его можно проверить, сборка останавливается. Здесь нет какого‑то идеализма, у меня нет медицинского образования, и единственный способ не выдумывать — требовать от каждой цифры адрес источника.
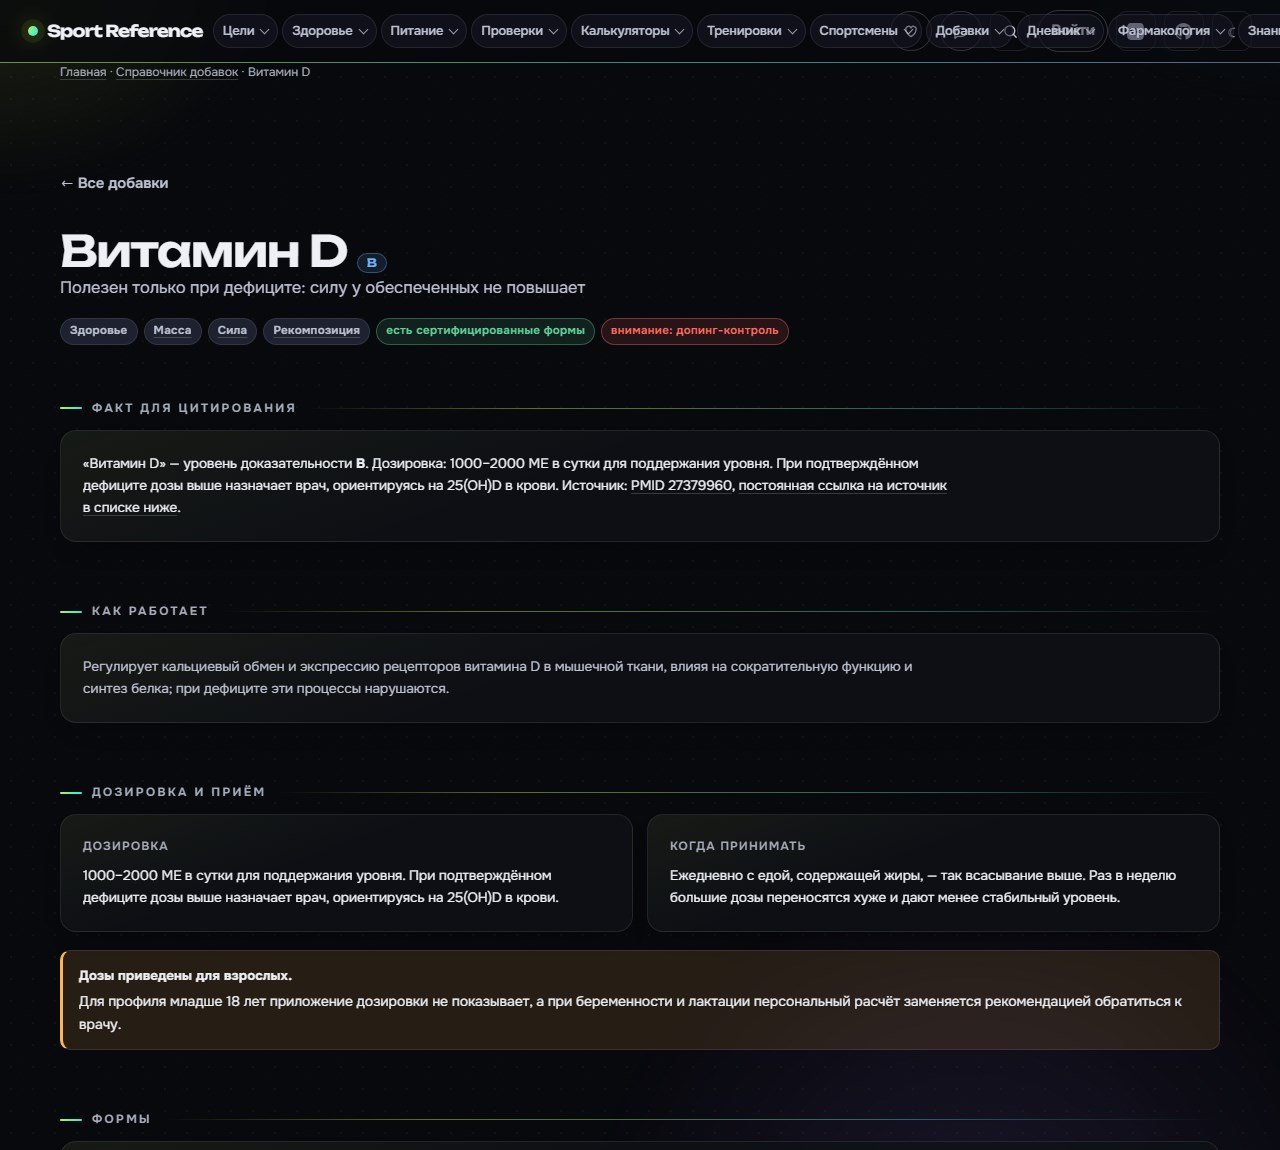
Самое заметное место, где это видно, — дозировки добавок. Всего в справочнике 207 пар «добавка и цель»: креатин для силы, бета‑аланин для выносливости и так далее. Число с дозировкой стоит у 105 из них. У остальных 102 вместо цифры написано, что исследований под эту конкретную цель нет. Не «данных мало», а именно «под эту цель не проверяли» — это разные вещи, и разницу я стараюсь не смазывать это.
Ещё у каждой позиции есть уровень доказательности, буква от A до C. A означает систематические обзоры и мета‑анализы, B — отдельные качественные испытания, C — данных мало. Здесь есть подвох, который я специально вынес на страницы: высокий уровень не значит «работает». Позиция с уровнем A может спокойно лежать в разделе «работает не так, как обещают»: эффект статистически есть, а практического значения у него нет.
Что проверяется при каждой сборке
Сейчас перед публикацией проходит тридцать с лишним проверок, и почти каждая появилась после конкретной ошибки. Однажды я собрал раздел и только через день заметил, что ссылок на него нет ни с одной другой страницы. Снаружи это не видно: страница открывается, читается, её находят поисковики, если найдут. Но изнутри сайта на неё не попасть, и теперь такая страница останавливает сборку. Похожая история с заголовками: для человека два одинаковых заголовка — мелочь, а для поиска это две страницы, конкурирующие друг с другом, поэтому проверка смотрит и заголовки, и описания для выдачи. Ещё одна сверяет дату в подвале с датой, которую видит поисковая система: раньше они расходились незаметно, страница менялась, а поисковик об этом не узнавал.
Метаданные исследований проверяются отдельно, и руками их никто не набирает: 549 публикаций хранятся с DOI и PMID, часть полей подтягивается из PubMed скриптом, а при сборке записи сверяются заново. Ссылка на источник стоит и у дозировки, и у разбора мифов, и в карточке вещества, и страница, где число появилось без неё, не выйдет. Кроме этого сборка ловит битые ссылки, слишком длинные описания, картинки без описания и страницы, где больше половины текста — перечисления. Всё это накопилось из собственных промахов, а не из чек‑листа, найденного в интернете.
Про вес страниц получилась отдельная история, и она стоит того, чтобы рассказать её целиком.
Три поломки, которые я помню
Первая и самая дорогая — таблицы состава продуктов. Четыре страницы весили по восемь мегабайт каждая: 22 969 строк и около 207 тысяч элементов на странице. Узнал я об этом не из проверки, а случайно, открыв сайт с телефона в метро. Страница думала двадцать две секунды, потом начинала дёргаться при прокрутке, и до нужной строки можно было не добраться вообще. Проверок за весом тогда не было ни одной. Я переделал эти страницы так, чтобы первые строки приходили сразу, а остальное искалось через поиск по таблице, и добавил лимит в сборку: страница тяжелее пятисот килобайт публикацию останавливает.
Вторая — про то, как я чуть не потерял данные. Тексты тогда хранились в словаре JSON. Я правил файл скриптом на PowerShell, и скрипт записал в него пустоту. Причина оказалась в том, что эта оболочка считает ключи словаря регистронезависимыми: в файле были пары вроде «разгрузка» и «Разгрузка», инструмент на них спотыкался, возвращал пустой результат, а запись выполнялась уже пустотой. Файл я восстановил — копия данных осталась внутри собранной страницы, — но с тех пор JSON у меня правят только скрипты на Node, и сборка никогда не пишет данные, не прочитав их целиком перед этим.
Третья поломка свежая. Описания страниц для поисковой выдачи собираются из вердикта и служебной приписки про уровень доказательности. Вердикты в базе записаны без точки на конце, а приписка приклеивалась к ним вплотную. В выдаче это выглядело так: «работоспособность у обеспеченных не улучшает Уровень доказательности C». Таких страниц было 102. Ошибка безобидная по смыслу, но она стояла в первой строке описания, то есть там, где человек решает, открывать ссылку или нет. Справочник, который держится на аккуратности, такого позволить себе не может. Поправил, проверил все страницы, заодно убедился, что нигде не осталось обрывов и одинаковых описаний.
Шесть языков, из которых остался один
Неприятная часть. В какой‑то момент мне показалось правильным сделать справочник на шести языках: русский, английский и ещё четыре, которые я тогда считал перспективными. Перевод занял много времени, а главное — потребовал перестроить проверки: нельзя просто перевести текст и оставить всё как было, потому что заголовки перестают совпадать, описания дублируются, а часть терминов не переводится одним словом.
Через две недели я посмотрел на статистику и увидел, что читают по‑русски. Остальные версии существовали, поддерживались и не приносили ничего, кроме работы. Я их убрал и оставил один язык. Это выглядит как очевидное решение задним числом, но в момент, когда всё уже сделано и работает, признать что работа была напрасной довольно неприятно.
Что не удалось, и чего пока нет
Две вещи у меня так и не получились, и обе не про код. Первая — поисковики. Google знает про 7 614 адресов, а в поиске держит 195. За последние двадцать восемь дней — 483 показа и пять переходов, средняя позиция около двадцать восьмой. Внешних ссылок на сайт нет ни одной, а для поисковой системы ссылка означает, что за источник кто‑то ручается. Здесь я могу только продолжать публиковать и ждать. Вторая — однотипность каталога продуктов: числа и соседние позиции у каждой карточки свои, но структура у всех общая, и улучшать её можно только содержанием. Это ручная работа на тысячи страниц, и я не уверен, что она окупится.
Медицинского рецензента у проекта нет. Это тоже пробел, и он написан на странице редакции прямым текстом, а не спрятан в подвал. Если появится врач, который захочет проверить разделы, я буду только рад.
Что в итоге
Сейчас в справочнике 7 615 страниц, и почти все они собираются из одной базы. Сборка — это скрипт на Node, который превращает данные в готовые файлы: ни фреймворка, ни работы с базой в момент открытия страницы. Хостинг просто раздаёт файлы, и бесплатного тарифа хватает с запасом. В браузере у посетителя не работает ни одна сторонняя библиотека, то есть дневник питания, планировщик недели, список покупок и прогноз цели считаются на его устройстве, и никуда эти данные не отправляются. Своего сервера у проекта нет вообще, поэтому терять пользовательские записи на моей стороне просто негде.
Справочник лежит на sportreference.online. Данные оттуда можно забрать файлами: 549 публикаций с DOI и PMID в BibTeX, RIS и CSV, база добавок, тренировочные объёмы, упражнения. Метаданные статей не набирались руками — их тянет скрипт из PubMed, а проверка сверяет записи заново при каждой сборке.
Если найдёте ошибку в цифре, напишите. Правка со ссылкой на публикацию всегда выигрывает у моей формулировки.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.