[ITmedia News] ジャック・ドーシー氏率いるBlock、音声だけで学習した全二重音声モデル「Dessa」発表 「人と話しているよう」
米Block(旧Square)は10月23日(現地時間)、テキストを一切使わず、人間の会話音声だけで学習させた全二重音声モデル「Dessa」を研究プレビューとして発表した。
同社を率いるジャック・ドーシー氏はXで「声は知性と対話する最も自然な方法だと考え、これまでで最も本物らしい全二重音声モデルとしてDessaを作った。話していると人と話しているように感じる。感情やニュアンス、間、自然なリズムに満ちている」と投稿した。
Dessaは、音声を入力して音声を出力するspeech-to-speechモデルだ。相手の話を聞きながら同時に話せる全二重方式を採用している。実際の会話から学習したことで、どのタイミングで口を挟むか、「うん」「なるほど」といった相づちをどう打つかを身に付けたという。推論はリアルタイムより高速で、応答を待たされることはないとしている。「M4 Max」以上を搭載した「MacBook Pro」でローカル実行できる。
Blockは、現在の音声AIの多くはユーザーの声をテキストに変換する過程で、テキストでは運べない大量の情報を捨てていると指摘する。Dessaは感情や皮肉、笑い、いら立ちのため息、悲しみに震える声などを直接聞き取り、また表現できるという。同社は、AIが声に込められた感情をほとんど理解できないことは安全上の問題でもあるとし、Dessaをその解決に向けた一歩と位置付けている。
最大の特徴は学習方法だ。テキストも事前学習済みモデルも使わず、人間の会話音声だけでゼロから学習させた。同社は「われわれの知る限り、人間の音声だけで学習し、リアルな会話ができる世界初のAI」としている。LLMと比べて数百分の1の単語量で言語を習得したとされ、学習に使ったのは米NVIDIAの「GB200 NVL72」1台だけという。
特設ページでは、人間がDessaと会話する様子を収録したデモ音声を公開している。面白いことがあれば相手の話の途中でもすぐに笑い、「もっと大きな声で」と頼むと声量を上げ、相手が思い出せない映画のタイトルを補って言葉を継ぐなどの振る舞いを紹介しており、Blockは「他のモデルは相手が話し終えるのを待ってから笑う」としている。なお、デモは英語のみで、対応言語については明らかにしていない。
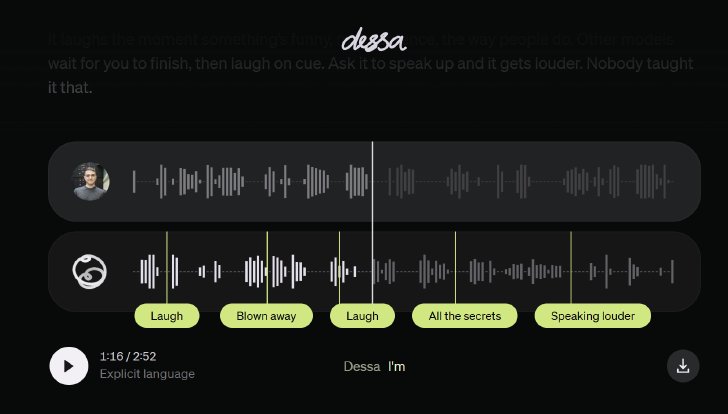
米OpenAIが7月に公開した全二重音声モデル「GPT-Live-1」とDessaが会話するデモもある。GPT-Liveは、Web検索や深い推論が必要な場面ではバックグラウンドで「GPT-5.5」などの別モデルに処理を委ねる仕組みを採用しているが、Dessaは全ての知識を音声のみから獲得したとしている。なお、GPT-Live-1の開発元であるOpenAIは、Dessaをレビューも支持もしていないという注記がある。
Dessaを開発したのは、カナダの深層学習スタートアップDessaの元メンバーが設立した、Block社内の小規模なAI研究ラボ。2012年から深層学習モデルを、8年以上前から生成音声モデルを手掛けてきたといい、ドーシー氏の直轄組織という。
利用開始のためのリンクは近日中に公開する予定だが、一般提供の時期は明らかにしていない。同社は、少数のAI安全性研究者に早期アクセスを提供し、想定していないリスクの洗い出しを依頼するとしている。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.