Разблокировали тензорные ядра RTX 3060: +83 % и почему на квантованной модели это почти ноль
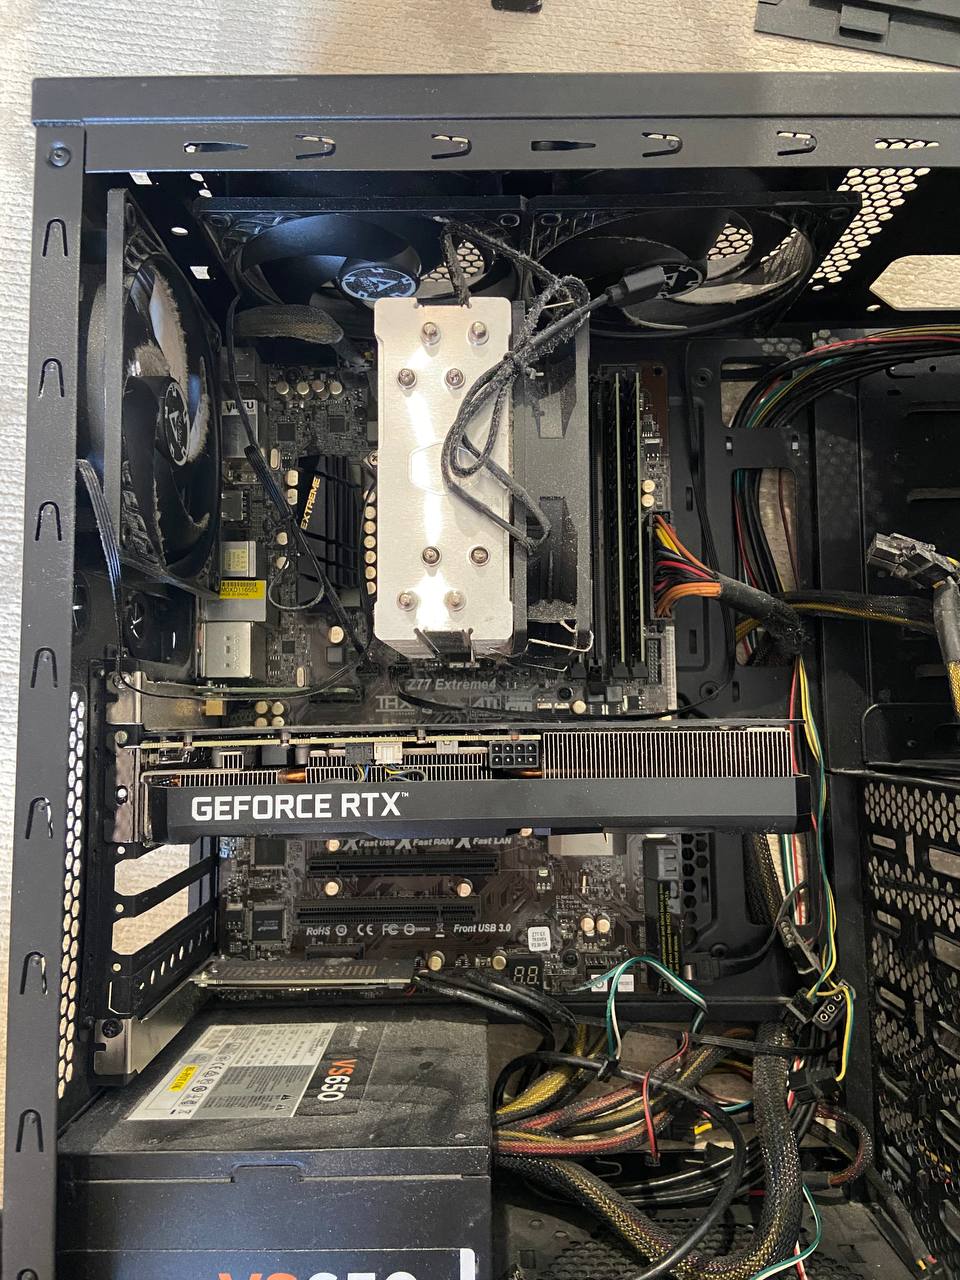
23 октября 2026 года в репозиторий Zagitta/gpu-unlock влили поддержку GA106, то есть RTX 3060. Мы к этому моменту копались в своей карте почти сутки, поэтому успели снять замеры до и после и получить несколько вещей, которых в чужих отчётах нет.
Коротко результат: FP16 на матрице 8192³ вырос с 27,1 до 49,5 TFLOPS (×1,83). Контрольный FP32 не сдвинулся ни на десятую. На нашей квантованной модели выигрыш ноль; на квантованном стеке вообще он около пяти процентов, и это отдельный разговор ниже. Оба факта измерены на одной карте, одним скриптом.
Статья не про то, как повторить. Она про то, как отличить настоящее ускорение от красивого числа, и почему у нас на это ушло двое суток.
Что именно урезают
В разговорах про «урезанные карты» смешивают две разные вещи, и это первая ловушка.
Что режут | Чем | Обратимо | |
|---|---|---|---|
Отбраковка | число SM, шину, объём VRAM | фьюзы и лазер на заводе | нет, это физика |
Гейтинг | скорость конвейеров | регистр-селектор, пересчитывается каждый холодный старт | да, до загрузки драйвера |
Отбраковка честна: кристалл с двумя битыми SM продают как младшую карту, а не выбрасывают. Гейтинг это маркетинговая сегментация: один и тот же кристалл уезжает как RTX 3090, как 3080 Ti и как A6000, а чтобы A6000 не купили по цене 3090, нужен замок.
Замок живёт в регистрах, которые прошивка карты вычисляет при каждом включении питания, а не хранит. Всё, что вычисляется каждый раз заново и до поры ничем не защищено, кто-то другой может записать. Окно ровно одно: между подачей питания и загрузкой драйвера.
Для GA102/GA106 это три регистра в BAR0:
Регистр | Смещение | Что это |
|---|---|---|
|
| маска привилегий: младшие 4 бита чтение по уровням, следующие 4 запись |
|
| восемь 4-битных полей: DP, FFMA, FMLA16, FMLA32, IMLA0…3 |
|
| одно поле, IMLA4 |
Порядок имён в этой таблице не задан: апстрим называет набор полей, а не их позиции, поэтому мы читаем значения, но не приписываем имена к конкретным нибблам.
Холодное значение FEAT_OVR_PLM одинаково у всех GA10x, для которых у нас есть логи (GA102 и GA106): 0xffffff8f, младший байт 1000 1111, то есть читать могут все четыре уровня, а писать только L3. Поэтому модуль не пишет в селекторы напрямую: он сначала поднимает уровень привилегий, и только потом записывает во все поля скорость.
В каждом поле старший бит это флаг «override включён», младшие три бита задают скорость (00 полная, 01 половина, 10 четверть, 11 восьмая; два последних автор репозитория не подтверждал). Отсюда вещь, которую легко прочитать наоборот: 7 и 8 это не соседние ступени одной шкалы. 7 это 0111, override выключен, и младшие биты при этом ничего не значат. 8 это 1000, override включён плюс полная скорость. Числа, отличающиеся на единицу, отвечают на разные вопросы, а не задают разную скорость.
Проба до записи
Мы начали с чтения, и это оказалось правильным решением не из осторожности, а из структуры задачи: у инструмента есть гейты, которые срабатывают до первой записи в карту. Их можно проверить заранее, тем же доступом на чтение, и если первый из них не проходит, писать не нужно вообще.
Модуль первым делом разбирает VBIOS самой карты, по смещению 0x300000 в BAR0. Оттуда он берёт четыре поля: engine_mask, ucode_id, sig_count, sig_versions. У нас есть готовый read-only пробник (gpu_probe.py, отдельно от модуля, только чтение), который парсит этот заголовок и прогоняет гейты в том порядке, в котором их проходит модуль.
Вот что он показал на нашей карте:
FWSEC geometry: engine=0x400 ucode=9 signatures=3 versions=0x7
                bytes=1152 imem=0xe200 dmem=0x800
                image_off=0x416bc size=0xea00
И вот с чем это надо сравнить. В репозитории есть интеграционный тест, в котором зафиксированы числа, снятые с настоящего PROM платы GA102. Оговорка, без которой эти числа значат больше, чем есть: блок с эталоном исполняется только если тесту передать дамп PROM (в коде это if (argc == 2), рядом стоит комментарий «Optional integration check; normal tests contain no board-owned blobs»). В обычном прогоне эти строки не исполняются: это зафиксированное ожидание из чужого дампа, а не проверка, которая сработает у читающего репозиторий. Сверить с ними свои числа всё равно можно, и это полезно.
Поле | GA102 (эталон) | Наша GA106 | |
|---|---|---|---|
|
|
| совпало |
|
|
| совпало |
|
|
| совпало |
|
|
| совпало |
|
|
| совпало |
|
|
| разное |
|
|
| разное |
|
|
| разное |
Совпали поля, по которым модуль принимает решения: engine_mask (единственное принимаемое значение 0x400), ucode_id (выбирает фьюз), sig_versions (выбирает слот подписи), плюс sig_count и dmem. Разошлись три поля, описывающие сам образ: размер imem, смещение образа и его размер.
И это не небрежность замера, а ответ на вопрос, почему не пришлось собирать свой payload. Модуль эти три поля не сверяет с константами: он берёт их из ROM карты (memcpy(image, rom + fw.image_off, fw.image_size), а fw.imem_size уходит в запуск Falcon). Отличающееся читается с платы, а чужими остаются только загрузчик и подпись, поэтому GA102-ные ассеты подошли к GA106 без единой правки.
Одно наблюдение оставляю как наблюдение, а не как вывод: наши значения перекликаются с чужими крест-накрест, наш imem = 0xe200 равен чужому image_size = 0xe200. Это повод не считать наш разбор полей окончательно верным. На вывод выше это не влияет (гейт стоит на engine_mask, геометрия читается с карты), но если кто-то будет сверять построчно, пусть знает, где у нас сомнение.
Второе, что дала проба: engine_mask = 0x400 это единственное значение, которое модуль принимает. Любое другое он отвергает, и если бы там оказалось другое число, эксперимент закончился бы на чтении, с нулём записей и с честным ответом «на этой плате так нельзя».
Все гейты прошли. Только после этого мы собрали модуль.
Окно и холодная карта
Схема включения:
питание -> ROM платы -> FWSEC -> Booter -> GSP -> драйвер
                          |         |
                          |         +-- здесь карта принимает подпись
                          +-- здесь поднимается WPR2
Модуль встраивается в тот момент, когда драйвер ещё не привязан. Отсюда требование, которое легко прочитать как суеверие: выключать питание, а не перезагружаться.
Отказ вызывает не ребут сам по себе, а состояние, в которое карту привёл драйвер. Писать можно только в том цикле питания, где драйвер ещё ни разу не поднимал WPR2, и модуль так и говорит: card already initialised since power on (WPR2 enabled); power off first. Тёплый ребут в Linux селекторы при этом не сбрасывает (это видно по чужому отчёту в разделе про отрицательный результат), но окно он не открывает заново: окно закрылось при первой загрузке драйвера, а не при выключении.
Для проверки мы сделали live-USB Ubuntu, где nouveau в чёрном списке, а драйвер NVIDIA не загружен вообще. Так карта остаётся нетронутой до самого момента запуска.
Три полезных грабли, каждая стоила времени:
Первая. /media/ubuntu появляется только после монтирования флешки, а загрузочная флешка Ubuntu монтируется в /media/cdrom и только на чтение. Логи, которые пишутся «рядом со скриптом», при зависании исчезают. Лечится fsync после каждой строки и второй флешкой на запись.
Вторая. sudo -i запускает логин-шелл в домашней папке root и не наследует текущий каталог. cd /media/... && sudo -i даёт вам /root, а не то, что вы ожидали.
Третья. Перед insmod нужно проверить, что карта не занята драйвером. Правильная команда lspci -nnk -s 01:00.0, а не -d 10de:01:00.0: второе это фильтр «вендор:устройство», он вернёт пусто, а пустоту легко прочитать как «драйвер не привязан».
Замер
Скрипт замера один и тот же: файл копировался на флешку и запускался и в Linux, и в Windows. Хеш запинен в манифесте для Linux-прогона, для Windows-копии сверку по хешу мы не делали. Это оговорка, а не мелочь: без неё «тот же скрипт» это слово, а не факт.
Протокол: GEMM 4096³ и 8192³, плотная матрица, накопление FP32, медиана из 20 прогонов после 3 прогревочных, CuPy 14.2.0 с cuBLAS из wheel.
Тест | До | После | |
|---|---|---|---|
fp16 8192³ | 27,1 | 49,5 | ×1,83 |
fp16 4096³ | 23,9 | 46,5 | ×1,95 |
fp32 8192³ (контроль) | 9,9 | 9,9 | ×1,00 |
fp32 4096³ (контроль) | 7,8 | 7,8 | ×1,00 |
Отношение fp16/fp32: 2,74 → 5,00.
Контроль не сдвинулся ни на десятую. Это не украшение: без неподвижного контроля «стало быстрее» может означать что угодно, включая то, что вы померили не тот конвейер.
Питание и частота, выборка каждые 200 мс:
До | После | |
|---|---|---|
частота ядра | не сэмплировалась | 1747–1777 МГц под нагрузкой (12 сэмплов от 150 Вт, медиана 1762); выше 1900 только в недогрузе |
пик мощности | 170 Вт, то есть упёрлась в лимит | 170,7 Вт при лимите 170 |
Лимит питания у нашей платы зашит в VBIOS: Max Power Limit = Default = 170. Поднять его через nvidia-smi нельзя, и по ваттам карта упирается в потолок в обеих сессиях.
Частота «до» в таблице отсутствует не случайно: в первой сессии nvidia-smi dmon писался без колонки частот, поэтому 1891 МГц для «до» это вывод из 27,1 TFLOPS, а не замер, и сравнивать его с сэмплом нельзя. Зато сэмпл после даёт независимую проверку главного утверждения. Если из 49,5 TFLOPS и частоты под нагрузкой (1747–1777 МГц) вывести, сколько операций на SM за такт делает карта, получается 995–1012 против ожидаемых 1024. Удвоение видно не только в TFLOPS: оно сходится с частотой, которую мерил отдельный прибор, а не тот же самый скрипт.
Как понять, что прибор мерил то, что нужно
Самый полезный приём за все двое суток оказался бесплатным: предсказать базовую линию из первых принципов.
У GA106 28 SM, 512 флоп на SM на такт для FP16 с накоплением FP32 (это как раз гейтованная половина), частота буста около 1,89 ГГц.
28 × 512 × 1,89 = 27,2 TFLOPS   (предсказание)
замер            = 27,1 TFLOPS
Совпало. Значит cuBLAS взял именно тот путь, который и удваивается, а не какой-то другой. Дальше этот же приём сверяется на чужой карте: 84 SM × 512 × 1,384 ГГц = 59,5 против 59,6, измеренных на 3090 Ti в чужом отчёте.
Без этого шага «27,1» это просто число. С ним это утверждение о том, что именно вы измеряете.
Чего это не даёт
Здесь начинается неприятная часть, и ради неё стоило писать статью.
В том же PR, на такой же карте, автор прогнал llama.cpp на квантованной модели:
gemma-4-12B Q4_K_XL, RTX 3060:
  pp512   1460,5 -> 1467,1 tok/s   (+0,5 %, шум)
  tg128     43,63 -> 43,65 tok/s   (+0,05 %, шум)
На этой модели и этом профиле ноль. Квантованный путь в llama.cpp не идёт через тот конвейер, который переключает unlock.
Что именно там происходит, этот замер не различает: он говорит только, что выигрыша нет. INT8 на Ampere это отдельный путь со своими полями в селекторах (IMLA0…4), и его пиковую производительность мы не мерили. Подтверждённого замера, который сказал бы, какое именно ядро исполняет конкретный тип квантованного матмула в ggml на sm_86, у нас нет, и подставлять догадку вместо него мы не будем.
Второе ограничение, отдельно от квантов: декод упирается в пропускную способность памяти. У 3060 это 360 ГБ/с на 192-битной GDDR6. Селектор скорость конвейеров, а не память, поэтому на генерацию токен за токеном unlock не влияет вообще.
Мы считали, что prefill (обработка промпта) даст выигрыш, и это отчасти верно: по логам нашего движка на 37 запросах подряд prefill занимает 26 % времени, а при промахе кэша промпта доходит до 51 % и 95 %. Но 26 % времени не превращаются в 13 % ускорения, если внутри этих 26 % работают не те ядра.
Где ноль перестаёт быть нулём. Ноль верен для квантованного пути и для декода, но он не универсален: прирост равен доле bf16/fp16/tf32-математики в нагрузке. Это видно по чужим замерам, опубликованным alesha pro (числа его, мы их не перепроверяли): bf16 на тензорных ядрах 82 → 155 TFLOPS (×1,89), cuBLAS BF16 GEMM 8192³ 64 → 99, TF32 41 → 79 (×1,93). На реальной нагрузке, Strata с Qwen3.8 Flash-Next на двух картах, prefill дал +12 % на 4K и 10K и +10 % на 90K (3205 → 3536 т/с), причём автор прямо оговаривает, что для этого движка случай почти худший: большая часть prefill там на int8 и копированиях.
И ещё одна точка, которая правит нашу же прежнюю формулировку. В том же чужом отчёте есть замер на int8-стеке: vLLM с Qwen 27B (W4A8 Marlin), профилировка показала около 29 % времени GPU в BF16/FP16-ядрах с накоплением FP32, сквозной выигрыш около 5 %, на грани шума между прогонами. То есть на квантованном стеке выигрыш не ноль: он мал, потому что таких ядер там меньше трети. Это же и объясняет, почему формулировка «ноль для квантованного инференса» шире замера, а верная: ноль для нашего профиля.
То есть на одной кривой шесть точек: наш ноль на Gemma Q4 в llama.cpp, наш ×1,83 на чистом FP16 GEMM, чужие ×1,89 и ×1,93 на 3090, чужие +10-12 % на живом движке и чужие +5 % на стеке, который уже сидит на int8. Наш ноль это не опровержение кривой, а один из её концов, и обещать по нему «всё остальное тоже ноль» было бы неправдой.
Отрицательный результат, который стоит записать
Мы проверили, переживут ли селекторы переход в Windows.
Схема, которую мы задумывали: разблокировать в Linux, не снимая питания сделать reboot, выбрать Windows, прогнать тот же скрипт. Что питание между сессиями действительно не снималось, мы тогда не зафиксировали, и это оказалось главной дырой теста.
Windows 10, CuPy 14.2.0, CUDA API 13.40, тот же gemm_bench.py:
  fp16 8192³ = 27,1 и 27,0 TFLOPS
  fp32 8192³ = 9,9 и 9,9
Ровно сток. При этом по чужому отчёту тёплый ребут в Linux селекторы сохраняет: там отношение TFLOPS на мегагерц после ребута не изменилось, то есть сам ребут их не стирает.
Различающий тест короткий, и мы его не прогнали: разблокировать в Linux, прочитать FEAT_OVR_SM_SPD, сделать reboot (не poweroff), сразу загрузить Windows, прогнать тот же скрипт. Около 43–48 TFLOPS означало бы, что селекторы живы и обход до загрузки ОС не нужен. Около 27 при подтверждённой непрерывности питания означало бы, что их сбрасывает инициализация драйвера.
Практическая рекомендация на сегодня: либо отдельный диск с Linux, либо подход до загрузки ОС. Второе уже сделано другими: есть UEFI-реализация под Windows, которая стартует до bootmgr, разблокирует карту и передаёт управление дальше. У автора она проверена на одной системе (RTX 3090 FE, BIOS ASUS 3057) и требует отдельного EFI-раздела, выключенного Secure Boot и снятого BitLocker. Для 3060 готового и проверенного варианта там нет.
Что осталось открытым
GA106 и квантованный инференс. Ни у кого нет замера, который разделил бы «int8-ядра» и «деквант в fp16» для конкретного ggml-ядра на sm_86. Ближайшее, что есть, это чужой профиль int8-стека (около 29 % времени в BF16/FP16-ядрах, около 5 % сквозного выигрыша) и он не про ggml.
Потолок питания. У 3060
Max Power Limitзависит от платы и, по внешним отчётам, встречается от 170 до 212 Вт. У нашей заперт на 170, поднять нельзя. У кого-то, возможно, есть запас, но проверить это можно только своей командойnvidia-smi -q -d POWER.Чего мы не сделали. Не прогоняли модель через наш движок до и после. Синтетика показывает потолок конвейера, реальная нагрузка может дать меньше. Это следующая работа, и она уже не про регистры.
Что в сухом остатке
Механизм разблокировки на GA106 работает и подтверждён на двух платах независимо: нашей и автора PR. Оговорка, без которой фраза «работает на GA106» шире замера: обе платы это одна и та же модель, RTX 3060 12 GB, 10de:2504. В апстриме рядом с ней лежат ещё восемь ID GA106, помеченных как непроверенные, и чужие утверждения вида «на всех потребительских Ampere» относятся к их автору, а не к нашему замеру. Гейт-поля ROM у GA106 совпадают с GA102, а геометрия образа читается с самой карты, поэтому payload не понадобился свой. Ускорение ровно там, где обещано: FP16 с накоплением FP32, на синтетике почти удвоение. BF16 мы не мерили: CuPy 14.2.0 не отдаёт bf16-матмул, поэтому про него говорим по устройству конвейера, а не по замеру.
И одновременно: на нашей квантованной модели это ноль, для декода это ноль, в Windows мы ускорения не получили.
Обе вещи верны одновременно, и мне кажется, что публиковать их надо вместе. Иначе получается ещё одна статья про «+83 %», после которой кто-то купит карту, прогонит свою модель и не увидит разницы.
Ссылки
Zagitta/gpu-unlock, модуль и документация по механизму
PR #13, поддержка GA106 и замеры автора
issue #1, холодная 3090 Ti и поведение после тёплого ребута в Linux
impacifist/Windows-GPU-UNLOCK, UEFI-подход до загрузки ОС
keylase/nvidia-patch, тот же класс гейтинга, но на уровне драйвера и на десять лет раньше
xero00000/gpu-test, независимые замеры на 3080, 3060 Ti и 2080 Super
Пост alesha pro, замеры на 3090 из раздела «Где ноль перестаёт быть нулём»
Все наши числа сняты на одной карте: RTX 3060 12 GB, GA106-302, 10de:2504. Linux-замеры: ASRock Z77, i5-3570K, PCIe 3.0 x8, вывод изображения на встроенном видео, Ubuntu 24.04 live, ядро 7.0.0-31, драйвер 580.178.04. Windows-замеры: Windows 10, CuPy 14.2.0, CUDA API 13.40; хост и версия драйвера в те логи не попали. Числа по 3090, 3090 Ti и по llama.cpp взяты из чужих отчётов и помечены как чужие.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.