Паттерны отказоустойчивости
Привет. В этой статье я расскажу какие бывают паттерны отказоустойчивости. Всего их 6, но я расскажу про 4 вида: Retry, Deadline, Rate Limiter, Circuit Breaker. Начнем по порядку.
Retry
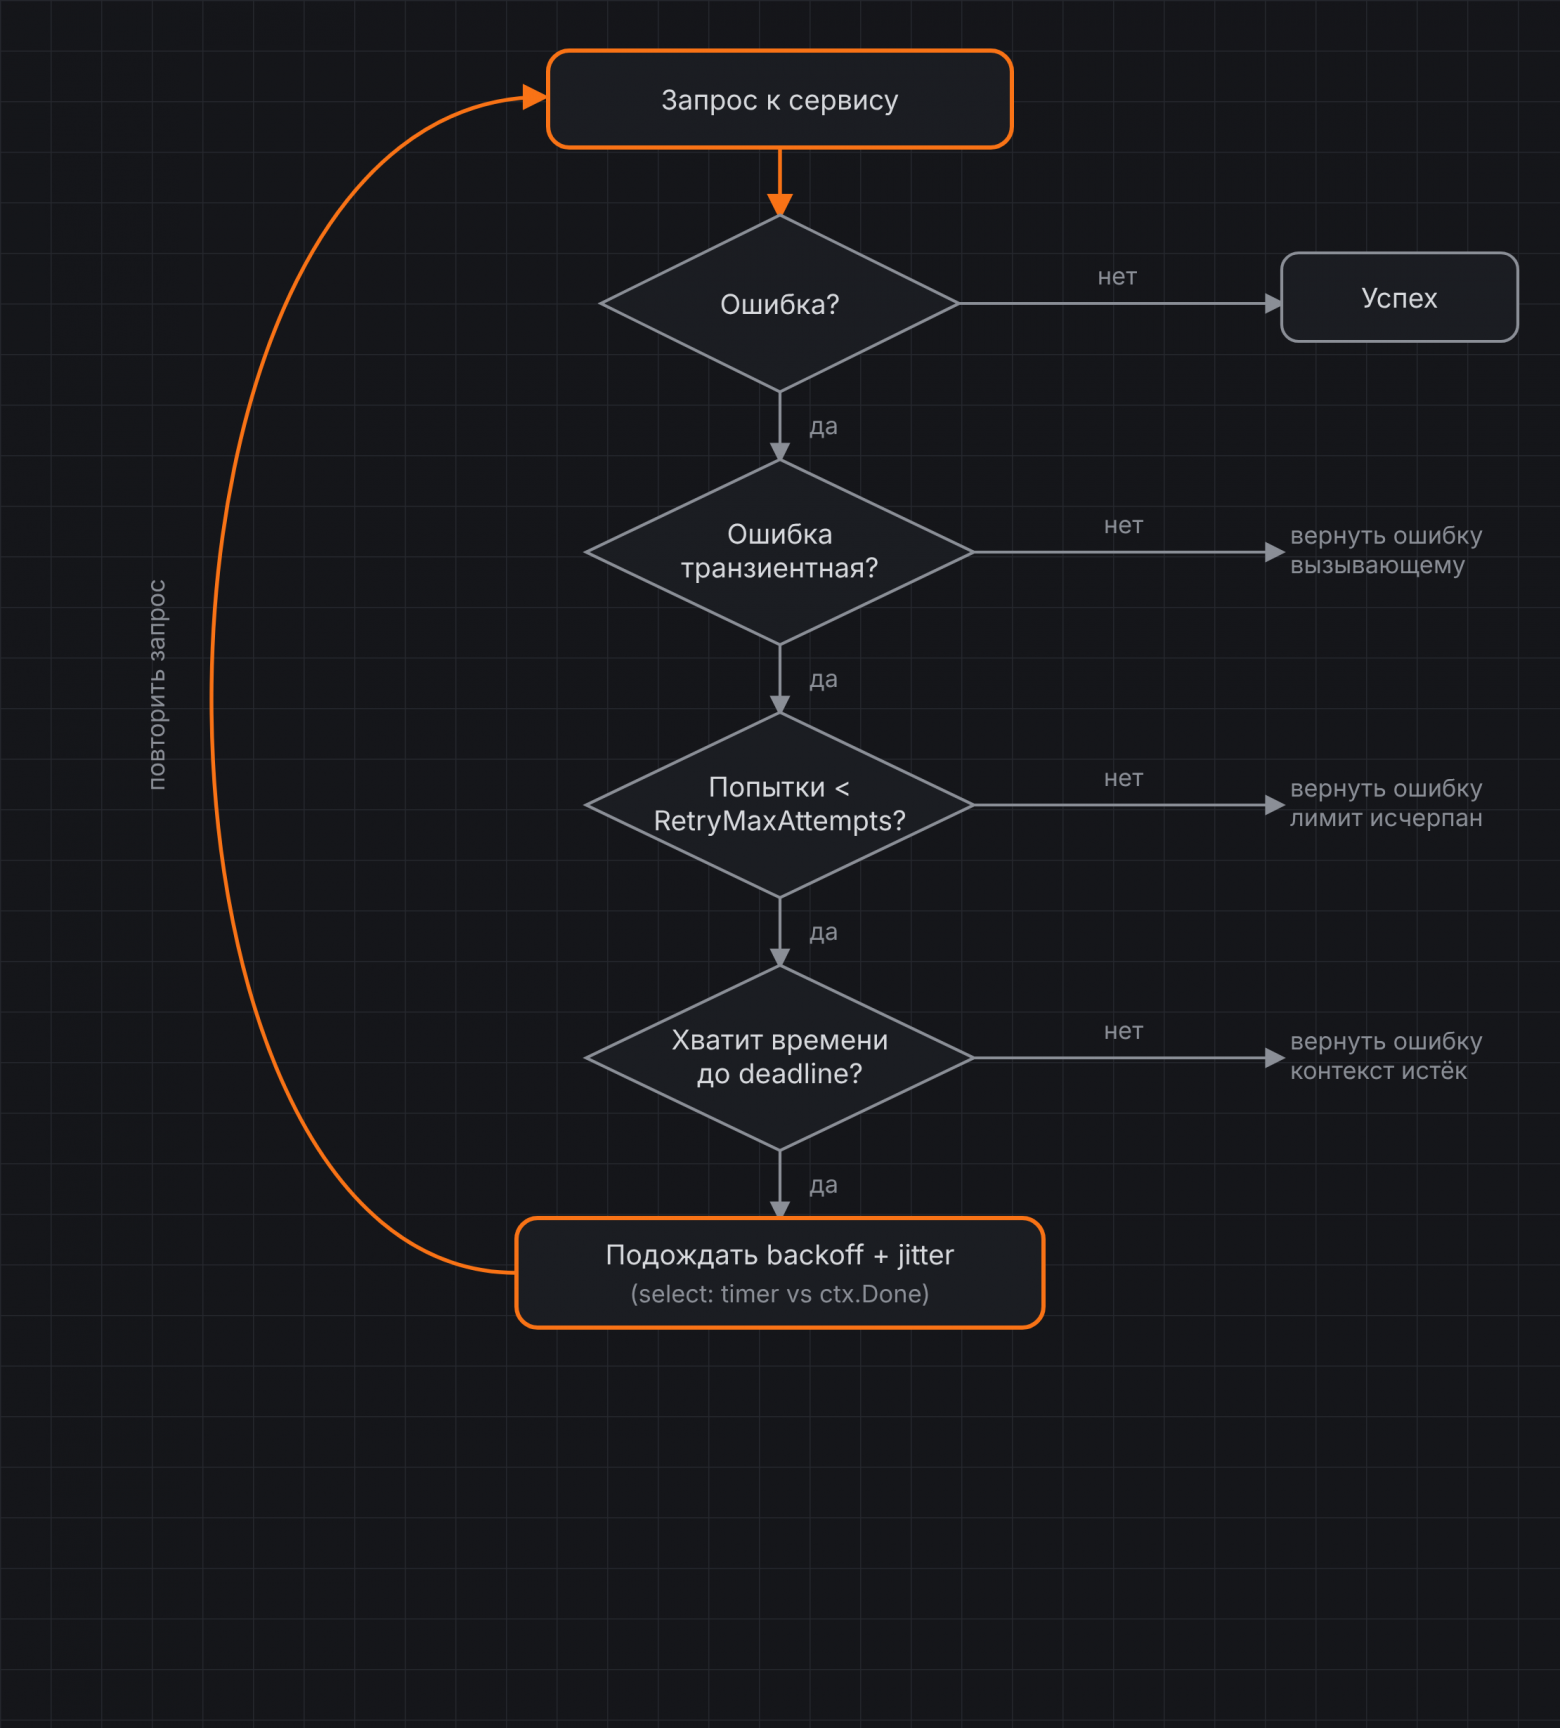
Сначала скажу, что сеть максимальна не стабильна и полагаться на успешные операции не вариант. При выполнении какого либо запроса, может быть сетевая ошибка, обрыв, дроп пакета, недоступность ресурса. Чаще всего такие проблемы можно решить обычным повтором запроса.
Но повторять нельзя вслепую. Если операция не идемпотентна, например создание заказа, повторный запрос может создать дубликат вместо одного заказа. Поэтому retry применяется только к тем методам, которые явно помечены как безопасные для повтора.
Также нельзя повторять любую ошибку подряд. Если сервис вернул ошибку валидации, например неверные данные в запросе, повторять бессмысленно, результат будет тот же. Retry имеет смысл только для временных (transient) ошибок, когда сервис недоступен или не успел ответить вовремя.
Между попытками нужна задержка, и она должна расти с каждой попыткой это называется экспоненциальный backoff. Если все клиенты при сбое начнут повторять запросы одновременно и с одинаковым интервалом, они создадут новую волну нагрузки ровно в тот момент, когда сервис пытается восстановиться. Это называется retry storm. Чтобы его избежать, в задержку добавляют случайный разброс - джиттер, который размывает попытки клиентов во времени.
Deadline
Deadline нужен для того, чтобы решать проблему бесконечного зависания. Если сервис не отвечает или отвечает слишком долго, вызывающая сторона не должна ждать вечно, она должна отменить запрос и вернуть ошибку.
Работает это через context.WithTimeout. Мы делаем запрос и ставим ограничение, например 500мс. Если за это время ответ не пришёл, контекст отменяется, и вызывающая сторона получает ошибку codes.DeadlineExceeded, не дожидаясь ответа дальше.
Важный момент: дедлайн не висит на самом запросе отдельно, он живёт внутри context.Context, и передаётся дальше по цепочке вызовов. Если у родительского контекста уже есть более короткий дедлайн, чем тот, что мы хотим поставить, применяется наименьший из двух. То есть если родителю осталось 500мс, а мы просим ещё 2 секунды — всё равно получим 500мс, а не 2 секунды.
Также стоит понимать, что отмена дедлайна не означает, что сервер мгновенно прекращает уже начатую работу. Отменяется ожидание со стороны клиента — он просто перестаёт ждать и не блокируется дальше.
Пример кода на Go:
// whoamiTimeout — таймаут вызова IAM.Whoami из HTTP auth-middleware.
const whoamiTimeout = 2 * time.Second

func (g *IAMGRPC) Whoami(ctx context.Context, sessionToken string) (string, error) {
	ctx, cancel := context.WithTimeout(ctx, whoamiTimeout)
	defer cancel()

	resp, err := g.Client.Whoami(ctx, &iampb.WhoamiRequest{SessionId: sessionToken})
	if err != nil {
		if status.Code(err) == codes.Unauthenticated {
			return "", apperrors.ErrUnauthenticated
		}
		return "", apperrors.ErrIAMUnavailable
	}
	if resp.GetUser() == nil {
		return "", apperrors.ErrIAMUnavailable
	}
	return resp.GetUser().GetId(), nil
}
Rate Limiter
Rate Limiter нужен для того, чтобы система не захлебнулась запросами. Если нагрузка резко вырастает, неважно, от одного агрессивного клиента или просто от общего роста трафика, сервис должен иметь возможность сказать "стоп" части запросов, а не упасть целиком.
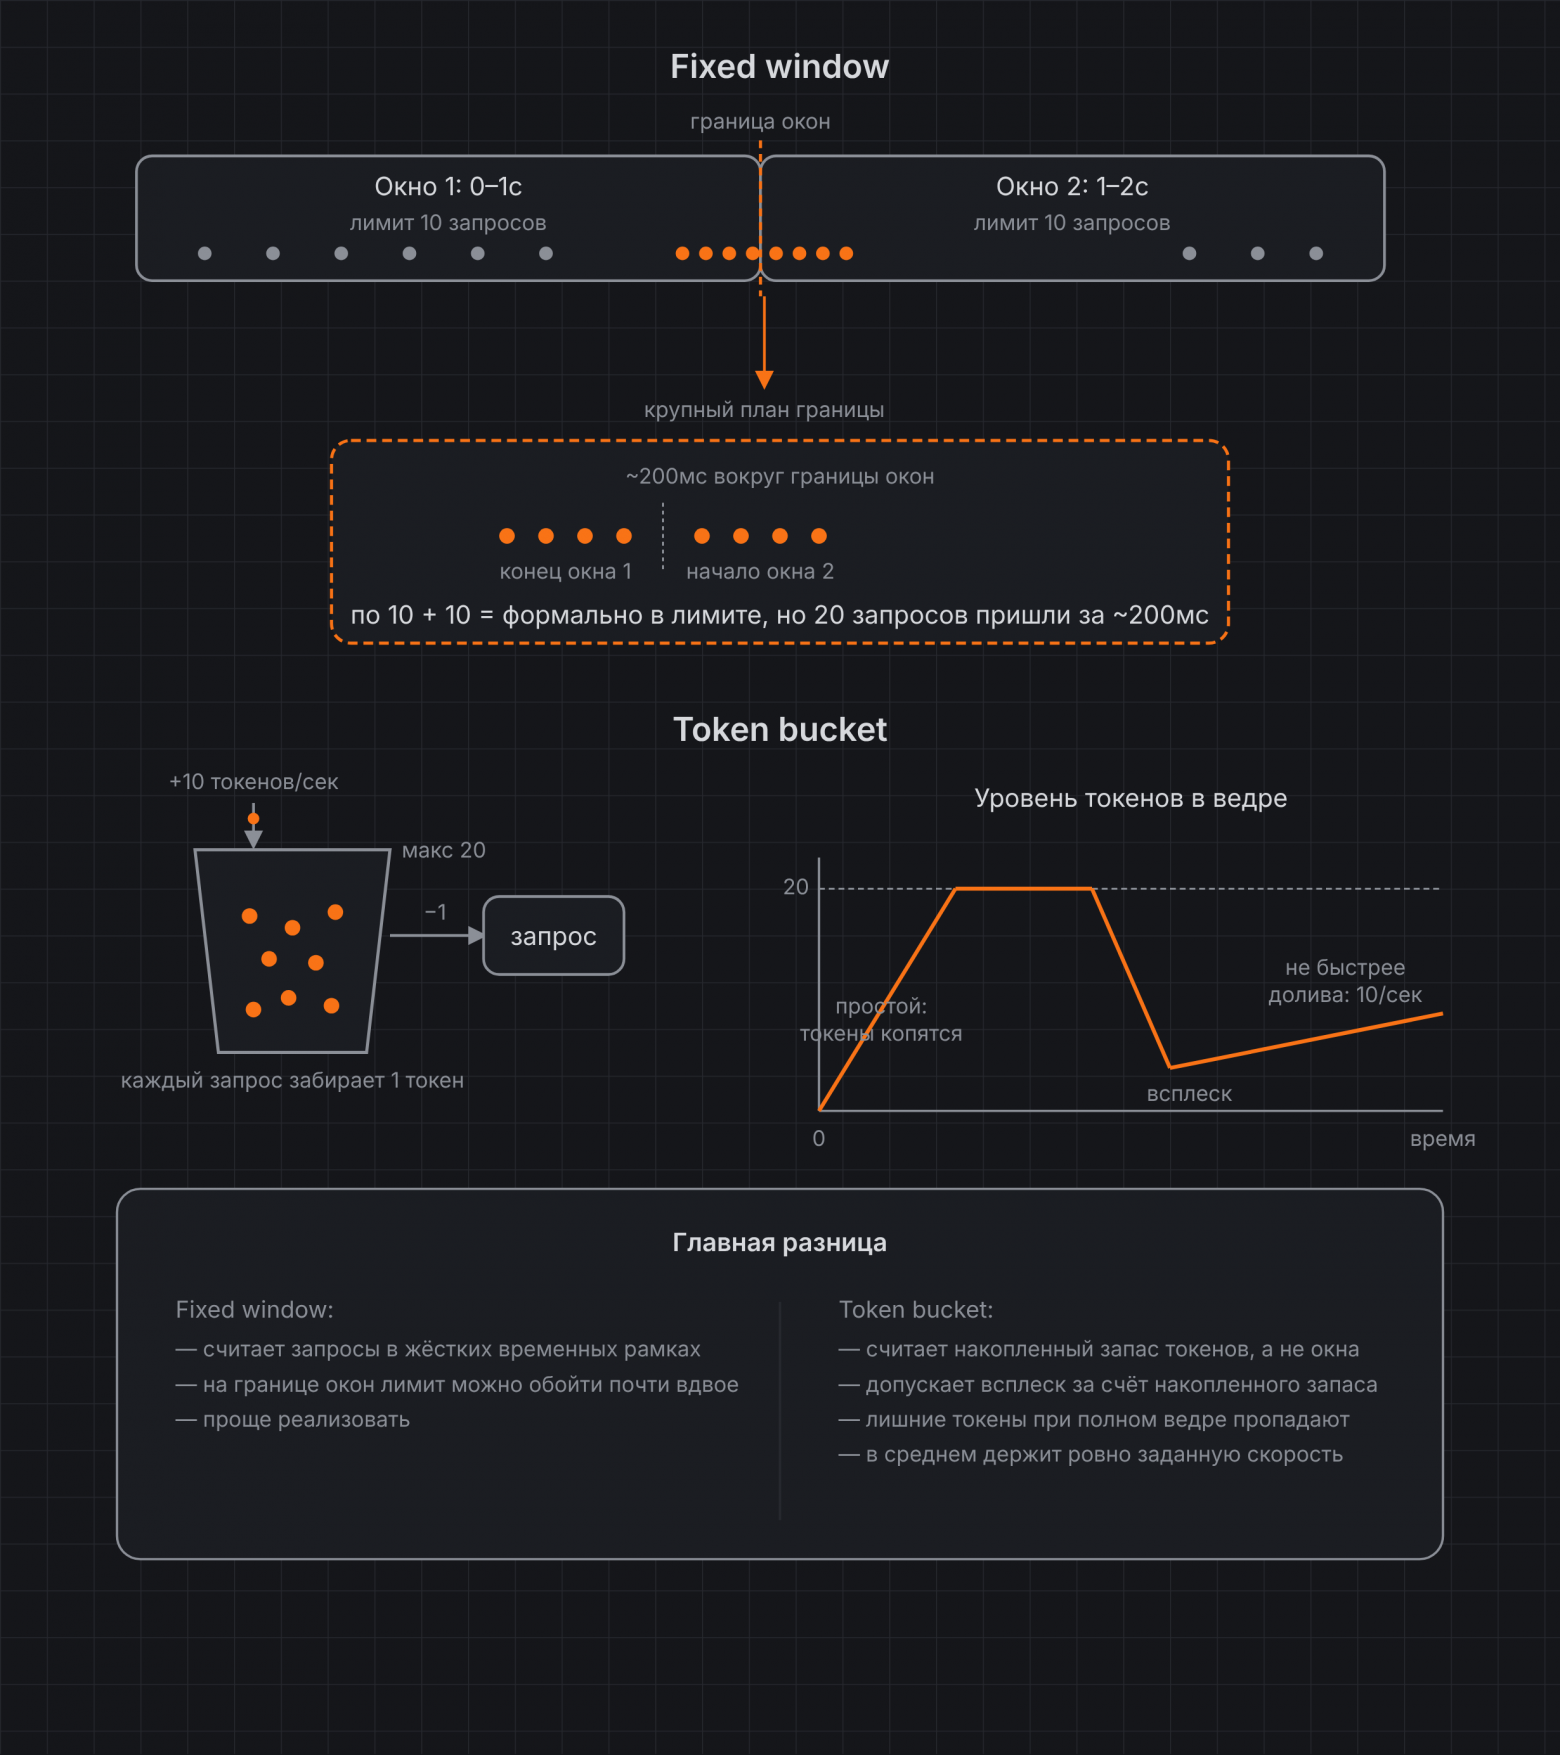
Один из распространённых способов посчитать лимит, fixed window (фиксированное окно). Берём интервал времени, например 1 секунду, и считаем в нём количество запросов. Как только секунда прошла, счётчик обнуляется и начинается новое окно. Если лимит на окно 10 запросов, то 11-й запрос отклоняется.
Проблема в том, что окна жёстко привязаны к времени, а не к самим запросам. Если 10 запросов прилетели в последние 100мс первого окна, а ещё 10 прилетели в первые 100мс следующего окна, формально оба окна уложились в лимит, но фактически за 200мс система приняла 20 запросов вместо 10. Границы окон можно эксплуатировать.
Token bucket (ведро с токенами) устроен иначе. В ведро с постоянной скоростью капают токены, например по 10 токенов в секунду. У ведра есть максимальная вместимость, скажем 20 токенов, лишние токены просто не помещаются и пропадают. Каждый входящий запрос забирает из ведра один токен. Если токен есть, запрос пропускается, если токенов нет, запрос отклоняется.
Разница с fixed window в том, что тут нет жёстких границ окон. Если какое-то время запросов не было, в ведре накопится токенов, и можно будет принять короткий всплеск запросов сразу, пока не кончатся накопленные токены. А если запросы идут равномерно, ведро просто не успевает переполниться, и всё работает как ровный постоянный лимит. Поэтому token bucket лучше справляется с резкими всплесками, не создавая проблему границы окна, которая есть у fixed window.
Если сервис работает в нескольких репликах, локальный счётчик в памяти каждой реплики не подойдёт, лимит у каждой будет свой, и суммарно сервис пропустит в разы больше, чем задумано. Поэтому счётчики хранят централизованно, например в Redis, чтобы лимит был общим для всех реплик сразу.
Отдельный вопрос, что делать, если само хранилище счётчиков недоступно или не ответило вовремя. Тут есть два пути: fail-closed (отклонять все запросы, пока хранилище не починится) или fail-open (пропускать запросы без проверки). Обычно выбирают fail-open, лимитер защищает сервис от перегрузки, а не обеспечивает безопасность, и он не должен сам стать причиной отказа сервиса, если сломался.
Circuit Breaker
Circuit Breaker нужен для того, чтобы не долбить запросами сервис, который уже сломан. Если зависимый сервис лежит, и мы всё равно продолжаем слать к нему запросы (пусть даже с retry и deadline), мы просто тратим время на ожидание таймаутов и добавляем нагрузку сервису, который и так не может подняться.
Идея в том, чтобы отслеживать подряд идущие сбои и, если их становится слишком много, на время вообще перестать стучаться в сервис, а сразу отдавать ошибку вызывающему. Это экономит время (не ждём таймаут по новой на каждый запрос) и даёт сломанному сервису шанс восстановиться без дополнительной нагрузки.
Работает это через три состояния.
Closed, обычное состояние. Запросы идут как обычно, а breaker в фоне считает подряд идущие сбои. Если сбоев подряд набирается больше порога, переходим в open.
Open, аварийное состояние. Запросы вообще не доходят до сервиса, breaker сразу возвращает ошибку. Так продолжается определённое время (таймаут восстановления).
Half-open, пробное состояние. Когда таймаут из open истекает, breaker пропускает несколько пробных запросов, чтобы проверить, ожил ли сервис. Если пробные запросы прошли успешно, breaker возвращается в closed. Если хотя бы один провалился, breaker снова уходит в open, и таймер восстановления запускается заново.
Важный момент, не каждая ошибка должна считаться сбоем сервиса. Если сервис ответил ошибкой валидации или "не найдено", это не значит, что он сломан, это значит, что он в полном порядке и просто корректно обработал запрос. Breaker должен реагировать только на ошибки, которые говорят именно о проблемах инфраструктуры, недоступность, таймаут, внутренняя ошибка сервера, а не на бизнес-ошибки.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.