[ITmedia News] Microsoft、初のストリーミング文字起こしモデル「MAI-Transcribe-2-Streaming」公開 音声合成「MAI-Voice-2.1」と高速版も
米MicrosoftのAI部門Microsoft AI(MAI)は10月1日(現地時間)、同社初のストリーミング型文字起こしモデル「MAI-Transcribe-2-Streaming」と、音声合成(TTS)モデル「MAI-Voice-2.1」、その高速版「MAI-Voice-2.1-Flash」を発表した。いずれも「Microsoft Foundry」でパブリックプレビューとして提供する。人と音声で対話する「音声エージェント」の構築を想定したモデル群だ。
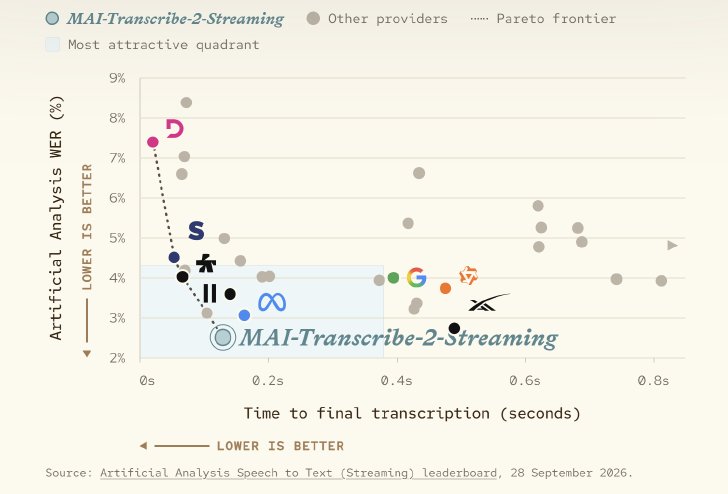
MAI-Transcribe-2-Streamingは、話している最中に文字起こし結果を逐次返す低遅延モデルで、日本語を含む60言語に対応し、話されている言語を自動で判別する。音声の受信から100ミリ秒強で暫定的な認識結果を返し、文脈に応じて修正しながら確定させるため、音声エージェントが相手の発話の途中で処理を始められるという。AI評価機関Artificial Analysisの評価で精度1位になったとしている。料金は年末までの導入価格として音声1時間当たり0.54ドルだ。
MAI-Voice-2.1は23言語に対応する多言語TTSモデル。1つの声のまま言語を切り替えても、各言語のネイティブのアクセントで話せるのが特徴という。料金は100万文字当たり22ドル。高速版のMAI-Voice-2.1-Flashは、45秒の音声を150ミリ秒の遅延で生成でき、同等のモデルと比べて約60%安価だとしている。料金は100万文字当たり15ドルという設定だ。
2つのVoiceモデルは、数秒の参照音声から声を複製する機能も備えるが、利用には審査を経たアクセス承認が必要で、本人の同意を得た声しか合成できない仕組みを組み込んだとしている。なお、発表文に掲載されている既定音声の一覧には、現時点で日本語は含まれていないが、モデルの提供リージョンには東日本(Japan East)も含まれる。
3モデルはFoundryのほか、「MAI Playground」やVercelなどでも利用でき、MAI Playgroundでは3モデルを組み合わせた音声エージェントのデモ「Chatter」も公開されている。日本語で話しかけると内容を認識するものの、応答の設定に日本語はなく、例えば英語で返答する仕様だ。
音声AIを巡っては、米OpenAIが5月にストリーミング文字起こし向けの「GPT-Realtime-Whisper」を、米Googleが9月に会話を止めずに裏でタスクを実行できる「Gemini 3.8 Live」を発表している。米Metaも昨年11月に、1600以上の言語に対応する音声認識「Omnilingual ASR」をオープンソースで公開している。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.