画像や音声も処理できる意思決定モデル「d1.2」「d1.2-ultra」が登場
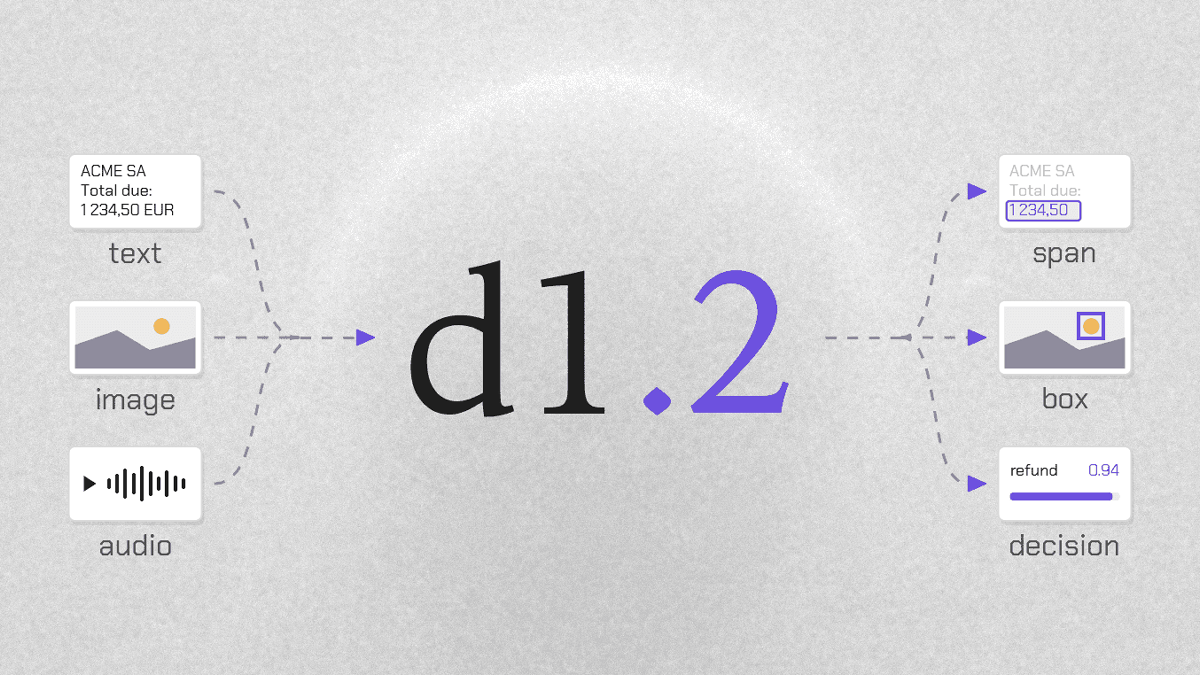
AI企業のLiquid AIがマルチモーダル意思決定モデル「d1.2」と「d1.2-ultra」を現地時間の2026年11月16日にリリースしました。
d1.2: State-of-the-Art Omnimodal Decision Models | Blog | Liquid AI
https://www.liquid.ai/blog/d1-2
— Liquid AI (@liquidai) November 16, 2026Today, we release d1.2 and d1.2-ultra, the state-of-the-art omnimodal decision models. d1.2 and d1.2-ultra both can process text, images, and audio with new output capabilities.
> #1 on the @ArtificialAnlys Decision Index (75)
> Read a value from the input (text, number or date)… pic.twitter.com/xP7TcrmMnE
d1.2とd1.2-ultraは入力内容に対する判断を信頼度スコア付きで出力できる意思決定モデルです。テキスト・画像・音声の入力に対応したマルチモーダルモデルであることも大きな特徴です。
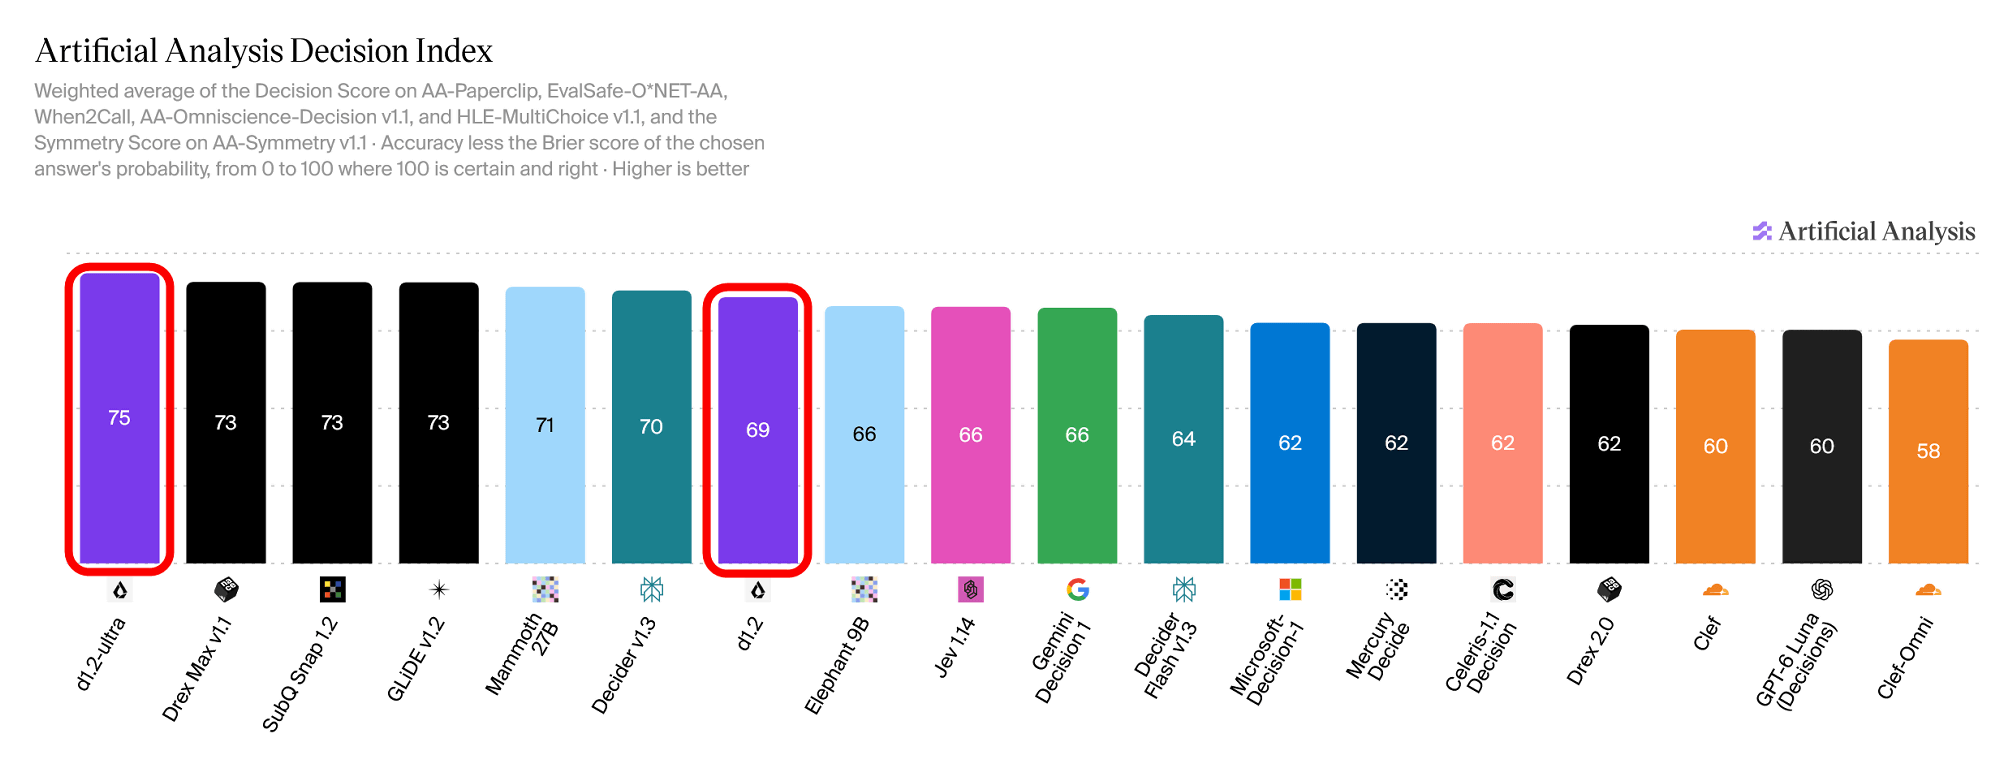
d1.2は低コストモデルで、d1.2-ultraは高コスト・高精度モデルです。意思決定モデルの性能指標であるArtificial Analysis Decision Index v2.1ではd1.2-ultraが「75」というスコアを記録してトップにランクイン。d1.2もJev 1.14を上回りました。
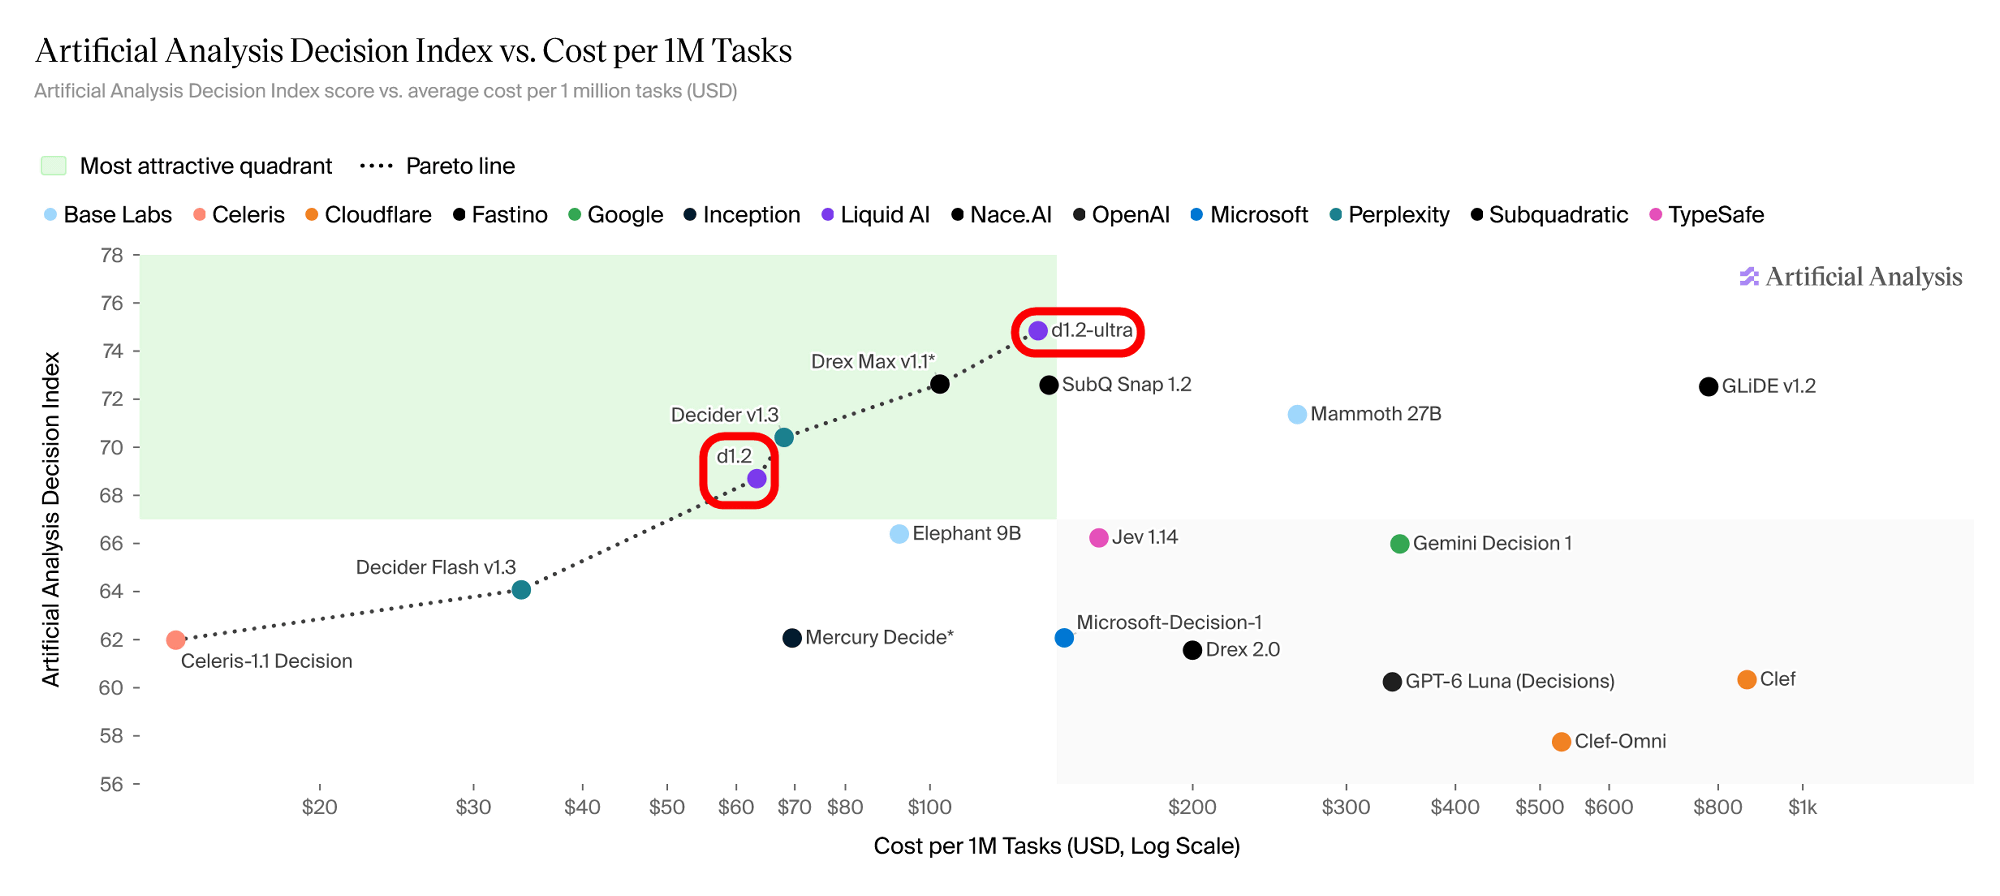
入力100万トークン当たりのAPI料金はd1.2が0.02ドル(約3.2円)、d1.2-ultraが0.042ドル(約6.7円)です。以下のグラフは横軸がコスト、縦軸が性能を示しており、d1.2とd1.2-ultraが同等コストのモデルの中で最高性能のモデルであることが分かります。
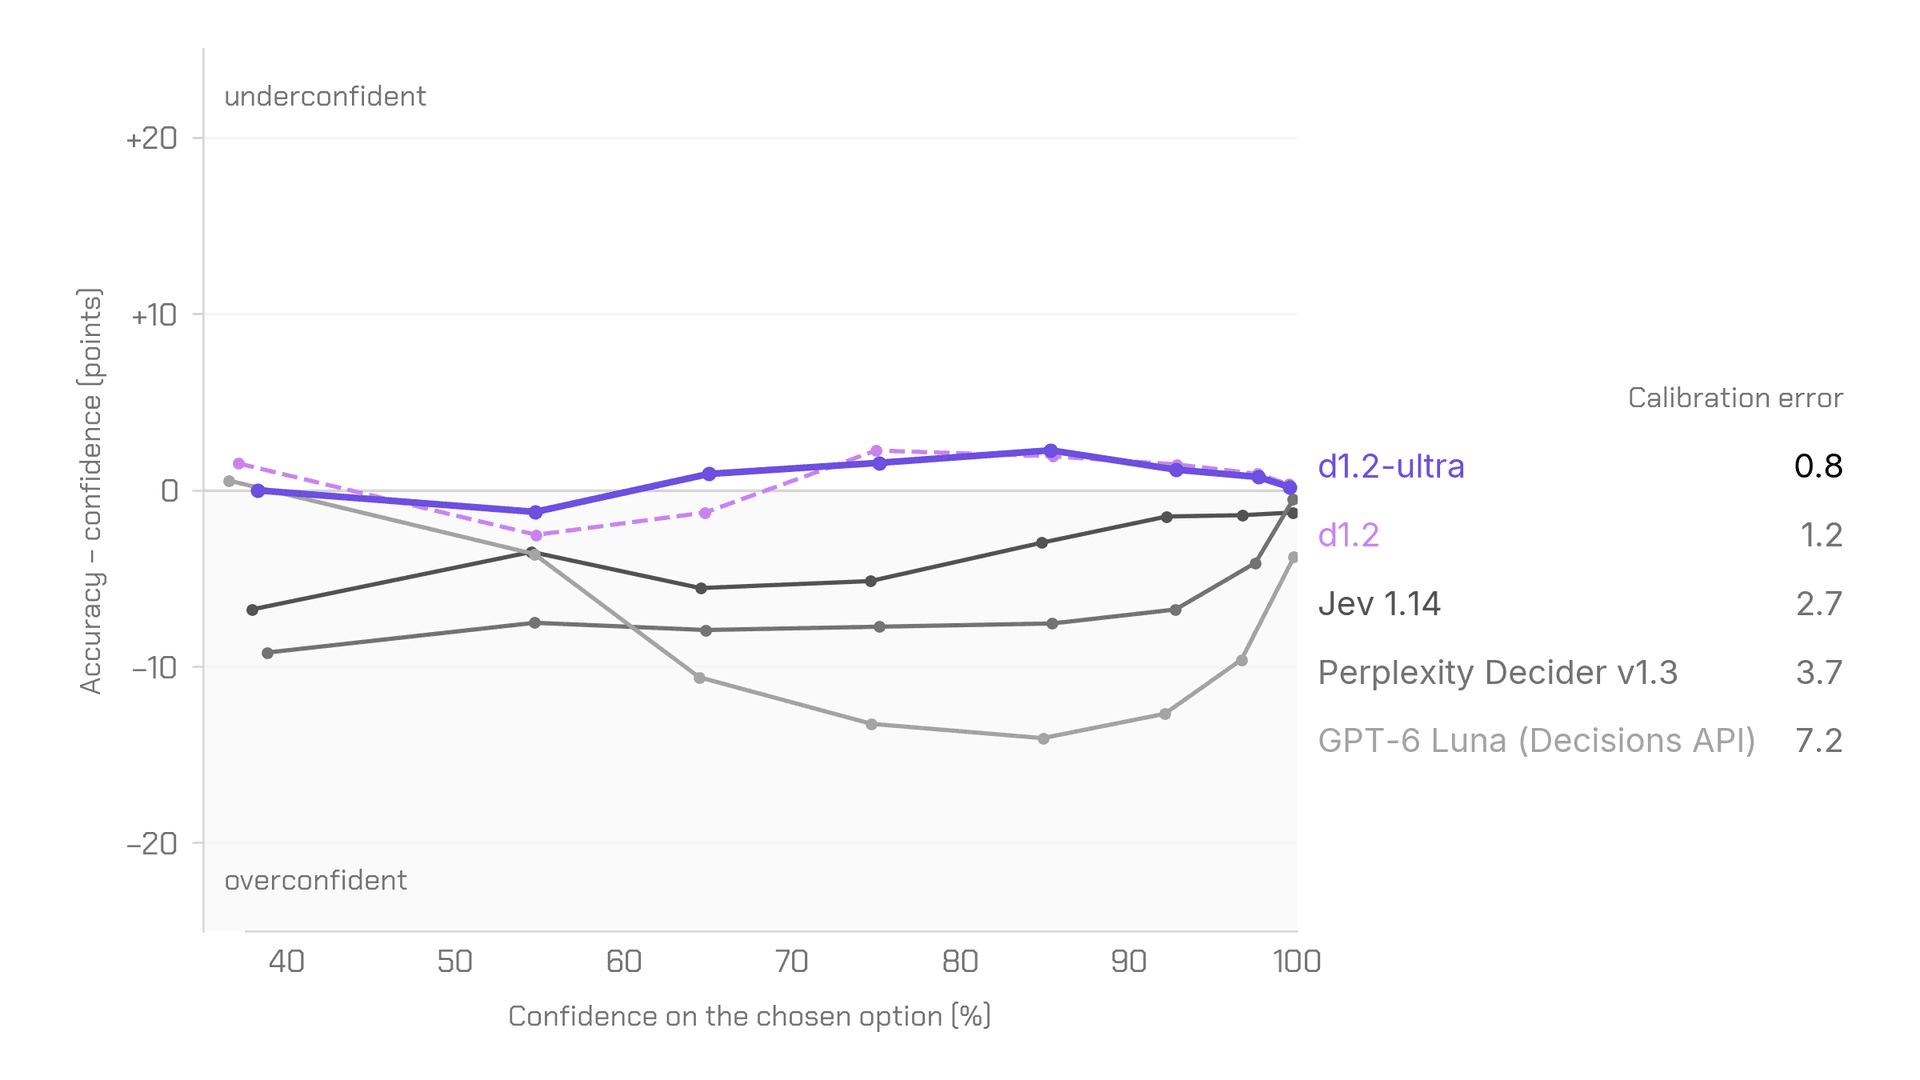
意思決定モデルでは信頼度スコアの正確性も重要です。Liquid AIによると、d1.2とd1.2-ultraはJev 1.14よりも正確性が高いとのこと。
d1.2とd1.2-ultraのAPIにはモデルを活用するための5種類の機能が追加されています。各機能の概要は以下の通り。
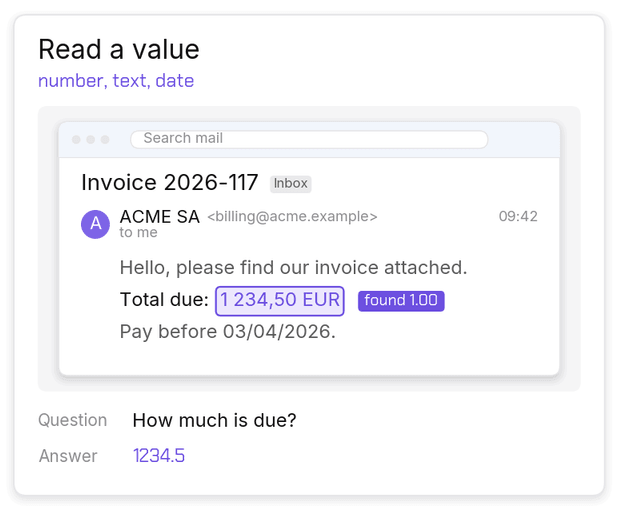
・値を読み取る
テキストに含まれるテキスト・数値・日付などの値を読み取る機能です。例えば請求書とともに「料金はいくら?」と入力すると料金を読み取って出力してくれます。
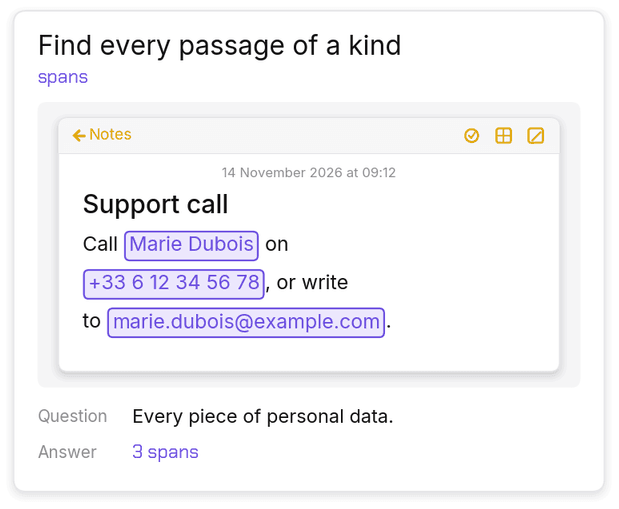
・テキスト内の特定の部分の個数を読みとる
テキスト内に条件に沿った部分が何カ所あるかを読みとります。以下の例の場合は「個人情報は何個含まれている?」という質問に対して「3カ所」と返答しています。
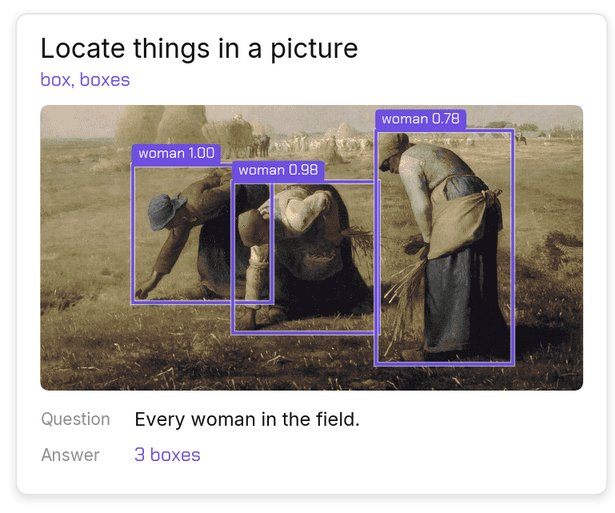
・画像内の位置特定
画像内の特定の物体を枠で囲むことができます。
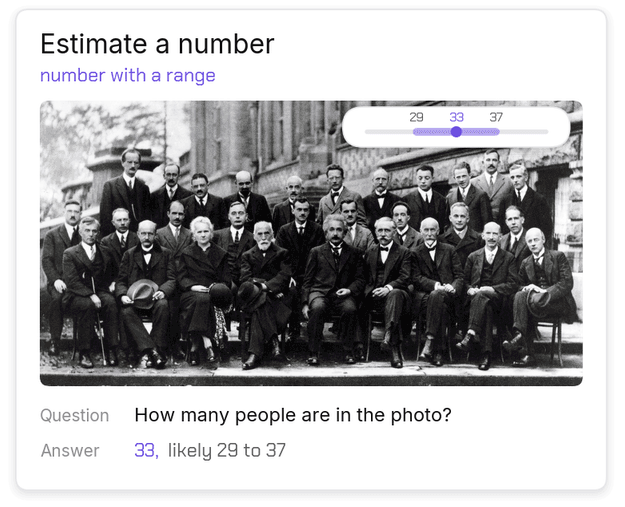
・計数
画像内の特定の物体の数を推定します。出力には「最も可能性の高い数」と「可能性の高い範囲」の両方が含まれます。以下の例では「写真には何人写っている?」という質問に対して「33人」「29人~37人」という結果を返しています。
・該当するすべての選択肢を提示
質問に対する回答を選択肢から複数選択して出力します。例えば「二重請求されたし、荷物がまだ届かない」という問い合わせ文章について「問い合わせのカテゴリは何?」と質問すると「支払い」「配達」という2種類のカテゴリを返してくれます。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.