Tenemos un nuevo "benchmark" para la IA: preguntarle si has montado correctamente tus muebles de Ikea o no
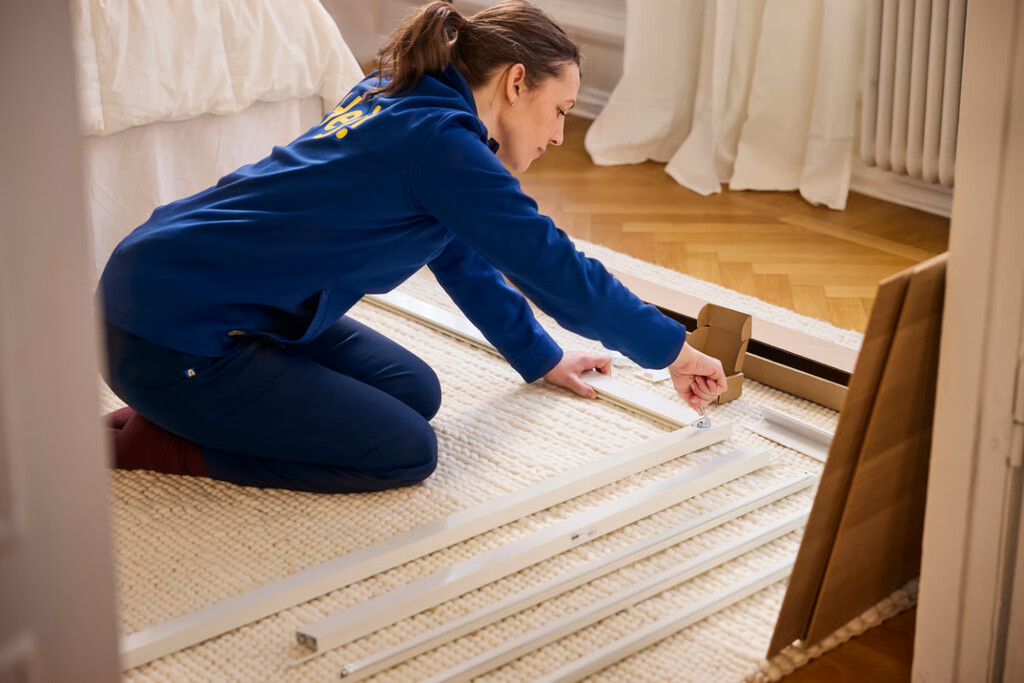
A Epoch AI la conocemos por su ambicioso benchmark matemático para la IA, pero sus responsables tuvieron hace tiempo una idea de lo más original. Compraron tres muebles de IKEA, empezaron a montarlos y de vez en cuando hicieron algo mal a propósito. Luego sacaron fotos y se las enseñaron a distintos modelos de IA junto con el manual de instrucciones. La misión de la IA era decidir si el mueble estaba bien montado y si no, encontrar dónde se había encontrado el error. Tenemos una buena noticia: han mejorado a lo grande en eso.
De un 28% a un 80% en apenas diez meses. El dato es sorprendente, porque la mejora de los modelos en el llamado Furniture Assembly Benchmark (FAB) es notable. En noviembre de 2025 el mejor modelo de IA en esta prueba era Claude 4,5, y lograba un 28% de aciertos. En septiembre de 2026 GPT-6 Astra logró el 80%, y no solo acertó mucho más: necesitó una media de tres minutos por foto, entre dos y diez veces menos tiempo que modelos que anteriormente estaban entre los mejores.

No basta "mirar" una foto. Lo modelos reciben una fotografía del mueble medio montado, el manual oficial de IKEA, una herramienta para ampliar zonas de la imagen y un intérprete de Python. A partir de ahí debe relacionar los diagramas del manual con piezas reales fotografiadas desde ciertos ángulos concretos. El objetivo: reconstruir qué pasos ha seguido la persona que ha montado el mueble y detectar cosas como una pieza colocada al revés. Epoch incluso continuaba montajes después de introducir el fallo para que ese error no fuese necesariamente el último paso visible y así ponérselo más difícil a la IA.
IKEA es solo una excusa. Lo que Epoch AI quiere medir es la capacidad de razonamiento abstracto de los modelos de IA. Es decir, si son capaces de conectar instrucciones abstractas (de los manuales de IKEA, en este caso) con objetos del mundo real. Es una habilidad crítica para que algún día un modelo de IA nos pueda ayudar a reparar un electroméstico on un coche siguiendo documentación técnica. Es fácil evaluar modelos en matemáticas o en programación, pero no lo es en absoluto cuando se trata de evaluar visión o razonamiento espacial y su aplicación a nuestro mundo.
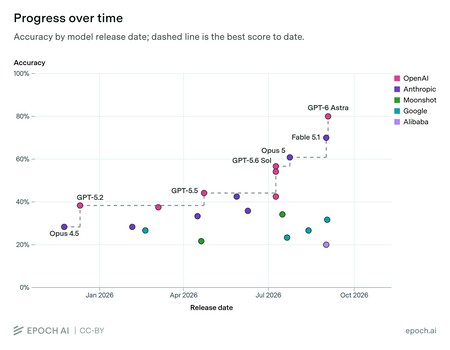 Fuente: Epoch AI.
Pero estamos lejos de robots que nos monten los muebles. Este FAB analiza si una IA puede observar el trabajo hecho por una persona y verificarlo, pero no si puede planificar y ejecutar todo el proceso físicamente desde cero. Así, puede reconocer que una pieza está invertida cuando tenemos delante el manual y tiene una foto para estudiar la situación. Sin embargo eso es muy distinto a que una máquina pueda manipular las piezas, resolver imprevistos y lograr montar correctamente un mueble.
Falsos positivos. Además, Epoch AI encontró distintos sesgos según la familia de modelos utilizada. Gemini y Qwen tendían a asumir que siempre había fallos y encontraban errores que no existían. Modelos anteriores de OpenAI y Anthropic sufrían el problema contrario: daban por buenos montajes que contenían errores. El proceso demostró que era tan importante buscar errores en el montaje como saber cuándo dejar de buscarlos.
Vuelve Moravec. El experimento deja una curiosidad ya observada: estamos aprendiendo a medir cada vez mejor cómo los modelos de IA resuelven problemas con una solución que luego podemos verificar. El problema es medirlas cuando el proceso es más ambigüo. Volvemos a la vieja paradoja de Moravec: la inteligencia artificial hace fácil lo difícil y viceversa.
En Xataka | El mundo se está quedando sin datos para seguir entrenando a la IA. China tiene un as en la manga
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.