Один адрес на все хранилища, или как я перестал бояться переездов S3
У меня несколько кластеров Ceph с S3, они стоят в разных ЦОД, и у каждого свой адрес, свои пользователи и свои ключи.
Пока кластер один, жизнь прекрасна, но когда их становится пять, начинается то, что я про себя называю адресной бухгалтерией.
Это такая бухгалтерия, где вместо денег адреса, а вместо налоговой разработчики, которые хотят знать, куда им ходить.
В этой статье расскажу, как я устал от этой бухгалтерии, написал свой балансер для S3 и что он в итоге умеет.
Будет немного боли, немного архитектуры и немного машинок.
С чего всё началось
Разговор в рабочем чате мог выглядеть примерно так.
Приходит разработчик и спрашивает адрес хранилища, я уточняю, с какого кластера у него ключи, а он отвечает, что ключи ему когда-то выдал коллега, у которого уже не спросишь.
Дальше начинается археология, в ходе которой мы выясняем, на каком кластере живёт этот ключ, прописываем адрес в конфиг сервиса, и всё работает ровно до первого переезда.
Иногда эта археология идёт дольше раскопок Трои, а находки примерно те же, черепки старых конфигов и надписи на языке, которого уже никто не помнит.
А переезды случаются регулярно, потому что железо стареет, ЦОД закрываются, а иногда кто-то решает, что данным будет лучше в другом месте.
Каждый раз у кластера меняется адрес, и приходится обходить все сервисы, которые туда ходят, и менять им конфиги.
Сервисов много, команды разные, у каждой свой релизный цикл, а у кого-то релиз раз в квартал, причём по пятницам.
Собрать их всех перед переездом примерно как собрать родню на юбилей, кто-то в отпуске, кто-то не отвечает, а кто-то обиделся ещё с прошлого раза.
Обиднее всего то, что сервисам вообще не нужно знать, на каком кластере лежат их данные, им нужно положить файл и потом его забрать.
Всё остальное это наши внутренние проблемы, которые мы зачем-то сделали проблемами всех вокруг.
Идея
Идея пришла довольно простая, пусть у всех будет один адрес, а куда отправить запрос дальше, решаем уже мы.
Как в хорошем ресторане, гость заказывает блюдо, а не выбирает плиту, на которой его будут готовить.
Оставалось понять, как по запросу определить нужный кластер, и тут S3 сам подкладывает подсказку.
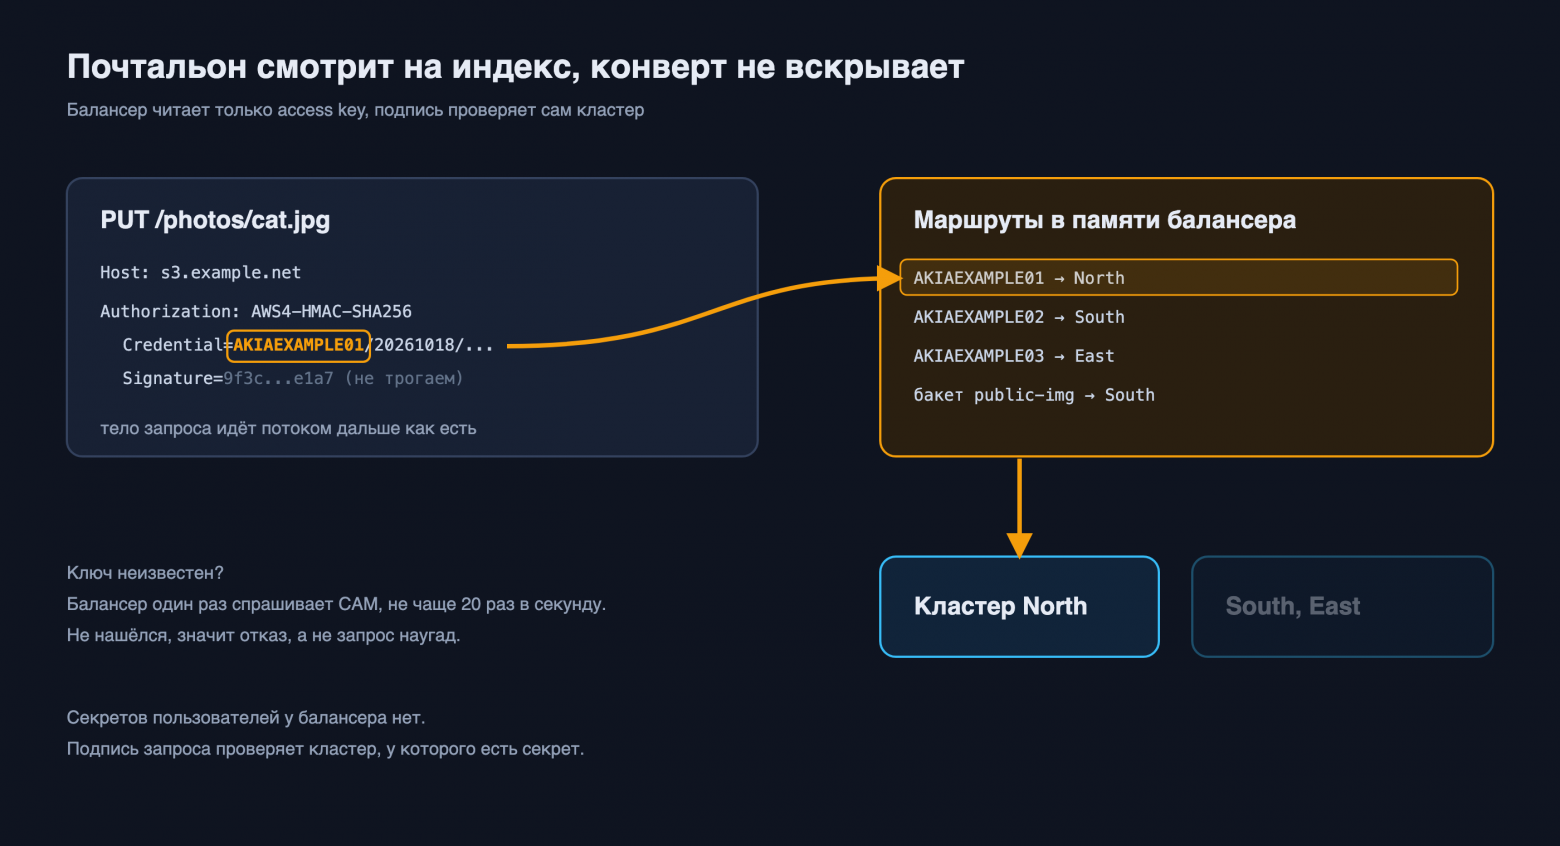
В каждом подписанном запросе открытым текстом лежит access key, а секрета там нет.
Обычно ключ стоит в заголовке Authorization рядом с подписью, а в ссылках с подписью он записан прямо в адресе.
И каждый ключ, как правило, живёт только на одном кластере.
Получается, что балансеру достаточно достать ключ из запроса, найти его в таблице и отправить запрос на нужный кластер, не трогая ни тело запроса, ни подпись.
Подпись проверяет сам кластер, у которого есть секрет, а балансер работает как почтальон, который смотрит на индекс на конверте и не лезет внутрь.
Такой почтальон мечта любого параноика, адрес видит, а писем не читает.
Этот момент я очень ценю, потому что балансеру не нужны секретные ключи пользователей, он их не хранит и не видит.
Если его взломают, данных пользователей и их секретов там не окажется, а табличка с тем, какой ключ на каком кластере живёт, это неприятно, но далеко не катастрофа.
Откуда балансер знает маршруты
Таблицу маршрутов ведёт CAM, это моя панель управления хранилищем, через которую создаются пользователи, ключи и бакеты.
Когда пользователя заводят через CAM, маршрут его ключа появляется сразу, а когда ключ удаляют или меняют, маршрут обновляется вместе с ним.
Но жизнь сложнее любой панели, кто-то создаёт пользователей руками через radosgw-admin, а кто-то генерирует ключи скриптом в обход всего.
Поэтому раз в десять минут CAM проходит по кэшу пользователей и бакетов со всех кластеров и дописывает недостающие маршруты.
Ручные маршруты он при этом не трогает, а спорные ключи, которые нашлись сразу на двух кластерах, пропускает и показывает отдельно, чтобы решение принял человек.
Если запрос пришёл с ключом, которого в таблице нет, балансер один раз спрашивает у CAM, где этот ключ живёт, но делает это не чаще двадцати раз в секунду, чтобы какой-нибудь бот с перебором ключей не устроил нам нагрузочное тестирование панели.
Панель у меня одна, и пусть она тратит силы на людей, а не на ботов-кладоискателей.
Что делать с ключом, который так и не нашёлся, решает настройка.
Можно отправлять такие запросы на кластер по умолчанию, это удобно, пока таблица только заполняется, а когда маршруты есть у всех, балансер переводится в режим отказа, потому что отправлять неизвестно кого неизвестно куда я не люблю.
Для ключей, по которым были промахи, есть отдельная карточка, где видно, кто стучится с неизвестным ключом, с какого IP и в какой бакет.
В таком списке легко найти забытые сервисы и тестовые стенды, о которых все давно забыли, кроме самих стендов.
Стенды, к слову, очень не любят, когда их находят, и тут же оказываются кому-то срочно нужны.
Запросы клиентов не ходят в базу
С самого начала я поставил себе жёсткое правило, что запрос клиента никогда не обращается к базе данных.
База данных существо нежное, и тревожить её ради каждой картинки с котиком я не готов.
Балансер держит весь снимок маршрутов у себя в памяти и раз в пять секунд спрашивает у CAM, не поменялась ли версия.
Если версия прежняя, CAM отвечает коротко и снимок целиком не пересылает, а когда маршруты меняются, CAM сам просит реплики перечитать снимок, не дожидаясь следующего опроса.
Из этого получается приятное следствие, если CAM недоступен, балансер продолжает работать на последнем снимке, и клиенты ничего не замечают.
Снимок к тому же сохраняется на диск, так что даже перезапущенная реплика поднимется без CAM.
Новые маршруты в это время, конечно, не появятся, но всё, что работало, работать продолжит.
Публичные бакеты
Анонимные запросы устроены иначе, ведь у публичного бакета ключа нет и скачать из него картинку может кто угодно, так что искать ключ в запросе бесполезно.
По бакету же маршрутизируются и запросы с временными ключами STS, которых нет ни в одной таблице.
Для таких запросов балансер смотрит на имя бакета, которое есть либо в пути, либо в имени хоста, если клиент обращается по виртуальным хостам.
У CAM для этого есть вторая таблица, где бакет связан с кластером, и заполняется она тоже автоматически.
Веселее всего становится, когда бакет с одинаковым именем есть на двух кластерах, и да, так бывает, и да, оба называются test.
Иногда рядом ещё лежит test2, видимо, для надёжности.
Угадывать в таком случае балансер не станет, он ответит, что не знает, а в CAM достаточно один раз задать явный маршрут.
Ради чего всё затевалось
Теперь про переезд, и тут сразу оговорюсь, что телепортировать данные балансер не умеет.
Я пробовал его уговорить, но он упёрся и сослался на законы физики.
Он убирает одну конкретную боль, правку адресов и ключей во всех сервисах, а за то, чтобы к моменту переключения данные уже лежали на новом кластере, по-прежнему отвечаем мы.
Если сервис пишет мало или давно ничего не пишет, всё довольно просто.
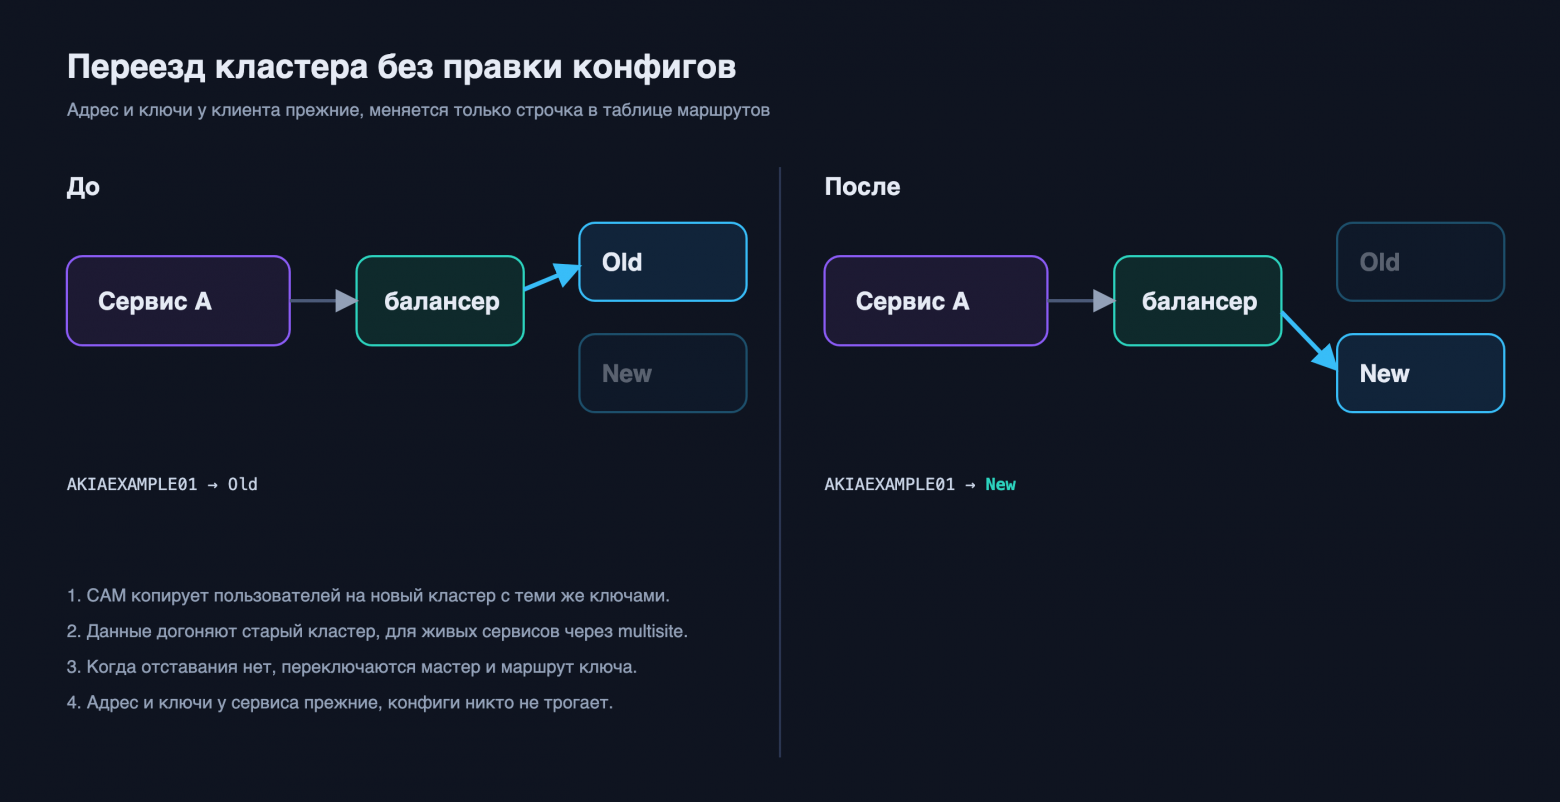
CAM копирует пользователей на новый кластер с теми же ключами, данные копируются, последним проходом досинхронизируется то, что успело измениться, и после этого переключается маршрут ключа.
С сервисами, которые постоянно пишут и читают, так не получится, потому что между последней копией и переключением на старый кластер обязательно что-нибудь запишется и потеряется.
Для них новый кластер сначала добавляется репликой в multisite к старому, и Ceph сам перетягивает туда и старые данные, и все новые записи.
Когда CAM показывает, что реплика догнала мастер и отставания нет, мы переключаем мастера группы, балансер начинает отправлять запросы на новый кластер, а клиенты продолжают ходить на тот же адрес.
Сам момент переключения всё равно есть, и про него лучше заранее предупредить владельца сервиса.
Но это несколько минут в согласованное окно, а не квартал правок конфигов, релизов и писем всем командам.
После переключения для клиента не меняется ничего, адрес тот же, ключи те же, конфиги трогать не нужно.
Сервис продолжает класть и забирать файлы, и только по графикам видно, что его запросы теперь уходят в другое место.
Если переключать всех разом страшно, маршруты можно переводить постепенно, по одному пользователю или выбранной группе через массовое изменение маршрутов, начиная с тех, чьи данные уже на месте.
Если ничего не загорелось, переводим следующих, а если загорелось, так же быстро возвращаем маршрут назад и идём пить чай с валерьянкой.
Multisite и отказ мастера
Часть кластеров у нас связана в multisite, где есть мастер и реплики, метаданные синхронизируются, и на реплике лежат те же пользователи с теми же ключами.
Для балансера это ловушка, ведь каждый ключ вдруг оказывается сразу на двух кластерах.
Как близнецы на паспортном контроле, лица одинаковые, а отвечать должен кто-то один.
Поэтому такие пары объявляются в CAM группой, которую балансер считает одним домом.
Обычно все запросы идут на мастер.
Если мастер перестал отвечать, чтение балансер сам переводит на реплику.
Запись уходит на реплику, только если это разрешено для группы в CAM, причём решение одно на все реплики балансера, чтобы при сетевых проблемах один экземпляр не писал в мастер, а другой в реплику.
Начатые multipart-загрузки при этом доезжают в ту зону, где начались, потому что незавершённую загрузку multisite не реплицирует.
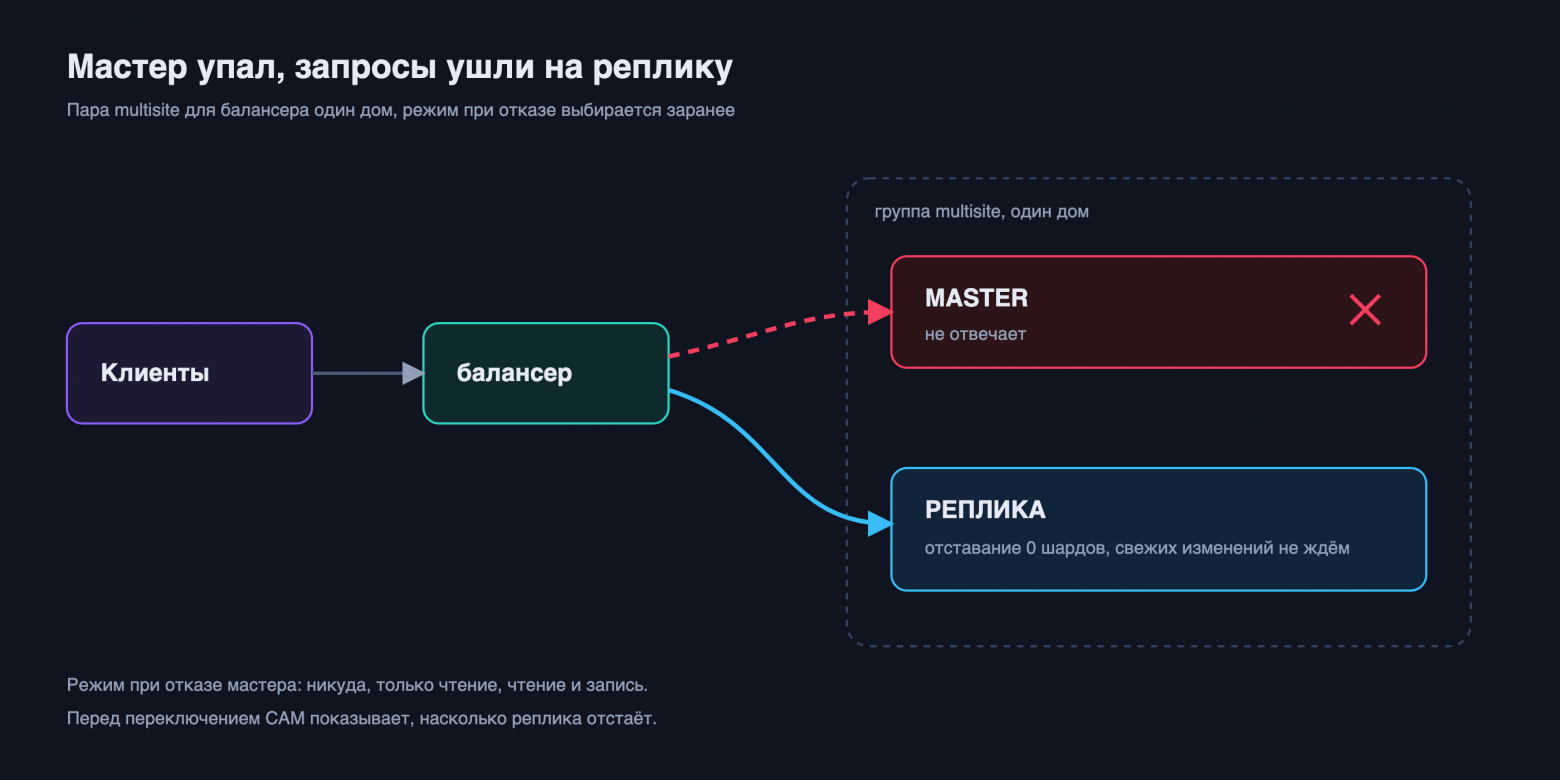
Перед тем как переключиться вручную или включить автоматический переход, CAM показывает, насколько реплика отстаёт, сколько шардов ещё не догнали мастер и когда было самое старое неприменённое изменение.
Это спасает от ситуации, когда переключились, а свежих файлов на новом месте нет, и почему-то такие ситуации всегда обнаруживаются в три часа ночи.
Балансер тоже не должен падать
Сделать один адрес на все хранилища и поставить за ним одну машину было бы смешно, потому что это уже не балансер, а единая точка отказа с красивым названием.
Реплик несколько, стоят они на разных нодах.
Снаружи общий виртуальный адрес держит L4-балансировщик на Katran и раскидывает соединения по нодам, а дальше шлюз на ноде отправляет запросы только в те реплики, которые отвечают на проверку готовности.
Если нода умирает, планировщик поднимает реплику на запасной ноде, а чтобы и Katran сам переставал слать соединения на мёртвую ноду, на VIP нужна проверка приложения, которую тоже можно настроить из CAM.
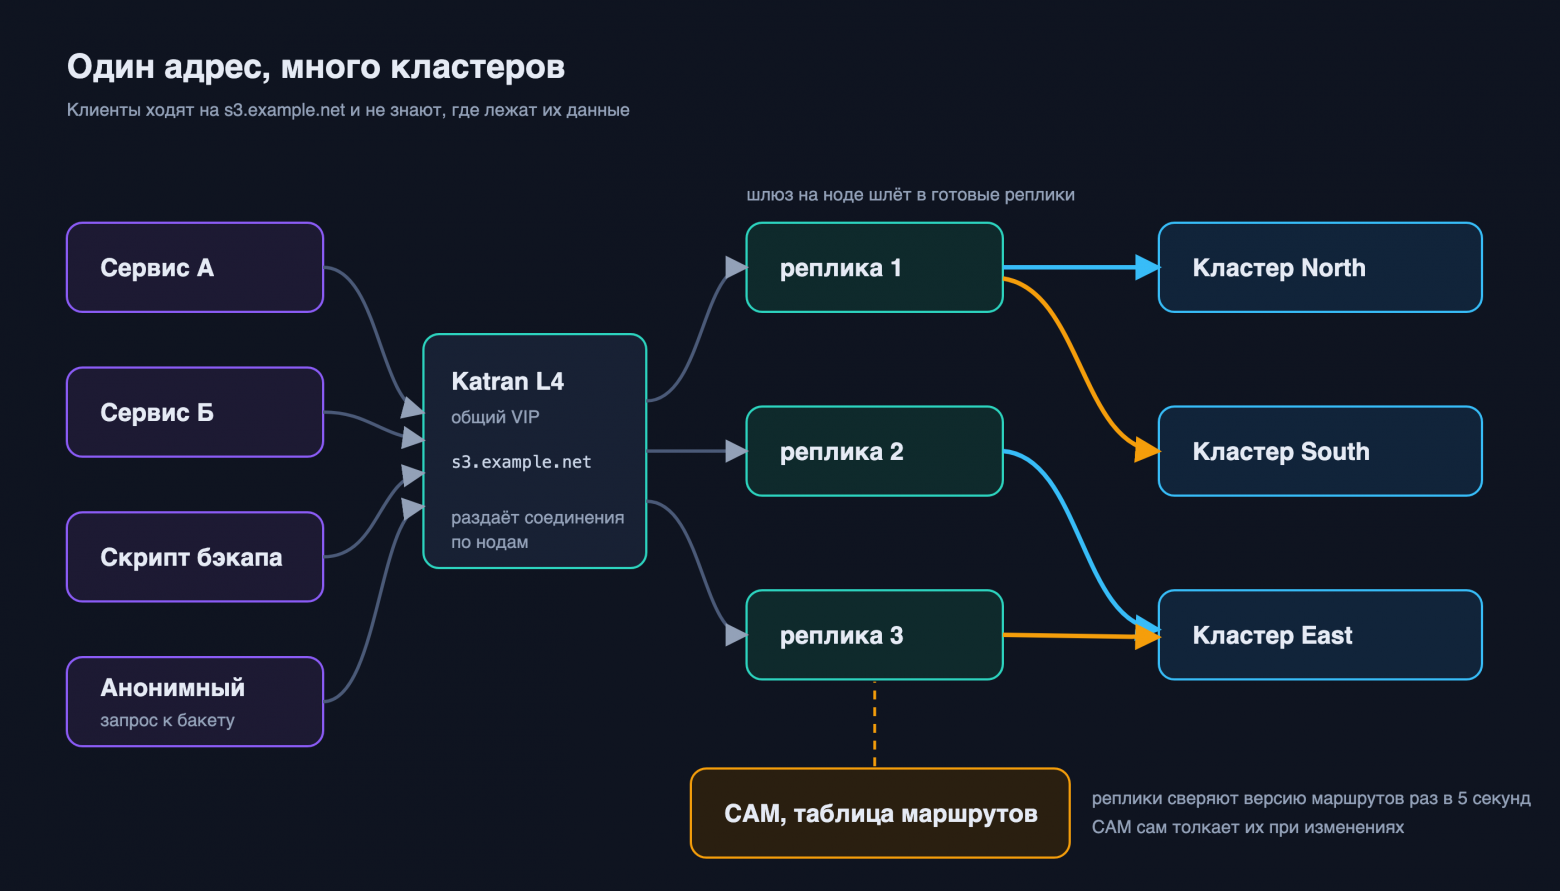
Реплику можно вывести на обслуживание кнопкой, и она начинает отвечать на проверку готовности, что не готова.
Через 15-30 секунд новые запросы перестают к ней приходить, а начатые она дообслуживает до конца.
Последнюю живую реплику CAM на обслуживание без отдельного подтверждения не отпустит, иначе трафику просто некуда будет идти.
Новые реплики сами сообщают CAM свой адрес, так что вписывать их куда-то руками не нужно.
Мелочь, но именно такие мелочи обычно забываются в пятницу вечером.
Большие файлы
С большими объектами пришлось повозиться отдельно.
Балансер не ограничивает размер запроса и не складывает тело в память, а перекачивает поток в обе стороны небольшим буфером, так что многогигабайтный файл проходит через него как вода через трубу.
Главное, чтобы на том конце трубы его кто-то ждал.
Зато я наступил на таймаут, о котором раньше не думал.
После того как клиент отправил последний кусок multipart-загрузки, кластеру нужно время, чтобы собрать файл целиком, и на больших объектах это занимает минуты, а у балансера ожидание ответа было ограничено шестьюдесятью секундами.
В итоге клиент загружал всё до последнего байта и получал ошибку, хотя файл на самом деле собирался.
Это примерно как прийти в ресторан, сделать заказ и через минуту уйти с криком, что тут не кормят.
Таймаут подняли до пятнадцати минут, а все звенья перед балансером настроили так, чтобы поток мог жить хоть сутки.
Что видно глазами
Мне всегда мало того, чтобы всё работало, хочется видеть, что происходит, причём не через три клика в Grafana, а там же, где этим управляешь.
На странице балансера есть живой трафик, где за последние секунды виден каждый клиент по ключу, по IP или по бакету, сколько он читает и пишет и сколько делает операций.
Это очень помогает найти героя, который положил кластер своим ночным бэкапом.
Чаще всего героя зовут cron, и он искренне уверен, что ночью никому не мешает.
В журнале ошибок у каждой записи сохранён идентификатор запроса, поэтому разработчик может прийти с номером из своего лога и увидеть, что произошло и на каком кластере.
Есть история примерно за две недели, чтобы отвечать на вопрос, что же было во вторник, и вкладка с нодами, где видны процессор, сеть, диски, SMART и состояние RAID.
Если с нодой что-то не так, приходит оповещение, а когда всё починили, приходит второе, чтобы можно было выдохнуть.
Карта трафика, или где я немного увлёкся
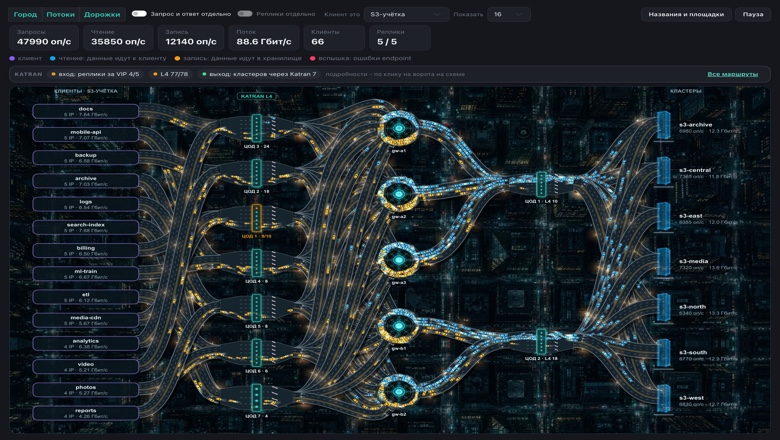
Признаюсь, здесь я немного увлёкся, потому что хотелось сделать картинку, по которой с одного взгляда понятно, кто куда ходит.
Ну как немного, примерно как человек, который вышел за хлебом и вернулся с дрелью.
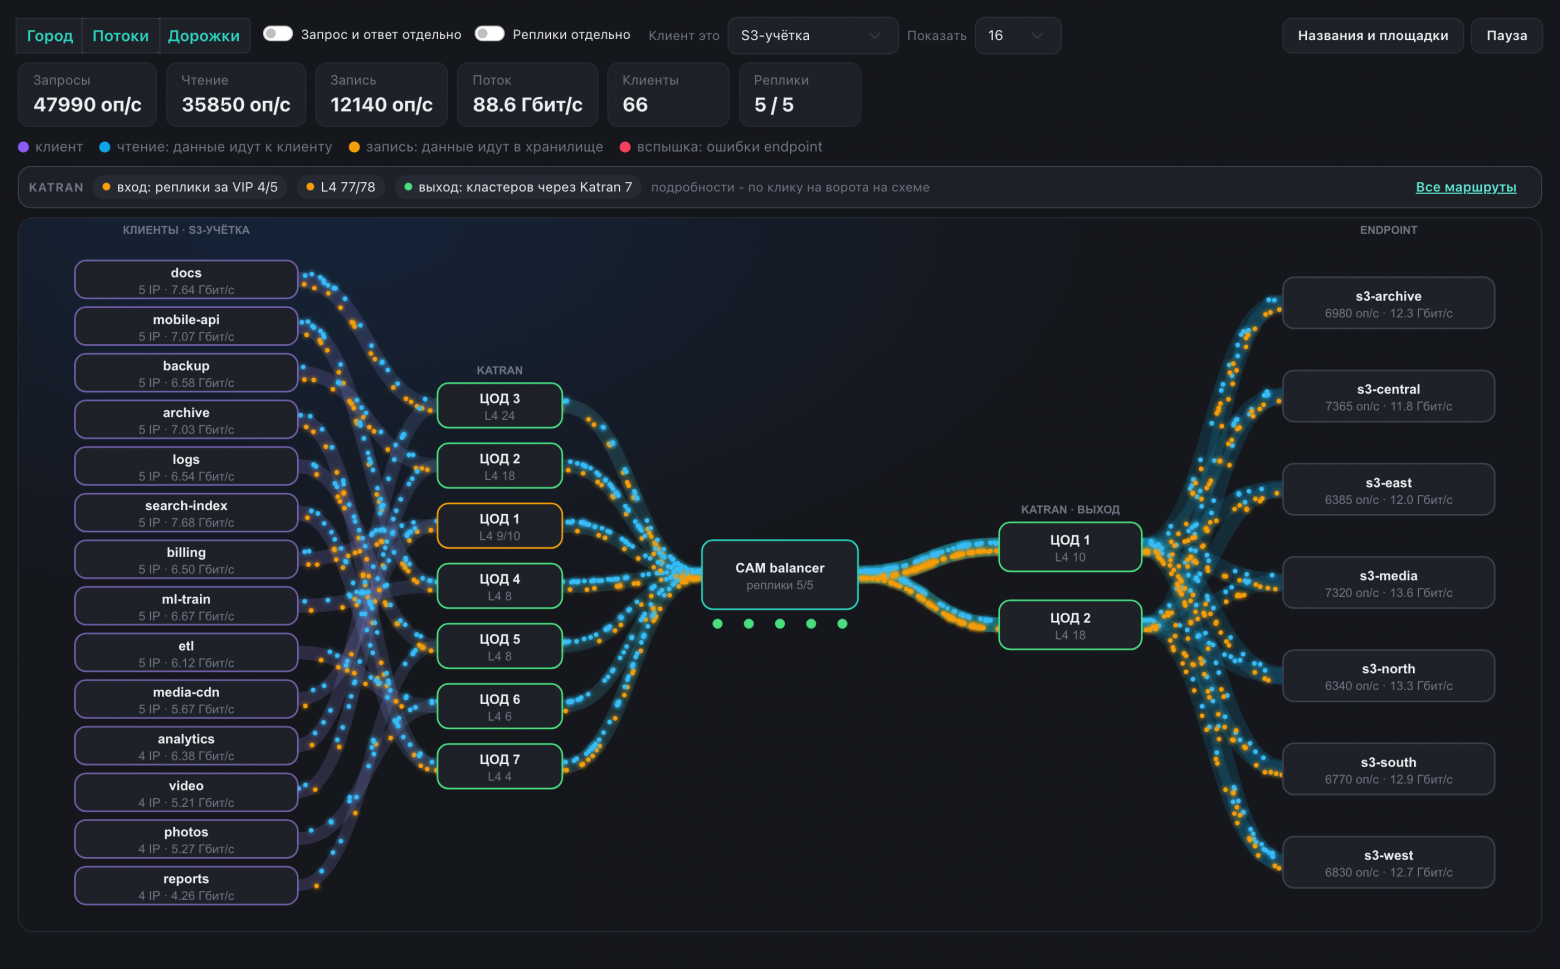
Сначала появились потоки, где слева клиенты, в центре балансер, справа кластеры, а между ними бегут частицы.
Толщина русла показывает объём, количество частиц показывает число операций, голубые частицы означают чтение, оранжевые запись.
Можно нажать на клиента и подсветить только его путь или нажать на кластер и увидеть, кто к нему сейчас обращается.
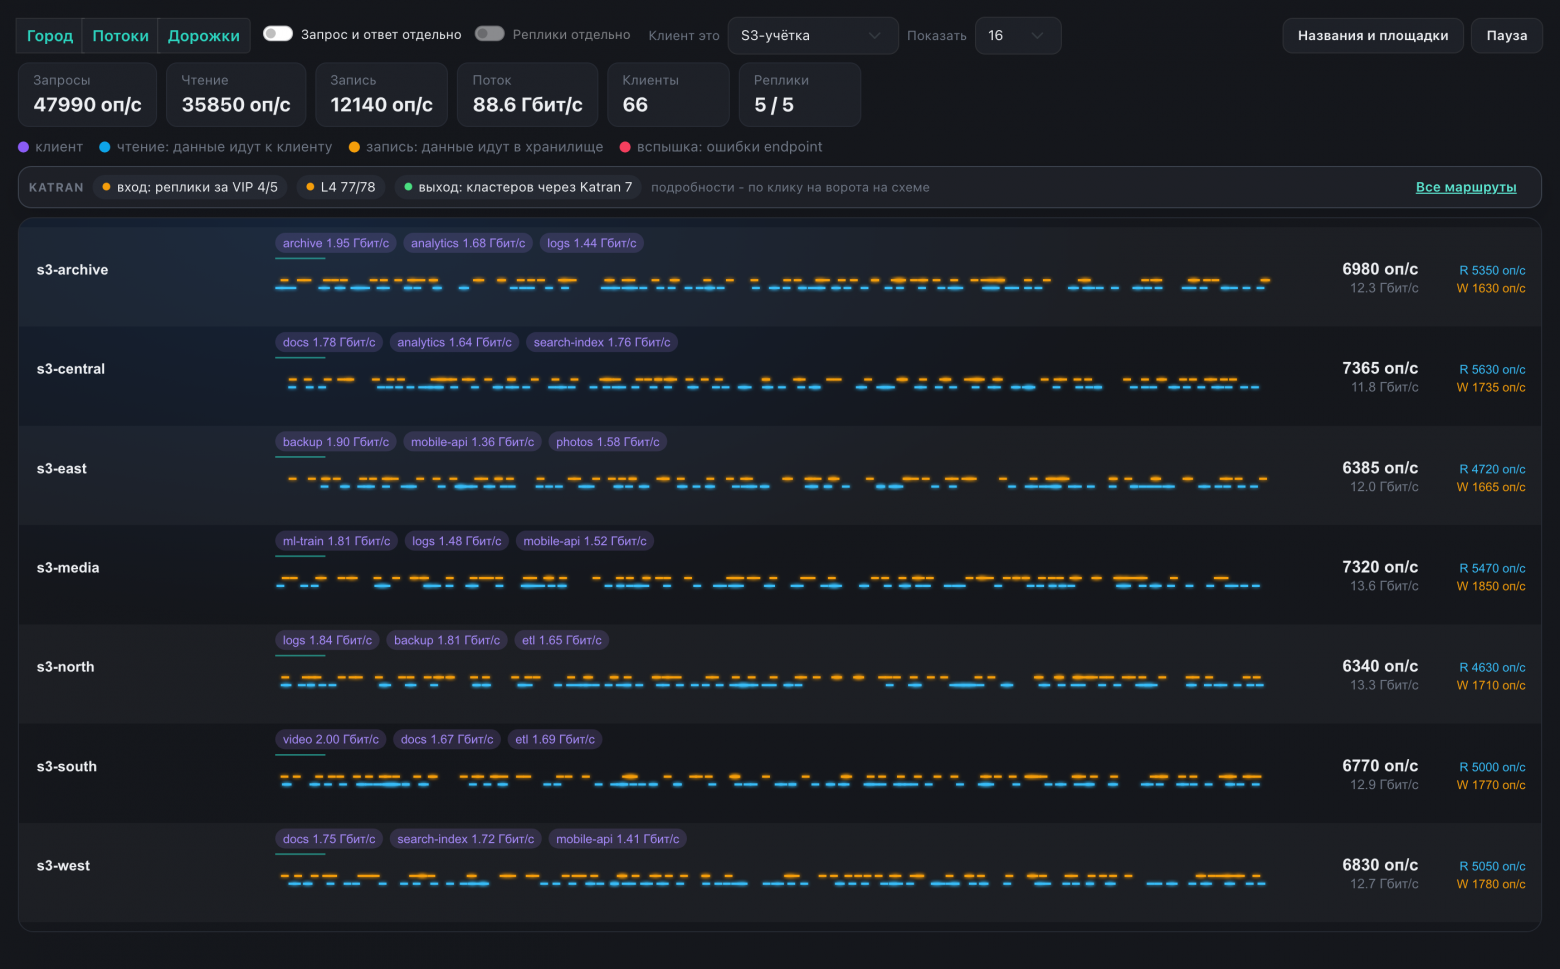
Потом появились дорожки для тех, у кого кластеров много и потоки начинают сливаться в кашу, там у каждого кластера своя полоса со своим графиком и тремя самыми активными клиентами.
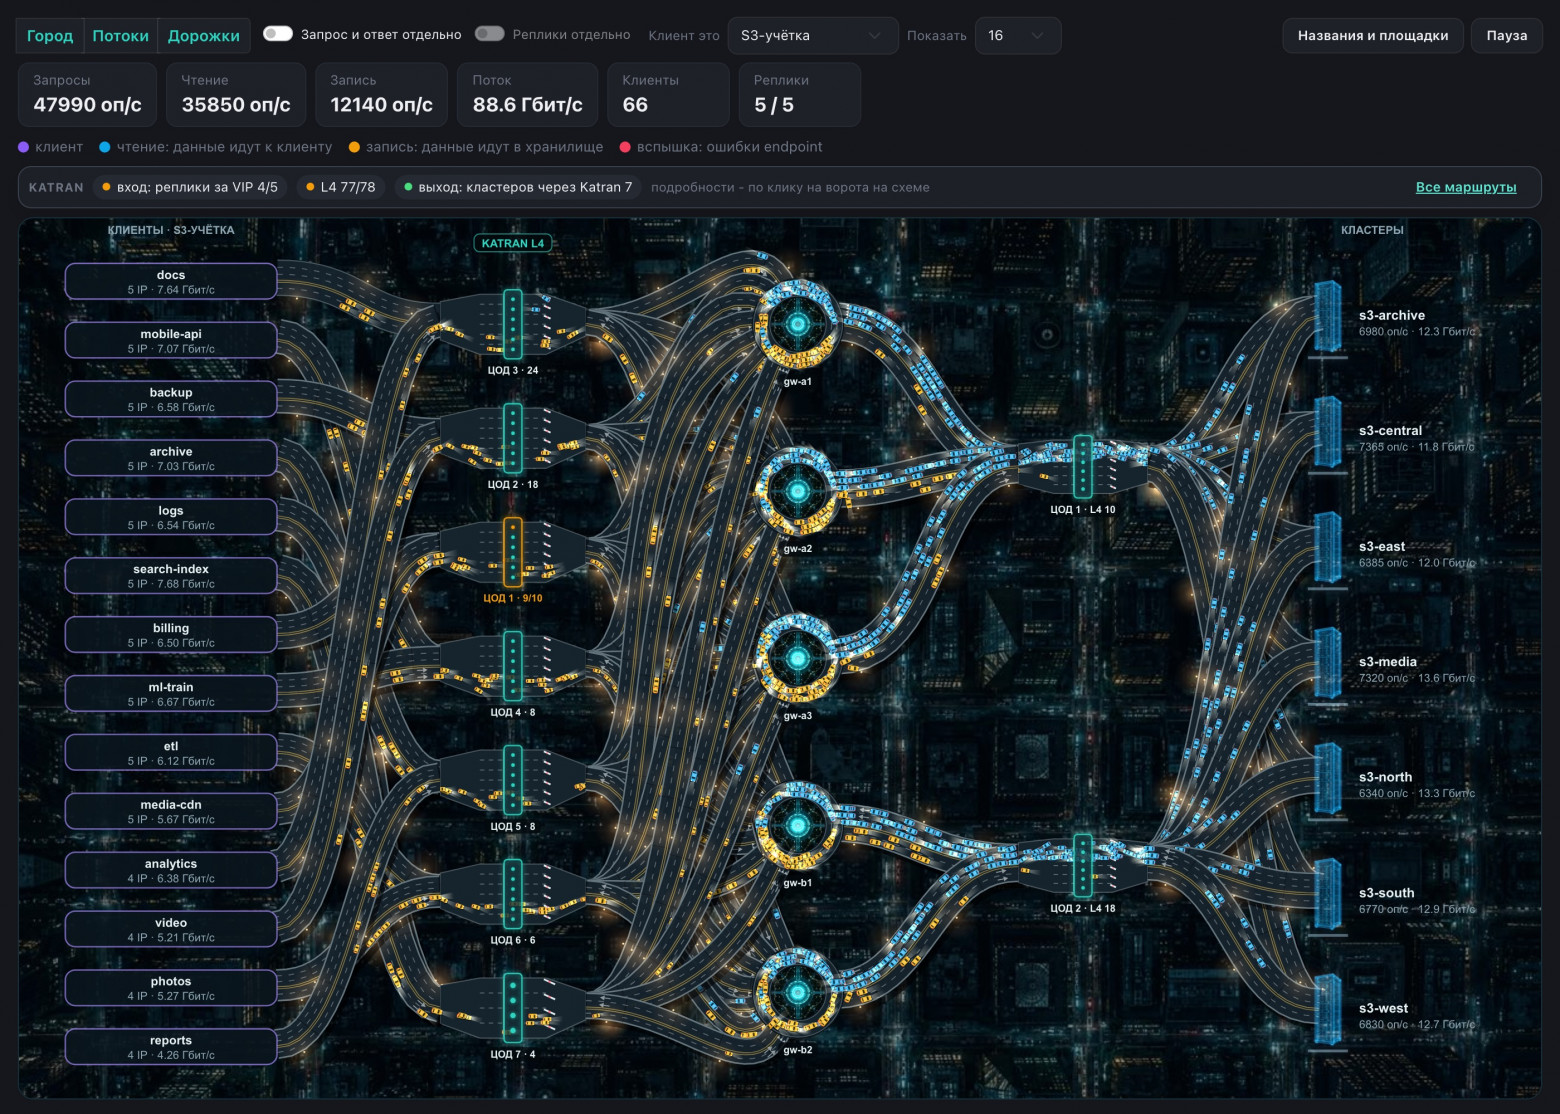
А потом я сделал город, в котором реплики балансера стоят кольцевыми развязками, клиенты живут в районах слева, а кластеры стоят башнями справа.
По дорогам ездят машинки, жёлтые везут запись, синие везут прочитанное обратно, а красные везут ошибки.
Полосы расширяются, когда поток большой, движение правостороннее, а на развязках есть эстакады.
Не хватает только инспектора ДПС, но его роль исправно играют оповещения.
Выглядит как шутка, но пробку перед упавшей репликой на такой картинке замечаешь с первого взгляда.
Последней появилась настоящая карта местности, на которой реплики и кластеры стоят в своих ЦОД, а клиенты располагаются рядом со своими площадками по подсетям.
На ней хорошо видно, когда сервис из одного города зачем-то читает данные из другого, и с такой картинкой разговор с владельцем сервиса начинать гораздо проще.
Чего балансер не делает
Чтобы не создалось впечатления серебряной пули, перечислю то, чего он сознательно не умеет.
Он не переподписывает запросы и не знает секретов.
Он не пишет данные сразу в два места, потому что это задача репликации, а не прокси.
И при промахе он не обходит все кластеры подряд в поисках ключа, потому что так один неизвестный ключ быстро превращается в нагрузку на всё хранилище.
Пропускную способность он тоже не увеличивает, медленный кластер через балансер быстрее не станет.
Зато будет видно, что медленный именно кластер, а не сеть, не балансер и не сервис соседа.
По-моему, это вообще главный навык любого мониторинга, показывать пальцем на правильного виноватого.
Что в итоге
Сервисы ходят на один адрес и не знают, сколько за ним кластеров.
Переезд кластера перестал быть проектом на квартал с письмами всем командам.
Данные по-прежнему нужно довезти и дождаться синхронизации, но конфиги сервисов при этом никто не трогает, а падение мастера в multisite больше не означает, что все бегут их менять.
Но главное, на вопрос про адрес хранилища теперь есть один ответ, и ради этого стоило всё затевать.
А археологию я теперь с чистой совестью оставляю настоящим археологам.
Если интересно, могу отдельно рассказать, как устроен снимок маршрутов в памяти и почему я так упорно не пускаю запросы клиентов в базу.
Пишите в комментариях, какие у вас были приключения с переездами S3, мне будет приятно знать, что я такой не один.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.