Распил монолита глазами QA: как взять от жизни все и наладить тестирование нового микросервиса
Кто-то скажет: «Разве сложно распилить монолит? Нужно всего лишь вытащить куски кода в новый сервис, поменять в тестах эндпоинты, и готово!». Когда-то и я так думал. Но однажды в нашу команду прилетела задача — вынести часть функциональности в новый сервис. Почти сразу эта задача превратилась в эпик, который начал расти со скоростью майской ивы: в ходе анализа монолита и его функциональности рождались новые непокрытые кейсы, дублирование тестов, логические ошибки в уже существующих и уточнения бизнес логики микросервиса. Тогда мы решили оптимизировать перенос автотестов и тестирование нового микросервиса и параллельно провести аудит тестов - чтобы, как в новый год, взять только самое хорошее.
Меня зовут Григорий Седельников, и в EXANTE я Automation QA инженер. В этой статье расскажу, как наша команда выносила из монолита сервис оценки рисков при размещении ордера и переносила на него около двухсот автотестов. Спойлер: регресс этого сервиса теперь занимает две минуты вместо часа.
Отдельно расскажу про AI, который наш продакт называет «имитацией интеллекта». Мы подключали его там, где он действительно экономил время, а основную часть переноса сделали руками. Объясню, почему нельзя написать промпт по всем канонам и уйти играть в падел, пока корпоративный AI работает над вашей задачей, и почему ручная работа в итоге стала фундаментом для будущей автоматизации.
Как работал сервис в монолите
EXANTE — финтех-компания и брокер. Через нашу платформу трейдеры совершают сделки на крупные суммы, поэтому она должна работать бесперебойно, в том числе тогда, когда мы что-то в ней перестраиваем. Стабильность сервисов и быстрое решение инцидентов — основа, без которой развитие платформы просто невозможно. Каждый QA знает, что пропущенный на прод баг означает высокие репутационные риски. Для нашей компании это ещё и потенциальные финансовые потери клиентов, поэтому качеству мы уделяем максимальное внимание.
Наш монолит мы называем Core. По сути это огромный калькулятор: он ведёт расчёты для сотен тысяч клиентов по более чем трём миллионам финансовых инструментов (акции, облигации, фьючерсы, опционы и т. д.) на рынках по всему миру. В Core рассчитываются ордера, то есть заявки клиентов на покупку или продажу, позиции на счетах и маржинальные настройки. В системе нет сервиса, который бы не обращался к Core с запросами.
Сервис Pre-margin о котором и пойдёт речь в статье, рассчитывает риски при размещении ордера.
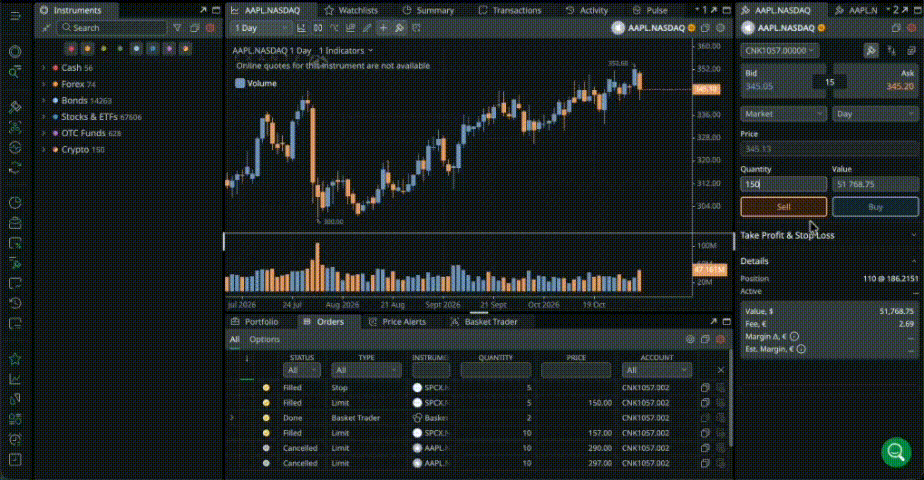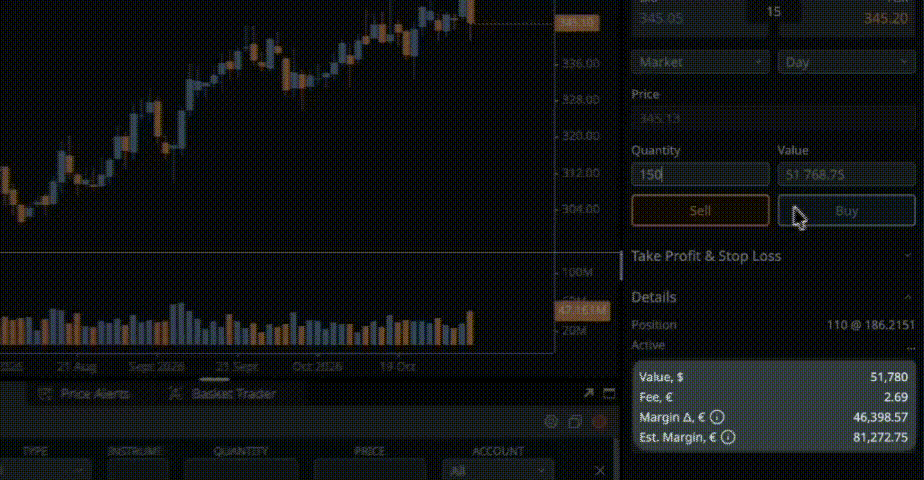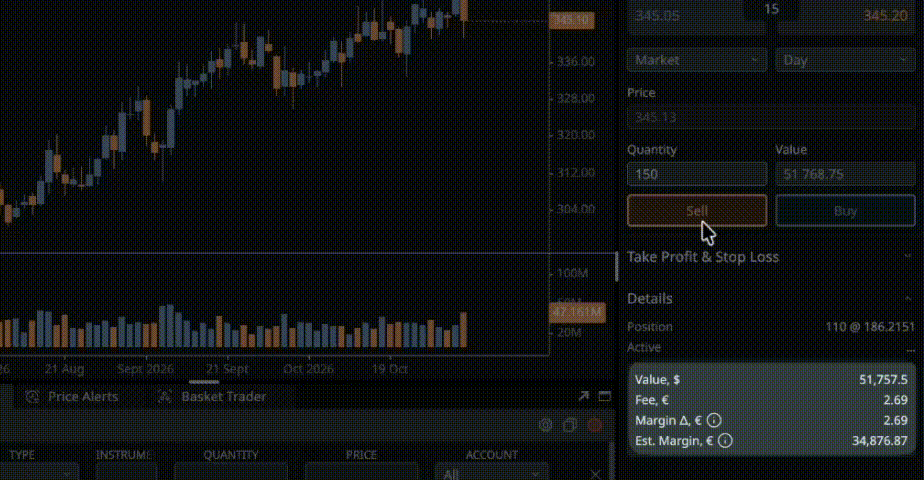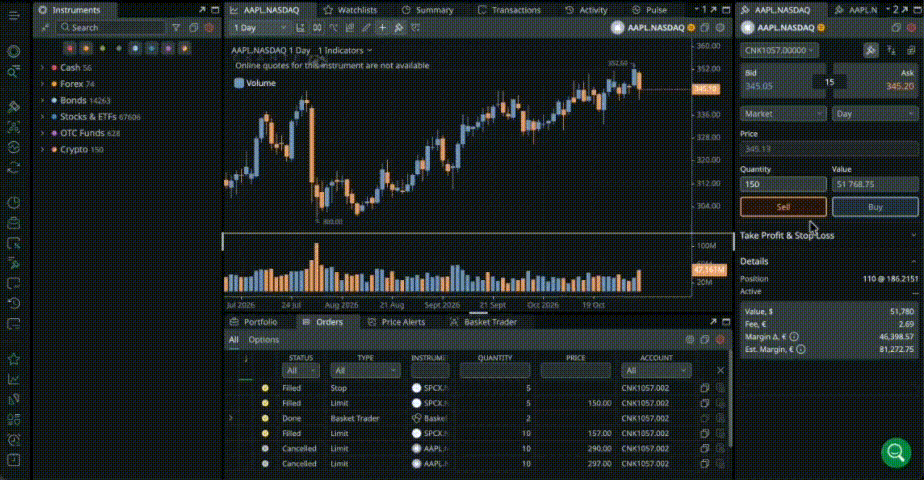
Реальный пример: клиент открывает торговый терминал, чтобы купить или продать инструмент. Ещё в тот момент, когда он наводит курсор на кнопку Buy или Sell, терминал отправляет запрос на проверку счёта. Система оценивает, хватит ли у клиента средств, чтобы открыть новую позицию. Для такой проверки Pre-margin не нужны тонны данных, которые хранит монолит: достаточно настроек аккаунта, настроек инструмента и текущего состояния счёта.
Почему мы решили вынести Pre-margin из монолита
Выделение микросервиса из монолита это не дань моде, это жизненная необходимость для развития крупной системы. Давайте посмотрим на причины выноса глазами нашей команды.
Более простая и дешёвая масштабируемость. Монолит масштабируется только целиком, даже если нагрузка выросла на одну его функцию. Отдельный сервис можно масштабировать независимо и выделять ресурсы именно под него. Для Pre-margin это особенно важно: он получает запрос каждый раз, когда клиент наводит курсор на Buy или Sell, а значит, гораздо чаще, чем ордер реально размещается.
Выделенная доменная область сервиса, а значит, и команды. Один сервис отвечает за одну задачу, и за ним стоит команда, которая глубоко знает свою доменную область. Такой сервис проще развивать, тестировать и отлаживать, а изменения в нём не задевают соседнюю функциональность.
Конечно, плюшки от выноса получают не только разработчики, перепадает и нам, QA. Для нас это прежде всего более быстрое расследование инцидентов и снижение когнитивной нагрузки на дежурных, а ещё ускорение прогона регрессионных тестов. Чтобы объяснить, почему это было так важно, расскажу, как было устроено тестирование монолита.
Почему это важно для процесса тестирования
Мы давно автоматизировали тестирование Core. Сейчас в нашем фреймворке более 3500 автотестов на Python. Они разбиты на 16 джоб, которые каждую ночь гоняются на нескольких окружениях. Специальные сетаперы создают нужные сущности при развёртывании нового окружения. Тесты нужно поддерживать в стабильном состоянии и разбираться с теми, что упали ночью. Для этого каждую неделю мы выбираем дежурного по автотестам из команды монолита, и в его капасити мы закладываем четыре часа в день только на разбор падений.
Из такого устройства вытекали две большие проблемы.
Первая: долгий и шумный регресс. Каждое изменение в Pre-margin проходило регрессионное тестирование. Из-за огромного количества тестов регресс даже небольшого изменения занимал около часа. Но ещё больнее было то, что при приёмке новой версии специалист видел падения тестов на функциональность, которую, по факту, изменения вообще не затрагивали. Коллеге приходилось разбираться, флак это или мы действительно сломали логику монолита.
Стабильность сервиса для нас - краеугольный камень, поэтому мы не выкатываем изменения, пока не поймём, почему упали тесты на функциональность, которую мы не трогали. В итоге, релиз даже маленькой фичи или исправления в Pre-margin могли сильно затянуться.
Вторая: сложное расследование инцидентов и высокая когнитивная нагрузка. Пока сервис находился внутри монолита, расследовать инциденты было трудно. Чтобы докопаться до причины, специалисту приходилось держать в голове огромный контекст: как устроены зависимые модули, какие настройки аккаунтов и инструментов участвуют в расчёте, какие ещё части Core могли на него повлиять. Плюс, огромное количество логов, большая часть которых к конкретной проблеме не относилась.
А теперь представьте, как взрывается мозг дежурного, когда ему нужно дебажить падающие тесты:
более чем в десяти различных джобах,
с абсолютно разной проверяемой функциональностью,
и с зависимостями разных частей кода внутри самого монолита.
К концу дня дежурный мог выглядеть так:
О том, как у нас устроена работа дежурного по автотестам, подробно рассказал мой коллега Владимир Смирнов в статье «Философия автотестов»: как разбирать ночные падения, отличать флаки от реальных проблем и почему тесты не обязаны быть зелёными.
Давайте подытожим: в выносе Pre-margin из монолита мы нашли следующие преимущества:
Выделение доменной ответственности микросервиса. Один микросервис — одна задача.
Ускорение регрессионного тестирования.
Быстрая локализация багов.
Снижение когнитивной нагрузки на дежурных и защита от выгорания. Бонусом, другим командам тоже проще разбираться в сервисе.
Как мы переносили автотесты
Пока команда неравнодушных разработчиков выпиливала микросервис из монолита, тестировщики занимались автотестами. Разберём все, что мы сделали, чтобы подготовить микросервис к выкатке на прод.
Провели инвентаризацию тестов с помощью AI
У нас были тесты на расчёт преордера, и нам нужно было найти их в разных сьютах тестов на монолит. Мы делегировали Claude задачу из двух действий:
Найти все тесты, которые дергают и проверяют эндпоинты оценки ордера.
Свести данные в таблицу с полями: название теста, где лежит, что проверяет и какие предусловия.
Здесь было важно передать Claude подробную инструкцию:
Найди тесты, которые дёргают эндпоинт-оценки преордера в папке тестов монолита, и имеют проверки результатов этого запроса — assert в коде теста, хэлперов или утилит.
Собери полный список предусловий теста. Предусловия бери из блока пресетаперов, а так же смотри на устанавлеваемые параментры в блоке сущности и настраивают их в блоке def setup_class и def setup_method.
Собери данные в таблицу с обязательными полями: файл, тест класс, тест метод, предусловия и что проверяет — то есть какие assert имеет.
Так за пару часов мы получили полный справочник тестов, которые проверяют функционал нового микросервиса.
Спланировали архитектуру для тестовых файлов нового микросервиса
Далее нам нужно было спланировать новую структуру файлов и папок тестового набора для микросервиса. Мы разделили тесты по смыслу того, что они проверяют. Так с ними удобнее работать — например, проще и быстрее ориентироваться, когда возникают вопросы. А ещё, наши тесты служат справочником: по ним видно, за что отвечает сервис.
Чтобы спланировать архитектуру, мы почти не использовали AI, а включали мозги и придумывали решения самостоятельно. Например, AI накидывал нам аргументы для краш-тестов идей — после нескольких итераций можно было подобрать более чистое решение.
Если слишком сильно доверять AI в планировании архитектуры, он может выстроить её так, как ему удобно. Для вас это может быть неудобно, а в полной мере вы оцените неудобство спустя время, когда переделывать структуру будет поздно, потому что в команде не хватает ни сил, ни капасити.
Перенесли автотесты
Этот шаг был самым трудоёмким. Тестов на функциональность нового микросервиса оказалось около двухсот штук. Казалось бы — можно написать инструкцию для Claude и попросить перенести тесты на новый микросервис в отдельную папочку.
Но когда я проделал этот трюк с одним файлом тестов из 19, я понял, что так не прокатит. Нам нужно было сохранить тесты на эту функциональность в монолите и вытащить их на новый микросервис — обязательно с новыми сущностями, которые важно правильно создать. На моей практике, клод постоянно забывал применить какие-то настройки аккаунтов и инструментов. И дело не в плохом промпте: система финансового брокера очень сложная, в ней множество вариаций настроек инструментов, аккаунтов, комиссий и т. д.
Поэтому мы приняли немодное в эпоху AI решение — делать перенос руками. Когда вручную ревьюили и прогоняли старые тесты, мы нашли удивительные вещи, которые никто бы даже не подумал запромтить агенту. Поэтому если вдруг вы боитесь, что вас заменит искусственный интеллект — знайте: от нас, кожаных мешков, ещё есть смысл!
Расскажу подробнее о том, как переносили тесты.
Во-первых, мы копировали код тестов и создавали новые сущности, чтобы удалить зависимости между тестами монолита и нового сервиса. В этом не было ничего сложного — вручную мы делали это быстрее, чем писали бы промпты для AI.
Во-вторых, мы запускали каждый перенесённый тест и сверяли его с эталоном, которым для нас служил монолит. Это был архиважный шаг — именно здесь вскрылось большое количество багов нового сервиса и тестов.
Фреймворку с тестами было более семи лет. За это время в компании появились новые стандарты и правила написания тестов. Во время переноса мы обнаружили:
Недостающие сетаперы. Сетаперы — это методы, которые создают нужные нам настройки в коде автотестов. Часть настроек была сделана вручную, без сетаперов. Это грозило тем, что при запуске тестов на новый микросервис, на новом окружении они могли падать не с продуктовым багом, а из-за ошибки в самих тестах, так как мы неверно оформили предусловия. Команда тратила бы время на расследование несуществующих багов, а реальные могли бы затеряться среди ложных падений.
Большие тестовые файлы, которые тормозили прогон. Мы разбивали эти крупные файлы на несколько файлов, чтобы параллельно запускать тесты в раннере.
Тестовые пробелы. Как это происходило: тестировщик смотрел в файл с тестами, понимал, что в них не проверяется какое-то предусловие, углублялся, изучал и понимал, что теста нет, хотя сценарий очень важен. В таком случае специалист либо дописывал тест, либо писал его прямо во время переноса, если это было недолго, либо заводил задачку в беклог.
Неточности в документации. Закрывая пробел в тестах, тестировщик разбирал сценарий, который раньше никто не проверял, и сверял поведение сервиса с документацией. Иногда оказывалось, что документация описывает этот случай неточно или не описывает вовсе. Документацию, конечно, обновляли: иногда сами в процессе, иногда силами техписателей.
Ложноположительные проверки. Мы обнаружили несколько тестов, которые проверяли None==None, и были всегда зелёными. Это происходило из-за ошибок обработки в хелперах и утилитах. На самом деле тест ничего не проверял, но до момента переноса никому и в голову не приходило проверить всегда зелёный тест.
Ненужные строчки кода, которые замедляли прогон. В ходе ежедневной работы у нас не было возможности подумать над оптимизацией. А при миграции стало заметно, что мы можем ускорить автотесты, очистив их код от ненужного. Например, почистить сетап-классы и -методы, которые каждый раз сетапили одно и то же для каждого тестового класса в файле. Это дало значительный прирост скорости: с девяти минут время прогона сократилось до двух с половиной минут.
Когда базовый набор тестов на микросервис был готов, мы начали добавлять новую функциональность. Работа шла параллельно с разработкой: после каждого коммита мы делали прогон автотестов, а затем расследовали причины падения. Интересно было наблюдать, как работает принцип Парето. Я немного перефразирую его: «20% времени на дейлике решают 80% проблем»: мы открыто обсужали потребности сервиса со своей командой - не только в QA, но и с разработкой. Это значительно ускорило развитие сервиса.
Также, открытые обсуждения принесли нам ощутимые бонусы: увеличили покрытие юнит-тестами, обменялись знаниями внутри команды и углубили экспертизу в продукте.
Что получили в итоге
После того как мы стабилизировали новое детище, пора было заняться рутиной — включить джобы автотестов в расписании ночных прогонов, постепенно переключить трафик клиентов на наш сервис и отправить его в светлое будущее на проде…
Теперь о самом главном. Помните проблемы, которые мы ожидали решить?
Регресс был долгим. Теперь регресс Pre-margin занимает две минуты. Причины — вынесли тесты из монолита, оптимизировали прогон. Теперь мы можем проверить сервис преордера при выкатке новой фичи в 30 раз быстрее!
Инциденты было сложно расследовать. Теперь узкая доменная область выделена в отдельный микросервис, и при проверке мы не распыляемся на соседнюю функциональность. Баги локализуются проще и быстрее.
Дежурные были перегружены. Работать стало легче! Чтобы протестировать Pre-margin, дежурному больше не нужно погружаться в огромную логику монолита.
И теперь тестировщик выглядит примерно так: он устал, но не сломлен.
Помимо явных проблем от которых мы хотели избавиться, получилось решить ещё несколько важных задач:
Качество тестов выросло. Мы исправили все ложноположительные тесты, решили проблему флаков и перенесли тесты с учётом актуальных паттернов кода компании.
Покрытие стало шире. Детальный анализ выявил тестовые пробелы, и большую часть из них мы закрыли прямо в процессе миграции. Лишь небольшая часть переехала в бэклог.
Документация стала точнее. Теперь функциональность сервиса описана шире и на большем количестве примеров.
Команда углубила экспертизу в продукте. После погружения в самую пучину сервиса полную картину видит каждый, кто участвует в развитии Pre-margin.
Мы осознали реальный объём техдолга. Инвентаризация и перенос тестов показали его во всей красе. Можете ли вы сейчас с уверенностью сказать, что полностью понимаете техдолг своего сервиса? Смею предположить, что скорее нет.
Почему AI досталась скромная роль
Подробнее хотелось бы сказать про AI.
AI мы доверили то, в чём он действительно силён: быстро проанализировать более 3500 тестов и собрать из них справочник, а ещё помочь проверить на прочность наши архитектурные идеи. Благодаря этому мы быстро стартовали. А вот сам перенос сделали руками, и причин было две.
Сложность предметной области. Система брокера держится на множестве комбинаций настроек инструментов, аккаунтов и комиссий. В первом же эксперименте Claude регулярно упускал часть из них, а ошибка в тестах финансовой системы стоит дорого.
Экономика. Когда выносишь один сервис, написать, отладить и проверить промпты для переноса дольше и дороже, чем перенести тесты самому. На небольшом объёме работ промпт-инжиниринг просто не окупается.
При этом AI остаётся классным инструментом, если применять его с головой. Представьте, что у вас есть очень крутой автоматический хирургический прибор. Он может вырезать пациенту что угодно, но вы не знаете, что именно, зачем и когда нужно вырезать. Скорее всего, всё будет вырезано идеально, но пациент скончается на проде. С тестами так же. Решения, стратегию, чёткие границы и инструкции должны задавать вы, а не auto-mode в Claude. Слепое доверие AI не дало бы нам и 70% той пользы, которую мы получили в итоге.
Ручной перенос не был отказом от AI. Наоборот, это была подготовка к автоматизации. Пройдя весь путь руками, мы поняли, из каких шагов состоит перенос, где прячутся подводные камни и какие предусловия нельзя упустить. Теперь у нас есть фундамент, чтобы формализовать процесс и подключить к нему AI, когда придёт время выносить из монолита следующие сервисы.
Человек — архитектор и мегамозг для больших и сложных решений, которые меняют перспективу. AI — рабочие руки, которые делают то, что им подробно описали и формализовали. И работать он может только под присмотром человека.
Основной вывод
И главное, что хочется сказать коллегам-тестировщикам: если вы жутко страдаете при тестировании одной большой штуки, скорее всего, её можно распилить на штуки поменьше. Процесс станет легче, а по пути вы узнаете о своём продукте много нового.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.