Память в GoOS, часть 2. Нативные потоки, горутины и GC на SMP
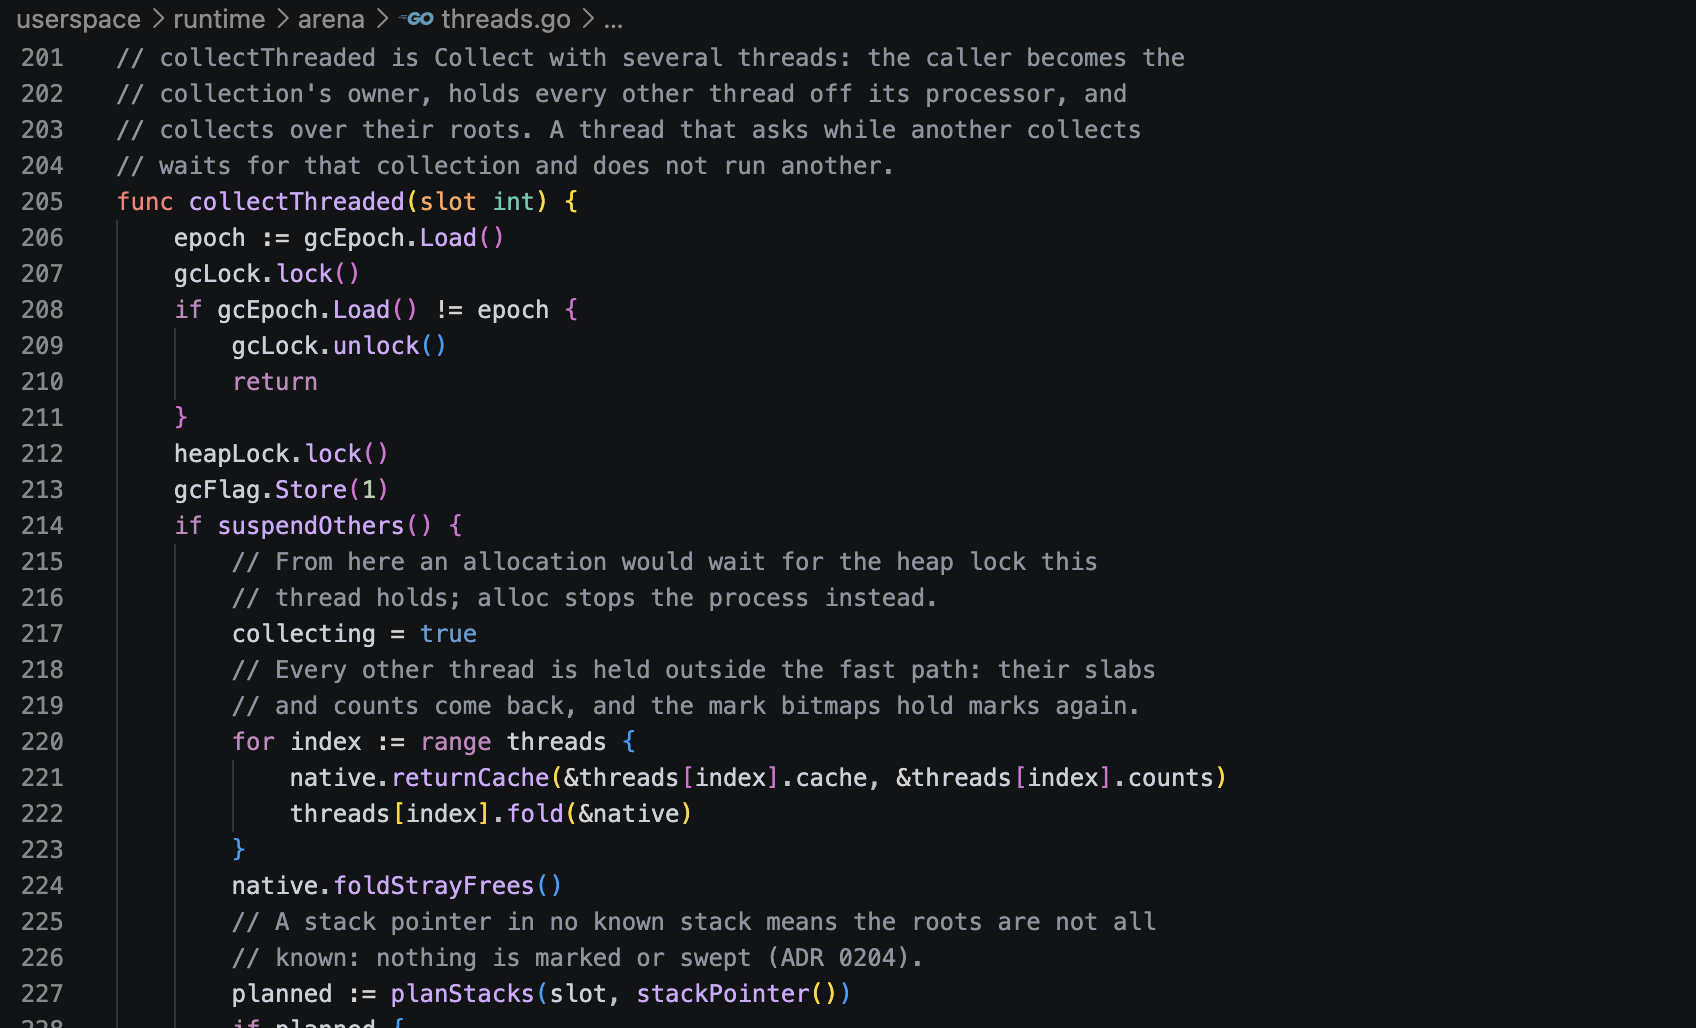
Как я рассказывал в первой части, реализация работы с памятью - довольно непростое занятие, и в первой части я рассказывал про сравнительно лёгкую область этой работы.
Пока процесс однопоточный, сборщик мусора имеет дело с одним стеком, одним набором регистров и одной точкой выполнения. Как только появляется второй поток, он уже может одновременно менять кучу на другом процессорном ядре. А после появления горутин выполнение Go-кода вообще перестаёт быть жёстко связано с одним стеком нативного потока.
В релизе GoOS 0.2.8 сначала появились нативные потоки пользовательского пространства, а затем поверх них — собственный M:N runtime для горутин. После этого задача сборщика мусора стала заметно неприятнее: перед освобождением объекта нужно быть уверенным, что ссылка на него не осталась в стеке другого потока, в сохранённом контексте горутины, в XMM-регистре или в промежуточном состоянии переключения контекста.
Это уже не только задача GC. Здесь пересекаются планировщик, аллокатор, ABI, TLS, виртуальная память и код сохранения регистров.
Сначала - нативные потоки
Ранее нативный процесс GoOS фактически выполнялся одной задачей ядра. Само ядро уже давно умело планировать несколько задач одного процесса на разных процессорах — например, Linux-совместимый слой использует это для clone. Но нативный ABI GoOS не позволял обычному процессу создать второй поток.
В итоге, появился отдельный интерфейс для потоков:
Операция | Что делает |
| создаёт новый поток в том же процессе |
| завершает только текущий поток |
| ждёт завершения конкретного потока |
| возвращает идентификатор и слот текущего потока |
| добровольно отдаёт процессор |
| внутренняя операция runtime для остановки остальных потоков перед GC |
| возобновляет потоки после сборки |
Новый поток не получает отдельное адресное пространство, набор capabilities или таблицу handles. Всё это принадлежит процессу и разделяется между его потоками. Отдельными остаются задача ядра, стек, служебное состояние системных вызовов, TLS и локальное состояние аллокатора. Идентификатор потока включает не только номер слота, но и поколение. Если поток завершился, а его слот позже занял новый, старый ID не начинает внезапно обозначать уже другой поток. Обычный Exit по-прежнему завершает весь процесс. ThreadExit нужен именно для нормального завершения одного потока. Ошибка или аварийное завершение одного из потоков считается ошибкой процесса и завершает его целиком.
Стек каждого потока создаёт ядро
В процессе есть 16 слотов нативных потоков, включая основной поток в слоте 0. Для дополнительных потоков ядро создаёт стек размером 512 КиБ и оставляет под ним 64 КиБ недоступной защитной области. Если стек вырастет за допустимую границу, процесс получит fault вместо тихой записи в соседнюю память. Стек создаётся ядром, а не обычным аллокатором GoOS. Это важно: создание нового контекста выполнения не должно само зависеть от выделения памяти из той же Go-кучи, которую этот контекст потом будет использовать. 16 слотов — это архитектурный предел таблицы, а не обещание, что любой процесс сможет одновременно создать ещё 15 потоков. Квота задач процесса ниже: для обычного профиля сейчас это 4 задачи, для большого — 8.
Как runtime узнаёт, на каком потоке он работает
Первая реализация нативных потоков использовала простое свойство фиксированных стеков. Пока TinyGo собирал программу с scheduler: none, поток никогда не покидал свой стек, поэтому номер слота можно было вычислить по RSP.
После появления горутин этот способ перестал работать. Один и тот же нативный поток теперь может исполнять код на стеке горутины, затем перейти на собственный стек планировщика, а потом запустить другую горутину. По текущему указателю стека уже нельзя однозначно определить сам поток. На данный момент для этого используется FS.
База FS каждого нативного потока указывает на небольшой блок управления потоком. Его размещение фиксировано, потому что к нему обращается в том числе ассемблерный код runtime:
Self
Slot
Magic
M
Pins
G
ID
Task
Slot теперь читается одним обращением относительно FS и не зависит от того, на каком стеке выполняется код. Ядро и так сохраняет и восстанавливает FS base при переключении задач, поэтому отдельного тяжёлого механизма для этого не понадобилось. Это одна из деталей, которые пришлось поменять уже по ходу работы: вычисление потока по RSP было корректно для первоначальной модели нативных потоков, но перестало быть корректным после появления M:N-планировщика.
Один глобальный mutex для аллокатора оказался слишком дорогим
После появления второго потока куча стала общей изменяемой структурой. Самый очевидный вариант — поставить одну блокировку вокруг каждого alloc и free. Такой режим в GoOS есть и используется в тестах как базовый вариант для сравнения. Он корректный, но при нескольких потоках конкуренция за одну блокировку быстро становится заметной. Поэтому для мелких выделений основной путь работает иначе.
Каждый поток может владеть одной slab-страницей каждого класса размеров. Сейчас классов 14. Пока поток выделяет или освобождает объект внутри принадлежащей ему slab-страницы, общая блокировка кучи не нужна. Локальные счётчики тоже сначала меняются самим потоком и лишь периодически сворачиваются в общее состояние: при получении новой slab-страницы, завершении потока и перед сборкой мусора. В худшем случае один поток может держать по одной лишней странице каждого класса — 14 страниц, то есть 56 КиБ. Для восьми потоков верхняя оценка такого локального кэша составляет 448 КиБ. Крупные выделения, занимающие несколько страниц подряд, остаются под общей блокировкой кучи.
Что происходит, если память освобождает другой поток
Тут уже появляется более интересный случай. Допустим, поток A выделил объект из своей slab-страницы, а позже этот объект освобождает поток B. Поток B не может просто изменить основную битовую карту страницы: A в этот же момент может выполнять новое выделение из той же slab-страницы. Для таких освобождений используется вторая битовая карта mark в метаданных страницы. Между сборками мусора GC её не использует, поэтому она временно служит для регистрации освобождений из других потоков. Поток B атомарной операцией выставляет бит нужного слота. Когда владелец страницы в следующий раз доходит до медленного пути, он переносит эти биты в основную карту занятости. То же самое обязательно происходит перед сборкой мусора. Если другой поток попытается освободить тот же слот повторно, уже установленный бит позволяет обнаружить двойное освобождение. Есть ещё одна гонка: поток B мог прочитать старого владельца страницы как раз в момент, когда A перестал ею владеть. В этом случае отметка об освобождении может попасть в уже ничью slab-страницу. Это безопасно: слот останется занятым чуть дольше и будет освобождён при следующем назначении владельца или перед GC. Главное здесь не потерять память навсегда, а не сделать обратную ошибку — не считать слот свободным раньше времени и не выдать его повторно, пока старый объект ещё используется.
Быстрый путь аллокатора и GC должны видеть согласованное состояние
Локальные slab-страницы убрали глобальную блокировку из частого пути, но сразу создали проблему для stop-the-world GC.
Представим, что поток остановлен посередине изменения метаданных: один бит уже записан, а связанный счётчик ещё нет. Если сборщик в этот момент начнёт маркировку и sweep, он увидит временно несогласованное состояние кучи. Поэтому короткий путь аллокатора объявляет в состоянии потока, что сейчас находится внутри такого перехода. Упрощённо схема выглядит так:
поток:
    fast_path = 1
    проверить gc_flag
    изменить bitmap / counters
    fast_path = 0

GC:
    gc_flag = 1
    остановить остальные потоки
    проверить fast_path каждого потока
Если GC остановил поток внутри этого окна, сборка не продолжается. Runtime возобновляет потоки, даёт незавершённой операции закончиться и повторяет попытку остановки. Таких попыток ограниченное число — четыре. Если получить согласованный снимок не удалось, текущий цикл GC просто отменяется. Sweep по сомнительным метаданным не запускается. В этой части runtime правило довольно жёсткое: неполный снимок означает отсутствие сборки, а не попытку «додумать», что же там происходило с кучей.
Stop-the-world теперь действительно останавливает несколько потоков
В многопоточном процессе сборка проходит примерно так:
поток-сборщик
      |
      | блокировка GC
      v
 блокировка кучи
      |
      | gc_flag = 1
      v
 ThreadSuspend
      |
      +----> ядро удерживает поток 1
      +----> ядро удерживает поток 2
      +----> ядро удерживает поток N
      |
      v
 проверить сохранённые контексты
 и переходные окна runtime
      |
      v
 забрать slab-страницы у потоков
 свернуть счётчики и чужие free
      |
      v
 найти и просканировать корни
      |
      v
 mark -> sweep -> trim
      |
      v
 ThreadResume
ThreadSuspend — не флажок, который остальные потоки должны когда-нибудь заметить сами. Ядро удерживает задачи процесса вне процессоров, посылает запрос на перепланирование тем ядрам CPU, где они сейчас выполняются, и ждёт получения сохранённого пользовательского контекста каждого потока. В снимок входят RIP, RSP, пятнадцать регистров общего назначения и шестнадцать XMM-регистров.
Если какой-то поток не удалось корректно остановить, его пользовательский контекст выглядит недостоверно или runtime видит незавершённое окно аллокатора/Region, GC не идёт дальше. Потоки снова запускаются, а куча остаётся нетронутой. После успешной остановки runtime забирает у потоков принадлежащие им slab-страницы, переносит локальные счётчики в общие, применяет отложенные освобождения и только после этого начинает маркировку.
Почему в корни GC пришлось включить XMM-регистры
В первоначальной однопоточной версии сборщик сохранял callee-saved-регистры общего назначения. Для обычного синхронного вызова функции этого достаточно: ABI заранее определяет, какие регистры обязан сохранить вызываемый код. Асинхронная остановка потока устроена иначе.
Поток можно прервать между практически любыми двумя инструкциями. Компилятор в этот момент может держать живой Go-указатель не только на стеке, но и в caller-saved-регистре общего назначения или в XMM. Никакого обычного вызова функции, после которого значение можно было бы считать уничтоженным по правилам ABI, ещё не произошло. Поэтому снимок остановленного потока для GC включает и регистры общего назначения, и XMM. Сборщик рассматривает их как ещё одну область корней.
Позже я выяснил, что это не перестраховка. Ошибка сохранения XMM действительно ломала систему, причём выглядела как две совершенно разные проблемы. К этому ещё вернусь ниже.
Следующий шаг — горутины
Нативные потоки дали настоящую параллельность на нескольких процессорных ядрах, но это ещё не привычная модель Go. Обычный нативный вариант сборки GoOS никуда не исчез. Программа по-прежнему может явно создавать потоки через thread.Start и ждать их через thread.Join.
Для go, каналов, select, таймеров, time.Sleep и нужных примитивов sync появился отдельный target с поддержкой горутин. В его конфигурации TinyGo стоит scheduler: cores, но это не означает, что я просто включил готовый планировщик TinyGo и на этом всё закончилось.
GoOS сейчас использует закреплённую версию TinyGo 0.42.0. Утилита tools/goroutineroot проверяет хэши нужных исходников и строит отдельное дерево с runtime-слоем GoOS. Установленный TinyGo при этом не переписывается. Компилятор всё ещё использует внутренние механизмы TinyGo для представления go f(), но очереди, нативные потоки, ожидания, стеки, вытеснение и связь с GC реализованы в runtime GoOS.
G, M и разрешение на выполнение
Здесь удобно использовать привычные обозначения из Go runtime, хотя реализация GoOS не копирует его один в один.
G — горутина.
M — нативный поток GoOS, который может выполнять горутины.
Полноценного отдельного объекта P сейчас нет. Вместо него используется разрешение на выполнение: только M, получивший такое разрешение, может исполнять обычные G. Количество разрешений ограничивает реальный параллелизм и управляется через GOMAXPROCS.
По умолчанию предел выбирается по наименьшему из трёх ограничений:
число доступных CPU
квота задач процесса
16 слотов нативных потоков
Основной поток процесса тоже участвует в работе планировщика.
У каждого рабочего M есть локальная очередь до 256 готовых горутин. Есть и общая очередь. Если локальная очередь переполняется, часть работы переносится в общую. Поток без собственной работы может забрать часть очереди другого рабочего потока.
Новые рабочие потоки создаются только по необходимости и в пределах квоты процесса. Если ядро не позволяет создать ещё один поток, готовые горутины не теряются — runtime просто продолжает работу с меньшим фактическим параллелизмом.
Сколько горутин может жить одновременно
Описатели G лежат в фиксированной таблице на 1024 элемента.
По умолчанию процессу разрешено одновременно иметь до 256 горутин. Через runtime этот предел можно изменить, но выше MaxGoroutines = 1024 он не поднимается.
Это сознательно ограниченная модель. Мне пока не нужен runtime, который для роста собственной таблицы горутин сам начинает выделять произвольные объёмы памяти в момент, когда планировщик пытается создать новый контекст выполнения.
Стек горутины
Обычная G получает 256 КиБ виртуального пространства под стек и 64 КиБ недоступной защитной области.
Отдельный стек планировщика M занимает 64 КиБ. Это не растущий стек стандартного Go runtime. Границы фиксированы. Физическая память при этом, как и в других виртуальных областях GoOS, появляется только по мере обращения к страницам. Сам факт резерва 256 КиБ не означает, что спящая горутина немедленно заняла столько же RAM.
Первая реализация выделяла для каждой G две отдельные области виртуальной памяти: защитную область и сам стек. Примерно сотня спящих горутин быстро упёрлась в таблицу регионов процесса, в которой 128 записей.
После этого стеки стали резервироваться пачками. Одна область виртуальной памяти содержит повторяющиеся пары «защитная область + стек». Ядро знает такой формат и не разрешает частичную операцию, которая могла бы разрезать пачку или убрать защитную область.
Когда горутина завершается, физические страницы её стека можно вернуть через VMDiscard, а сам слот позже использовать снова.
Переключение между горутинами
Непосредственное переключение выполняет goos_g_swap. Он сохраняет указатель стека и callee-saved-регистры System V ABI, загружает сохранённый стек другой горутины и восстанавливает её состояние. Когда горутина добровольно перестаёт выполняться — например, ждёт канал, mutex, таймер, handle или вызывает Gosched — поток переходит на стек планировщика, фиксирует причину остановки G и выбирает следующую готовую горутину.
Но переключать G можно не в любой момент. В TCB есть счётчик Pins. Пока нативный поток использует состояние, которое принадлежит именно ему — например, дескрипторы системного вызова, локальные кэши аллокатора или внутреннюю блокировку runtime, — текущая горутина считается закреплённой за этим M и не должна мигрировать. То же относится к arena.Region: курсор региона является состоянием потока, а не горутины. Поэтому припарковать или перенести G, пока она находится внутри Region, нельзя.
Асинхронное вытеснение
Одних добровольных переключений недостаточно. Горутина с плотным циклом без вызовов могла бы навсегда занять один M. Поэтому GoOS добавляет вытеснение по таймеру. Сейчас PreemptTicks = 2: через заданное число тиков пользовательского времени ядро может перенаправить сохранённые RIP/RSP потока на goos_preempt_entry. Этот вход выполняется на прерванном стеке. Runtime проверяет, можно ли сейчас безопасно переключить горутину: поток не должен быть закреплён, G должна действительно выполняться на своём стеке, а аллокатор и Region не должны находиться в переходном состоянии. Если переключение безопасно и есть другая готовая работа, истёк таймер, появилось событие ожидания или изменился предел GOMAXPROCS, текущая G может быть снята с выполнения.
Ядро здесь не планирует горутины. Оно только предоставляет безопасную точку асинхронного входа. Какая G будет выполняться дальше, решает пользовательский runtime.
Блокирующее ожидание не всегда должно блокировать нативный поток
Если каждая горутина при ожидании просто вызывает блокирующую операцию ядра, M перестаёт выполнять остальные G. При большом числе ожиданий M:N быстро теряет смысл. Поэтому часть операций получила адаптеры, которые умеют приостановить только текущую горутину.
Ожидание процесса, ThreadJoin, ожидание новых записей лога, IRQ и обычные ожидания handles могут зарегистрировать интерес в runtime, перевести текущую G в ожидающее состояние и позволить M заняться другой работой.
Один из простаивающих M при необходимости становится потоком ожидания и одним системным вызовом ждёт события handles, собственный флаг пробуждения и ближайший таймер. Когда событие приходит, соответствующая G снова становится готовой к выполнению.
Не все системные операции принудительно переделаны в такой режим. Есть случаи, где блокируется именно M: некоторые максимальные наборы ожиданий, операции со стека планировщика, работа внутри Region и участки, где поток дополнительно закреплён.
Что изменилось в GC после появления горутин
После M:N уже недостаточно остановить нативные потоки и просканировать только их текущие стеки. В момент остановки M может находиться:
- на собственном стеке планировщика;
- на стеке выполняющейся G;
- внутри переключения между этими стеками;
- внутри goos_preempt_entry.
Кроме того, есть горутины, которые сейчас вообще не выполняются ни на одном M. Их стеки всё равно содержат живые ссылки. Поэтому перед маркировкой runtime строит план сканирования стеков. Из RSP каждого остановленного потока определяется, на каком известном стеке он находится. Затем в план добавляются стеки планировщика, сохранённые стеки приостановленных горутин и стеки M, которые в данный момент не исполняют обычную G. Для остановленного потока учитывается и 128-байтная красная зона System V ABI под сохранённым RSP: листовая функция может держать там живые значения, не изменяя указатель стека. План строится без выделений памяти и без захвата обычных runtime-блокировок. Это важно: остановленный поток сам мог держать такую блокировку.
Если RSP какого-то потока не попадает ни в один известный диапазон стека или сохранённый SP горутины находится за пределами её стека, сборка отменяется до начала маркировки. Здесь снова действует то же правило: если runtime не может доказать, где искать все корни, sweep не запускается.
Region тоже пришлось согласовать с остановкой потоков
В однопоточном варианте Region был довольно прост: поток входит в регион, текущий курсор аллокатора переключается на него, затем при выходе возвращается обратно. В многопоточной системе появляется короткий промежуток, когда часть состояния уже изменена, а часть ещё нет. Например, курсор уже записан, а указатель на текущий Region ещё не опубликован. Обычного закрепления горутины здесь недостаточно. GC останавливает нативную задачу принудительно и может попасть ровно в этот промежуток. Поэтому Enter и Leave отмечают отдельное переходное окно. Если ThreadSuspend поймал поток внутри него, runtime не строит сборку на таком состоянии: потоки возобновляются, переход заканчивается, затем остановка повторяется. По той же схеме защищён быстрый путь аллокатора. Вместо одного огромного mutex вокруг всего runtime короткие внутренние переходы имеют явный признак: «состояние пока нельзя использовать как снимок для GC».
Ошибка с XMM, которая выглядела как две разные поломки
Самая неприятная ошибка в этой работе сначала вообще не выглядела проблемой вытеснения. Под параллельной нагрузкой VFS иногда падал в ramfs.MakeName: memmove получал нулевой адрес источника при ненулевой длине. Нормальный безопасный Go-код не должен внезапно создать slice с Data=0 и положительным Len. Одновременно gcstress 8 иногда падал с другой ошибкой: arena: slab count does not match its bitmap. Выглядело так, будто одна ошибка портит slice в VFS, а другая ломает метаданные аллокатора. Причина оказалась одна.
Старая версия goos_preempt_entry сначала делала системный вызов ThreadPreemptTake и только потом сохраняла FPU/SSE-состояние через FXSAVE. Для обычного вызова функции это допустимо: XMM-регистры относятся к caller-saved, и вызываемый код имеет право их изменить. Но асинхронное вытеснение — не обычный вызов. Прерванный код не знает, что между двумя его инструкциями кто-то выполнил чужую функцию. После возврата XMM должны быть ровно такими же, какими были в момент прерывания. Системный путь успевал использовать SSE до FXSAVE и тем самым портил живое состояние пользовательского кода.
В случае VFS TinyGo в конкретном скомпилированном участке строил заголовок slice через XMM0. После неудачного вытеснения значения длины или ёмкости могли оказаться испорчены.
В случае аллокатора причина была ещё веселее. Target x86_64 GoOS не включает POPCNT, поэтому LLVM реализовал bits.OnesCount64 через SSE2. Константные маски для подсчёта битов находились в XMM3–XMM6. Если их портило асинхронное вытеснение, проверка числа занятых слотов переставала совпадать с битовой картой, хотя сама карта могла быть совершенно правильной. Исправление получилось довольно коротким: goos_preempt_entry теперь сохраняет FPU/SSE-состояние до любого системного вызова и восстанавливает его после обработки вытеснения. После этого оба класса падений исчезли в нагрузках, которые раньше их воспроизводили.
swaphold: GC на каждой достижимой границе переключения контекста
После истории с XMM обычного стресс-теста мне уже было недостаточно. В validation-сборке появились специальные операции ядра, использующие аппаратные debug-регистры x86 и пошаговое выполнение. Они позволяют остановить один поток на конкретной границе между инструкциями кода сохранения контекста и в этот момент принудительно запустить сборку мусора.
goprobe swaphold проверяет два участка:
Участок | Проверено |
| 15 из 15 границ |
| 47 из 47 достижимых границ |
На каждой такой остановке другой поток запускает runtime.GC(). Проверка считается пройденной только если сборка действительно завершилась, а данные горутины после неё остались целыми.
У goos_preempt_entry есть ещё финальный аварийный UD2, который в нормальном выполнении недостижим. Поэтому 47 из 47 здесь означает все достижимые точки, а не пропуск одной инструкции.
Эти проверки проходили и под TCG, и под KVM. Временное намеренное повреждение логики планирования стеков делало тест красным: проверка действительно реагирует на потерю конкретного корня, а не просто долго крутит систему в надежде случайно поймать проблему.
regroots: ссылка существует только в одном регистре
У swaphold остаётся слабое место консервативного GC: объект может случайно удержаться какой-нибудь второй копией адреса на стеке. Поэтому появился отдельный тест goprobe regroots. Он оставляет адрес объекта только в одном выбранном регистре, удаляет остальные видимые тесту копии и запускает GC.
Проверяются:
16 XMM-регистров —
XMM0–XMM15;7 регистров общего назначения —
RAX,RBX,RCX,RDX,RSI,RDI,RBP;8 расширенных регистров общего назначения —
R8–R15.
Всего 31 регистр.
Каждый случай проверяется в трёх вариантах: обычный нативный поток, выполняющаяся горутина и горутина, которая уже снята с выполнения. Для снятой с выполнения G ссылка должна находиться уже не в снимке регистров M, а в сохранённом состоянии на её собственном стеке. Есть и отрицательные контрольные случаи: если адрес не оставлен ни в одном проверяемом месте, объект должен быть освобождён. 15 последовательных прогонов под TCG с SMP=4 прошли все регистровые случаи с lost=0. Два чистых совместных прогона KVM на восьми vCPU также прошли swaphold и regroots.
Отдельно проверялась чувствительность теста: если перед маркировкой намеренно занулить сохранённые XMM или GPR, соответствующие объекты действительно начинают теряться. Для уже снятой с выполнения горутины такой объект остаётся живым, потому что её состояние лежит на собственном стеке.
Всё это используется не только в тестовом бинарнике
VFS теперь по умолчанию собирается с горутинным runtime. Входной обработчик VFS может одновременно допустить до восьми запросов к двум рабочим горутинам чтения. Чтения RAMFS и образов могут реально перекрываться по времени. Операции, которые меняют состояние — изменения файловой системы, операции namespace, закрытие сессии и управляющие запросы — проходят через упорядочивающие барьеры. Для одной сессии одновременно допускается не больше одного запроса. Транспорт к постоянной файловой системе при этом остаётся сериализованным. Появление параллельных чтений не означает, что протокол работы с дисковым backend внезапно стал неупорядоченным. Сохранил ещё и старый режим VFS_RUNTIME=serial как резервный, на всякий случай, позже он будет удалён.
Что показал тест многопоточного аллокатора
Для аллокатора есть показательное измерение под KVM на восьми vCPU. Каждый поток выполнял по 200 000 выделений.
Потоки | Одна блокировка кучи | Slab-страницы на поток | Разница |
1 | 31,0 мс | 31,9 мс | 0,97x |
2 | 222,5 мс | 100,9 мс | 2,21x |
4 | 611,3 мс | 361,3 мс | 1,69x |
8 | 1745,8 мс | 816,7 мс | 2,14x |
На этой нагрузке закреплённые за потоками slab-страницы примерно вдвое выигрывают у варианта с одной общей блокировкой при нескольких потоках. Но это не линейное масштабирование и не стоит его так трактовать. Куча всё равно общая. Порог GC общий. Чем больше потоков одновременно выделяют память, тем быстрее они вместе доходят до следующей сборки, а сборка останавливает все потоки процесса.
В том же измерении число сборок выросло примерно с 49 при одном потоке до 388 при восьми. Самая длинная пауза оставалась в пределах сотен микросекунд — 410 мкс в восьмипоточном случае, — но стоимость остановки и сборки никуда не исчезла. То есть оптимизация решает конкретную проблему: убирает общую блокировку с частого пути мелких выделений. Она не превращает общую кучу со stop-the-world GC в структуру с идеальным масштабированием на любое число CPU.
Что пока остаётся ограничением
На данный момент, новый релиз не превращает GoOS в стандартный Go runtime с собственной реализацией всех его возможностей. Сборщик мусора остаётся консервативным. Случайное значение, похожее на адрес в куче, может удержать уже недостижимый объект. Полных точных карт указателей для стеков и всех типов пока нет. GC синхронный и stop-the-world. Параллельной с выполнением программы маркировки нет. На время сборки останавливаются все потоки и горутины конкретного процесса, но не вся операционная система. Стеки горутин фиксированные — 256 КиБ, без автоматического роста и сжатия. По умолчанию одновременно разрешено 256 горутин, жёсткий предел таблицы — 1024. Нативных слотов потоков 16, а реальное число работающих M дополнительно ограничивается квотой задач процесса. Не каждая блокирующая системная операция умеет приостанавливать только G вместо всего M. Детерминированная проверка swaphold проходит каждую достижимую границу одного выбранного остановленного потока. Она не строит полный декартов продукт состояний, в котором несколько M одновременно остановлены на независимо выбранных инструкциях переключения контекста. Это ограничение тестового покрытия, а не режим работы GC: после принятой остановки остальные M уже удерживаются ядром и не продолжают менять кучу во время sweep.
Есть и ещё одна поправка к моей самой первой статье про GoOS. Тогда я писал, что unsafe в пользовательском пространстве сосредоточен в runtime/sys и runtime/arena. После появления собственного планировщика горутин, FS-based TCB, переключения стеков и планировщика корней правильнее сказать, что низкоуровневый unsafe сосредоточен в слое runtime. В него теперь входят в том числе runtime/goroutine и runtime/tls. Обычные сервисы и библиотеки по-прежнему не должны напрямую работать с сырыми указателями.
Что получилось в итоге
В первой части я рассказывал, как GoOS ушёл от bump allocator и общего Reset к нормальной освобождаемой куче и собственному GC. После добавления SMP-параллелизма одной этой работы оказалось недостаточно. Теперь несколько нативных потоков одного процесса могут одновременно работать на разных CPU. Для мелких выделений каждый поток имеет собственные slab-страницы. Горутинный runtime распределяет G по M, использует локальные и общую очереди, умеет переносить работу между потоками и вытеснять горутину по таймеру. VFS уже использует этот режим в обычной сборке. А GC перед sweep должен собрать полный снимок процесса: глобальные корни, Region, стек самого сборщика, стеки остальных M и G, регистры общего назначения и XMM. Если runtime не может однозначно определить хотя бы один стек или видит поток в незавершённом внутреннем переходе, сборка не выполняется.
Главное изменение в новом релизе для меня не сводится отдельно ни к горутинам, ни к многопоточному аллокатору. Появилась единая модель, в которой аллокатор, потоки, горутины и сборщик мусора знают о границах ответственности друг друга. Поток не может быть незаметно остановлен посередине изменения метаданных. Горутина не мигрирует, пока использует состояние M. GC не освобождает память по неполному снимку. А асинхронное вытеснение обязано сохранить даже те XMM-регистры, которые обычный function-call ABI разрешил бы уничтожить. Именно на таких местах собственный runtime перестаёт быть просто набором тупых заглушек для TinyGo и становится частью архитектуры операционной системы.
Архитектура уже правильного класса, но пока минимальная. Я уже избавился от очевидного ботлнека — одной глобальной блокировки на каждое выделение — и получил примерно двукратный выигрыш при contention. Следующий уровень — уже сделать так, чтобы число обращений к общей куче и число глобальных STW-событий росло намного медленнее числа потоков. Но это уже совсем другая история...
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.