Как слова и конструкция запроса меняют AI-видимость бренда
Классический поисковый маркетинг долгое время опирался на относительно устойчивую единицу анализа — ключевую фразу. Даже когда SEO-специалист объединял тысячи формулировок в кластеры, практическая логика оставалась понятной: запрос задаёт тему и приблизительный интент, поисковая система ранжирует документы, а позиции и трафик можно измерять по повторяемой шкале. Генеративный поиск эту модель ломает. Одну потребность человек описывает десятками естественных формулировок, добавляет личный контекст, ограничения и критерии. Система сама может разложить вопрос на подзадачи и собрать итоговый ответ из разных источников. [6; 7; 11; 13]
Поэтому в GEO вопроса «по какому запросу виден бренд?» уже мало. Нужно понять сценарий, который сидит в формулировке. Человек может просить назвать несколько компаний, объяснить критерии выбора, найти дешёвый вариант, выбрать надёжного подрядчика, сравнить уже известные бренды или решить узкую задачу с конкретными ограничениями. Товарная категория при этом бывает одной. Competitive set и основания для включения бренда — разными.
Задача работы — практическая система GEO-intents. Где смена слов остаётся поверхностным парафразом. Где она реально меняет информационную задачу. Около 70% материала занимает практика: модификаторы, архитектура prompt portfolio, измерение brand inclusion, ошибки мониторинга. Теоретический блок нужен, чтобы объяснить, откуда такие различия берутся.
Три класса Бродера
Андрей Бродер в 2002 г. разделил запросы на informational, navigational и transactional. Человек либо ищет сведения, либо хочет попасть в конкретное место в сети, либо стремится выполнить действие. Рамка до сих пор полезна. Современные коммерческие и диалоговые сценарии она закрывает плохо. Один запрос сразу может содержать исследование, сравнение, ограничения и готовность к действию. [1]
Для GEO интент удобнее держать как набор признаков. Один label это ловит плохо. Запрос «посоветуй надёжный сервис для миграции CRM до 50 тыс. рублей в России» сразу несёт recommendation, trust, цену, категорию, географию и стадию решения. Если оставить только label «commercial», существенная часть логики запроса пропадает.
Таблица 1. Из каких признаков складывает
Измерение интента | Примеры | Что меняется в AI-ответе |
Task / действие | объясни, посоветуй, сравни, найди, выбери | Формат ответа: объяснение, shortlist, verdict, поиск вариантов |
Funnel stage | узнать → рассмотреть → выбрать → купить | Вероятность появления брендов и степень коммерческой конкретики |
Evaluation criterion | лучший, надёжный, быстрый, безопасный | Набор критериев и доказательств |
Economics | дёшево, до N рублей, цена/качество | Допустимый ценовой сегмент и список кандидатов |
Geography | Россия, Москва, рядом со мной | Локальная доступность и local sources |
Scenario / audience | для ребёнка, для бизнеса, после ДТП | Сужение релевантного множества решений |
Constraint | без посредников, с гарантией, сегодня | Исключение части вариантов, приоритет доступности |
Brand state | без брендов / с названными брендами | Свободный shortlist против сравнения заданных кандидатов |
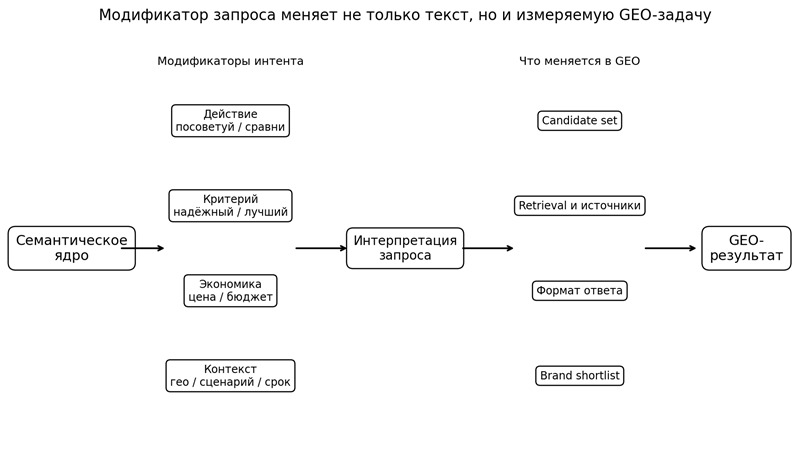
Почему маленькое слово может весить больше
Современные языковые системы не берут запрос как неделимую строку. Текст режут на токены, затем строят контекстные представления с учётом отношений элементов фразы друг к другу. Transformer сделал attention базовым способом моделировать такие зависимости. BERT показал, что двунаправленное контекстное представление хорошо работает на задачах понимания языка. [2; 3]
На практике служебное слово иногда оказывается важнее крупного существительного, потому что меняет отношение между сущностями. Google публично разбирал это на примере внедрения BERT в Search. В запросе о путешествии из Бразилии в США предлог задавал направление поездки. Вместе с ним сдвигался и набор релевантных результатов. Компания формулировала требование так: Search должен понимать слова в контексте. Короткие служебные элементы в этой логике тоже способны сдвинуть смысл. [4]
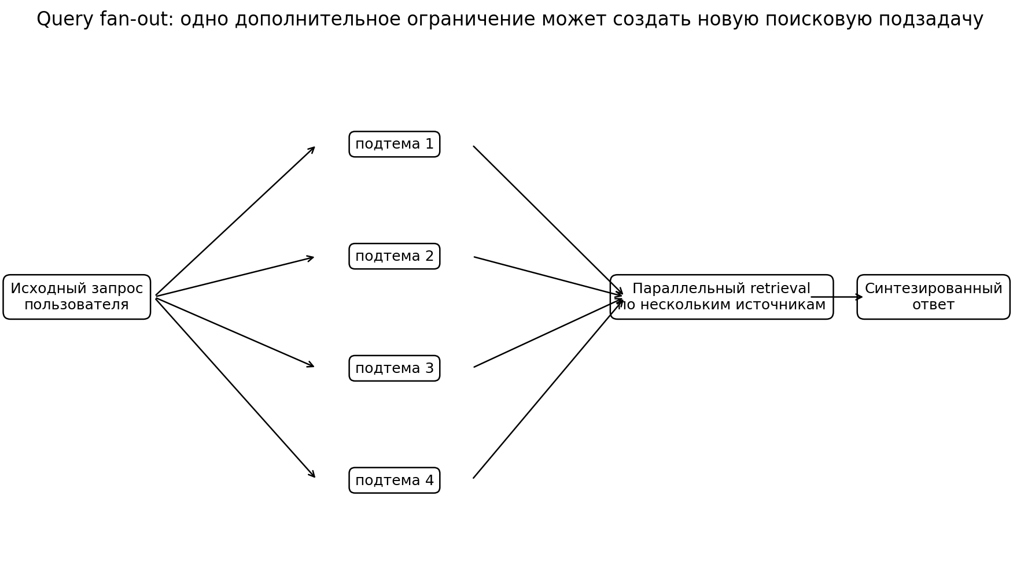
В генеративном поиске понимание текста уже не последнее звено. Система способна выделить сущности и ограничения, переписать запрос или расширить его синонимами, затем провести retrieval, переранжировать источники и только после этого синтезировать ответ. Точные реализации проприетарны. Между продуктами они расходятся, так что одну и ту же цепочку всем AI-поисковикам приписывать нельзя. Публичный механизм query fan-out в Google AI Mode даёт хотя бы один проверяемый пример. Сложный вопрос там разбивается на подтемы, и по ним запускается несколько параллельных поисков. [7; 19]
Поиск уходит от «keyword-ese» к естественному языку
Ещё до массового распространения генеративных ответов поисковые системы двигались от буквального совпадения слов к пониманию естественного языка. Google отмечал, что с 2015 г. использование естественно-языковых запросов выросло более чем на 60%. Это означает, что пользователь всё меньше вынужден угадывать «правильную ключевую фразу» и всё чаще описывает задачу так, как сформулировал бы её человеку. [5]
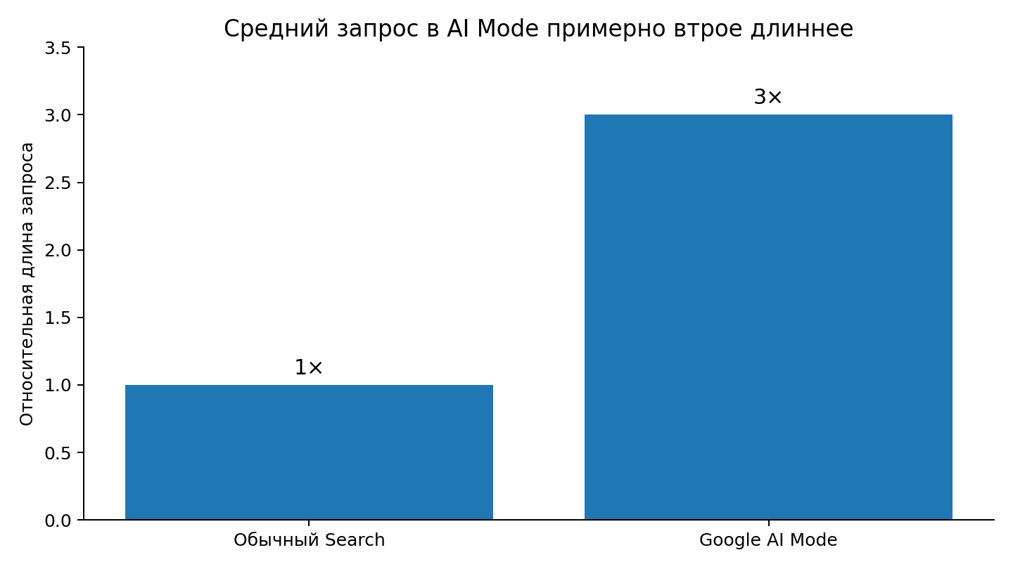
AI Mode усилил тенденцию. По данным Google за май 2026 г., средний запрос в AI Mode примерно втрое длиннее традиционного Search-запроса. Быстрее общего потока росли planning-, brainstorming- и decision-oriented формулировки. Длина сама по себе не равна сложности, но более длинный запрос чаще содержит дополнительные ограничения, критерии и контекст. [6]
Длина запроса меняет вероятность генеративного режима
Pew Research Center по реальным сессиям марта 2025 г.: длинные и вопросительные запросы чаще попадают в генеративный слой Google. AI summary сидела только в 8% запросов длиной один–два слова. В запросах из десяти и более слов — уже в 53%. Сама структура формулировки способна сменить тип интерфейса, в котором бренд конкурирует за внимание. [8]
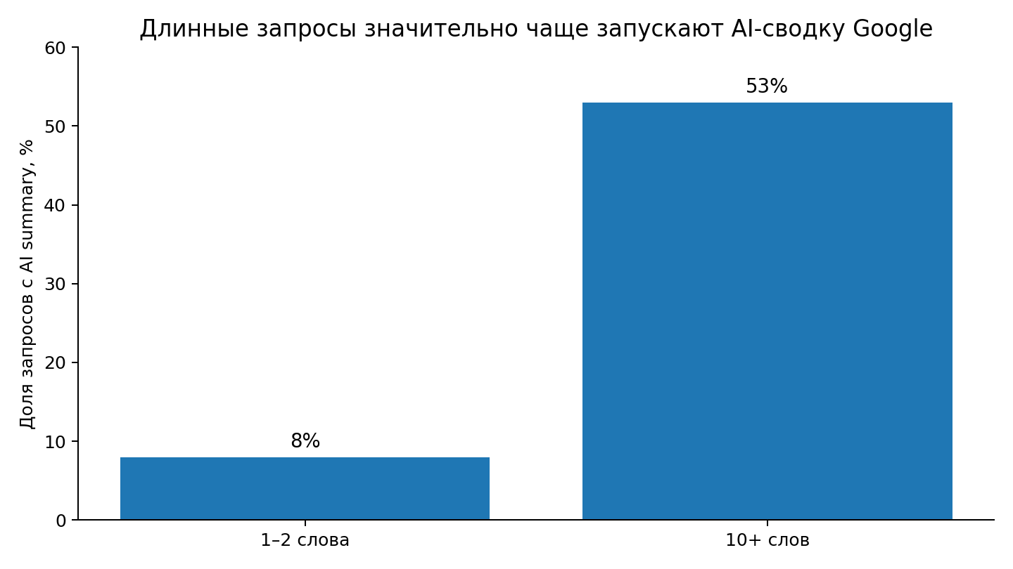
Для GEO отсюда простой эффект. Два запроса по одной теме могут попасть в разные режимы выдачи. Короткая формулировка чаще даёт традиционную SERP, подробный вопрос — AI Overview или AI Mode с синтезом источников. Prompt portfolio поэтому моделирует и семантические варианты, и естественную глубину пользовательского вопроса.
Из чего собирают GEO-intent
Коммерческий GEO-intent удобно собирать из нескольких кусков. Task, funnel, category или entity, критерии оценки, ограничения, география, аудитория или сценарий, временной контекст. Это не математика LLM, а рабочая схема для проектирования промптов. По ней отделяют семантическое ядро от модификаторов. Заранее видно, какие сдвиги фразы дают новый интент, а какие остаются парафразом.
Таблица 2. Конструктор GEO-intent.
Компонент | Контрольный вопрос при составлении промпта | Пример |
Task | Что пользователь просит сделать? | посоветуй / сравни / объясни / найди |
Funnel | Насколько близко решение? | изучает категорию / выбирает подрядчика / готов купить |
Category | Что именно является объектом выбора? | CRM, стоматология, кровля, логистика |
Criterion | По какому признаку выбирать? | лучший, безопасный, быстрый, экспертный |
Constraint | Что исключается или обязательно? | до 50 тыс.; без посредников; с гарантией |
Geo | Где должно быть доступно решение? | Москва / Россия / рядом |
Scenario | Для кого и в какой ситуации? | для малого бизнеса / после ДТП / для ребёнка |
Time | Когда решение должно быть доступно? | сегодня / в 2026 году / срочно |
«Посоветуй», «порекомендуй», «какую выбрать»
Рекомендационная конструкция уводит систему от описания категории к формированию consideration set. На запрос «CRM для малого бизнеса» модель может дать определение, критерии и несколько примеров. На «посоветуй CRM для малого бизнеса» основной задачей становится shortlist. Для бренда это принципиально: контент по теме ещё не гарантирует inclusion в свободно собранный набор рекомендаций.
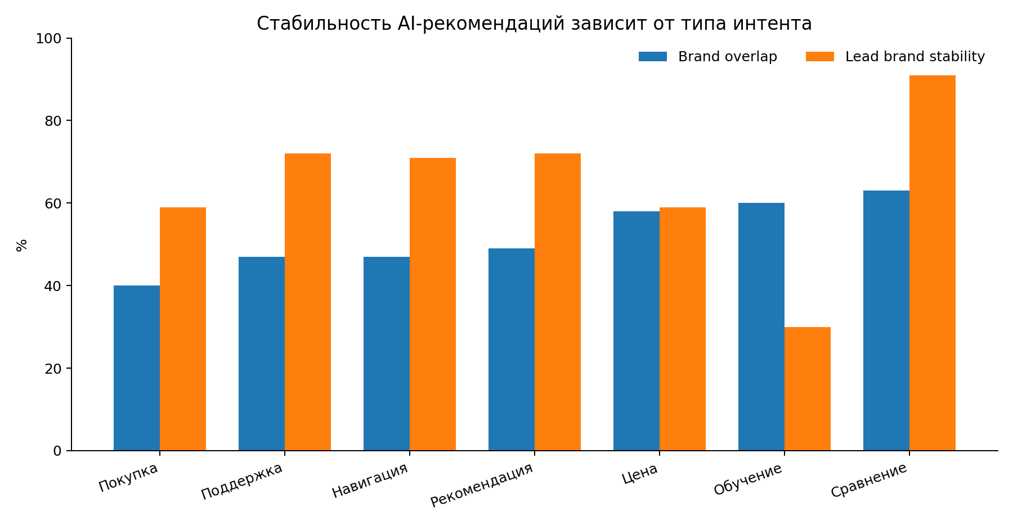
Conductor прогнал 14 тыс. API-вызовов по десяти индустриям и семи типам интентов. Recommendation prompts дали отдельный профиль стабильности: средний brand overlap 49%, lead brand stability 72%. Бренды заранее не названы, shortlist система собирает свободно. Unbranded recommendation prompts авторы советуют держать отдельно от branded и comparison сценариев. [15]
Неявный суперлатив
Человек, который пишет «лучший», «топ» или «ведущий», как правило, ждёт ранжирование. Голый перечень вариантов его обычно не устраивает. Критерии при этом почти никогда не названы, и атрибуты приходится восстанавливать, иначе внутри категории непонятно, что считать лучшим. В работах по LLM-рекомендациям такие запросы относят к implicit superlative query [18].
«Лучший сервис аналитики» чаще вытягивает крупные и широко известные бренды. Use-case появляется уже в запросе «сервис аналитики для команды из пяти человек», и нишевое решение получает шанс. Одного шаблона «лучший X» на весь коммерческий кластер мало.
Trust-сигналы
В медицине, финансах, юридических услугах и строительстве цена ошибки высока, и trust modifiers там заметнее. К отбору по товару добавляется доказательность: системе нужно показать, почему варианту можно доверять. Лицензии, опыт, отзывы, экспертные источники и понятные гарантии работают как проверяемые сигналы.
Такие слова способны сменить тип документов, которые полезны для retrieval. Порядок брендов при этом тоже может измениться. Страница с описанием услуги закрывает вопрос «кто делает X». Для «надёжная компания X» её уже мало: растёт роль репутационных и независимых подтверждений. GEO-стратегия поэтому связывает owned content с earned media, отзывами и внешними источниками. [13; 14]
Ценовые формулировки
Ценовые слова образуют отдельную ветку коммерческого интента. «Недорогой» и «до 50 тыс. рублей» задают одно допустимое множество, «цена/качество» и «выгоднее» — другое, «премиальный» — третье. Это не простые варианты одного запроса. У бренда с сильной экспертностью recommendation visibility может быть высокой. Price-fit visibility при этом оказывается низкой, если публично нет понятных цен или диапазонов.
В исследовании Conductor у Pricing prompts оказался иной профиль стабильности, чем у Recommendation или Purchase. Brand overlap составил 58%, lead brand stability — 59%, при этом 20% pricing-ответов в их эксперименте не содержали брендов. Авторы связывают часть проблемы с недоступностью структурированной ценовой информации. Даже если не принимать это как универсальную причинную оценку, результат показывает, что pricing — отдельный измерительный класс, а не подвариант общего commercial prompt. [15]
Сравнение: самый структурированный, но не самый «органический» интент
Запрос «X или Y?» радикально отличается от «посоветуй сервис». В первом случае пользователь сам определяет competitive set; модели остаётся сравнить заданные варианты. Поэтому comparison visibility нельзя смешивать с unbranded recommendation visibility. Бренд, отлично выглядящий при прямом сравнении, может вообще не попадать в shortlist, когда модели предлагается выбирать свободно.
В исследовании Conductor Comparison оказался самым стабильным из семи типов: brand overlap 63%, lead brand stability 91%. Это логично: бренды уже присутствуют в вопросе, и пространство выбора существенно ограничено. Purchase, напротив, дал overlap около 40%. Один общий «AI visibility score» скрывает это различие. [15]
География и local intent
Город, район или конструкция «рядом со мной» меняют допустимый candidate set по существу. Часть национальных брендов в нужной локации не работает, локальные компании наоборот становятся релевантными. Это не поверхностный парафраз, а ограничение задачи. «Посоветуй стоматологию» и «посоветуй стоматологию в Олонецком парке» при высокой лексической схожести всё равно следует держать разными GEO-intents.
Если у системы есть веб-поиск, география способна сменить и набор источников. В выдачу чаще попадают карты, локальные каталоги, региональные публикации, отзывы, страницы филиалов. В prompt tracking географические варианты поэтому держат отдельными сегментами и не смешивают с национальной выборкой.
Категория обрастает уточнениями
«Хостинг для Битрикс» задаёт технологическую категорию. Если добавить «для Битрикс-магазина с 50 тыс. товаров», появляется объём и use-case. Сервисный критерий появляется вместе с «с администрированием», технический — с «для высокой нагрузки». После этого часть провайдеров выпадает, а сравнение идёт уже по новым основаниям.
В B2B-закупках уточнения встречаются чаще. Абстрактное «лучшее ПО» почти не используется: в запросе уже сидят размер компании, стек, интеграции, регуляторные требования, бюджет или сценарий миграции. Мониторинг одних head terms завышает коммерческую видимость.
Явные исключения в запросе
Жёсткий фильтр в запросе не равен оттенку тона. Фразы «без посредников» и «не маркетплейс» должны убрать класс посредников из candidate set. «Без операции» или «не дороже N» сужают допустимое множество ещё сильнее. Если система ограничение поняла, часть ранее релевантных кандидатов пропадает. Срочность стоит рядом, но измеряет другое. «Сегодня», «24/7», «в наличии», «с доставкой завтра» переводят интерес в проверку доступности.
Реальную клиентскую потребность такого рода имеет смысл держать отдельным пунктом мониторинга. Собирать десятки искусственных отрицаний «на всякий случай» не стоит. Prompt portfolio нужен для вероятных пользовательских сценариев, а не для комбинаторного перебора языка.
Наложение ограничений
Модификаторы в реальной речи обычно идут пачкой. Человек пишет «посоветуй надёжную недорогую клинику для имплантации в Москве» и тем самым задаёт рекомендацию, цену, город и медицинский риск сразу. Классический keyword research такие куски часто раскладывал по хвостам. Генеративный поиск получает конфигурацию целиком и может строить ответ по их пересечению.
В материалах Google этот слой назван query fan-out [7]. AI Mode раскладывает вопрос на подтемы и запускает несколько поисков параллельно. Дополнительное ограничение способно открыть новую ветку retrieval. Репутационная проверка может пойти от слова «надёжный». «До 50 тыс.» уводит к цене, «Москва» — к локальной доступности, но это не формула «один модификатор = один search call»: такого обещания в документации нет.
Близкие recommendation-фразы
Новый интент от замены «посоветуй» на «порекомендуй» возникает редко. «Посоветуй CRM» и «порекомендуй CRM», как и «какую CRM посоветуешь», часто остаются surface forms одного recommendation intent. Отдельный учёт каждой фразы искусственно раздувает один сценарий. Формулировка «посоветуй CRM для отдела продаж до 20 человек с российским хостингом» устроена иначе. Ограничения там уже существенные, competitive set может смениться.
Практический критерий — семантический эффект. Новый intent или archetype появляется, когда сдвинулось действие, стадия воронки, критерий выбора, допустимый набор кандидатов либо обязательное ограничение. Если этого сдвига нет, формулировка остаётся вариантом внутри того же intent cluster.
Академические оценки prompt sensitivity
Оценки чувствительности LLM к формулировке в литературе расходятся. Fu и Barez фиксируют, что семантически эквивалентные парафразы способны ухудшать производительность моделей и сдвигать поведение. Hua и соавторы относят часть обсуждаемой prompt sensitivity к артефакту жёсткой оценки: лексика ответа меняется, семантическая корректность сохраняется. Меняется ли текст ответа и меняется ли фактическое решение — разные вопросы. [9; 10]
Для GEO textual similarity ответов почти ничего не даёт. Нужны объекты с коммерческим смыслом: появился ли бренд, кто вошёл в shortlist, удержалось ли первое место, какие источники использованы, сдвинулись ли аргументы рекомендации. Стилистическую вариативность и коммерчески значимую чувствительность тогда удаётся развести.
Prompt portfolio вместо одного запроса
Ehrlinspiel, Landwehr и Rudzki, 2026 г.: prompt wording и brand visibility в AI answer engines. Study A — 288 человеческих формулировок двух коммерческих задач на четырёх answer engines. Study B — 1 466 контролируемых промптов, включая 54 base prompts и 1 412 вариантов по 18 subverticals, пяти секторам и двум answer engines. Наиболее заметная контролируемая чувствительность, пишут авторы, сидит в unbranded middle-funnel commercial prompts. Измерение тогда строится как portfolio problem. [11]
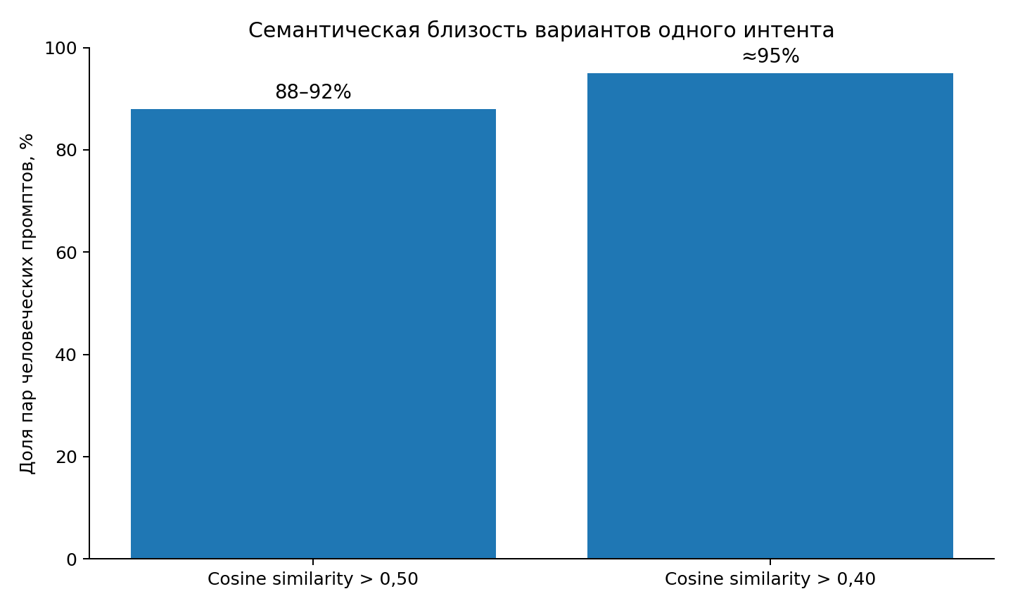
Дополнительный анализ Peec AI показывает, что человеческое разнообразие формулировок структурировано. В зависимости от embedding-модели около 88–92% пар естественных промптов имели cosine similarity выше 0,50, около 95% — выше 0,40. Большинство людей выражают одну потребность разными словами. Небольшая доля формулировок реально уходит в другие семантические области. [12]
Формулировка, baseline и источники
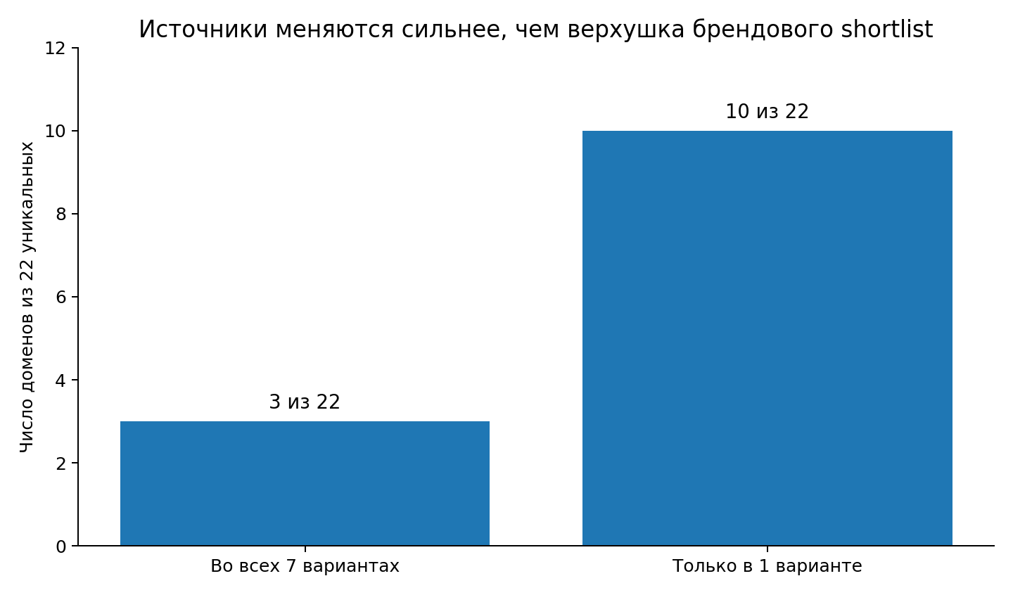
Другие работы тоже показывают практический вес wording. Характер эффекта зависит от метрики. Rankshift прогнал семь почти идентичных CRM-промптов, меняя оценочные слова («top», «best», «leading»), существительные и формулировку размера бизнеса. Верхушка брендового рейтинга держалась сравнительно устойчиво, mid-tier visibility колебалась сильнее. Источники оказались ещё чувствительнее: из 22 уникальных доменов только три входили в top sources для всех семи вариантов, десять появлялись только в одном. [16]
Chen и соавторы в крупном исследовании AI Search тоже брали контролируемые paraphrases. По чувствительности к phrasing поисковые системы расходились. Prompt variant и engine — две отдельные координаты. Стабильность на одной платформе на другую не переносят. [13]
Стадия воронки сама по себе меняет вероятность появления бренда
Формулировка отражает не только тему, но и готовность пользователя к решению. В независимом эксперименте Omniscient Digital 180 промптов по четырём индустриям дали заметный градиент: brand recommendations появлялись в 19% ответов на problem-unaware prompts, в 28% на problem-aware и в 79% на solution-aware prompts. Это не общерыночная оценка и не российская статистика, но она наглядно показывает, насколько близость к выбору способна менять brand density ответа. [17]
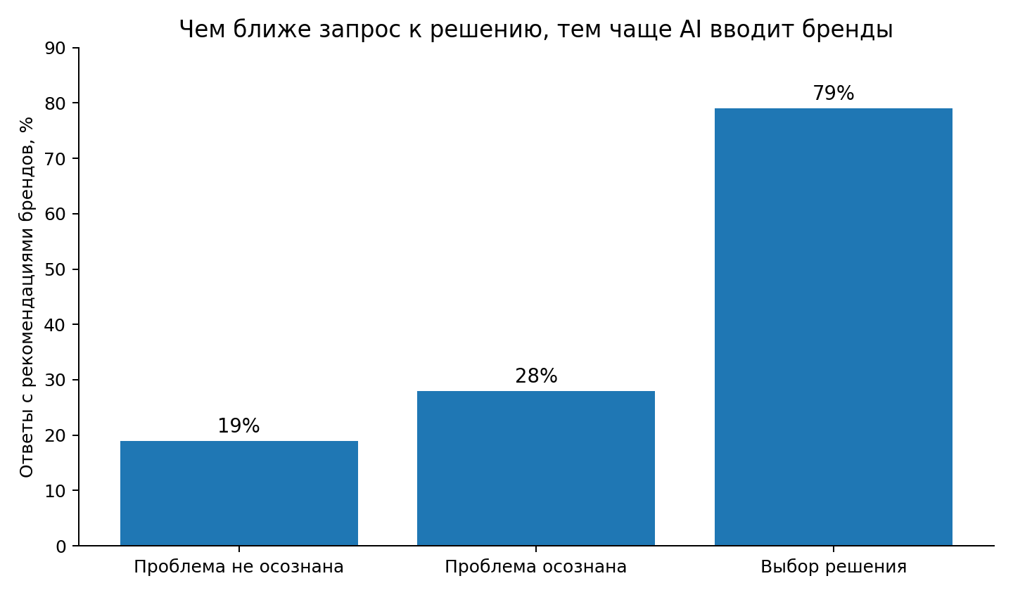
Один intent не означает один и тот же shortlist на разных AI-поверхностях
Даже при одинаковой формулировке разные answer engines могут формировать shortlist разного размера и с разной стабильностью. В исследовании Conductor ChatGPT в среднем возвращал около пяти брендов на ответ, Perplexity — 8,3, Claude — 8,5, Gemini — 9,2. Более длинный список не означает более высокую ценность упоминания: чем больше кандидатов, тем ниже относительная доля внимания каждого из них. [15]
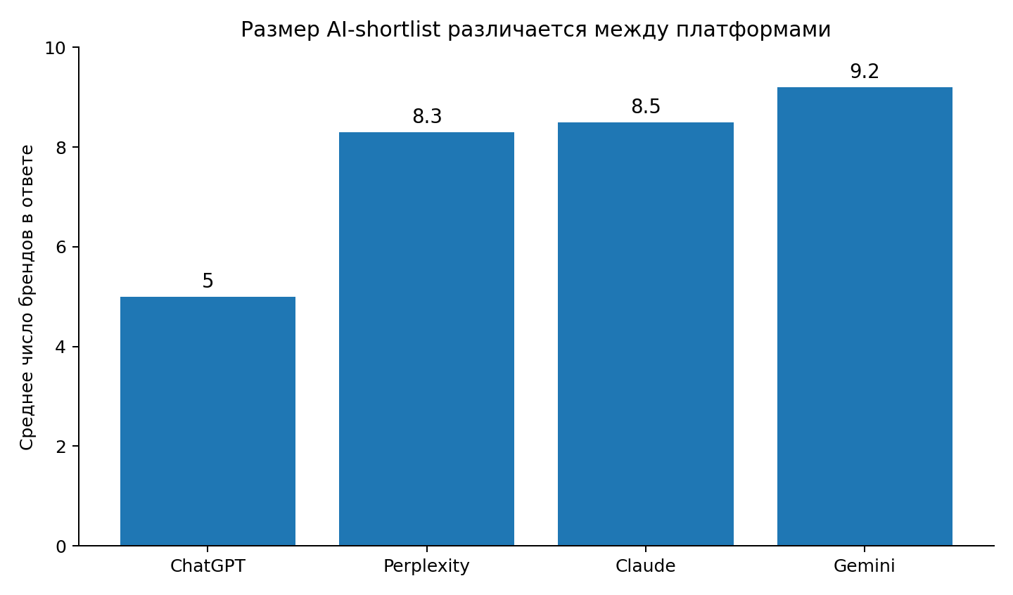
Conductor также фиксирует различия по типу задач. ChatGPT в их эксперименте был стабильнее на knowledge-oriented prompts — Comparison, Education, Navigation и Support. Perplexity лидировал по transactional-oriented категориям Pricing, Recommendations и Purchase. На все версии моделей и рынки это автоматически не переносят. Принцип другой: prompt archetype и engine образуют совместную единицу анализа. GEO-отчёт поэтому показывает видимость отдельно по платформам. ChatGPT, Perplexity, Gemini, Claude и локальные системы в одну цифру не усредняют.
Откуда брать формулировки
Практический prompt portfolio начинают с наблюдаемого языка клиента, не с генерации красивых вопросов нейросетью. Источники — Search Console и внутренняя статистика поиска, обращения отдела продаж, записи звонков, FAQ и support tickets, отзывы, комментарии, поисковые подсказки, формулировки в тендерах, brief-ы и вопросы, которые пользователи уже задают AI-интерфейсам. После сбора сырой фразеологии запросы группируют по semantic core, затем размечают по task, funnel, criterion, constraint, geography и scenario.
Процесс нужен по простой причине. Маркетинговая команда часто формулирует потребность иначе, чем клиент: компания думает категориями продукта, пользователь — проблемой, бюджетом и ситуацией. Реальные данные ещё показывают частоту модификаторов. Если клиенты постоянно спрашивают про гарантию, срок запуска или интеграцию, эти параметры получают отдельные GEO-intents, даже когда их поисковая частотность в классических keyword tools невелика.
Таблица 3. Источники для построения GEO-intent portfolio из реального языка пользователей.
Источник языка пользователя | Что из него извлекать | Как превращать в GEO-intent |
Поисковые запросы | Категории, long-tail, географию | Semantic core + local/scenario modifiers |
Продажи и звонки | Возражения, критерии, бюджет | Trust, price, comparison intents |
Поддержка / FAQ | Проблемы после выбора | Support и post-purchase intents |
Отзывы | Причины доверия и недовольства | Evidence / reputation modifiers |
Тендеры / брифы B2B | Ограничения, стек, SLA, сроки | Constraint-rich decision prompts |
AI-логи / prompt analytics | Естественные диалоговые формулировки | Semantic variants внутри cluster |
Эмпирическая проверка GeoAist: дизайн matched-среза
Для проверки гипотезы о чувствительности GEO к формулировке использован обезличенный фрагмент мониторинга GeoAist за апрель–август 2026 г. В анализ включены только успешные consideration/decision prompts, для которых можно выделить общий объект услуги и сопоставить несколько разных коммерческих архетипов внутри той же темы и той же AI-поверхности. После фильтрации получено 873 проверок, 10 тематических групп, 10 AI-поверхностей и 91 сопоставимая связка «тема × платформа». В каждую связку входило не менее четырёх архетипов запроса.
Единицей анализа является не отдельный ответ, а matched topic × platform cell. Такой дизайн частично контролирует различия между темами и движками: сравнение wording проводится внутри одной категории и одной AI-поверхности. Наблюдательный характер работы при этом сохраняется. Архетипы отличаются несколькими смысловыми элементами, число повторов неодинаково, версии моделей за период могли обновляться. Речь об устойчивых ассоциациях между типом формулировки и структурой ответа. Причинный эффект одного конкретного слова из этого не следует.
Таблица 4. Дизайн эмпирической проверки GeoAist.ru.
Параметр | Значение | Зачем нужен |
Период | апрель–август 2026 | Единое временное окно мониторинга |
Успешные проверки | 873 | Только status=done |
Тематические группы | 10 | Сопоставление внутри одной потребности |
AI-поверхности | 10 | Разделение engine-specific поведения |
Matched cells | 91 | Тема × платформа как единица сравнения |
Минимум архетипов | 4 на matched cell | Сравниваются разные механики коммерческого выбора |
Основные outcomes | brand inclusion, citations, response length | Проверяется не текстовая, а GEO-значимая вариативность |
Brand inclusion в matched-срезе
В matched-срезе средняя доля включения отслеживаемого бренда была самой высокой у конструкции «чаще всего рекомендуют» — около 6,3% topic × platform observations. Ценовой архетип «сколько стоит / адекватный бюджет» дал около 5,9%, конструкция «под ключ + надёжность» — около 4,8%. У «топ / рейтинг» и «цена / качество» baseline заметно ниже. Универсальным рейтингом слов это не является. Разные способы сформулировать коммерческий выбор создают неодинаковые условия для попадания конкретного бренда в ответ.
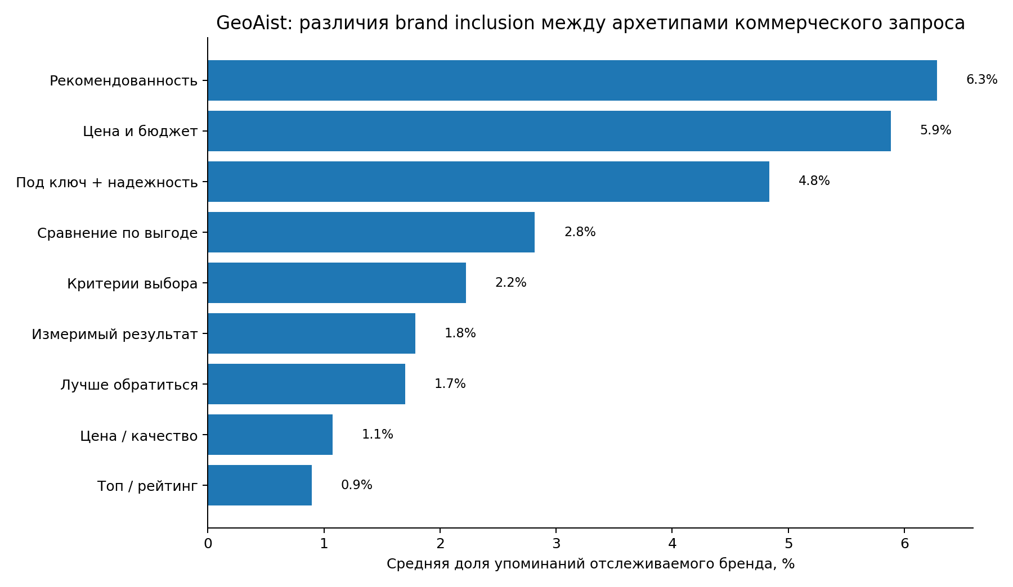
Практически это означает, что one-prompt tracking способен давать систематически смещённую оценку. Мониторинг только запросов вида «топ компаний» измеряет не то же самое, что recommendation-, price- или trust-oriented запросы, даже если товарная категория одинакова. В GEO необходимо отдельно хранить сам semantic core и способ принятия решения, который задаёт wording.
Модификатор меняет требования к доказательствам и источникам
Сильнее всего собственный срез расширяет картину на уровне citations. Архетип «под ключ + надёжность» шёл с цитируемыми источниками в среднем примерно в 60,5% matched observations. Recommendation-конструкции — около 41,3%. Цена и бюджет — 39,5%. «Топ / рейтинг» — 35,7%. На другом полюсе «лучше обратиться» и «сравнение по выгоде» — около 19,7% и 20,9%. Wording связан с candidate set. И с тем, насколько ответ строится как evidence-backed synthesis.
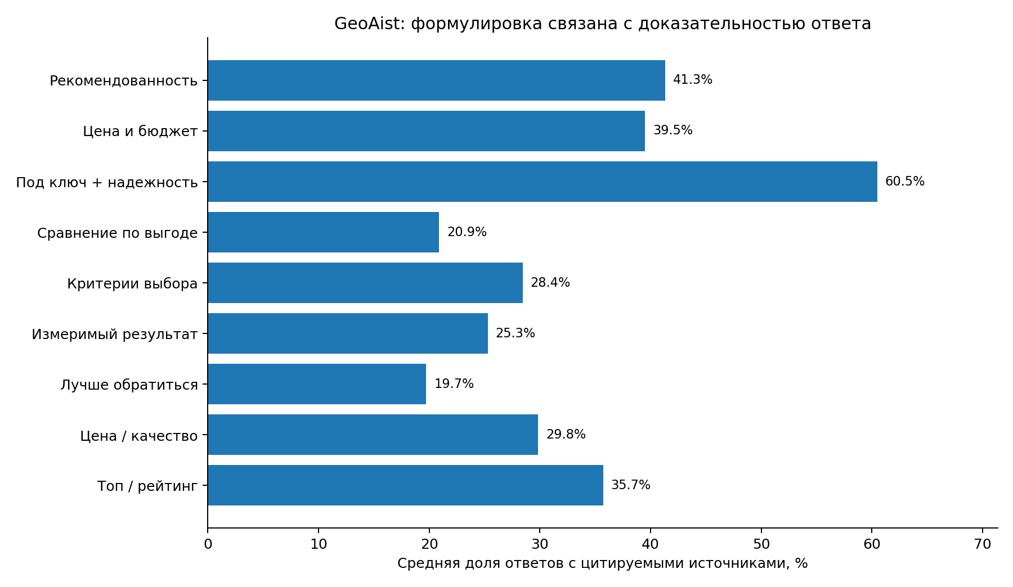
Trust-компонент здесь показателен отдельно. Конструкция «под ключ + надёжность» по brand inclusion лидером не была. По наличию источников — была. Модификатор может не поднимать число брендов в ответе. Требования к проверяемым доказательствам — да. Под trust-intent мало контента с заявлением «мы надёжные». Системе нужны подтверждения: независимые публикации, кейсы, лицензии, рейтинги, условия гарантий или иные релевантные источники.
Жанр и объём ответа
В том же matched-срезе медианная длина ответа тоже расходилась. Архетип «критерии выбора» давал самые длинные ответы — около 1,7 тыс. символов в агрегированной matched-панели — при сравнительно низкой brand inclusion. «Лучше обратиться», «под ключ + надёжность» и «измеримый результат» чаще шли короткой прикладной структурой. Запрос остаётся коммерческим по теме. Модель при этом переключается между жанром shortlist и жанром методического объяснения.
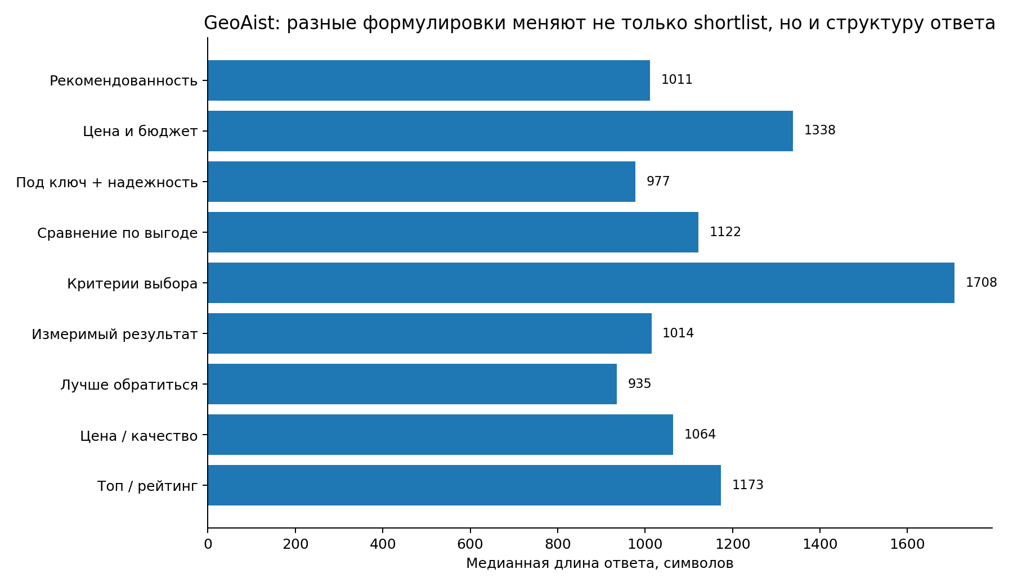
Отсутствие бренда в длинном ответе «как выбрать» с отсутствием в коротком «кого посоветуете» напрямую не сравнивают. В первом случае модель может отдавать приоритет критериям. Во втором — конкретным кандидатам. Mention Rate читают вместе с answer structure.
Внутри одной темы wording двигает сразу несколько признаков
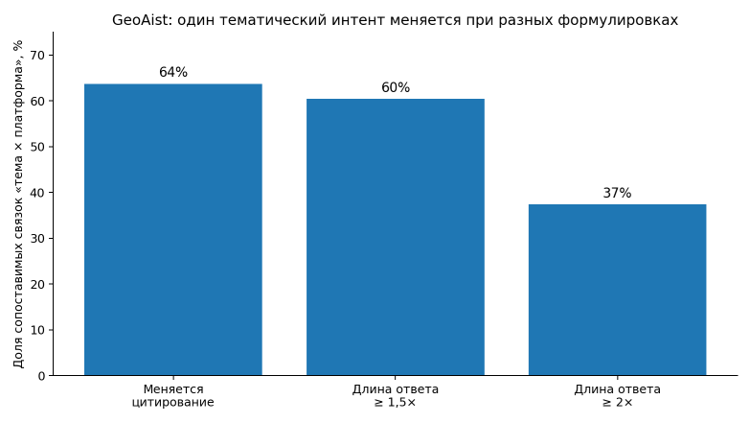
Сравнение строго внутри тех же 91 связок «тема × платформа». Влияние wording видно уже не только по агрегатам. В 58 из 91 связок (64%) между архетипами менялось наличие или частота цитируемых источников. В 55 связках (60%) максимальная медианная длина ответа была как минимум в 1,5 раза выше минимальной; в 34 связках (37%) — минимум вдвое.
Brand inclusion — более редкое событие в этой подвыборке: отслеживаемый бренд появился хотя бы в одном архетипе только в 14 из 91 matched cells. Но во всех этих 14 активных связках частота упоминания различалась между формулировками; медианный диапазон между минимальным и максимальным значением составил около 58 процентных пунктов. Из-за малого числа активных cells этот показатель нельзя экстраполировать на рынок, однако он хорошо показывает риск one-prompt measurement именно для брендов, находящихся на границе shortlist.
Чувствительность проявляется по-разному на разных AI-поверхностях
Engine-specific поведение видно и внутри matched-панели. Для каждой AI-поверхности было от 7 до 10 тематических cells, поэтому эти показатели следует трактовать как exploratory. Тем не менее паттерн неоднороден: у части систем wording чаще менял наличие citations, у других сильнее менялся объём ответа. Это согласуется с внешними исследованиями Conductor и Rankshift: prompt и engine нельзя рассматривать как независимые от контекста координаты.
Таблица 5. Наблюдаемая чувствительность к wording по AI-поверхностям в matched-срезе GeoAist.
AI-поверхность | Matched cells | Cells с изменением citations | Cells с длиной ответа ≥2× |
YandexGPT | 10 | 90% | 20% |
Google AI Mode | 9 | 89% | 22% |
Grok | 7 | 86% | 29% |
Google AI Overviews | 9 | 78% | 0% |
Perplexity | 9 | 78% | 33% |
DeepSeek | 10 | 60% | 10% |
ChatGPT | 10 | 50% | 80% |
Claude | 9 | 44% | 22% |
Алиса | 9 | 44% | 89% |
GigaChat | 9 | 22% | 67% |
Например, изменение citation behavior наблюдалось в 9 из 10 matched cells YandexGPT, в 8 из 9 Google AI Mode, в 6 из 7 Grok и в 7 из 9 Perplexity и Google AI Overviews. У ChatGPT этот тип вариации встречался в 5 из 10 cells, зато в 8 из 10 cells длина ответа между архетипами отличалась как минимум вдвое. Эти различия не являются рейтингом качества моделей: они показывают, что один и тот же prompt portfolio может проявлять чувствительность через разные измеримые признаки — sources, answer depth или brand inclusion.
Как правильно строить GEO prompt portfolio
Практическая единица мониторинга — не отдельная фраза, а intent cluster. Внутри него следует хранить несколько архетипов, которые представляют реальные способы принятия решения. Затем для каждого архетипа можно иметь ограниченное число естественных парафразов. Иначе легко застрять на одном prompt. Точная формулировка тогда получает лишний вес. Возможен и обратный перекос: сотни почти одинаковых фраз раздувают один сценарий.
Таблица 6. Иерархия GEO prompt portfolio.
Уровень | Что содержит | Рекомендуемая роль |
1. Intent cluster | Одна бизнес-потребность | Базовая единица отчётности |
2. Archetype | Рекомендация, цена, сравнение, trust, local, scenario | Показывает разные механики выбора |
3. Semantic variant | 2–4 естественных парафраза | Проверяет устойчивость к wording |
4. Engine | ChatGPT, Perplexity, Gemini, Алиса и др. | Не смешивать платформы в один ответ |
5. Repeated run | Повтор одинакового prompt | Отделяет wording от stochastic variance |
Сколько промптов достаточно на старте
Ограниченный бюджет мониторинга лучше тратить на покрытие разных механизмов выбора. Сотня почти синонимичных фраз здесь помогает слабо. Для одной категории обычно хватает 15–30 промптов. Часть из них закрывает discovery и education, часть — unbranded recommendation. Trust/quality и price/value держат отдельно, как и comparison, local/scenario, transaction/purchase. Соотношение зависит от отрасли: локальному бизнесу нужно больше географии. В SaaS чаще выходят на первый план use-case и comparison. Медицина тянет к trust/high-stakes, e-commerce — к price/specification.
Таблица 7. Практический каркас коммерческого GEO-intent set.
Блок | Пример задачи | Что измеряется |
Discovery / education | как выбрать / на что обратить внимание | Authority и появление брендов без явного recommendation |
Recommendation | посоветуй несколько компаний | Органический AI-shortlist |
Trust / quality | надёжная / проверенная / лучшая | Evidence и reputation fit |
Price / value | до N / цена-качество / выгоднее | Экономический fit |
Comparison | X vs Y / сравни варианты | Verdict и lead stability |
Local / scenario | в Москве / для бизнеса / после события | Контекстная релевантность |
Purchase / transaction | где заказать / купить сегодня | Bottom-funnel availability |
Что ломает prompt tracking
Парафразы не считают отдельными интентами. «Посоветуй», «порекомендуй» и «что посоветуешь» сами по себе не утраивают вес recommendation cluster. Покрытие проседает, если в мониторинге сидят только head prompts вроде «лучший X», а сценарии с ограничениями отсутствуют. Branded и unbranded запросы смешивать нельзя: знание бренда и способность самостоятельно попасть в shortlist — разные уровни GEO.
Comparison и recommendation тоже держат отдельно. Если бренды названы в prompt, модель organic discovery не показывает. Платформы без повторов сравнивать и потом списывать случайный reroll на «влияние слов» нельзя. Менять сразу пять компонентов запроса и вешать весь результат на один модификатор — та же ошибка. Prompt list лучше брать из реальных пользовательских формулировок, не из маркетингового языка компании.
Таблица 8. Типовые методологические ошибки prompt tracking.
Ошибка | Почему искажает GEO | Как исправить |
Один канонический prompt | Переобучение метрики на точную формулировку | 2–4 variants на ключевой archetype |
Десятки парафразов одного типа | Искусственно завышает вес сценария | Агрегировать в intent cluster |
Branded + unbranded вместе | Смешивает knowledge и recommendation | Раздельные KPI |
Нет повторных запусков | Wording смешивается со stochastic variance | Повторы/окна времени |
Только одна LLM | Engine-specific эффект выдаётся за общий | Считать платформы отдельно |
Нет funnel-разметки | Сравниваются разные задачи | Явно маркировать stage и archetype |
Искусственные промпты | Мониторинг не отражает спрос | Опора на реальные query patterns |
Откуда берётся шум
У query sensitivity шум идёт из трёх мест. Semantic variance — это про то, описывают ли варианты одну потребность. Модификатор внутри одного intent cluster может сменить саму задачу; такой сдвиг называют prompt-archetype variance. Ответ иногда меняется и при точном повторе той же фразы (stochastic variance). Если три эффекта не развести, любую разницу в ответах легко назвать «влиянием одного слова».
Если нужна именно причинная оценка, схему сужают до одного модификатора. Базовый intent оставляют, вариант несколько раз прогоняют внутри одной AI-поверхности. В протокол попадают brand set, first mention, citations, answer structure. Тот же набор затем снимают на других engines. Порядок запусков и временное окно лучше фиксировать: иначе wording-эффект смешивается с обычным мониторингом ассоциаций.
Устойчивость рядом с Mention Rate
Mention Rate сам по себе не показывает, устойчива ли видимость к смене формулировки. Пересечение shortlists разных variants считают как Brand Set Overlap. Удержание первого места — Lead Brand Stability. По источникам отдельно считают Source Overlap. Citation Rate фиксирует, появляется ли доказательная ссылка. Intent Coverage — доля реально значимых archetypes, которые мониторинг вообще покрывает.
Таблица 9. Метрики для измерения устойчивости GEO-intents.
Метрика | Что отвечает | Интерпретация |
Mention Rate | Как часто бренд включён? | Базовая AI-видимость внутри cluster |
Brand Set Overlap | Совпадает ли shortlist между variants? | Чувствительность consideration set |
Lead Brand Stability | Сохраняется ли первый бренд? | Защищённость лидирующей позиции |
Source Overlap | Используются ли одни и те же домены? | Retrieval sensitivity |
Citation Rate | Есть ли подтверждающие источники? | Доказательность ответа |
Intent Coverage | Покрыты ли реальные сценарии? | Качество самого prompt portfolio |
Variant Range | Минимум–максимум видимости в cluster | Риск one-prompt measurement |
Что из этого следует для контента
Интенты нужны не одному мониторингу. Они задают, какие доказательства AI должен уметь извлечь. Для recommendation prompts это явная связь бренда с категорией и независимая авторитетность. Price prompts требуют доступных цен и условий, comparison — структурированных характеристик. Trust prompts опираются на проверяемые репутационные и экспертные сигналы. Local prompts нуждаются в корректной географии и филиалах. Scenario prompts — в контенте, который связывает продукт с конкретной задачей пользователя.
GEO не сводится к тому, чтобы вставить на сайт слово «лучший». Нужны machine-readable основания, по которым бренд подходит под конкретный modifier. Запрос «надёжный» требует, чтобы в источниках были свидетельства надёжности. Формулировка «для малого бизнеса» имеет смысл, только если применимость к малому бизнесу доказана. При «до N рублей» цена должна быть публично доступна и актуальна. Формулировка prompt, по сути, сообщает системе, какой тип доказательства придётся искать.
35. Следствия для измерения GEO
Поисковый интент в генеративной среде плохо укладывается в один класс informational/commercial/transactional. На практике его удобнее держать многомерной конфигурацией действия, стадии воронки, критериев, ограничений, географии и сценария.
Изменение слов само по себе ещё ничего не означает. Парафраз может почти не сдвинуть semantic intent. Price-, trust-, local- или scenario-modifier способен изменить допустимый candidate set и retrieval-задачу. Поэтому в GEO необходимо различать semantic variants и intent modifiers.
Третий вывод: естественно-языковой поиск делает запросы длиннее и содержательнее. Google фиксирует рост natural-language queries и трёхкратную разницу в средней длине AI Mode queries; Pew показывает, что длинные запросы существенно чаще вызывают AI summary. Формулировка всё чаще определяет не только результат, но и сам режим поиска. [5; 6; 8]
Четвёртый вывод: внешние исследования сходятся в главном — одна фраза недостаточна. Peec AI показывает необходимость портфельного измерения wording variations, Conductor — сильные различия стабильности по intent type, Rankshift — повышенную волатильность источников даже при близких формулировках. [11; 12; 15; 16]
Пятый вывод: matched-срез GeoAist показывает, что query sensitivity проявляется сразу в нескольких GEO-измерениях. Архетипы различались по brand inclusion, citation propensity и длине ответа; в 58 из 91 сопоставимых связок менялось citation behavior, а в 55 из 91 длина ответа между вариантами отличалась как минимум в 1,5 раза.
Шестой вывод: trust- и evidence-oriented формулировки требуют отдельной интерпретации. В собственном срезе конструкция «под ключ + надёжность» имела не максимальную brand inclusion, но наиболее высокую долю ответов с цитируемыми источниками — около 60,5%. Значит, модификатор способен менять прежде всего доказательную архитектуру ответа, а не только число брендов.
Чувствительность к wording зависит от engine. В matched-срезе одни AI-поверхности чаще меняли citation behavior, другие — глубину и объём ответа. Видимость поэтому считают отдельно по платформам: единый усреднённый GEO-score без engine breakdown важные различия может спрятать.
Единица GEO-мониторинга — intent cluster: несколько archetypes, ограниченное число semantic variants, отдельно по engines и в повторных запусках. Шума меньше, реальное разнообразие пользовательского языка видно лучше. Для причинной оценки одного модификатора semantic core фиксируют, один параметр меняют последовательно, условия запуска держат одинаковыми.
Материал готовила аналитическая команда Geoaist. На портале мы каждый день смотрим, какие источники нейросети тащат в ответы и как в этой выдаче выглядят бренды.
Источники
[1] Broder A. A Taxonomy of Web Search. ACM SIGIR Forum, 2002. DOI: 10.1145/792550.792552. https://doi.org/10.1145/792550.792552
[2] Vaswani A. et al. Attention Is All You Need. 2017. https://arxiv.org/abs/1706.03762
[3] Devlin J. et al. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL, 2019. https://aclanthology.org/N19-1423/
[4] Google. Understanding searches better than ever before, 25.10.2019. https://blog.google/products-and-platforms/products/search/search-language-understanding-bert/
[5] Google. Our Search Liaison on 25 years of keeping up with search, 2022. https://blog.google/products-and-platforms/products/search/danny-25-years-of-search/
[6] Google. How AI Mode is changing and expanding the way people search in the U.S., 19.05.2026. https://blog.google/products-and-platforms/products/search/ai-mode-us-insights/
[7] Google. AI Mode in Google Search: Updates from Google I/O 2025. https://blog.google/products-and-platforms/products/search/google-search-ai-mode-update/
[8] Pew Research Center. Google users are less likely to click on links when an AI summary appears in the results, 22.07.2025. https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
[9] Hua A. et al. Flaw or Artifact? Rethinking Prompt Sensitivity in Evaluating LLMs. EMNLP 2025. https://aclanthology.org/2025.emnlp-main.1006/
[10] Fu T., Barez F. Same Question, Different Words: A Latent Adversarial Framework for Prompt Robustness. EMNLP 2025. https://aclanthology.org/2025.emnlp-main.1595/
[11] Ehrlinspiel J., Landwehr M., Rudzki T. Prompt Tracking Works, But Not as a One-Prompt Measurement System. SSRN, 2026. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6914539
[12] Search Engine Journal / Peec AI. Prompt Tracking: Does prompt variance impact brand mentions?, 2026. https://www.searchenginejournal.com/ai-prompt-intent-keywords-peec-spa/576201/
[13] Chen M., Wang X., Chen K., Koudas N. Generative Engine Optimization: How to Dominate AI Search. 2025. https://arxiv.org/abs/2509.08919
[14] Aggarwal P. et al. GEO: Generative Engine Optimization. KDD 2024. DOI: 10.1145/3637528.3671900. https://doi.org/10.1145/3637528.3671900
[15] Conductor. AI Brand Recommendation Study: Why Intent Type Predicts AI Output Consistency, 2026. https://www.conductor.com/academy/ai-recommendation-consistency-analysis/
[16] Rankshift. The Impact of Prompt Phrasing on AI Brand Visibility, 20.03.2026. https://www.rankshift.ai/blog/impact-of-prompt-phrasing-on-ai-brand-visibility/
[17] Omniscient Digital. Do LLMs recommend brands even when users aren’t shopping? Research. https://beomniscient.com/blog/llm-brand-recommendations-customer-journey/
[18] Generative Product Recommendations for Implicit Superlative Queries. NAACL SRW 2025. https://aclanthology.org/2025.naacl-srw.8/
[19] Google for Developers. Rewriting Queries / Expanding Search Queries with Synonyms. https://developers.google.com/custom-search/docs/queries
[20] GeoAist. Платформа аналитики AI-видимости и GEO. https://geoaist.ru/
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.