Чему нас научило тестирование платформы «ИИ-интервьюер»
Привет, Хабр! Меня зовут Полина, я эксперт по исследованиям, работаю на стыке аналитики и ИИ. Мы с командой big data T2 создали цифровую платформу «ИИ-интервьюер», которая ускоряет и автоматизирует проведение полного цикла качественного исследования.
В этой статье я расскажу какие инсайты мы получили после тестирования этой платформы, какие проблемы оказались действительно критичными и почему для исследовательского ИИ-продукта «работает» ещё не означает «можно доверять».
Погружение в контекст
Когда создается ИИ-инструмент для качественных исследований, первая мысль звучит довольно просто: если модель умеет задавать вопросы, поддерживать диалог с пользователем и анализировать ответы, значит половина задачи уже решена.
На практике всё оказалось сложнее. Мы в big data T2 решили провести серию тестирований, чтобы комплексно оценить работу продукта на всех этапах пользовательского пути. Мы проверяли не только интерфейс. Нам было важно понять, можно ли доверить ИИ часть работы исследователя, чтобы автоматизация не ломала логику интервью, не подменяла высказывания респондентов и не превращала аналитику в красивый, но недостоверный отчет.
Поэтому на одном из этапов развития платформы мы сознательно вышли за рамки обычного QA и провели экспертное юзабилити-тестирование полного пользовательского пути — от брифа до аналитического отчёта.
Почему обычного QA оказалось недостаточно
Функциональность интерфейса можно проверить довольно просто: нажимается ли кнопка, сохраняются ли данные, открывается ли экран и т.д. Но для платформы, которая претендует на роль исследовательского инструмента, этого мало.
Нам нужно было ответить на более сложные вопросы: соответствует ли сценарий логике реального исследования, правильно ли передаются параметры между этапами, не нарушает ли ИИ методологию проведения интервью, можно ли проверить результаты анализа и понимает ли сам исследователь, где закончились его вводные и началась генерация модели.
Именно поэтому объектом тестирования стал не отдельный экран, а весь CJM продукта.
Как мы тестировали платформу
В тестировании участвовали 7 внутренних экспертов: специалисты по исследованиям цифровых интерфейсов, рынка и аналитике. Наша цель была — оценить, насколько текущая версия платформы соответствует реальному пользовательскому сценарию проведения качественного исследования и требованиям профессиональных исследователей.
Эксперты последовательно проходили основной сценарий продукта и комментировали процесс по ходу работы.
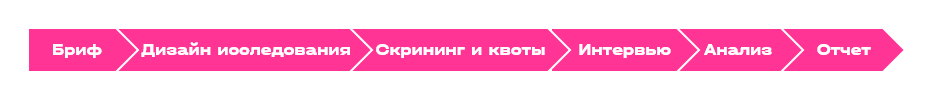
Сценарий тестирования состоял из следующих этапов:
формирование брифа
подготовка гайда
настройка скрининга, квот и доп. параметров выборки
прохождение интервью в роли респондента и оценку работы ИИ-модератора
проверку аналитического блока, категорий, цитат, выводов и отчета
работу с проектами, статусами и административными элементами платформы
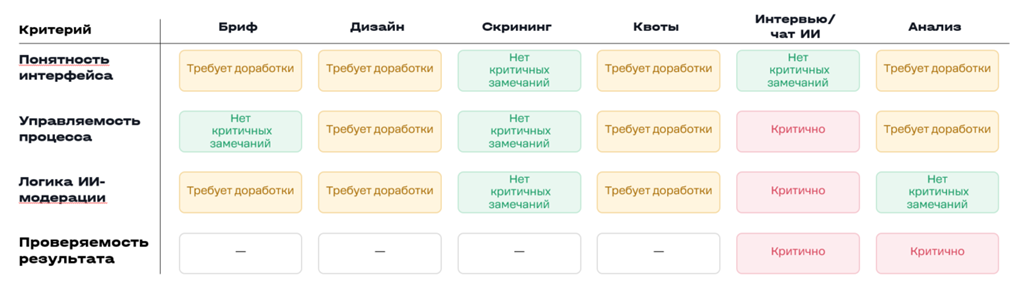
Для анализа использовалась логика CJM: замечания сопоставлялись с конкретными этапами пути и оценивались с точки зрения понятности интерфейса, управляемости процесса, логики ИИ-модерации и проверяемости результата.
Мы структурировали улучшения через User Story, а баги через Problem Story. То есть фиксировали не просто «переименовать кнопку» или «ИИ повторяет вопрос», а роль пользователя, его потребность, проблему и ожидаемый результат.
«Как [роль], я хочу [действие/возможность], чтобы [получить ценность]».
5 инсайтов, которые мы обнаружили
Инсайт 1 - ИИ должен быть соавтором, а не «чёрным ящиком»
Эксперт воспринимает ИИ не как отдельную подсказку, а как соавтора рабочего процесса. Ценность возникает, когда ИИ сразу предлагает содержательный результат и пользователь может проверить, изменить и перегенерировать его.
Что это означает для продукта:
Автоматизация должна сочетаться с управляемостью: платформе необходимы прозрачная логика генерации, редактирование результатов и поддержка версионности и возможность вмешиваться в аналитическую логику.
Инсайт 2 - платформа должна ощущаться как единый процесс
Пользователь хочет видеть в платформе привычную исследовательскую логику, а не набор отдельных экранов. Повторный ввод данных и отсутствие связи между этапами снижают заявленную ценность автоматизации.
Что это означает для продукта:
Необходимо обеспечить бесшовную передачу исследовательских параметров: ЦА, скрининг, выставление квот и ограничения должны автоматически генерироваться и продолжать пользовательский сценарий.
Инсайт 3 - автоматизация не должна лишать исследователя контроля
Платформа должна поддерживать итерационный характер исследовательской работы. Автоматически сформированный результат не должен становиться неизменяемым.
Что это означает для продукта:
Архитектура платформы должна поддерживать редактирование и версионность. Например, блок аналитики должен быть редактируемым элементом, который можно адаптировать под методологию конкретного проекта.
Инсайт 4 - доверие заканчивается там, где начинаются неподтверждённые факты
Доверие к продукту снижается, когда модель добавляет новые смыслы и контекст без подтверждения. Для профессионального инструмента происхождение каждого содержательного элемента должно быть доказано иначе возникает риск подмены исследовательских фактов предположениями модели.
Что это означает для продукта:
Поведение ИИ должно контролироваться и прозрачно показывать, какую информацию добавил исследователь, а какую сгенерировал ИИ.
Инсайт 5 - красивый вывод еще не аналитика
Качество ИИ-продукта оценивается по соответствию методологии проведению качественных исследований. Текст в выводах может быть грамматически корректным, но продукт не будет восприниматься как исследовательский инструмент, если ИИ не удерживает контекст и генерирует неподтвержденные выводы.
Что это означает для продукта:
Необходимо вводить критерии качества на уровне поведения ИИ: нейтральный язык, удержание текущего блока, запрет на неподтвержденные факты, обязательная связь аналитического вывода с первичными данными.
Пользователи готовы делегировать ИИ работу, но не ответственность
Один из самых устойчивых сквозных инсайтов оказался довольно прагматичным. Исследователи не сопротивляются автоматизации как таковой. Наоборот, они готовы передавать ИИ рутинные и трудоёмкие операции — подготовку гайда, первичную структуру отчета, поиск повторяющихся тем в транскриптах. Логику интервью, критические настройки выборки и финальную интерпретацию исследователь хочет видеть прозрачными и редактируемыми.
В нашем случае это привело к важному правилу: ИИ должен быть не «чёрным ящиком, который знает лучше», а управляемым соавтором, чьи действия можно проверить и изменить.
Для исследовательского ИИ-продукта это особенно полезно, потому что часть багов лежит на границе UX, логики модели и методологии.
Вместо вывода
Экспертное тестирование показало нам простую вещь: ценность ИИ-Интервьюера определяется не степенью автономности системы, а её способностью выполнять исследовательские действия предсказуемо, корректно и под контролем специалиста.
Самой критичной зоной остается ИИ-интервью на этот этап приходится большая часть багов. Потеря контекста, добавление неподтвержденных гипотез, некорректная глубина уточнений способны менять качество получаемых данных.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.