GitOps «сломал» CI/CD — настраиваем промоушен: от костылей и sed до Kargo (разбор на практике и неочевидные нюансы)
Всем привет! На Хабре я уже писал про пайплайны по push-модели: это когда коммит доезжает до продакшена без ручного вмешательства, за один цикл. И эта система хорошо работала, пока мы не перешли на GitOps: тут-то непрерывный конвейер CI/CD и оказался разорван пополам.
Меня зовут Андрей Шилов, я инженер по практикам DevOps в «Экспресс 42». В статье расскажу, где в GitOps рвётся цепочка CI/CD, какими костылями её чинят вручную и какие инструменты есть в индустрии, чтобы её собрать. Начну с Argo CD Image Updater и Renovate, затем перейду к встроенным в Argo CD и Flux механизмам управления синхронизацией и закончу Kargo. Часть инструментов мы с командой прогнали на стенде, так что это будет не сухой пересказ документации, а наш опыт: какие нюансы нашли, какие проблемы возникли, что увидели сами. В конце статьи — немного о том, кому вообще не нужен GitOps.
Содержание:
Недавно одни наши клиенты рассказали, что внедрили у себя Argo CD и GitOps. Технически всё работало, но от пользователей пришла обратная связь: неудобно и непонятно. Раньше разработчик видел деплой прямо в пайплайне: зелёный — значит, выкатилось. Теперь же пайплайн заканчивался на сборке образа, а дальше нужно было идти в отдельный GitOps-репозиторий или в интерфейс Argo CD и разбираться, доехала ли версия, а если нет, то почему. Чтобы выкатиться в следующее окружение, приходилось делать MR в чужой репозиторий. Итог звучал так: «Мы к такому не готовы, раньше было лучше». Пришлось откатить всё назад.
Сначала это могло показаться частным случаем. Но со временем мы видим всё больше клиентов, которые возвращаются к классической push-модели, и в комьюнити я тоже часто встречаю такое мнение. С каждым разом я всё сильнее убеждаюсь, что дело не в конкретной команде и не в Argo CD, а в самом паттерне GitOps. Он создаёт разрыв конвейера, и команды закрывают его как умеют: кто-то костылём, кто-то отдельным инструментом, а кто-то откатывается к обычному непрерывному конвейеру по push-модели.
Где рвётся конвейер
Пока конвейер CI/CD жил в классической push-модели, всё было относительно просто. Пайплайн сам решал, когда и что выкатывать, и делал это самостоятельно, вплоть до продакшена, если были настроены все автоматические стейджи. Фактически весь конвейер умещался в один .gitlab-ci.yml:
stages:
  - build
  - deploy

build:
  stage: build
  script:
    - docker build -t registry.example.com/myapp:$CI_COMMIT_SHORT_SHA .
    - docker push registry.example.com/myapp:$CI_COMMIT_SHORT_SHA

deploy-prod:
  stage: deploy
  script:
    - helm upgrade --install myapp ./chart --set image.tag=$CI_COMMIT_SHORT_SHA -n prod --wait --timeout 5m
  environment:
    name: production
  rules:
    - if: '$CI_COMMIT_BRANCH == "main"'
Мы собирали образ и тут же, в этом же пайплайне, накатывали его в кластер. Буквально один запуск от коммита до работающего ворклоада в Kubernetes: пайплайн зелёный — значит, на проде новая версия. Зоны ответственности тоже не размывались: кто отвечает за результат, было понятно всем, — тот, кто запустил пайплайн, и тот, кто последним влил код в ветку.
GitOps эту простоту разрушает, но разрушает сознательно по нескольким причинам.
Первая, конечно же, безопасность. У CI-раннера по-хорошему не должно быть никакого прямого доступа к продакшен-кластеру. Вместо этого в парадигме GitOps в кластере крутится агент (Argo CD, Flux), который сам подтягивает нужное состояние из Git. Секреты и доступы не размазаны по раннерам, а лежат в одном месте, и CI-раннер просто собирает код. Зоны ответственности разведены довольно чётко.
Вторая: в GitOps Git является единственным источником правды. Желаемое состояние кластера всегда описано в репозитории, и больше не нужно лезть в логи прошедших пайплайнов. Чтобы узнать, что должно быть задеплоено, мы смотрим в Git. А доехало ли оно на самом деле и в каком состоянии, показывает уже Argo CD.
Третья причина: drift detection и self-healing. Если кто-то поправил что-то в кластере руками, GitOps-агент это заметит. А вернёт ли он состояние к описанному в Git сам, без участия CI, зависит от настроек: в Argo CD для этого нужен автосинк с selfHeal: true. Без него агент просто покажет, что кластер разошёлся с репозиторием.
И последняя: деплой не зависит от доступности CI. В push-модели недоступный раннер зачастую означал заблокированный деплой, потому что один и тот же раннер и собирал, и деплоил. А агент в кластере может докатить откат конфигурации, даже если сборщики лежат.
CNCF GitOps Working Group формализовала это в четырёх принципах OpenGitOps:
Declarative — управляемая система имеет желаемое состояние, описанное декларативно.
Versioned and Immutable — каждая версия желаемого состояния неизменяема: изменение не переписывает старую версию, а добавляет новую, поэтому сохраняется полная история.
Pulled Automatically — программные агенты сами забирают описание желаемого состояния из источника.
Continuously Reconciled — агенты непрерывно наблюдают за фактическим состоянием и приводят его к желаемому.
Но интереснее то, чего в этих четырёх пунктах нет. В них ни слова о том, как желаемое состояние должно меняться, какие люди или какие автоматизации могут его менять и как оно переходит от окружения к окружению. Фактически спецификация OpenGitOps описывает, что происходит уже после того, как изменение попало в Git. А как оно туда попадает и как потом едет от окружения к окружению, остаётся за скобками. Но как раз здесь и живёт промоушен.
Что такое промоушен?
Промоушеном в GitOps называют продвижение проверенной версии приложения по цепочке окружений, от dev до prod. Сначала образ выкатывается в dev, потом проходят какие-то проверки, он катится в условный staging, а после staging — в prod (или в любые другие окружения, которые есть в инфраструктуре).
Важно, что по этой цепочке всегда едет одна и та же версия. В проде оказывается ровно тот же артефакт, который мы изначально выкатили в самое нижнее окружение, в dev: один и тот же образ, а не его пересборка с тем же тегом. В push-модели весь этот путь проходил один пайплайн, поэтому отдельного слова для этого процесса и не требовалось.
Из того, что промоушен не является частью GitOps, вытекают все дальнейшие расхождения: каждая команда закрывает этот процесс по-своему. Кто-то пишет sed-скрипты, кто-то берёт инструменты вроде Image Updater и Kargo (о них поговорим позже), а некоторые вообще развёртывают самописный портал.
Вместе со всем этим pull-модель развела по разным углам две вещи, которые раньше были одним непрерывным процессом:
CI собирает артефакт как можно быстрее. Это короткая, дешёвая, быстрая автоматическая задача.
CD довозит артефакт до продакшена, но безопасно и поэтапно, переходя из одной среды в другую — иногда за часы, иногда за дни. Это долгий процесс с другими принципами и паттернами, с другой природой.
Раньше это был один конвейер, а теперь их два, и у каждого свои ответственные. Команда разработки живёт в CI-репозитории: постоянно пушит новый код и собирает образы. Платформенная команда или DevOps живут в GitOps-репозитории и сами или с помощью инструментов автоматизации решают, когда там появится новый тег или дайджест. Этот тег должен как-то приехать из CI-репозитория в GitOps-репозиторий, а моста между ними GitOps по методологии CNCF «из коробки» не даёт.
Короткий дисклеймер, чтобы не спутать. Ломается не непрерывность в смысле пауз в выполнении пайплайна или проверок. В обычной push-модели в GitLab CI был точно такой же manual approve, и с ним прекрасно жилось. Ломается именно протокол передачи между двумя системами. Это стык между двумя репозиториями, двумя разными владельцами (разработкой и DevOps/платформой) и двумя абсолютно разными жизненными циклами. Спецификация не описывает, как команды должны взаимодействовать на этом стыке, и каждая команда закрывает его сама.
Зоопарк самописных решений
Пока спецификация OpenGitOps не говорит, как правильно, появляется много самодельных решений. Вот несколько самых частых из тех, что мы видим у клиентов и в индустрии.
Ручной MR в CD-репозитории. Кто-то просто идёт в GitOps-репозиторий и вручную правит тег в манифесте. Это действительно работает, но всегда остаются человеческий фактор и задержка между CI и CD: никто не гарантирует, что как только образ собрался, он сразу задеплоился — этот разрыв по времени есть всегда. Аудит фиксируется только в истории коммитов, которую, конечно же, никто не читает. Единственный гейт здесь — человек, который мёржит, но смотрит он только на тег, а результатов проверок в MR, как правило, нет.
Бамп прямо из CI-задачи (job). Делается это с помощью sed или yq: после сборки образа CI-задача сама идёт в CD-репозиторий и правит тег.
# .gitlab-ci.yml, задача в конце CI-пайплайна.
bump-cd-repo:
  stage: promote
  script:
    - git clone https://ci-bot:${CD_REPO_TOKEN}@gitlab.example.com/platform/gitops-repo.git
    - cd gitops-repo
    - yq -i '.image.tag = "'"$CI_COMMIT_SHORT_SHA"'"' apps/myapp/values.yaml
    - git commit -am "bump myapp to $CI_COMMIT_SHORT_SHA"
    - git push
  rules:
    - if: '$CI_COMMIT_BRANCH == "main"'
Выглядит как автоматизация, но работает, я бы сказал, костыльно, особенно с точки зрения безопасности. CI-репозиторий получает токен на запись в CD-репозиторий, и та самая граница безопасности, ради которой в том числе затевался переход на GitOps, снова размывается: CI-репозиторий напрямую влияет на то, какой тег будет стоять в GitOps-репозитории. И опять-таки нет никакого гейта: тег коммитится автоматически сразу после сборки, и никто не проверяет, прошла ли эта версия предыдущее окружение и весь цикл от dev до целевого. Например, если values-файл относится к prod-релизу, образ уедет туда, минуя все остальные окружения.
Вебхук или скрипт по событию из registry. Мы часто видим, что команды придумывают свои кастомные вебхуки или скрипты, которые дёргаются по событию из registry. По сути это то же самое, что и предыдущий вариант, только асинхронно. Упал вебхук — не факт, что кто-то увидит это в мониторинге, пока не заметят, что что-то не докатилось до прода.
Свой портал промоушена. Этот вариант нас сильно впечатлил. Команда одного крупного банка решила, что раз готового инструмента нет, можно написать свой. Получился большой внутренний портал с правилами, регламентами и красивым UI, в котором специально выделенные люди руками двигали артефакт между окружениями — с кнопками, апрувами, историей и согласованиями. Но при всём этом теги в GitOps-репозитории всё равно бампили руками DevOps-инженеры. Портал фактически просто перемещал образы контейнеров из одного registry в другой и управлял решением «что катить», а не механизмом записи в Git. В итоге бамп тега как был ручным, так и остался, просто теперь с красивым UI поверх и тонной регламентов.
Подобных решений мы видели много. Где-то это скрипт-обёртка перед раскатыванием: он проверяет, есть ли в кластере нужные зависимости (оператор БД, service mesh, cert-manager), при необходимости доставляет их и только потом пушит результат в GitOps-репозиторий. Фактически это императивный код поверх декларативной конфигурации, написанный только ради связки, которой нет «из коробки».
Всё это действительно работает, пока команда маленькая и никто не спрашивает про аудит, RBAC и постепенный роллаут образов между окружениями. А когда такие вопросы начинают задавать, приходится либо пилить свой портал, либо смотреть на готовые инструменты.
Есть ещё отдельная боль, которую мы в этой статье не трогаем: GitOps ломает не только конвейер деплоя, но и сам цикл локальной отладки. Результат доступен только после мержа, и дебажить приходится огромной пачкой тестовых коммитов. В нашей практике мы нередко видели в ветке окружения полсотни коммитов вроде test-1, test-2, test-3. Иногда под это поднимают второй кластер для dev-ветки или у разработчиков есть свой локальный кластер. Но это, пожалуй, тема для отдельного материала.
Промоушен — это два разных вопроса
Промоушен на самом деле состоит из двух больших треков. Прежде чем переходить к инструментам, попробую их развести, чтобы было понятно, что это две совершенно разные задачи. И обе относятся к зоне, которую принципы OpenGitOps не описывают.
Бамп артефакта. Как сообщить CD-репозиторию, что появился новый тег, образ или дайджест. Это то, что мы только что разобрали.
Промоушен между окружениями. Не просто «как бампнуть тег», а «как провести изменение по цепочке dev → staging → prod со всеми условиями перехода, проверками, гейтами и наблюдаемостью того, что и где сейчас развёрнуто». Сюда же относится перенос образа между registry, когда у prod свой изолированный registry и проверенный артефакт нужно туда скопировать — как в истории с порталом банка выше. Эта задача крупнее, но в обсуждениях промоушена её часто путают именно с бампом тега.
Проверки и гейты
Версия едет в следующее окружение, только когда её проверили. Но какие это проверки? Без ответа на этот вопрос инструменты не сравнить: непонятно, чего от них вообще ждать.
Проверка даёт конкретный факт об артефакте. Например: все тесты прошли, в образе нет критических CVE, под с этим образом стал Healthy, p99 после канарейки не вырос. А гейт — это точка, где по фактам из проверок решают, пускать ли артефакт дальше. Главное свойство гейта в том, что он может остановить артефакт, не пустить его дальше. Если проверку провели, но её результат ни на что не повлиял и версия всё равно едет дальше, это просто отчёт: посмотреть результат можно, а остановить выкатку нельзя.
И ещё: гейт пропускает или останавливает конкретную версию, а именно конкретный образ с конкретным дайджестом. Если механизм не знает, какая версия сейчас едет, и просто открывает или закрывает выкатку целиком, это уже стоп-кран, а не гейт.
Отсюда не самое очевидное следствие: инструмент промоушена не заменяет проверки качества. Он может учитывать состояние приложения, но проверки посерьёзнее происходят на стороне CI, Argo Rollouts или мониторинга. А инструмент промоушена либо умеет связать их результат с решением «пускать или нет», либо не умеет. По этому признаку мы дальше и будем сравнивать инструменты.
Почему с гейтами вообще так сложно в pull-модели? В классическом CI/CD есть процесс, который можно остановить: пайплайн увидел проблему, вышел с ненулевым кодом и встал. А в GitOps с автосинком такого процесса нет. Контроллер видит изменение в ветке и приводит систему к этому состоянию, попытка за попыткой, до победного конца. Когда всё уже в main и контроллер подтянул изменения, остановить это одной кнопкой не получится: фактически оно уже выкатывается. Поэтому просто добавить проверку перед деплоем, как в push-модели, здесь не работает: нет точки, куда этот гейт можно вставить.
У каждого окружения по факту две границы. На входе вопрос: можно ли этому артефакту сюда попасть? На выходе вопрос: что должно с ним случиться в этом конкретном окружении, чтобы считать его проверенным и пустить в следующее? Выход из одного окружения и вход в следующее — по сути, одно решение, и именно на этот стык удобно и выгодно ставить гейт.
Какие проверки где ставить? Тут есть один принцип: проверка живёт в самом раннем окружении, где она может надёжно и чётко ответить на свой вопрос. В нашей цепочке самое раннее — это dev, дальше staging и так далее. В жизни окружений часто больше, например между dev и staging стоит отдельное окружение для QA, но принцип тот же. Чем раньше стоит проверка, тем дешевле ошибка и тем быстрее цикл обратной связи. Поэтому про каждую проверку полезно спрашивать не «куда её поставить», а «можно ли поставить её раньше».
Из этого вытекает несколько правил.
Всё, что не зависит от окружения (юнит-тесты, линтеры, сканирование образа, подпись), проверяется один раз и как можно раньше, в CI. Это свойства самого артефакта, а артефакт, как мы помним, в dev и в prod один и тот же. Это и есть первый гейт: в registry, откуда инструмент промоушена берёт образы, должно попадать только то, что прошло CI.
Каждое следующее окружение кумулятивно добавляет то, что нельзя было проверить в предыдущем. Например, в staging есть данные, близкие к продовым, и продовые версии соседних сервисов, с которыми наш сервис связан. А у prod уже есть реальный трафик. Стремиться стоит к тому, чтобы бóльшая часть проверок была в ранних окружениях и дальше не повторялась. Если staging условно повторяет проверки dev, это бессмысленный ритуал: гейт на выходе из него не узнает ничего нового. Исключение — хотфикс, который едет сразу в staging или prod и пропускает ранние окружения вместе с их проверками. Как с этим жить, во многом зависит от модели ветвления.
Строгость гейта растёт вместе с ценой ошибки. В dev всё происходит автоматически и быстро, а на входе в prod уже может появиться человек: согласовать релизное окно и взять на себя ответственность. А внутри prod может работать «канарейка» с автооткатом, чтобы при проблемах вернуться на прошлый релиз.
Для типичного сервиса это может выглядеть так:
Окружение | На входе | Что проверяем здесь | На выходе |
CI | — | Юнит-тесты, линтеры, сканирование образа, подпись | Всё зелёное — образ попадает в registry |
dev | Прошёл CI | Деплой, старт, smoke, контрактные тесты с соседями | Healthy и зелёный smoke; промоушен автоматический |
staging | Проверен в dev | e2e, миграции на копии данных, нагрузка, совместимость с продовыми версиями соседей | Всё зелёное и N часов без алертов |
prod | Проверен в staging, окно релиза, одобрение | «Канарейка» с анализом метрик, автооткат | Метрики «канарейки» в норме, выкат на 100 % |
Дальше пробежимся по инструментам, и по каждому я буду отмечать две вещи: что он закрывает (бамп, промоушен или сразу оба вопроса) и какие гейты даёт. Сначала разберём инструменты для бампа, потом — для промоушена.
Стенд. Image Updater и Kargo мы проверяли в рабочем кластере: Kubernetes 1.33, уже работающий Argo CD 3.4.4, GitLab CI на Kubernetes-раннере без privileged. Версии инструментов — Image Updater v1.2.2, Kargo v1.12.3. Приложение — минимальный HTTP-сервер на Go, который отвечает своей версией. Для отдельных сценариев мы собирали ещё два образа: подменённый под уже существующим тегом и падающий на старте. Окружения dev, staging и prod — три неймспейса в одном кластере.
Argo CD Image Updater: только бамп тега
Argo CD Image Updater — это отдельный контроллер из экосистемы Argo, который устанавливается в кластер рядом с Argo CD. Он просто ходит в registry и спрашивает, нет ли там подходящего образа новее того, что сейчас развёрнут под контролем Argo CD. Если есть, сам меняет тег.
Что именно отслеживать, описывается в ресурсе с очень простым kind — ImageUpdater. Там указывается:
какие Application и какие образы в них отслеживать;
где в манифестах находится указание на тег образа;
как выбирать версию: стратегия (semver, самая свежая сборка, digest) и ограничение вроде
1.x;куда записать результат — это называется write-back, о нём ниже.
Сам Argo CD про Image Updater ничего не знает. Для него это просто кто-то, кто поменял параметры Application или закоммитил их в репозиторий, на который Argo CD и смотрит.
Тут важно подсветить ограничение. Image Updater работает только с приложениями, манифесты которых шаблонизируются: Helm или Kustomize. С «голыми» YAML-манифестами он работать не умеет. Тег он обновляет через параметры приложения (под капотом, по сути, argocd app set --helm-set), а не патчит произвольный YAML. Так что слой шаблонизации обязателен. На стенде мы проверили, как это выглядит, и это не очень информативно. Ошибки нет, статус ресурса ImageUpdater — READY, а единственный след — маленький warning в логе контроллера, к которому у прикладной команды обычно и доступа нет:
level=warning msg="skipping app 'argocd/myapp-plain' of type 'Directory' because it's not of supported source type"Записать новый тег можно двумя принципиально разными способами. Это и есть метод write-back, и от его выбора зависит, останется ли Git источником правды: один режим пишет в репозиторий, другой правит кластер в обход него. Какой способ предпочтительнее, пожалуй, понятно: GitOps подразумевает, что точка правды очевидна, и это Git.
Тем не менее режим write-back по умолчанию — argocd. В нём Image Updater обновляет сам ресурс Application в кластере, а в Git версия никак не фиксируется. Желаемое состояние теперь живёт сразу в двух местах: в Git и в объекте, который реально применён. История изменения тега в Git не остаётся, а это, как мы знаем, прямое нарушение принципа GitOps. А если Application управляется из Git, следующий же синк перезапишет всё, что накатил Image Updater. Не знаю, кому этот способ может пригодиться и действительно ли кто-то создаёт Application через ClickOps. Но, повторюсь, это не очень похоже на GitOps, что бы ни было написано в названии инструмента.
А вот режим git уже коммитит тег в репозиторий. В манифесте указываем параметр gitConfig.writeBackTarget и файл с values. Если его не задать, Image Updater сам создаст файл .argocd-source-<appName>.yaml, а Argo CD подхватит его автоматически и наложит сверху с наивысшим приоритетом. Писать можно прямым коммитом в ветку, а можно через MR: тогда каждое обновление проходит обычное ревью. В этом случае Git остаётся источником правды. Но опять есть «но»: Image Updater должен где-то хранить креды на запись в CD-репозиторий. Получаем те же проблемы с безопасностью, что и в sed/yq-бампе, просто креды переехали из CI-задач в секрет внутри кластера Kubernetes.
Вот рабочий пример манифеста для режима git:
apiVersion: argocd-image-updater.argoproj.io/v1alpha1
kind: ImageUpdater
metadata:
  name: myapp
  namespace: argocd
spec:
  writeBackConfig:
    method: git:secret:argocd/myapp-git-write   # Secret с sshPrivateKey.
    gitConfig:
      branch: main
      writeBackTarget: helmvalues:/values-dev.yaml
  applicationRefs:
    - namePattern: myapp-dev
      images:
        - alias: app
          imageName: registry.example.com/myapp:1.x   # Без :1.x на стенде взял и 2.0.0-rc.1.
          commonUpdateSettings:
            updateStrategy: semver
          manifestTargets:
            helm: { name: image.repository, tag: image.tag }
Резюмируя: режим git — это, пожалуй, просто автоматизированная версия sed-бампа. Стратегии версионирования есть «из коробки», самодельных скриптов нет, CI-раннеру доступ на запись больше не нужен — правда, эти права никуда не исчезают, а переезжают в Image Updater. Но закрывается только бамп тега. Многостадийного промоушена с проверками он не делает, просто бампит. И гейтов нет: образ уезжает в окружение, как только появился в registry, поэтому всё, что должно его остановить, надо проверить ещё в CI.
Однако в процессе тестирования Argo CD Image Updater мы нашли ряд нюансов, которые стоит проговорить на берегу, чтобы вам было проще решить, брать его к себе или нет.
Ограничение версии лучше задавать всегда. Мы опубликовали подряд версии 1.0.1, 1.1.0 и 2.0.0-rc.1. Image Updater, у которого была настроена стратегия semver, взял все три, включая и релиз-кандидат, и смену мажорной версии, и успешно всё обновил:
Successfully updated image '...:1.1.0' to '...:2.0.0-rc.1'По документации pre-release нужно разрешать явно, но на деле это работает, только если в имени образа задано ограничение вроде 1.x. А без него проходит всё подряд: обновимся хоть до сотой версии.
Хвост от прежнего режима. Пожалуй, самая неприятная находка. Мы переключили write-back с файла по умолчанию на конкретный values-файл, то есть с генерируемого автоматически.argocd-source-*.yaml на явно указанный. При этом старый сгенерированный файл остался в репозитории и продолжил перекрывать наши values: он задаёт Helm-параметры, а они приоритетнее values. В итоге в values-файле у нас версия 1.1.0, а Argo CD показывает, что синхронизировано на 1.0.1. Ни Argo CD, ни статус Image Updater ничего из этого не показывают, и помогает тут только удалить файл руками. Штука неочевидная, её надо держать в голове.
Задержка между сборкой и деплоем. Это может оказаться критичным. В нашей установке Image Updater опрашивал registry раз в две минуты, Argo CD репозиторий — раз в три, и фактически под обновлялся примерно через 3,5 минуты. Это время складывается из двух циклов опроса, со стороны Image Updater и со стороны Argo CD, и в худшем случае может набегать ещё больше. Для dev-среды, где разработчик регулярно пушит фиксы и хочет сразу их проверять, это бывает очень критично. После push-модели, где деплой стартовал сразу за сборкой, такая пауза кажется очень долгой и здорово сбивает рабочий ритм. Можно, конечно, повесить дополнительные вебхуки и на Argo CD, и на Image Updater. Но это ещё два компонента, которые нужно настроить и поддерживать, плюс лишняя когнитивная нагрузка.
Pull-through mirror. Ещё один нюанс, который легко может застать врасплох. Image Updater наследует особенности registry, который опрашивает. А в крупных компаниях часто используют проксирование: целевой registry настроен как зеркало вышестоящего. Поведение тут зависит от реализации, но в некоторых зеркалах новый тег появляется в индексе только после того, как кто-то хотя бы раз его запулил. До этого момента для Image Updater тега не существует, и ошибки, соответственно, тоже нет. Так может вылезти неочевидная проблема, которая на самом деле не проблема Image Updater и даже не проблема вовсе, а просто особенность проксирующего registry. Это стоит иметь в виду.
Итого: по моему мнению, для схемы «dev всегда на последней сборке» Image Updater подходит хорошо. Легко регулировать и контролировать, какая версия окажется на dev, внедрить его практически ничего не стоит. Он действительно удобный и работает достаточно очевидно, если не считать перечисленных подводных камней. При этом промоушена между окружениями тут нет вообще: это решение задачи простого автобампа для конкретного окружения. Смело можно брать для dev, preview-стендов и динамических окружений, но никак не для продвижения образов до прода.
Renovate: бамп снаружи кластера
Тут стоит упомянуть ещё один инструмент — Renovate.
Важно: это не GitOps-инструмент. Он вообще ничего не знает ни про Argo CD, ни про промоушен, ни про Application — в общем, ни про что из этого GitOps-зоопарка.
Это обычный бот, который бампает зависимости. Но у него есть менеджеры под Kubernetes-экосистему, и фактически он решает ту же задачу, что бамп через sed/yq или Image Updater.
Что у него есть:
argocd — бампает образы, чарты и git-теги прямо в манифестах Application;
kubernetes — также обновляет образы в сырых манифестах;
helm-values — ссылки на образы в values-файлах;
kustomize — блок images в
kustomization.yaml, а заодно версии подключённых чартов;flux — версии чартов в HelmRelease и ссылки на источники Flux.
Механика у него простая. Renovate не патчит манифесты напрямую и не правит живые объекты в кластере. Всё, что он делает, — открывает MR в CD-репозиторий, а дальше это обычные ревью и merge flow, которые уже есть в команде и которыми управляет человек. Фактически это просто автоматизация ручного MR: только вместо человека, который должен вспомнить, зайти и поправить тег, MR по расписанию открывает бот. И раз финальный результат работы Renovate — всегда обычный коммит через MR, проблемы с дрифтом, как у Image Updater в режиме argocd, здесь нет: никто не правит live-объекты, и никаких прав на доступ к кластеру не требуется.
Image Updater в git-режиме, как мы уже говорили, тоже умеет открывать MR, так что по контролю изменений они близки. Разница в другом: Image Updater живёт в кластере и завязан на Argo CD, а Renovate работает снаружи, прав в кластере ему не нужно, и он закрывает все зависимости одним инструментом.
Что касается промоушена, Renovate опять-таки никак не оркестрирует переход между окружениями и не умеет ждать верификации. Его, конечно, можно скомбинировать с паттернами, которые мы опишем в следующем разделе, но это уже ваша автоматизация поверх классического механизма Renovate. Гейт у Renovate — ревью MR. А гейтом по проверкам он становится, только если к MR привязаны пайплайны, которые запускаются по этому событию и обязательны для мержа.
И, как всегда, есть вопрос с доступами. Renovate бывает и SaaS, и self-hosted, но в любом варианте размещения ему нужен доступ на запись в репозиторий, и это, конечно, не особо приятно. Тут вообще для всего класса инструментов, которые мы описали, есть общее правило: им требуется запись в CD-репозиторий. Так что вопрос, наверное, не в том, нужен ли доступ, а в том, кому мы доверяем запись в CD-репозиторий: контроллеру в кластере, CI или стороннему SaaS.
Таким образом, Renovate хорошо подходит там, где каждое обновление версии хочется видеть отдельным MR с ревью и обязательными пайплайнами. Например, для staging и prod, где автоматический бамп делать страшно, а вручную команды эксплуатации забывают это сделать. Особенно если Renovate уже работает в команде для обновления зависимостей: тогда бамп образов — это пара строк конфигурации, а не новый компонент в кластере. И, как и Image Updater, промоушен между окружениями он не делает — только бамп.
Промоушен между окружениями без отдельного инструмента
В предыдущих разделах мы много говорили про бамп тега, а теперь стоит вернуться ко второй задаче — непосредственно промоушену. Если мы хотим двигать артефакты между окружениями, а заводить в текущий стек дополнительный компонент не хочется, можно прийти к одному из паттернов, которые фактически сводятся к стратегии ветвления и выбору инструмента шаблонизации.
Branch-per-environment. Для начала поговорим о паттерне, который используют многие: одна ветка отвечает за одно окружение. Этот подход неизбежно сталкивается с критикой: если конфигурация окружений просто лежит по разным веткам, которые не мёржатся друг в друга, это антипаттерн. Ветки в такой модели превращаются в те же директории, только сильно неудобнее, потому что приходится переключаться между ветками. И это действительно противоречит духу и GitOps, и самого Git.
Но, как мне кажется, называть это антипаттерном не всегда справедливо. Отдельная ветка на prod полезна с точки зрения безопасности: её можно защитить от людей, которые не должны туда мёржить. Кроме того, она даёт чистую историю: git log по ней показывает только то, что действительно мёржилось в prod, и это добавляет определённое удобство.
И тут, пожалуй, можно найти компромисс. Директории в первую очередь нужны для хранения различий конфигурации между окружениями: в каждой ветке лежит одинаковый набор директорий, условно dev, stage и prod, а внутри — конфигурации окружений. А ветки стоит использовать совсем для другого — как гейт. В такой схеме промоушен (условно из staging в prod) оформляется как MR из staging-ветки в prod-ветку, а ветка служит точкой ревью и апрува. В этом случае ветки как раз регулярно мёржатся, и в этом весь смысл. Так что всегда стоит прикинуть разные варианты, но в целом этот вполне жизнеспособен.
ApplicationSet с matrix- и git-генераторами. Рядом с моделью ветвления и шаблонизацией в стеке с Argo CD часто используют ApplicationSet. Это, конечно, не инструмент промоушена, а скорее инструмент генерации по шаблону: matrix комбинирует несколько списков, git-генератор берёт окружения из файлов или директорий в репозитории, и задача у него одна — размножить конфигурацию (как это устроить на практике — я подробно разбирал в отдельной статье). Ближе всего к порядку в нём Progressive Syncs: стратегия RollingSync синхронизирует приложения шагами (сначала dev, потом staging), и ждёт, пока они станут Healthy. Но фича пока в beta, а что именно едет и прошло ли оно проверки, она не знает.
Kustomize overlays с каскадным бампом. Общая база плюс оверлей на каждое окружение, а CI-задача или бот последовательно поднимает тег по оверлеям. Здесь мы чуть лучше соблюдаем DRY, но логика каскадного бампа пишется руками и зачастую оказывается хрупкой.
Trunk-based с короткоживущими ветками. Этот вариант снимает вопрос постоянных веток окружений на корню: он обходится без staging- и prod-веток, и все кластеры фактически смотрят на main. Чтобы проверить изменение, создаётся короткоживущая ветка, на неё временно переключается тестовый кластер, изменение валидируется и мёржится обратно в main. При большом потоке изменений это превращается в подобие merge train. Стоит заметить, что такой подход требует высокой инженерной зрелости команды. Но это хороший контрпример к распространённому мнению, что без branch-per-env не обойтись.
Гибрид. Случается и гибридный подход: Image Updater или Renovate автоматически катят в dev, а в staging и prod изменения едут вручную через MR с ревью, то есть там появляется человек.
И тут, пожалуй, стоит назвать общую проблему всех этих паттернов. Условия перехода между стадиями (какие проверки прошли, кто согласовал, можно ли катить дальше) живут не декларативно, а в головах и в россыпи CI-скриптов. Если смотреть с точки зрения гейтов, то на входе стоит человек, который принимает MR, а выходные критерии, то есть при каких условиях артефакт покидает окружение, нигде не описаны. И условное «проверено в staging» каждый понимает абсолютно по-своему.
Встроенные механизмы управления синхронизацией
Мы много говорили о том, что точки, куда можно вставить гейт, в pull-модели GitOps нет. Но такую точку можно создать искусственно: для этого у Argo CD и Flux есть встроенные механизмы, которые позволяют управлять тем, когда и что синхронизируется. Сразу оговорюсь: это не полноценный промоушен, а скорее рабочий компромисс, как остановить выкатку между окружениями. И многие команды фактически на этом функционале и живут.
Sync Windows (Argo CD). Это окна, в которые синхронизация разрешена или запрещена. Действуют они и на автоматические, и на ручные синки, но ручной синк можно явно разрешить даже внутри закрытого окна. Типичный сценарий — планировать (schedule) обычные релизы, то есть откладывать их до нужного окна, и при этом оставлять проход для хотфиксов. Примерно так это выглядит в AppProject:
spec:
  syncWindows:
    - kind: deny
      schedule: "0 9 * * 1-5"   # По будням с 9:00.
      duration: 9h               # До 18:00 автосинк в prod закрыт.
      applications:
        - myapp-prod
      manualSync: true           # Ручной синк для хотфиксов разрешён.
Слабое место в том, что окно работает с приложением целиком и ничего не знает о версиях. Оно задаётся в AppProject по расписанию для целых приложений, и пока окно открыто, в прод может заехать любой свежий коммит — неважно, проверен он или нет. Чтобы что-то изменить, приходится править само окно через Git, а настройки, чтобы одобрить конкретное продвижение, не существует. И ещё один момент: ручными для Argo CD считаются не только синки, которые запускает человек, но и синки от инструментов промоушена вроде Kargo. Так что окно с manualSync: true пропустит и их — к этому мы вернёмся в разделе про стенд.
Suspend/resume Kustomization (Flux). В экосистеме Flux есть ручной стоп-кран — suspend и resume для Kustomization. Мы можем приостановить реконсиляцию конкретного ресурса, то есть заставить Flux-контроллер перестать постоянно сверяться с Git. Пока реконсиляция стоит, можно спокойно подебажить или что-то потестировать руками, а потом возобновить:
flux suspend kustomization myapp-prod
# Отлаживаем, проверяем руками.
flux resume kustomization myapp-prod
Это работает, но перекладывает часть работы контроллера, а значит, и часть отладки, на вас.
Sync waves и hooks (Argo CD). Это механизм применения ресурсов по очереди: волнами по номеру из аннотации или хуками на этапах синка. Рабочий пример: ставим Job с миграциями БД перед основным синком, и деплойменты поедут, только когда миграции завершатся. Упала миграция — дальше ничего не катится:
apiVersion: batch/v1
kind: Job
metadata:
  name: myapp-migrate
  annotations:
    argocd.argoproj.io/hook: PreSync
    argocd.argoproj.io/hook-delete-policy: BeforeHookCreation
spec:
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: migrate
          image: registry.example.com/myapp:1.1.0
          command: ["./migrate", "up"]
Такой самодельный верификационный гейт на механизмах Argo CD, без сторонних зависимостей.
Эти механизмы на самом деле не стоит грести под одну гребёнку гейтинга. Из трёх гейтом можно назвать только sync waves с хуками, потому что в них есть верификация. Но и это гейт внутри выкатки в одно окружение, а не на стыке между окружениями. Оставшиеся два — фактически стоп-кран и maintenance window. Они что-то ограничивают, но абсолютно ничего не знают о том, какой артефакт едет и какие проверки он прошёл.
И всё же этим набором закрывается значительная часть того, ради чего люди смотрят в сторону того же Kargo, если хватает точечных стоп-кранов и не нужна сквозная наблюдаемость конвейера.
Kargo: полноценный промоушен
В предыдущем разделе мы увидели, что все паттерны упёрлись в одну проблему: условия перехода между окружениями нигде централизованно не описаны, и что значит «артефакт проверен в этом окружении», каждый понимает по-своему. Kargo выносит всё это в единые объекты, описанные декларативно. В них можно явно описать, что сейчас едет, где оно проверено и куда его можно пустить дальше.
Kargo делает Akuity — компания, которую основали создатели Argo CD, и делался этот инструмент как раз для того, чтобы закрыть боли промоушена между окружениями. Стоит отметить, что продукт достаточно новый и мало у кого он есть в продакшене. Ни у нас, ни у клиентов его пока тоже нет, но, разбираясь в теме, мы подняли несколько стендов и хотим поделиться опытом.
Как это работает
С Kargo проще всего разобраться, если пройти полный жизненный цикл одного образа.
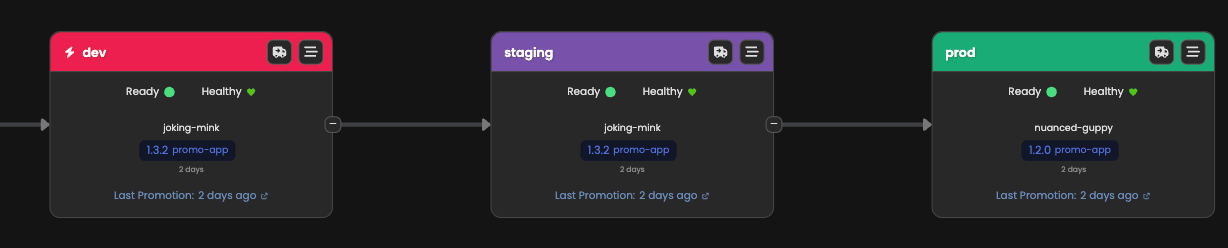
Покажу это на примере одного изменения. CI собрал образ и запушил его в registry. Kargo следит за registry и Git-репозиторием с конфигурацией (чарт и values). Как только в одном из них появляется новая версия, Kargo собирает Freight — бандл из конкретного образа и конкретного коммита конфигурации. Дальше этот бандл едет по цепочке окружений целиком: образ без своего чарта не продвигается.
Для dev обычно включён автопромоушен. Kargo рендерит манифесты, пушит их в ветку стейджа, откуда их читает Argo CD, и просит Argo CD синхронизировать. Сам Kargo ничего не деплоит: он пишет в Git, а к желаемому состоянию кластер приводит Argo CD.
Теперь приложение оказалось в dev, и на стороне Argo CD оно Synced и Healthy ровно на нужном коммите. Если прошли ещё и дополнительные проверки (если мы их настроили), Kargo отмечает Freight как проверенный в dev. И только после этого Freight становится доступен для следующего окружения, пусть будет staging. Дальше человек нажимает Promote в UI или выполняет команду kargo promote в CLI, и всё повторяется для staging: проходят проверки, всё становится зелёным, и после этого Freight можно двигать в prod. Если образ в dev не поднялся, Freight остаётся непроверенным, и довести его до следующего окружения просто нечем.
В итоге в любой момент видно, какая версия на каком стейдже и где она проверена, а где нет. Не нужно ничего расследовать и копаться в истории всех веток.
Из чего это собрано
Теперь разберёмся в сущностях. Все они — ресурсы Kubernetes и описываются в манифестах.
Warehouse — подписка на источники артефактов: registry образов, Git-репозиторий, Helm-репозиторий. Наш стенд подписан на образ и на CD-репозиторий. Когда появляется новая версия, Warehouse собирает из неё Freight:
apiVersion: kargo.akuity.io/v1alpha1
kind: Warehouse
metadata:
  name: myapp
  namespace: myapp
spec:
  subscriptions:
    - image:
        repoURL: registry.example.com/myapp
        imageSelectionStrategy: SemVer
        constraint: ^1.3.0
        discoveryLimit: 10
    - git:
        repoURL: https://git.example.com/platform/myapp-cd.git
        branch: main                 # Ветки stage/* не отслеживаем.
        includePaths:                # Freight — только на изменения того, что участвует в рендере.
          - chart
          - glob:values-*.yaml       # Файлы по маске — только через glob:
Project — проект Kargo, в котором живут все остальные сущности. Для него создаётся отдельный неймспейс. Здесь же, в
ProjectConfig, настраиваются правила для всего проекта. У нас автопромоушен включён только для dev, а CI после сборки образа дёргает вебхук, и Warehouse обновляется сразу, без ожидания очередного опроса registry. Второй вебхук делает то же для конфигурации: GitLab на пуш в CD-репозиторий шлёт событие во встроенныйreceiver gitlab, и Kargo обновляет подписанные на этот репозиторий Warehouse:
apiVersion: kargo.akuity.io/v1alpha1
kind: Project
metadata:
  name: myapp
---
apiVersion: kargo.akuity.io/v1alpha1
kind: ProjectConfig
metadata:
  name: myapp
  namespace: myapp
spec:
  promotionPolicies:
    - stage: dev
      autoPromotionEnabled: true
  webhookReceivers:
    - name: ci-image-pushed
      generic:
        secretRef:
          name: ci-webhook
        actions:
          - action: Refresh
            targetSelectionCriteria:
              - kind: Warehouse
                name: myapp
    - name: gitlab-push
      gitlab:
        secretRef:
          name: gitlab-webhook
Freight — тот самый бандл: набор конкретных артефактов с конкретными версиями, который едет по конвейеру целиком. Руками его не пишут, его создаёт Warehouse. Каждому Freight даётся случайно сгенерированное имя вроде
dapper-lizard, чтобы их можно было различать.Stage — стейдж, куда продвигается Freight. Обычно это окружение, но не обязательно: prod, например, можно разбить на несколько стейджей по регионам. В стейдже описано, откуда он берёт Freight и как его выкатывать. Dev берёт Freight прямо из Warehouse (
sources: { direct: true }), а staging — только проверенный в dev:
apiVersion: kargo.akuity.io/v1alpha1
kind: Stage
metadata:
  name: staging
  namespace: myapp
spec:
  requestedFreight:
    - origin: { kind: Warehouse, name: myapp }
      sources: { stages: [dev] }   # Только Freight, проверенный в dev.
  promotionTemplate:
    spec:
      steps:
        - task: { name: render-to-stage-branch }
Prod устроен так же, только смотрит на staging. Из этих ссылок и складывается вся цепочка промоушена.
Promotion — конкретный переход Freight в Stage, со своим статусом и историей. Его создаёт кнопка Promote или команда
kargo promote.
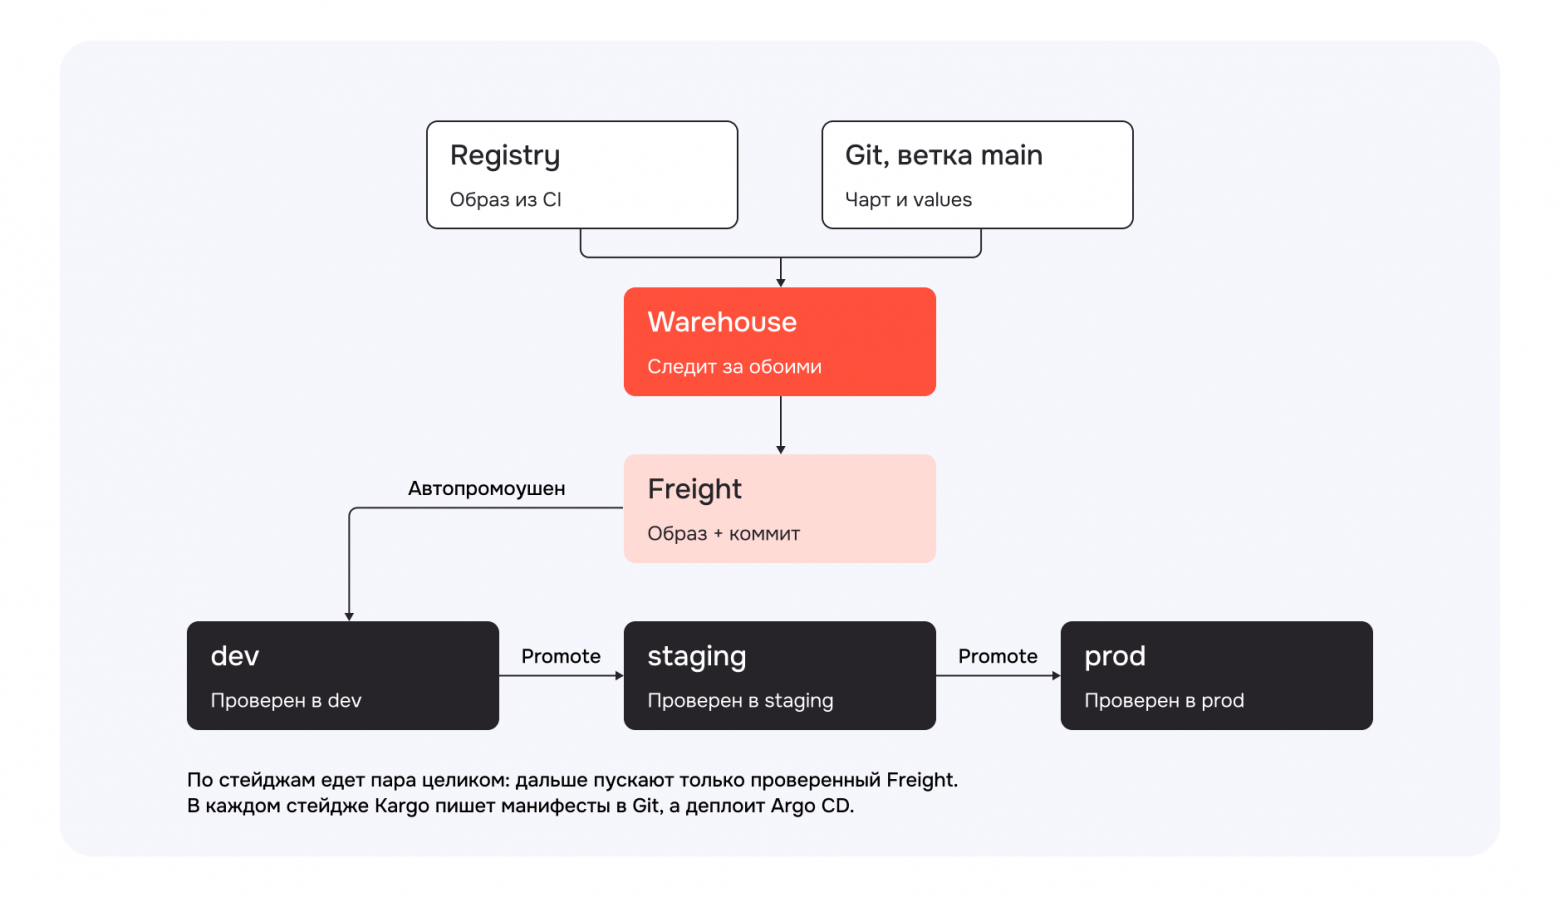
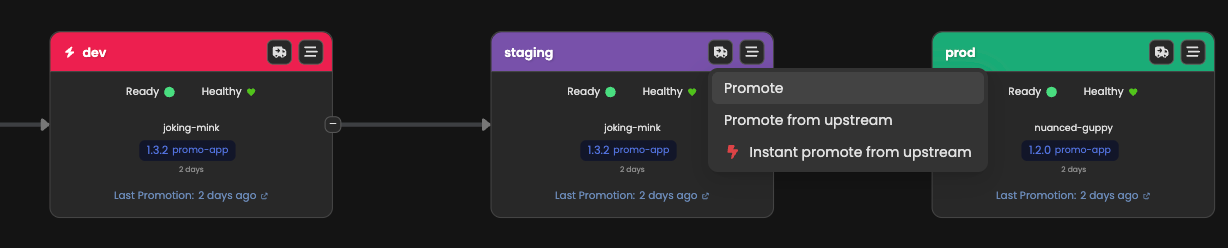
Как выкатывать в стейдж, описывается шаблоном промоушена — последовательностью шагов. Шаги можно вынести в общий PromotionTask, чтобы не дублировать их в каждом стейдже. У нас он один на все стейджи — полностью он показан ниже, в разделе «Рабочий вариант».
Application Argo CD, которыми Kargo может управлять, помечаются специальной аннотацией с именем проекта и стейджа. Автосинк в них выключен: синк запускает сам Kargo на последнем шаге промоушена.
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: myapp-staging
  namespace: argocd
  annotations:
    kargo.akuity.io/authorized-stage: myapp:staging
spec:
  project: myapp
  source:
    repoURL: https://git.example.com/platform/myapp-cd.git
    targetRevision: stage/staging
    path: .
  destination:
    server: https://kubernetes.default.svc
    namespace: myapp-staging
Подробнее — в документации по интеграции с Argo CD.
Kargo, как и любому инструменту бампа, нужен доступ на запись в CD-репозиторий и на чтение registry. Креды хранятся в секретах в неймспейсе проекта, и Kargo находит их по метке kargo.akuity.io/cred-type.
Рабочий вариант
Мы прогнали Kargo на стенде несколько раз, попробовали разные подходы и в итоге пришли к комбинации паттернов, которую сам Kargo рекомендует в своей документации. Если коротко: мы рендерим чарт в готовые манифесты и храним результат в отдельной ветке на каждый Stage.
Что происходит? Kargo берёт чарт и values из коммита, записанного во Freight, полностью рендерит его со значениями нужного стейджа и tag@digest из Freight, а потом кладёт готовые манифесты в ветку stage/<имя стейджа>: stage/dev, stage/staging, stage/prod. Argo CD Application каждого стейджа смотрит на свою ветку.
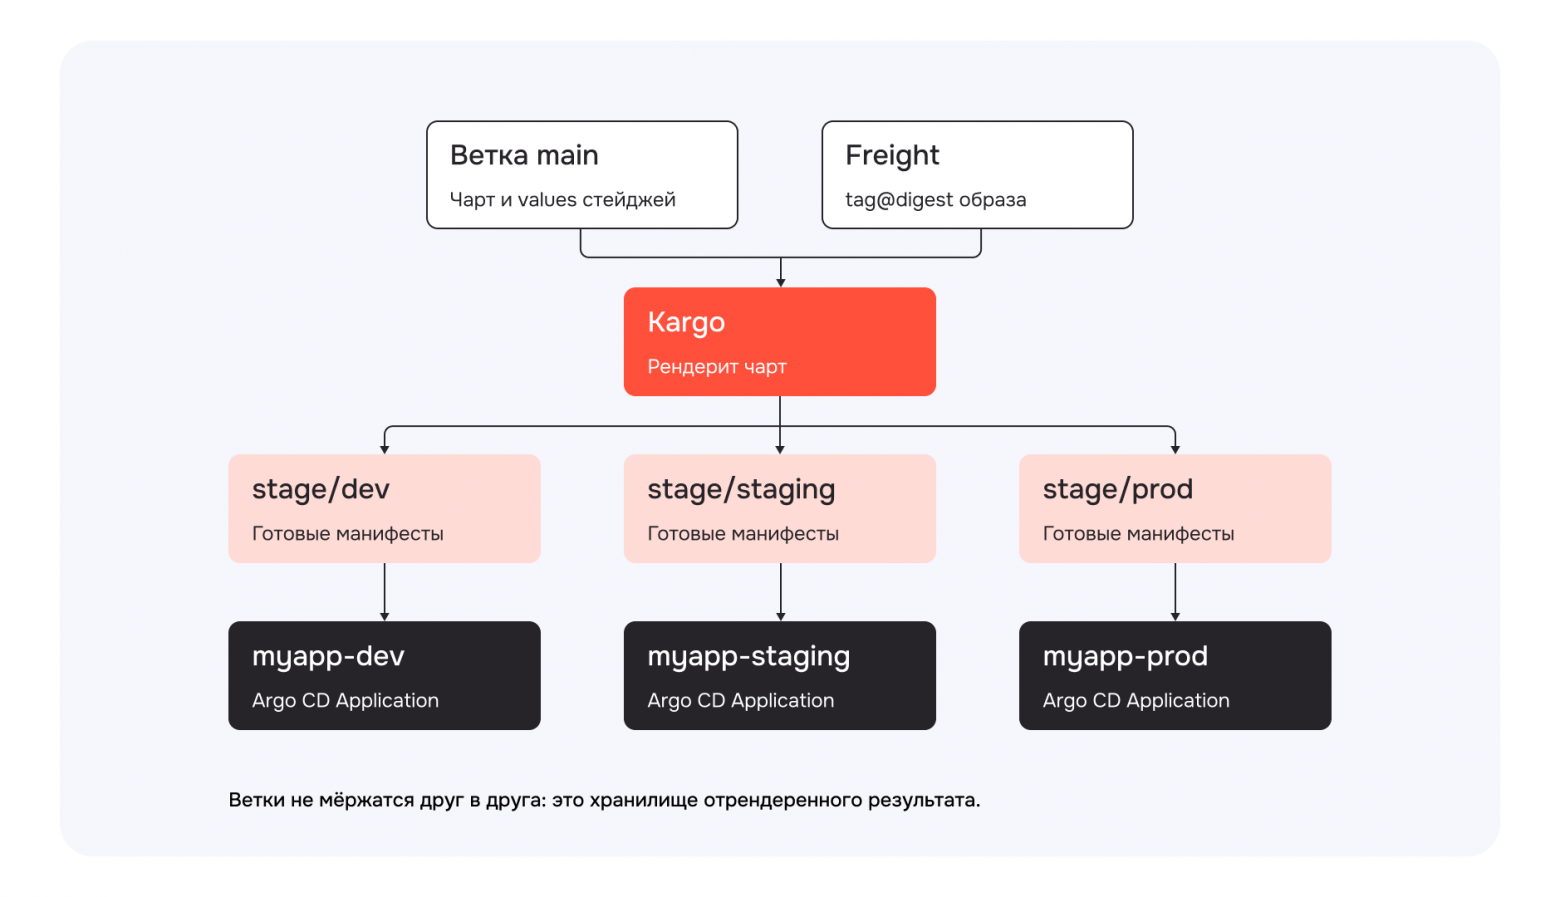
Это даёт несколько преимуществ. Во-первых, ревью идёт по настоящему diff манифестов, а не по values-файлу, который ещё нужно мысленно прогнать через Helm. Так видна полная картина изменений: если поменялся сам чарт, это сразу видно в манифестах, а глядя только на values, это легко пропустить. Во-вторых, у каждого стейджа своя история: ветка показывает ровно то состояние, которое выкатывается на её окружение, и ничего лишнего. GitOps в полном смысле слова.
Тут можно вспомнить подход branch-per-env, который мы описывали выше, но выглядит это немного по-другому. Мержить эти ветки друг в друга никто не собирается, и руками их тоже никто не правит. Их важно рассматривать не как классические ветки разработки в GitLab или GitHub, а просто как хранилище отрендеренного результата. Грубо говоря, это state, который лежит в отдельной ветке.
Важная деталь — откуда берётся чарт. В начале статьи мы договорились, что по цепочке едет один и тот же артефакт. В первых прогонах Warehouse был подписан только на образ, а чарт брался из head ветки main в момент промоушена. Это ломало принцип: если чарт поменяли после проверки в staging, в prod уехала бы непроверенная комбинация «старый образ + новый чарт», правку чарта нельзя было продвинуть или откатить через Kargo, а откат Freight возвращал образ, но не чарт.
Поэтому Warehouse подписан на два источника, Freight несёт пару «образ + коммит конфигурации», а шаг git-clone чекаутит не head ветки main, а коммит из Freight. Новый образ даёт Freight «новый образ + последний коммит конфигурации», правка чарта — «тот же образ + новый коммит», а промоушен и откат двигают пару целиком. У такой связки есть и обратная сторона: новый образ получает последний коммит конфигурации из main. Если там лежит непроверенная правка чарта, срочный хотфикс образа потянет её с собой. Избежать этого можно ручной сборкой Freight из конкретных версий.
Фильтр путей нужен, чтобы правка README не плодила Freight. В него должно попасть всё, что участвует в рендере, — и чарт, и values стейджей. А подписка только на main гарантирует, что собственные коммиты Kargo в ветки stage/* новых Freight не порождают. Есть и ограничение, общее для любой схемы с values по стейджам: правка, которая касается только values-prod.yaml, формально пройдёт проверку в dev и staging, хотя там этот файл в рендере не участвует. Изменение до prod фактически никто не видел.
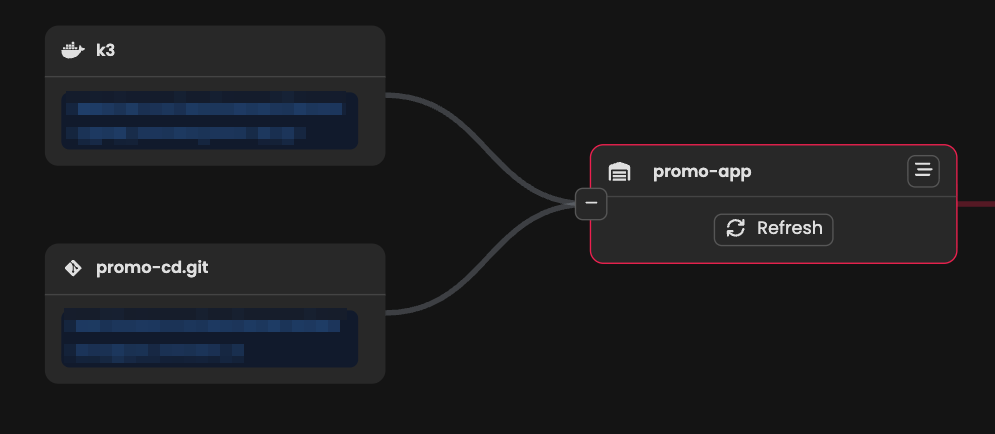
Если упрощать, промоушен в staging у нас выглядит так:
# Шаги промоушена в staging (упрощённо)
steps:
  - uses: git-clone        # Коммит конфигурации из Freight → ./src, ветка stage/staging → ./out.
  - uses: git-clear        # Чистим ветку стейджа: удалённые из чарта ресурсы не останутся.
  - uses: helm-template    # Рендерим чарт из ./src с values-staging.yaml.
    config:
      setValues:
        - key: image.tag
          value: "1.4.0@sha256:…"   # tag@digest из продвигаемого Freight.
  - uses: git-commit       # Коммитим готовые манифесты.
  - uses: git-push         # Пушим в stage/staging.
  - uses: argocd-update    # Синкаем myapp-staging ровно на этот коммит.
Шаги одинаковые для всех стейджей, поэтому мы вынесли их в общий шаблон — ресурс Kargo с kind PromotionTask, а каждый стейдж просто ссылается на него. Меняется только имя стейджа, которое Kargo подставляет сам.
Полные манифесты: PromotionTask и три Stage
apiVersion: kargo.akuity.io/v1alpha1
kind: PromotionTask
metadata:
  name: render-to-stage-branch
  namespace: myapp
spec:
  vars:
    - name: gitRepo          # CD-репозиторий; тот же URL — в подписке Warehouse и в Application.
      value: https://git.example.com/platform/myapp-cd.git
    - name: imageRepo
      value: registry.example.com/myapp
  steps:
    - uses: git-clone
      config:
        repoURL: ${{ vars.gitRepo }}
        checkout:
          - commit: ${{ commitFrom(vars.gitRepo).ID }}
            path: ./src
          - branch: stage/${{ ctx.stage }}   # ctx.stage — имя стейджа, который вызвал шаблон.
            create: true                     # Создать ветку при первом промоушене.
            path: ./out
    - uses: git-clear
      config:
        path: ./out
    - uses: helm-template
      config:
        path: ./src/chart
        releaseName: myapp
        valuesFiles:
          - ./src/values-${{ ctx.stage }}.yaml
        setValues:
          - key: image.repository
            value: ${{ vars.imageRepo }}
          - key: image.tag
            value: ${{ imageFrom(vars.imageRepo).Tag + "@" + imageFrom(vars.imageRepo).Digest }}
        outPath: ./out/manifests.yaml
    - uses: git-commit
      as: commit
      config:
        path: ./out
        # В сообщении — и образ, и коммит конфигурации.
        message: "myapp ${{ imageFrom(vars.imageRepo).Tag }} + config ${{ commitFrom(vars.gitRepo).ID[0:7] }} → ${{ ctx.stage }} (Freight ${{ ctx.targetFreight.name }})"
    - uses: git-push
      config:
        path: ./out
        targetBranch: stage/${{ ctx.stage }}
    - uses: argocd-update
      config:
        apps:
          - name: myapp-${{ ctx.stage }}
            sources:
              - repoURL: ${{ vars.gitRepo }}   # Должен совпадать с repoURL в Application.
                desiredRevision: ${{ task.outputs.commit.commit }}
---
apiVersion: kargo.akuity.io/v1alpha1
kind: Stage
metadata:
  name: dev
  namespace: myapp
spec:
  requestedFreight:
    - origin: { kind: Warehouse, name: myapp }
      sources: { direct: true }        # Прямо из Warehouse.
  promotionTemplate:
    spec:
      steps:
        - task: { name: render-to-stage-branch }
---
apiVersion: kargo.akuity.io/v1alpha1
kind: Stage
metadata:
  name: staging
  namespace: myapp
spec:
  requestedFreight:
    - origin: { kind: Warehouse, name: myapp }
      sources: { stages: [dev] }       # Только проверенный в dev.
  promotionTemplate:
    spec:
      steps:
        - task: { name: render-to-stage-branch }
---
apiVersion: kargo.akuity.io/v1alpha1
kind: Stage
metadata:
  name: prod
  namespace: myapp
spec:
  requestedFreight:
    - origin: { kind: Warehouse, name: myapp }
      sources: { stages: [staging] }   # Только проверенный в staging.
  promotionTemplate:
    spec:
      steps:
        - task: { name: render-to-stage-branch }
Что мы увидели на стенде
Kargo действительно сам создал ветки stage/dev, stage/staging и stage/prod с отрендеренными манифестами — работает, как ожидалось. Самый наглядный момент стенда — diff между staging и prod. Как видно на скриншоте, разница в одной строке, в числе реплик. Версия одна и та же: Freight один, а значит, и образ один — работает тот самый принцип build once, deploy many. Отличаются только настройки окружений. И ревью идёт по полностью готовым манифестам, а не по строчке с тегом.
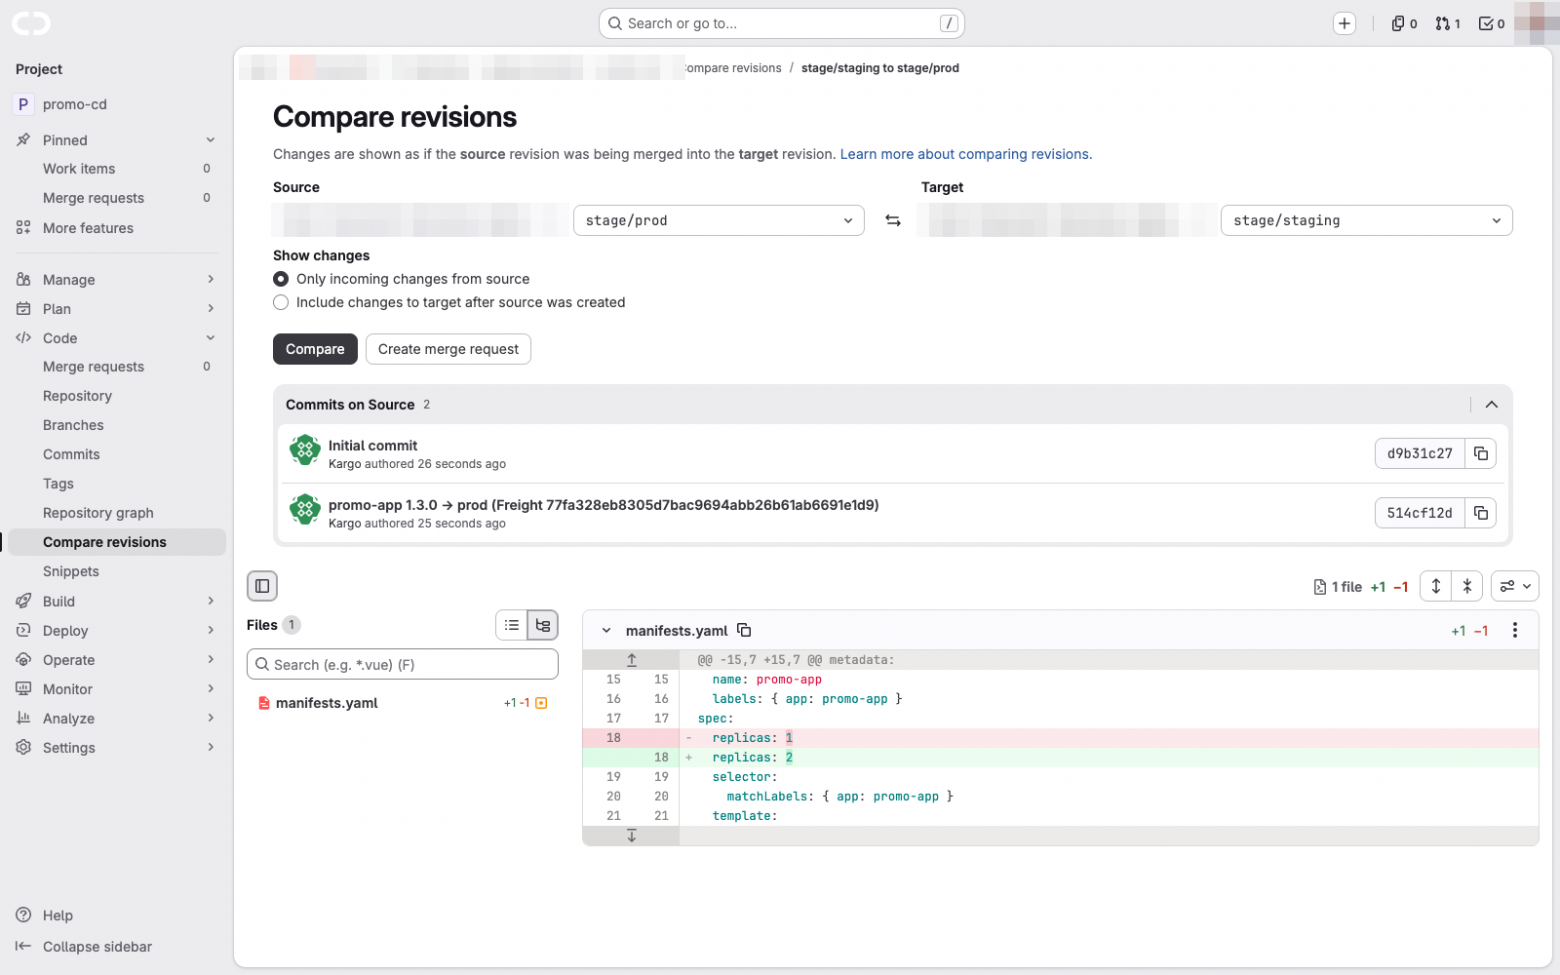
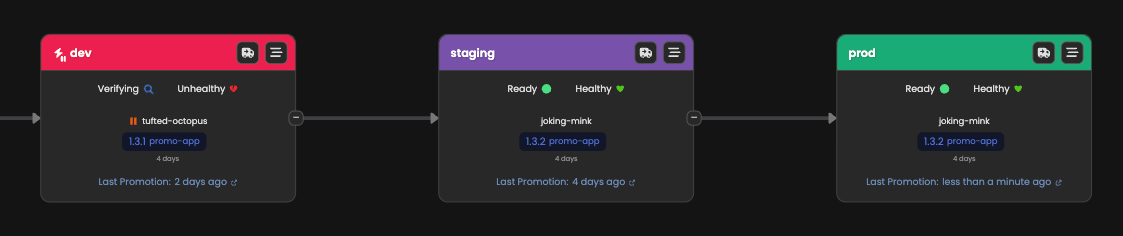
stage/staging и stage/prod: версия одна, отличается только число репликДальше мы продолжили эксперимент и выкатили образ, который намеренно падает на старте. Автопромоушен в dev прошёл успешно, то есть образ выкатился в dev-контур: сам промоушен не отвечает за здоровье приложения, его задача — записать версию в Git и запустить синхронизацию. Но дальше стейдж завис на проверке: Kargo ждал, пока Application станет Healthy, а этого не происходило.
При этом старый под продолжал отвечать. Это обычное поведение Deployment при rolling update: Kubernetes поднимает новый под рядом со старым и гасит старый, только когда новый стал Ready. Новый под уходил в CrashLoopBackOff и Ready так и не стал, поэтому старый остался работать, и трафик шёл на него.
В следующий стейдж Kargo этот Freight уже не пустил:
Error: 400 Bad Request: {"error":"Freight \"238eaa2c…\" is not available to Stage \"staging\""}Это и есть главный гейт Kargo, и включён он по умолчанию: Stage принимает только Freight, проверенный в предыдущем Stage.
# staging принимает только Freight, проверенный в dev.
requestedFreight:
  - origin: { kind: Warehouse, name: myapp }
    sources: { stages: [dev] }
После этого мы собрали исправленный образ, и новая сборка автоматически ушла в dev поверх сломанной.
Для dev такого гейта достаточно, а для staging и prod маловато: то, что приложение поднялось, ещё не значит, что оно работает. Поэтому дальше мы попробовали гейты, которые добавляют к нему настоящие условия.
Первый — requiredSoakTime. Freight станет доступен следующему стейджу, только когда непрерывно пробудет в предыдущем заданное время:
# Staging: Freight должен провести в dev не меньше часа.
requestedFreight:
  - origin: { kind: Warehouse, name: myapp }
    sources:
      stages: [dev]
      requiredSoakTime: 1h
На стенде, чтобы не ждать час, мы ставили выдержку в две минуты, и промоушен в staging отклонялся ровно две минуты. Неприятно другое: отказ выглядит так же, как для сломанного Freight, — тот же not available, без причины. Ждёт он выдержки или сломан, придётся разбираться самим.
Второй гейт — HTTP-проверка. Шаг http отправляет запрос во внешнюю систему и проверяет ответ выражением. Если ответ не устроил, промоушен падает ещё до записи в Git. Так можно, например, спросить систему управления изменениями, одобрен ли тикет на релиз или календарь релизов, не объявлен ли мораторий. На стенде мы поставили перед prod гейт «в staging сейчас работает та же версия, что во Freight»:
# Prod: первый шаг промоушена, до рендера и пуша.
- uses: http
  as: staging-gate
  config:
    method: GET
    url: http://myapp.myapp-staging.svc.cluster.local/
    timeout: 5s
    # Функции Freight внутри выражений недоступны — версию подставляем шаблоном. ${{ }}
    successExpression: 'response.status == 200 && response.body contains "version=${{ imageFrom("registry.example.com/myapp").Tag }} "'
    failureExpression: 'response.status != 200 || !(response.body contains "version=${{ imageFrom("registry.example.com/myapp").Tag }} ")'
Промоушен версии, которой в staging не было, остановился на первом же шаге, и в Git ничего не ушло:
step "staging-gate": HTTP (200) response met failure criteria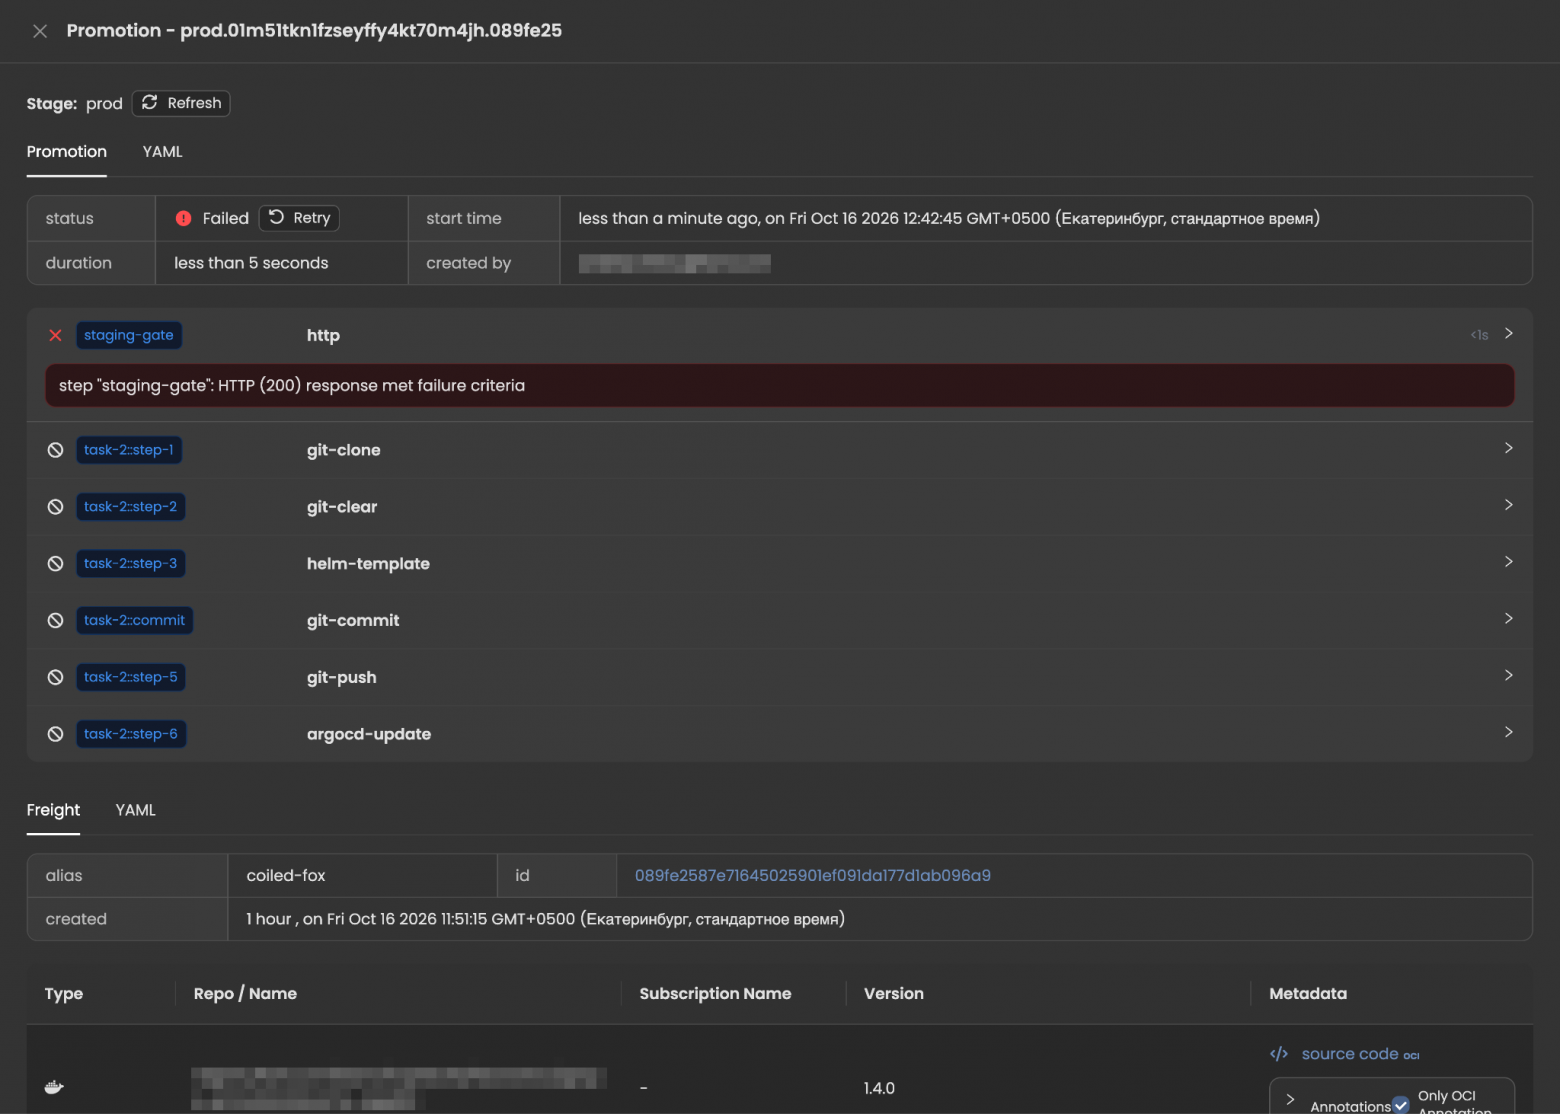
Однако тут есть нюанс. Дальше мы воспроизвели инцидент, который требует срочного хотфикса или отката для версии в prod. Гейт заблокировал и то, и другое.
С хотфиксом всё очевидно: он идёт в prod в обход staging, поэтому его версии в staging нет. С откатом то же самое: в staging уже стоит новая версия, а prod мы возвращаем на старую. Гейт требовал, чтобы prod всегда совпадал со staging, а хотфикс и откат по определению это нарушают. Получилось, что во время инцидента гейт мешает тем действиям, которые нужнее всего.
Вывод такой: проверять, что версия прошла staging, не нужно, Kargo делает это сам. HTTP-гейт полезен для того, чего Kargo не знает, например одобрен ли релиз в системе управления изменениями. Мы подняли простую заглушку такой системы и поставили гейт на неё:
- uses: http
  retry:
    timeout: 10m
  as: change-gate
  config:
    method: GET
    url: http://changes.myapp-changes.svc.cluster.local/approved
    queryParams:
      - name: service
        value: myapp
      - name: version
        value: ${{ imageFrom("registry.example.com/myapp").Tag }}
    timeout: 5s
    successExpression: response.status == 200 && response.body.approved == true
    failureExpression: response.status != 200 || response.body.approved != true
Теперь неодобренная версия в prod не попадает, а хотфикс и откат проходят, если для них есть одобрение.
Пара практических деталей:
Указывайте оба условия: и когда пропускать, и когда останавливать. Если ответ не подошёл ни под одно условие, Kargo не падает, а повторяет запрос раз в 30 секунд, и без таймаута это длится бесконечно. Промоушен висит в Running, и за ним в очереди встают остальные, включая откат. Иногда такое ожидание полезно, например чтобы дождаться одобрения тикета, но тогда задайте ему таймаут явно.
В реальной системе одобряйте дайджест образа, а не тег, иначе подменённый под тем же тегом образ пройдёт проверку.
config.timeoutограничивает отдельный HTTP-запрос, аretry.timeout— максимальное время ожидания результата шага. Без второго параметра ожидание может продолжаться бесконечно, если ответ не удовлетворяет ни условию успеха, ни условию ошибки.
Третий гейт — Merge Request. После HTTP-проверки промоушен в prod у нас шёл не прямым пушем, а через обычный MR: Kargo пушит рендер в отдельную ветку, открывает MR в ветку стейджа и ждёт мёржа. С GitLab это заработало: на карточке prod висело «Waiting for PR Approval» со ссылкой на MR, а после мёржа prod обновился через 17 секунд. Ревью и обязательные пайплайны остаются в GitLab, где команда и так работает, — как у Renovate, только внутри промоушена. Но важно понимать, что гейтом здесь служит не Kargo, а тот, кто может нажать Merge. Значит, смысл этого гейта целиком определяется правилами approval и защитой ветки в GitLab, а их, как и поведение при закрытом без мёржа MR или при squash, мы не проверяли.
Шаги промоушена через MR
# Фрагмент PromotionTask: вместо прямого пуша в stage/prod — MR.
- uses: git-push
  as: push
  config:
    path: ./out
    generateTargetBranch: true      # Пушим в отдельную ветку, а не в stage/prod.
- uses: git-open-pr
  as: pr
  config:
    repoURL: ${{ vars.gitRepo }}
    provider: gitlab
    sourceBranch: ${{ task.outputs.push.branch }}
    targetBranch: stage/${{ ctx.stage }}
- uses: git-wait-for-pr             # Промоушен ждёт здесь, пока MR не смёржат.
  as: merged
  config:
    repoURL: ${{ vars.gitRepo }}
    provider: gitlab
    prNumber: ${{ task.outputs.pr.pr.id }}
- uses: argocd-update
  config:
    apps:
      - name: myapp-${{ ctx.stage }}
        sources:
          - repoURL: ${{ vars.gitRepo }}
            desiredRevision: ${{ task.outputs.merged.commit }}   # SHA merge-коммита.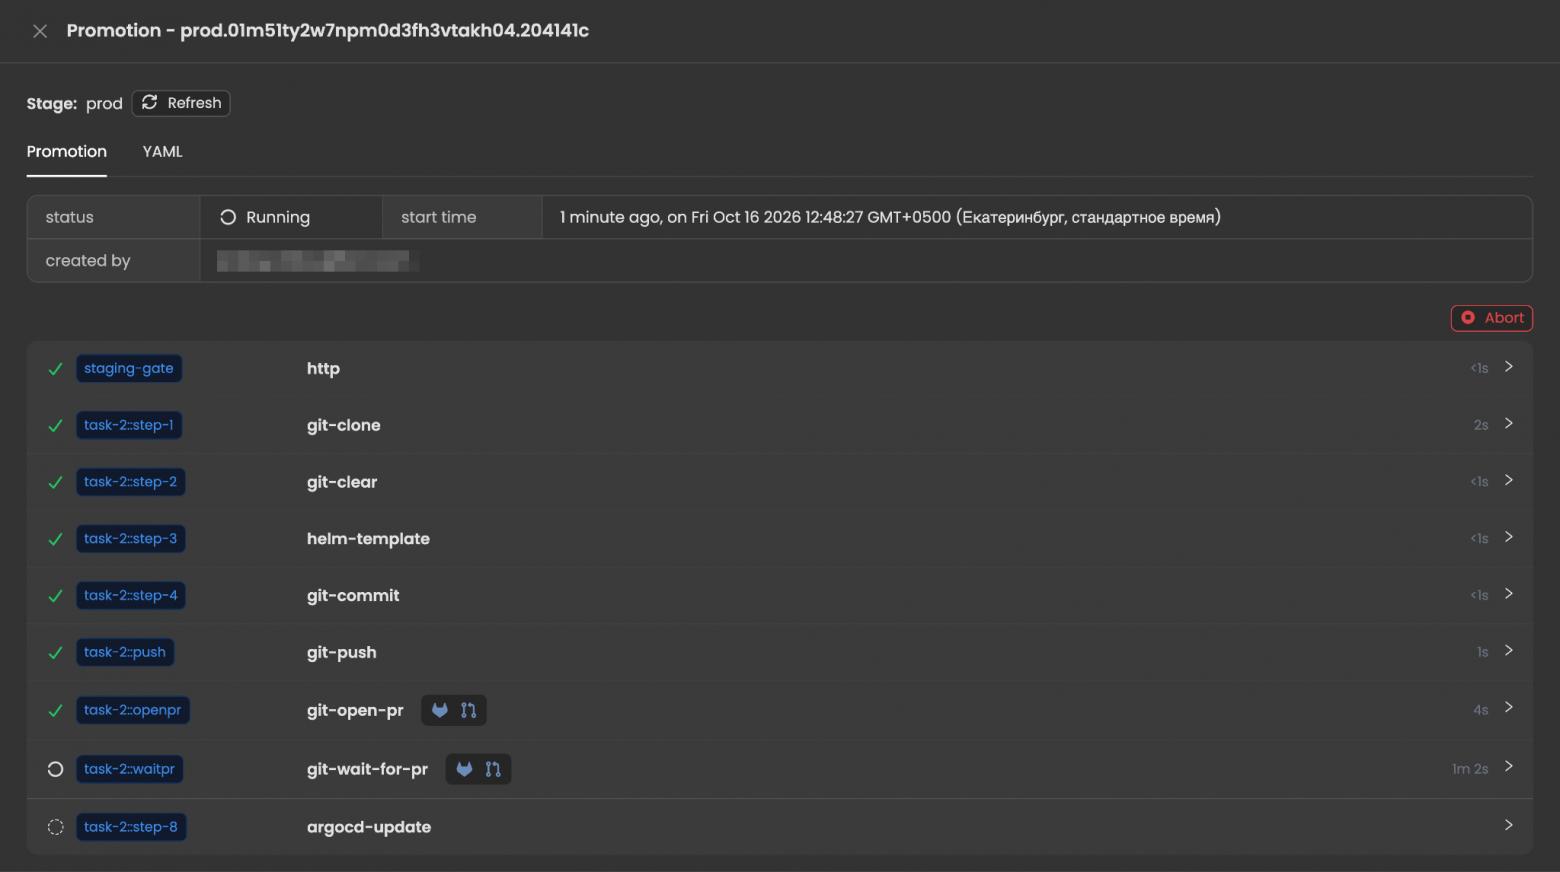
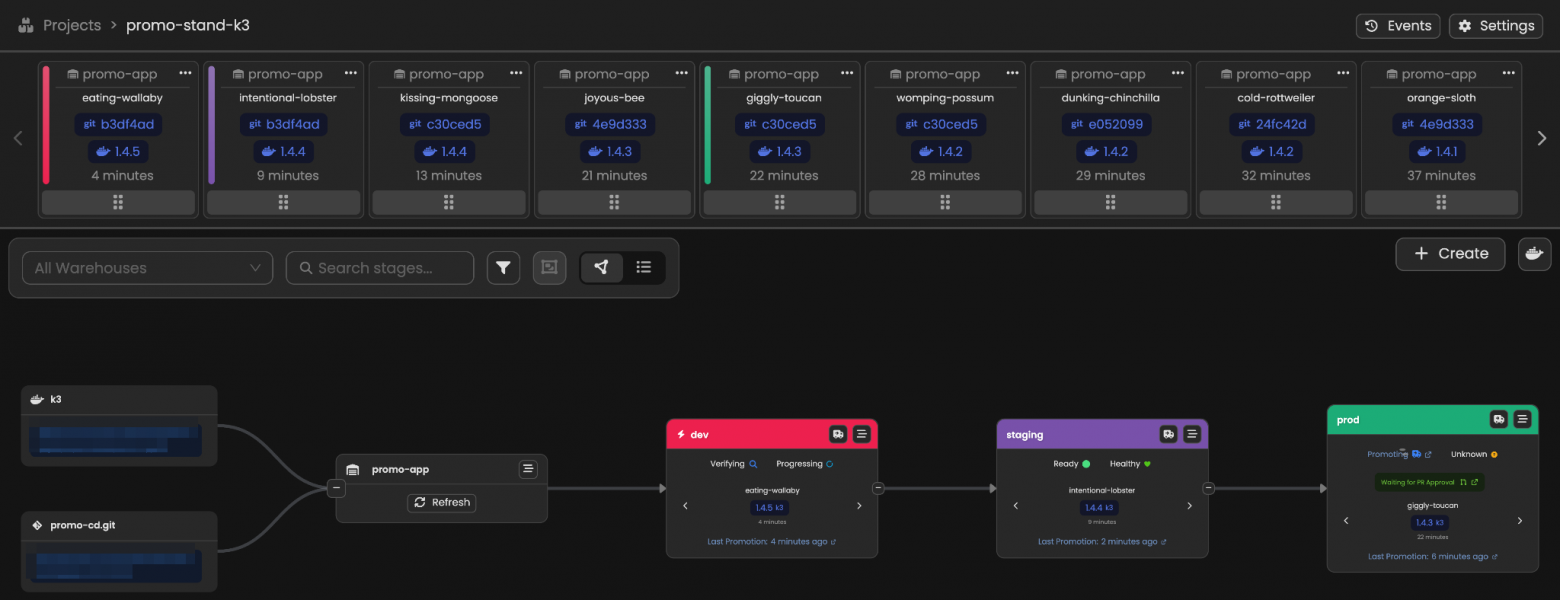
И последний гейт — человек. Автопромоушен у нас включён только для dev, поэтому в staging и prod Freight сам не едет, и кнопка Promote работает как ручной апрув. А кто может её нажать, решает обычный RBAC Kubernetes по действию promote на конкретном стейдже:
# Промоутить можно в dev и staging, но не в prod.
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: promoter-nonprod
  namespace: myapp
rules:
  - apiGroups: [kargo.akuity.io]
    resources: [stages]
    resourceNames: [dev, staging]
    verbs: [promote]
Пользователь с такой ролью спокойно промоутил в staging, а промоушен в prod отклонил вебхук Kargo:
admission webhook "promotion.kargo.akuity.io" denied the request: … is not permitted to create PromotionОбойти гейт между стейджами можно, но только явно. Для этого есть команда kargo approve: она вручную помечает Freight как допущенный в конкретный стейдж, даже если он не проверен ни в одном предыдущем. Так можно, например, отправить срочный хотфикс сразу в prod, минуя dev и staging. Мы так и проверили: собрали образ, сделали approve для prod и продвинули его туда напрямую. Важно, что это осознанное действие конкретного человека, а не дыра в гейте: по умолчанию непроверенный Freight дальше не едет.
Отката как отдельной операции в Kargo нет. Откат — это обычный промоушен предыдущего Freight: в UI выбираете старую версию, которая уже была проверена, и продвигаете её в нужный стейдж. В интерфейсе сразу видно, что меняются обе части: образ 1.4.3 → 1.4.0 и коммит конфигурации. Kargo заново рендерит манифесты из старой пары и коммитит их в ветку стейджа, и от клика до Succeeded у нас прошло 9 секунд. Поэтому в Git откат выглядит не как git revert, а как новый коммит поверх, в котором вернулись и старый образ, и старый чарт. История остаётся линейной, и по ней видно, кто и когда откатил.
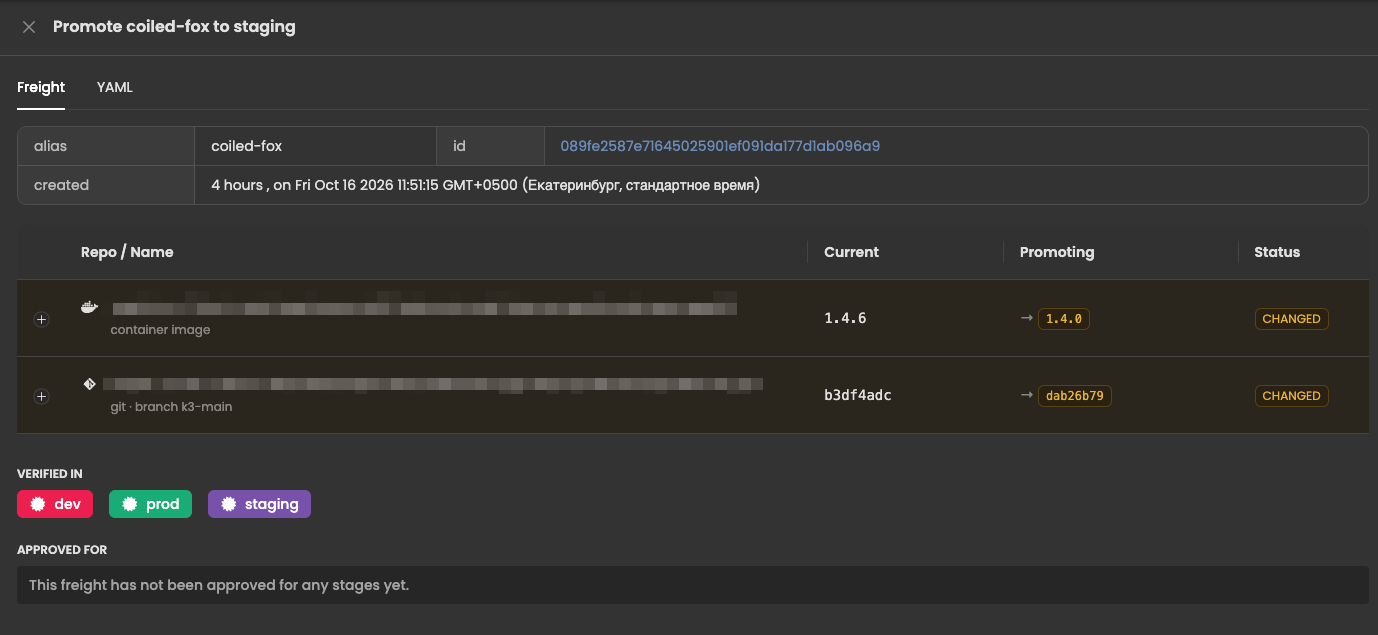
По скорости Kargo оказался вполне бодрым. С вебхуками от пуша образа до пода в dev прошло 42 секунды; без них, на опросе раз в пять минут, — 2 минуты 38 секунд. Правка чарта превращалась во Freight за 15 секунд с вебхуком GitLab и за 4 минуты 38 секунд без него. Для сравнения: у Image Updater без вебхуков выходило около трёх с половиной минут, хотя интервалы опроса там другие.
Последний эксперимент — релизный фриз: запретить выкатку в prod, например на время праздников. В Kargo для этого есть окна промоушена (promotionWindows), но это функция enterprise-версии, а в Open Source-версии их настройка молча игнорируется. Поэтому prod мы заморозили средствами Argo CD, через Sync Window. В отличие от примера в разделе про встроенные механизмы, здесь окно закрывало и ручные синки — а все синки, которые Kargo запускает по ручному промоушену, для Argo CD как раз ручные:
spec:
  syncWindows:
    - kind: deny
      schedule: "* * * * *"
      duration: 1h
      applications: [myapp-prod]
      manualSync: false   # Ручные синки тоже запрещены.
Под закрытым окном мы продвинули в prod сначала 1.3.0, а затем 1.3.2. Тут нас ждал сюрприз. Kargo выполняет промоушен по порядку: сначала рендерит манифесты и коммитит их в ветку stage/prod и только последним шагом (argocd-update) просит Argo CD синхронизировать. Sync Window блокирует именно синхронизацию. Первый промоушен на последнем шаге попросил Argo CD синхронизировать prod. Argo CD эту операцию принял, но выполнять не стал, потому что окно закрыто, и она так и повисла в ожидании. Второй промоушен, с 1.3.2, закоммитил новую версию в stage/prod, дошёл до того же шага, упёрся в уже висящую операцию и через пять минут упал по таймауту:
step "task-1::step-6" timed out after 5m0s:Причину, то есть окно, не назвал ни UI, ни статус. Kargo пометил промоушен как Failed и продолжал показывать prod на 1.3.0. Но в Git prod уже был на 1.3.2. Через шесть секунд после снятия окна Argo CD выполнил висевшую операцию и выкатил то, что к этому моменту лежало в stage/prod, — то есть 1.3.2, хотя запрашивал её ещё первый промоушен, с 1.3.0. Kargo при этом по-прежнему показывал 1.3.0 и Failed, и выровнялось это только повторным промоушеном.
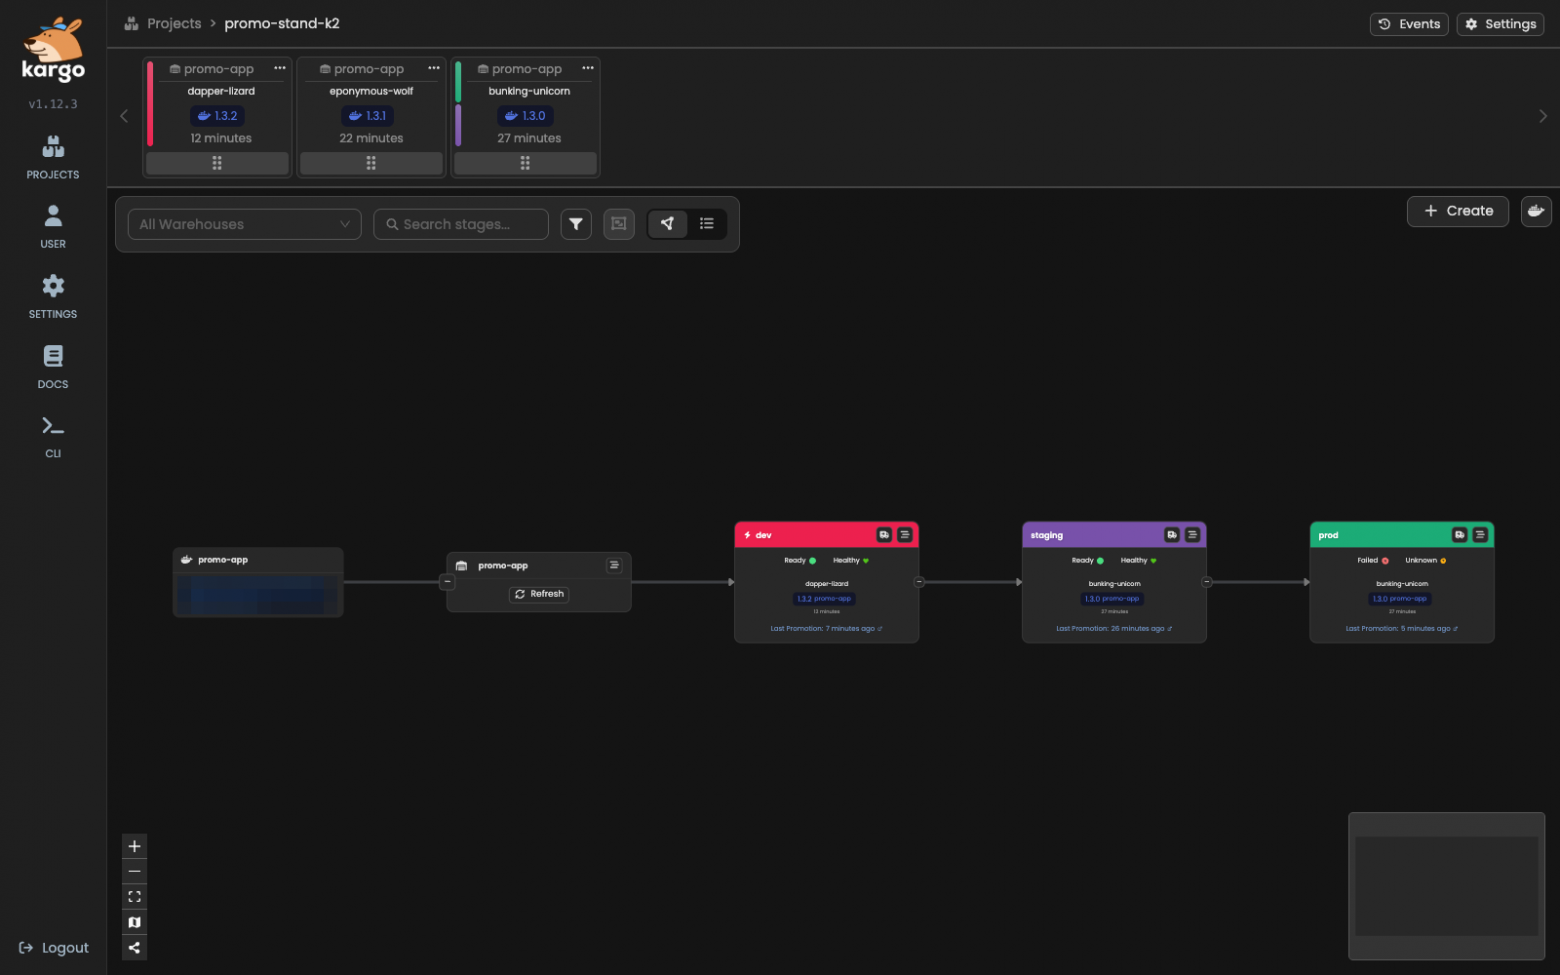
Для меня это главный урок стенда: в GitOps состояние — это Git, а не статус инструмента промоушена. Failed в Kargo не значит «не задеплоено». А Sync Window замораживает доставку, но не решение: если промоушен уже прошёл, новая версия лежит в Git и уедет в кластер, как только окно откроется. И важно, как настроено само окно. Мы повторили эксперимент с manualSync: true, и ручной промоушен через Kargo прошёл сквозь активное окно за 20 секунд. Так что окно для хотфиксов замораживает только автосинхронизацию и от промоушена через Kargo prod не защищает. Поэтому в Open Source-версии Kargo, где своих окон промоушена нет, релизное окно надёжнее делать тем же HTTP-гейтом: он останавливает промоушен ещё до записи в Git.
В итоге промоушен в prod у нас проходил сразу несколько гейтов: проверку в staging, HTTP-проверку и MR, а нажать Promote мог только тот, кому это разрешено. Это то, что мы проверили руками. С анализом из Argo Rollouts полная схема поверх таблицы из начала статьи выглядела бы так: в dev — автопромоушен и проверка по умолчанию; в staging — Freight из dev, выдержка и анализ с e2e; в prod — выдержка, HTTP-проверка тикета или окна, MR с ревью, RBAC и «канарейка» с анализом.
Чего стенд не покрывает: у нас был один сервис, один кластер и три неймспейса, без реального трафика и без Argo Rollouts. А значит, самые содержательные гейты — анализ после выкатки с метриками из мониторинга или Kubernetes Job с e2e и нагрузкой — мы не проверили. Открытыми остаются и вопросы, от которых зависит судьба Kargo на боевых стендах: как жить с десятками сервисов, как устроен промоушен в несколько кластеров и как RBAC работает в продакшене с SSO-группами.
Итог по Kargo
Kargo может показаться избыточным тем, кому хватает уже упомянутых механизмов управления синхронизацией, или тем, кто только начинает погружаться в GitOps-подход и не сильно страдает от описанных в статье проблем. Фактически это лишняя сущность в стеке: её нужно защитить перед архитектурным комитетом, поставить, обновлять и поддерживать.
Кроме того, рендеринг манифестов накладывает свои ограничения. При хранении отрендеренных манифестов в Git нельзя допускать, чтобы открытое содержимое секретов попадало в репозиторий. Для таких значений нужно использовать внешнее хранилище или механизм безопасного хранения и дешифрования секретов. И, конечно, есть ряд проблем, которые происходят без явных ошибок в логах.
В целом этот инструмент требует понимания всего жизненного цикла промоушена. Он добавляет много новой терминологии и новых объектов, и нужно разобраться, как ими управлять и по какому циклу они живут.
Но так или иначе из всех инструментов в pull-модели GitOps, которые мы проверили, Kargo — единственный, где у промоушена есть собственная история, свои гейты, откаты и механизмы проверки. Анализ после выкатки через Argo Rollouts мы не проверяли — если интересно, разберём отдельно. Также можно подробно разобрать, как дёргать Prometheus или кастомные HTTP-эндпоинты и как на этом построить очень классную систему.
И ещё одно: переход между окружениями в Kargo — отдельный объект, который видно. Это добавляет прозрачности всему процессу SDLC, и если окружений у вас много, по-моему, это стоит попробовать в первую очередь. Поэтому если брать Kargo, то сразу с ветками стейджей. Это не сразу кажется очевидным и требует немного изменить взгляды, но в итоге весь цикл промоушена становится понятным, прозрачным и предсказуемым.
У самого Argo CD постепенно складывается свой ответ на ту же задачу. Source Hydrator рендерит чарт с values в готовые манифесты и коммитит их в отдельную ветку — по сути, то же, что мы собрали руками на ветках стейджей в Kargo, только встроенное в Argo CD. Бамп и промоушен он сам не закрывает, а поверх таких веток промоушен между окружениями строит GitOps Promoter из argoproj-labs, решая по commit-статусам. Проект сам называет себя экспериментальным, и эту связку мы на стенде не проверяли. Но если вы живёте в экосистеме Argo и не хотите заводить отдельный продукт, за ней стоит следить.
Когда GitOps не нужен
Давайте вернёмся к клиенту из вступления, который откатился с Argo CD на деплой из GitLab CI по push-модели. Задним числом это действительно может выглядеть логично. GitOps приносит наибольшую пользу там, где нужны изоляция, аудит и постепенный роллаут по многим окружениям. Если же у команды, например, одно-два окружения и высокое доверие к CI, вся эта архитектура превращается в накладные расходы без выгоды: оверхед, оверинжиниринг и огромная портянка YAML-файлов.
Есть и случаи, когда GitOps в привычном виде просто неприменим:
нет Kubernetes: приложения живут на виртуалках, в managed-сервисах или в serverless, и агенту вроде Argo CD или Flux нечего синхронизировать;
деплой требует ручных шагов или завязан на легаси, которое невозможно выразить декларативными манифестами;
короткоживущие проекты и прототипы, где настраивать отдельный GitOps-репозиторий и агента дольше, чем жить самому проекту.
В таких случаях возврат к push-модели или отказ от GitOps — нормальный выбор, который соответствует и масштабу, и пониманию того, что вы вообще хотите получить.
И случай с откатом от Argo CD не единственный: среди клиентов и в комьюнити мы видим разные лагеря. Например, мы видели клиента с огромным продовым сетапом вообще без GitOps. Для инфраструктуры у них Terraform и Terragrunt с Atlantis, отдельный CI/CD-репозиторий с шаблонами пайплайнов и атомарные задачи на каждый этап CI/CD-процесса. Им так действительно удобнее и комфортнее: логи инфраструктуры и деплоя сервисов лежат в одном месте, и ценности в переходе на GitOps они для себя не видят. А есть те, кто, однажды перейдя на GitOps, уже не хочет вспоминать, как следил за логами задачи в GitLab.
Обе позиции валидны. Вопрос в том, какую конкретную боль вы хотите закрыть.
Выводы
Выбор, как продвигать артефакты между окружениями, упирается в несколько вопросов: сколько у вас окружений, нужен ли явный approve-гейт между ними и готовы ли вы заводить в свой стек ещё один компонент ради промоушена.
Если вы узнали себя в разделе про костыли, то есть у вас живёт самодельный бамп тега в CI или отдельный внутренний портал, то разумная точка входа обычно выглядит так: сначала закрыть бамп стандартным Image Updater или аналогом во Flux. А если окружений много и нужны видимость и, главное, прозрачность всего конвейера, стоит уже смотреть в сторону Kargo. Если же окружений одно-два и GitOps скорее мешает, чем помогает, вам, наверное, ближе классическая push-модель с деплоем прямо из CI. И признать это не стыдно, а нормально.
Что касается Image Updater и Kargo, нужно понимать: инструменты не то чтобы сильно сложные, но неприятности с ними возникают, и в логах они проявляются далеко не всегда явно. Тут нужны определённые компетенции и чёткое понимание абстракций обоих инструментов. Поэтому, какой бы инструмент вы ни выбрали, проверяйте, что реально лежит в Git и работает в кластере: UI порой может показывать другое или вести себя не так очевидно, как хотелось бы. Так что с инструментами придётся немного поразбираться и понять логику и паттерны их работы.
И ещё одно наблюдение — про обратную связь. В push-модели сломанный релиз сразу ломает пайплайн, и разработчик видит ошибку там же, где запустил деплой. А в GitOps пайплайн сборки остаётся зелёным, Argo CD пишет, что всё OK, а Degraded появляется только через 10 минут: столько по умолчанию ждёт Deployment, прежде чем признать выкатку проваленной. Kargo, конечно, не пустит такой Freight дальше, но показывает это у себя в интерфейсе, а не в пайплайне. Стоит понимать, что из-за разрыва конвейера появляются и определённые проблемы с наблюдаемостью.
В заключение: за скобками остались очень интересные темы, которые тянут на отдельную статью. Например, как наполнять гейты Kargo настоящими проверками через Argo Rollouts с примерами для Prometheus и HTTP-эндпоинтов; как выстроить DRY между конфигурациями окружений; платформы вроде Devtron и Codefresh, которые закрывают всю цепочку одним продуктом; обратная связь из CD обратно в CI. Если какая-то из тем заходит, напишите об этом в комментариях — сделаем вторую часть.
И открытый вопрос к вам: как промоушен решаете вы? Гоняете Kargo в проде, живёте на костылях с sed-бампами или вообще вернулись к деплою из CI? Расскажите в комментариях, интересно послушать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.