Как починить RAG
Привет! Я Катя Пославская, занимаюсь RAG-системами и ИИ-агентами в KTS.
За время работы с RAG я убедилась, что после вдохновляющих результатов прототипирования на фрагменте данных многие компании отказываются от вывода RAG-ассистента в прод. Причины просты: вау-эффект разбивается о реальность, когда мы подключаемся к полной корпоративной базе, большой, постоянно растущей, шумной. Кто-то видел актуальный корпоративный Confluence, в котором каждая статья точно описывает существующий процесс, оперативно выходят новые актуальные статьи, а устаревшее отправляется в архив или удаляется? Вот и я такого Confluence не видела. А что делать, когда у нас много владельцев контента, много источников данных, высокие риски выдачи неверного ответа клиенту?
Я строю RAG-системы для корпоративных заказчиков больше двух лет и успела освоить некоторые техники их «приручения», которые помогают минимизировать проблемы и успешно поддерживать решения в проде. Сегодня мы разберём тонкости настройки ассистента от чанков до генерации, а также лекарства от типичных поломок на проде.
Сразу дам маленький спойлер про галлюцинации, в которых постоянно упрекают LLM: на практике чаще всего в них виновата НЕ модель.
Оглавление
Классический и агентский RAG
Детально излагать концепцию RAG не буду, на Хабре уже есть простое и подробное объяснение. Если коротко, то это система ограничения LLM, чтобы модель отвечала по внутренней базе знаний компании, а не по тем документам, на которых обучалась. Для этого на вопрос пользователя система находит в базе фрагменты, максимально близкие к теме запроса, и подкладывает эти фрагменты в контекст LLM.
Классический RAG-пайплайн работает в один проход: пришёл запрос, система один раз сходила в базу, сгенерировала ответ и остановилась. Такой пайплайн просто строить и тестировать, а стоимость эксплуатации у него предсказуемая.
Агентский RAG устроен как цикл с обратной связью. LLM сама решает, каким инструментом поиска воспользоваться, сколько раз сходить в базу и надо ли туда идти вообще. На простом вопросе умный агент отработает так же, как классический пайплайн. На сложном сделает несколько итераций: сначала просто поищет, потом оценит, чего не хватает, скорректирует запрос и сходит в базу ещё раз. И так по кругу, пока LLM не убедится, что ответ уже полный.
Примечание
Тут есть нюанс с терминологией. Строго говоря, агентским пайплайн становится, только когда всем процессом управляет LLM, то есть когда наш пайплайн недетерминирован. Например, мы решили увеличить качество ответов системы для сложных запросов и дополнили классический RAG конвейер шагом по оценке качества промежуточного ответа с помощью маленькой LLM и одним повторным поиском в базе при низком качестве промежуточного ответа. В этом случае пайплайн всё ещё является классическим, а не агентским, поскольку набор, количество и порядок шагов поиска и генерации детерминированы, то есть «зашиты» в системе.
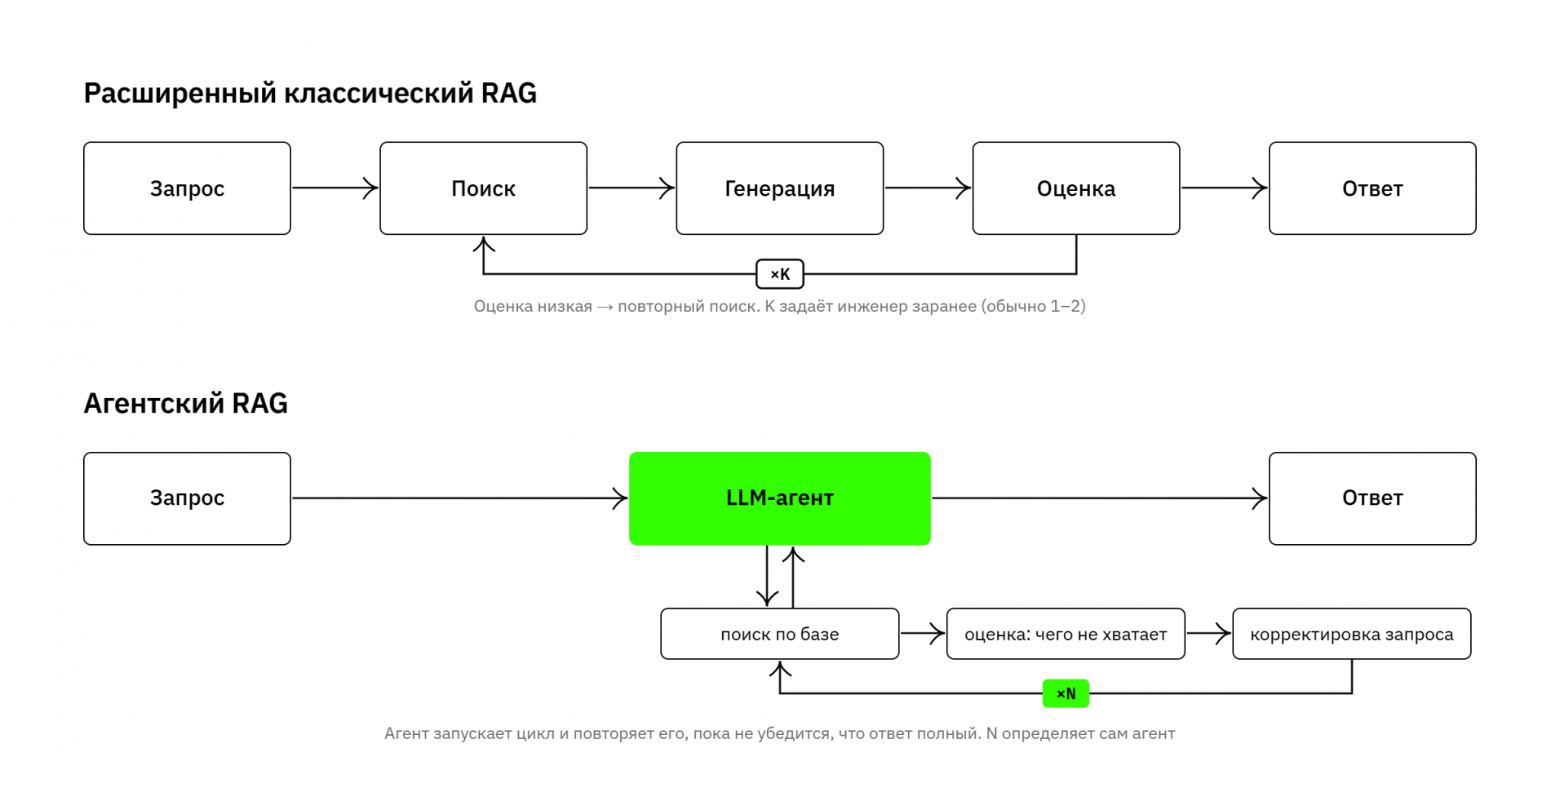
За гибкость агентского пайплайна приходится платить. Агентская система медленнее и дороже, у неё больше точек отказа, а тестировать её сложнее, потому что кроме качества финального ответа нужно проверять, правильно ли агент выбирал инструменты, оптимально ли количество шагов и так далее.
На практике хорошо работает гибридный подход с дешёвой моделью-маршрутизатором, которая выбирает, отправить ли запрос в классический или в агентский RAG. Примерно 80% вопросов пользователей простые, их выгодно пускать по классическому пайплайну. Оставшиеся сложные уходят в агентский. Начинать проект сразу с агентского RAG я не советую. Даже когда заранее видно, что простой схемы не хватит, классический пайплайн всё равно понадобится как baseline для сравнения.
Тонкости работы с данными
Успешная работа RAG-систем в первую очередь зависит от качества данных. Они должны быть актуальными, непротиворечивыми, полными. Однако очень часто сам разработчик мало может помочь с этим, тут нужно время экспертов, которого по опыту никогда не хватает на «генеральную уборку каталога». У нас для этой процедуры есть модуль Data Validator, который служит помощником аналитику: ищет в базе знаний дубликаты, противоречия и предлагает вариант их обработки (объединение, архивация неактуального и прочее). Наше решение является не повсеместным, поэтому зачастую ML-щик вынужден работать с тем, что уже есть. В этом случае, ключевым аспектом работы является корректная обработка данных.
В RAG-системе данные подготавливаются на этапе индексации: она обычно включает чанкинг (разбиение на фрагменты), векторизацию и построение хранилища (например, векторный или графовый индекс).
Индексация
Этот этап можно сравнить с организацией груды книг в каталогизированное библиотечное хранилище, по которому можно легко и быстро найти информацию.
Чанкинг
Документы вроде огромной статьи из Confluence или стостраничного PDF для поиска не годятся из-за своих размеров, поэтому их режут на фрагменты, они же чанки. Вариантов нарезки текста на чанки несколько: можно просто делить его на равные по длине куски, можно по структурным блокам (если они есть, как в markdown, например), можно попросить LLM выделить смысловые блоки и резать по границам, которые она определила. Последний подход удорожает индексацию, но на плохо структурированных документах, где вперемешку идут текст, таблицы и скриншоты, LLM-чанкинг даёт хороший прирост качества. Заодно чанки получаются разделёнными по смыслу, и в них не подмешивается лишний контекст.
Размер чанка в токенах зависит от задач RAG-системы. Для базы вопросов и ответов хватает около 200 токенов на чанк, вопрос с ответом целиком помещаются в один фрагмент. Для обычных информативных статей на русском языке я ориентируюсь примерно на 1000 токенов, для плотных юридических документов беру ещё больше.
Длина чанка и тип данных могут быть критичны для успешного поиска. Мне встречался RAG-ассистент, который регулярно выдавал несусветные ответы, хотя модель и остальные параметры были адекватные. Выяснилось, что база была нарезана фрагментами по 100 токенов. Для русского языка это совсем мало, а контент был насыщенный: инструкции с функциями Excel и пояснениями к ним. Нарезка на такие мелкие куски превращала их в бессвязные обрывки формул и фрагментов описаний. При поиске к запросу подтягивалась каша, из которой модель никак не могла собрать содержательный ответ.
Соседние чанки обязательно делают с нахлёстом, обычно около 10% размера, например, 100 токенов при чанке в 1000. Так смысл не рвётся на стыках фрагментов.
Типы индексов
Дальнейшая обработка чанков зависит от типа хранилища для наших данных, она определяет, как мы будем в будущем делать поиск. Семантический индекс использует векторное представление текста, превращая чанки в плотные векторы (эмбеддинги). Такой индекс отлично помогает улавливать смысловые нюансы живого запроса и намерения собеседника.
Полнотекстовый индекс отлично справляется с поиском по ключевым словам и терминам и строится вокруг частотности слов. Для него чанки превращаются в разреженные векторы (обычно используется алгоритм BM25).
Для классического RAG обычно оптимален гибрид: создаются оба индекса, а результаты поиска по семантическому и полнотекстовому индексам сливаются в общий список.
Кроме семантического, полнотекстового и гибридного есть ещё графовый индекс. Для его создания LLM извлекает из документов сущности и отношения между ними, далее формируются связанные группы и смысловые описания к ним и строится граф. Лучше всего графовый поиск работает на multihop-запросах, где ответ приходится собирать из нескольких разрозненных источников. Пример из банковской практики: пользователь спрашивает у RAG-ассистента примерные условия по кредиту для его конкретного случая, но ни одна статья не содержит полного ответа. В этом случае граф поможет модели связать условия из одного документа с особыми обстоятельствами клиента из другого и льготами сотрудника из третьего.
Правда, между собой мы называем графы «путём через Мордор». Их сложнее создавать, дороже поддерживать, и при каждом добавлении документов граф приходится перестраивать. Совет здесь простой: начинайте с гибридного поиска, а к графам переходите, только если при хорошо размеченных данных качество ответов всё равно хромает.
Векторизация
В семантическом индексе выбор векторизатора/эмбеддера сильно зависит от контура. Там, где разрешён доступ к внешним API, мы используем OpenAI text-embedding-3-large. В закрытых контурах берём BGE-M3, по нашему опыту это лучшая open-source модель и универсальный выбор. Ещё часто применяется E5. Qwen Embedding мы тоже пробовали, но на наших задачах она отработала хуже BGE-M3.
Для полнотекстового поиска вообще не используется векторизатор, BM25 (или другой алгоритм) строит для каждого чанка разрежённый вектор, размерность которого равна размеру словаря, а ненулевые значения – это веса терминов по их важности в документах.
Поиск
Мы рассмотрим самый типовой кейс гибридного поиска, когда поиск совершается сразу по семантическому и полнотекстовому индексам.
Сначала система готовит запрос к поиску. В зависимости от реализации запрос можно переписать, расширить или разбить на части, чтобы стилистически приблизить его к чанкам из базы и за счёт этого получить более репрезентативные результаты поиска. Кроме того, в реальных системах почти всегда поддерживается история диалога: сначала определяется, является ли текущий запрос самодостаточным или он связан с предыдущими k обменами репликами (например, пятью), после чего к запросу добавляется история за k обменов либо её сокращённая версия.
Затем запрос пользователя трансформируется в плотный вектор (семантический поиск) и в разреженный (поиск по ключевым словам). Естественно используем мы тот же векторизатор или алгоритм, что и при создании индекса.
Поиск в семантическом индексе обычно ведут по косинусной близости векторов запроса и чанков базы. Для полнотекстового поиска движок проходит по инвертированному индексу, то есть вытаскивает списки чанков, где встречаются термины/ключевые слова и для каждого чанка считает суммарный скор. При гибридном поиске два списка результатов сливаются в один алгоритмом Reciprocal Rank Fusion и передаются дальше по конвейеру, скажем, топ-10 кандидатов..
Следующим этапом часто ставят реранкер (чаще всего cross-encoder), который переупорядочивает чанки из топа, оптимизируя выдачу. Модель-трансформер проходит по списку и для каждой пары «запрос – кандидат» выдаёт скор смысловой релевантности. Фрагменты сортируются по скору и на генерацию отправляются, например, топ‑3–5 самых важных.
Уязвимости поиска Top-N
Число N фиксировано. При маленьком N, очевидно, проседает охват, но и слишком большое значение N не панацея. Если нужный чанк оказался на позиции N+1, отстав на доли процента от соседа, в контекст он не попадёт. Простым увеличением N мы проблему не решим, так как большое значение N увеличит стоимость и время ответа системы. Кроме того, большее количество чанков будет неизбежно подмешивать и больше шума в контекст, снижая качество ответов.
Поиск оценивает близость каждого чанка к запросу и никак не оценивает чанки относительно друг друга. Дополняют ли они друг друга, несут ли новую информацию – на это не смотрят ни поиск, ни реранкер. Чанки, близкие к запросу, обычно близки и между собой. Поэтому топ может забиваться дублями, и место в контексте расходуется впустую.
Нет целостного представления базы. На общие вопросы типа «О каких темах ты можешь рассказать?» система не может перечислить больше, чем N тем, так как всей базы она физически не видит. Сильнее всего страдают сложные multi-hop запросы, которые требуют обнаружить неочевидные связи, которых нет в отдельном чанке.
Генерация
На последнем этапе многое решает промпт. В него явно встраивают найденные чанки, роль, задачу и ограничения, а также правила работы с источниками. Мы, например, часто требуем ссылку на источник после каждого факта. Единого стандарта нет, шаблон всегда подгоняется под конкретную систему, а потом шлифуется и шлифуется.
Из параметров генерации важнее всего температура. Для фактологических ответов её держат около нуля, высокая температура добавляет креативности и вместе с ней галлюцинаций.
Если риск выдачи ложного ответа высок (например, ассистент общается не с внутренним пользователем, а с клиентом), полезно добавить этап критической оценки и финальной корректировки ответа. В этом случае черновик ответа проходит через LLM-судью: он сверяет его с найденными чанками, ловит утверждения, которых в контексте нет, и формирует итоговый ответ.
Оценка качества
Научный подход к оценке RAG кажется эффективным, но разбивается о реалии практических кейсов. Например, для оценки качества поиска предлагают рассчитывать Recall@K, т.е. долю случаев, когда нужный чанк попал в топ. Если Recall@10 < 0.7, остальные метрики можно не смотреть. Кроме того, оценивают метрики NDCG и MRR, которые показывают, насколько высоко релевантные документы стоят в выдаче. Для генерации метрик ещё больше, от релевантности и полноты ответа до частоты галлюцинаций и корректности цитат.
Проблема в том, что создание тестовых наборов данных и их разметку для расчёта метрик могут позволить себе разве что академические команды или продуктовые команды, которые строят RAG внутренними силами и выделяют на это многие часы своих экспертов.
В заказной разработке всё немного иначе, потому что у типового заказчика RAG-системы нет ни датасетов, ни представления о метриках. Клиенту надо, «чтобы работало с точностью 95%», – что бы это ни значило :) Кропотливо размеченные по всем правилам датасеты подрядчик не соберет без помощи экспертов заказчика, у которых и так постоянная нагрузка. Ассистента ведь и внедряют, чтобы их разгрузить.
Что делать в такой ситуации? На практике используют LLM-as-a-judge, когда модель-судья оценивает качество ответов системы относительно эталонного ответа. Если сервис в каком-то виде уже функционирует (например, техподдержка, которую осуществляют люди), оптимально взять реальные исторические запросы из текущего сервиса, в тех же формулировках, в каких их задавали пользователи, и ответы сотрудника. Для нового сервиса, по которому нет исторических данных, очень желательно, чтобы заказчик сам предоставил хотя бы 20 примеров вопросов и эталонных ответов к ним для калибровки системы. В противном случае все тестовые данные придётся синтезировать. Оптимально синтезировать хотя бы с какими-то вводными по ожидаемым типовым запросам пользователей (user stories). Дальше эти вопросы необходимо прогнать через систему и полученные ответы отправить эксперту заказчика на корректировку: насколько вопросы адекватны, а ответы корректны. По опыту у специалистов вызывает гораздо меньше сопротивления исправлять черновик, чем писать собственный «эталонный ответ».
Тестовый набор вопрос – ответ системы – эталонный ответ отправляется LLM-судье, которого просят оценить качество ответа системы по сравнению с эталоном. Модель может работать по бинарной шкале «хорошо/плохо», но я предпочитаю шкалу от 1 до 10, по нашим экспериментам она более информативна и стабильнее воспроизводится от запуска к запуску. Шкалу и условия вы задаёте в промпте LLM-судьи: за что снижать оценку, когда ставить единицу, когда десятку.
Когда система оказывается на проде, её можно мониторить похожим образом. Для этого продолжайте создавать новые датасеты тем же способом: копите вопросы реальных людей, гоняйте их через систему и LLM-судью, валидируйте через экспертов (не все, а случайные 5–10% или самые проблемные), проверяйте ответы системы на отклонения от эталона. И ещё важнее пользоваться теми же эталонными датасетами перед релизом любых изменений. Если вы поменяли парсер таблиц или размер чанка, прогоните систему по датасету и убедитесь, что она не регрессировала.
И напоследок: на пользовательские оценки (ответ хороший/плохой) полагаться не стоит. Люди очень редко ставят лайки/дизлайки ответу и ещё реже пишут что-то содержательное в комментарии, если ответ их не устроил. Единичка без контекста бесполезна, поскольку неясно ошиблась ли система и в чём нужно исправление. Так что CSI в оценке точности RAG-системы в лучшем случае вторичен.
Что ломается
Деградация со временем
Вернёмся к основной проблеме RAG-систем, о которой я говорила ещё во введении: на демо всё прекрасно, через полгода точность ответов на проде падает. Основная причина такой деградации в данных. База продолжает разрастаться, каждые несколько дней в неё добавляют новые документы, а чистить старые и неактуальные забывают. Накапливаются противоречия, растёт шум, целевые чанки находить всё труднее.
Чистить базу вручную дорого, и заказчик не будет заниматься этим никогда, поэтому мы собрали свой дата-валидатор под эту задачу. Он ищет в базе дубликаты, близкие документы и противоречия и подсвечивает подозрительные места, а человек решает, что с ними делать. Валидатору можно задавать уровень скепсиса; чем он выше, тем больше потенциальных ошибок он найдёт, и эксперту придётся проверять их все вручную. Но, к примеру, два разных числа в одном шаблонном банковском документе валидатор заметит даже при низком уровне скепсиса. Баланс между нагрузкой на эксперта и потребностью в хирургической точности приходится искать эмпирически.
Ещё качество может упасть, когда у системы меняется аудитория, и новые пользователи начинают задавать новые вопросы. Их поведение сложно спрогнозировать заранее, так что из их вопросов придется просто собирать новые датасеты и тюнить систему уже на них. Можно, конечно, заранее сделать датасеты из предположительных вопросов новых клиентов, но точность такого подхода сомнительна. Если бы вы точно знали, о чём вас спросят, вы бы написали FAQ, а не строили RAG. Так что при смене аудитории качество ответов в любом случае пострадает.
Просто низкое качество
Если желаемого качества вообще не получается добиться, причин тому, чаще всего две. Проверяйте их по порядку.
Сначала проверьте чанки, которые находятся по запросу. Возможно, в выборку Top-N вообще не попадает нужный факт. Тогда нужно чинить поиск.
Если чанк с нужным фактом в выборке есть, а ответ всё равно плохой, проблема в генерации. Нужно разбираться с промптом.
Поиск первым делом лечат переписыванием запроса, о нём я уже говорила. Ещё помогает разделение баз по доменам: если в компании есть IT, HR и юридический блоки, их можно смело разделять, потому что вопросов на стыке доменов почти не бывает. Вместо одной базы сделайте три, встройте маршрутизатор/классификатор, и по каждой из них система будет отвечать точнее. Заодно это закрывает перекрёстное загрязнение, когда финансовая информация просачивается в ответы на HR-вопросы. Если маршрутизация запросов не помогает, прикрутите фильтрацию по метаданным. В крайнем случае идите через граф. Под чутким присмотром Саурона.
Низкая производительность
Если же ваша система достигла нужного уровня точности, но отвечает слишком медленно или жрёт слишком много токенов, с этим тоже можно работать, упрощая пайплайн и минимизируя вызовы LLM. Например, подключить кэширование, чтобы на идентичные и очень близкие вопросы он мог отвечать без поиска по базе.
Заключение
Подытожу свои рекомендации. Если вы строите RAG, начинайте с классического гибридного поиска и вкладывайтесь в данные. Агентские циклы и тем более графы добавляйте только тогда, когда убедитесь, что вы упёрлись в ограничения простого подхода, а база знаний точно в порядке. По моему опыту, чаще всего проблемы кроются именно в исходных данных.
Заодно порекомендую статьи своих коллег. Там не про RAG, а про инфраструктуру для моделей и их тестирование. Для работы с ML в закрытом контуре точно пригодится:
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.