chunk(), lazy() и cursor() в Laravel: замеры памяти и почему chunk() теряет половину строк при обновлении
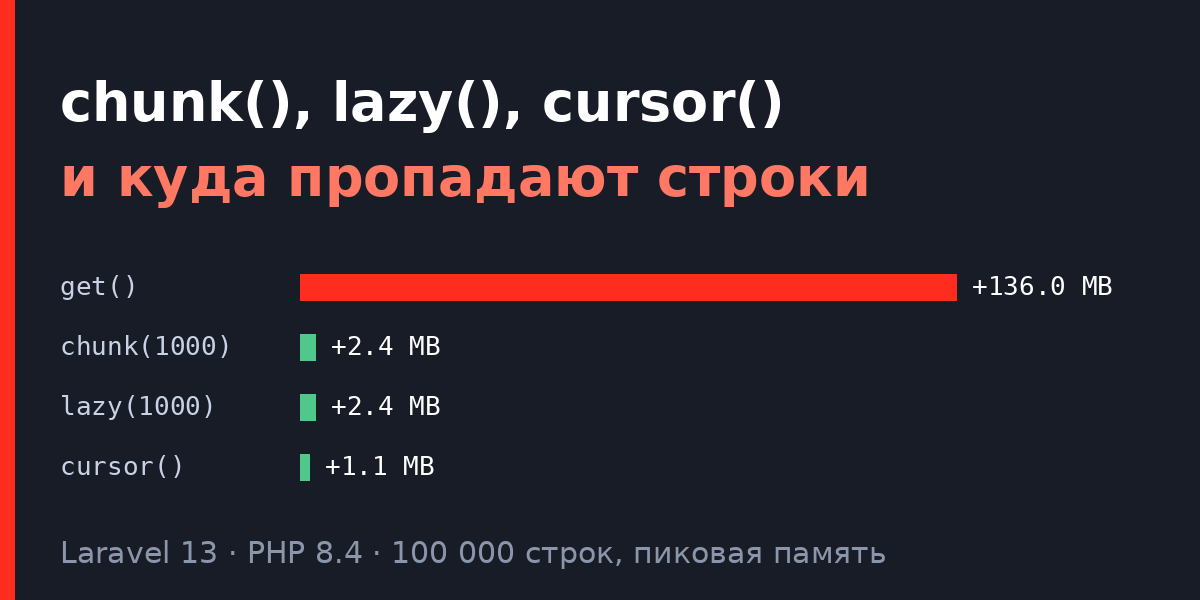
Когда в Laravel нужно обработать большую таблицу, обычно советуют «не делать all(), использовать chunk()». Совет верный, но неполный: у chunk() есть ловушка, из-за которой фоновая задача тихо обрабатывает только часть строк, без ошибок и предупреждений. Ниже замеры пяти способов обхода таблицы на 100 000 строк, разбор того, откуда берётся потеря строк, и правила выбора метода.
Стенд
Laravel 13.39.0, PHP 8.4.27 (CLI), SQLite 3.46.1, файловая база;
таблица
orders:id,status(string),payload(text, 200 символов),amount(integer), 100 000 строк;каждый режим запускается отдельным процессом PHP; память —
memory_get_peak_usage()минусmemory_get_usage()перед обходом (послеmemory_reset_peak_usage());запросы считаются через
DB::listen(); в счётчик входит один контрольныйcount()в конце.
Время зависит от машины и СУБД, его стоит воспринимать как относительное. Число запросов и число обработанных строк от железа не зависят. Скрипт целиком приведён в конце статьи.
Чтение: сколько памяти стоит каждый способ
Модель минимальная:
use Illuminate\Database\Eloquent\Model;

class Order extends Model
{
    protected $guarded = [];
    public $timestamps = false;
}
Пять вариантов обхода всех строк:
// 1. Всё в одну коллекцию
foreach (Order::all() as $order) { /* ... */ }

// 2. Пачками через LIMIT/OFFSET
Order::query()->orderBy('id')->chunk(1000, function ($orders) { /* ... */ });

// 3. Пачками через WHERE id > последний_id
Order::query()->chunkById(1000, function ($orders) { /* ... */ });

// 4. LazyCollection поверх пачек (lazy — OFFSET, lazyById — по ключу)
foreach (Order::query()->lazy(1000) as $order) { /* ... */ }
foreach (Order::query()->lazyById(1000) as $order) { /* ... */ }

// 5. Один запрос, модели создаются по одной
foreach (Order::query()->cursor() as $order) { /* ... */ }
Результаты:
Метод | Строк | Запросов | Время | Пик памяти |
|---|---|---|---|---|
| 100 000 | 2 | 1,52 с | +136,0 МБ |
| 100 000 | 102 | 0,99 с | +2,4 МБ |
| 100 000 | 102 | 0,76 с | +2,4 МБ |
| 100 000 | 102 | 0,98 с | +2,4 МБ |
| 100 000 | 102 | 0,78 с | +2,4 МБ |
| 100 000 | 2 | 0,89 с | +1,1 МБ |
Что из этого следует:
all()держит в памяти все 100 000 моделей сразу: 136 МБ на таблицу, где полезных данных около 20 МБ. Каждая модель Eloquent хранит массивыattributesиoriginal, плюс служебные свойства. При стандартномmemory_limit = 128Mэтот скрипт упал бы.Пакетные методы делают 101 запрос на выборку: 100 полных страниц и последнюю пустую, по которой цикл понимает, что данные кончились. Память не растёт с размером таблицы, она определяется размером пачки.
Варианты «по ключу» на этом стенде быстрее вариантов с
OFFSET. Причина в том, чтоOFFSET 99000заставляет СУБД пройти и выбросить 99 000 строк, аWHERE id > ?сразу идёт по индексу первичного ключа. На 100 000 строк разница — десятки процентов, на десятках миллионов строк поздние страницы сOFFSETстановятся заметно медленнее.cursor()— один запрос и самая низкая память в PHP, но у него есть ограничения, о которых ниже.
Ловушка: chunk() при изменении выборки
Типичная фоновая задача: найти все заказы в статусе new и перевести в done.
Order::where('status', 'new')
    ->orderBy('id')
    ->chunk(1000, function ($orders) {
        foreach ($orders as $order) {
            $order->update(['status' => 'done']);
        }
    });
Код выглядит правильно и падать не будет. Результат на стенде:
Метод | Обработано | Осталось | Запросов | Время |
|---|---|---|---|---|
| 50 000 | 50 000 | 50 052 | 27,36 с |
| 100 000 | 0 | 100 102 | 51,54 с |
chunk() обработал ровно половину строк. Механика такая. chunk() строит запросы вида:
select * from orders where status = 'new' order by id limit 1000 offset 0
select * from orders where status = 'new' order by id limit 1000 offset 1000
select * from orders where status = 'new' order by id limit 1000 offset 2000
...
После первой пачки 1000 строк перестают удовлетворять условию status = 'new'. Выборка «сдвигается» на 1000 строк вперёд, и второй запрос с offset 1000 пропускает тысячу ещё не обработанных строк. Так происходит на каждом шаге: одна пачка обрабатывается, одна пропускается. Получается ровно 50 из 100 пачек.
chunkById() не использует смещение. Каждый следующий запрос начинается с последнего увиденного ключа:
select * from orders where status = 'new' order by id limit 1000
select * from orders where status = 'new' and id > 1000 order by id limit 1000
select * from orders where status = 'new' and id > 2000 order by id limit 1000
Обновлённые строки уходят из выборки, но позиция привязана к значению id, а не к номеру строки, поэтому ничего не теряется. Документация Laravel прямо рекомендует chunkById() для случаев, когда внутри колбэка обновляются записи, по которым идёт фильтрация. Та же логика переносится на lazy() против lazyById(): lazy() тоже использует OFFSET и теряет строки в том же сценарии.
Ловушку трудно заметить, потому что:
нет исключения, задача завершается «успешно»;
на маленькой тестовой базе (меньше одной пачки) всё работает, ведь второго запроса нет;
при повторных запусках по расписанию оставшиеся строки постепенно дорабатываются (50 %, потом 25 % и так далее), и проблема выглядит как «задержка», а не как баг.
Тот же эффект даёт не только update, но и удаление строк внутри chunk(), и любая параллельная запись в таблицу (другой воркер, пользовательские запросы), которая меняет состав выборки до текущей позиции.
Ограничения chunkById()
Сортировка всегда по ключу (по умолчанию
id). СвойorderBy()вместе сchunkById()не сочетается: метод сам добавляет сортировку по столбцу, переданному третьим аргументом.Ключ должен быть уникальным и монотонно сравнимым. Если запрос с
join, а в обеих таблицах естьid, нужно явно указать столбец и алиас:chunkById(1000, $callback, 'orders.id', 'id').Если нужен обход в обратном порядке, есть
chunkByIdDesc().
Если строки не нужно загружать — не загружайте
В примере выше на каждую строку уходит отдельный UPDATE: 100 000 запросов и 51 секунда. Когда логика сводится к изменению столбцов без PHP-обработки каждой записи, достаточно одного запроса:
Order::where('status', 'new')->update(['status' => 'done']);
Метод | Обработано | Запросов | Время | Пик памяти |
|---|---|---|---|---|
массовый | 100 000 | 2 | 0,16 с | +0,9 МБ |
Разница с chunkById() + $order->update() — больше чем в 300 раз по времени. Цена: массовый update() на построителе не создаёт моделей, поэтому не срабатывают события Eloquent (updating, updated, saved), наблюдатели и мутаторы, а updated_at обновляется, только если у модели включены временные метки. Если на событиях модели висит логика (аудит, сброс кеша, отправка уведомлений), её придётся вызвать явно или оставить поштучное сохранение.
Промежуточный вариант — chunkById() и одно обновление на пачку:
Order::where('status', 'new')->chunkById(1000, function ($orders) {
    // своя обработка в PHP, если нужна
    Order::whereKey($orders->modelKeys())->update(['status' => 'done']);
});
Это 100 запросов на обновление вместо 100 000, и строки по-прежнему не теряются.
cursor(): когда он хорош и когда нет
cursor() выполняет один запрос и создаёт модели по одной через генератор PHP. Ограничения:
Нет eager loading.
with()вместе сcursor()не работает: связи грузятся только лениво, по запросу на каждую модель, и мы получаем N+1. Если нужны связи, беритеlazyById()— он подгружает отношения для каждой пачки.Буферизация драйвера. Документация Laravel предупреждает, что PDO может загрузить весь результат запроса в свой буфер. В частности, у MySQL по умолчанию включены буферизованные запросы, и на очень больших таблицах
cursor()всё равно исчерпает память, хоть и позже, чемall(), потому что сырые строки занимают меньше, чем модели. В наших замерах SQLite отдаёт строки по одной, поэтому цифра +1,1 МБ к MySQL напрямую не переносится.Долгий открытый запрос. Пока идёт обход, курсор держит результат запроса. Если внутри цикла пишете в ту же таблицу, поведение зависит от СУБД и уровня изоляции. Для таких сценариев надёжнее пачки по ключу.
Как выбирать
Нужно только изменить или удалить строки по условию → массовый
update()/delete()на построителе запросов, если не нужны события моделей.Нужно обработать каждую строку в PHP и внутри меняется состав выборки →
chunkById()илиlazyById(), никогда неchunk()/lazy().Нужен произвольный порядок сортировки и данные в процессе не меняются →
chunk()илиlazy()допустимы.Только чтение, без связей, большая таблица, СУБД без буферизации всего результата →
cursor().all()/get()без ограничений → только для таблиц, размер которых заведомо мал и не будет расти.
Как поймать проблему тестом
Ловушка с chunk() проявляется только при числе строк больше размера пачки. Тест должен создавать минимум две пачки и проверять итоговое состояние, а не отсутствие исключений:
public function test_all_new_orders_are_processed(): void
{
    Order::factory()->count(2500)->create(['status' => 'new']);

    (new CloseNewOrders)->handle(); // задача, внутри которой chunkById(1000, ...)

    $this->assertSame(0, Order::where('status', 'new')->count());
}
С chunk(1000) такой тест упадёт: останется 1000 необработанных строк (первый запрос обработает строки 1–1000, второй с offset 1000 получит строки 2001–2500, а так как пачка неполная, цикл на этом закончится).
Если размер пачки задаётся константой или конфигом, в тесте его удобно уменьшить, например до 10, чтобы не создавать тысячи записей.
Скрипт замеров
<?php
// php bench.php seed   — создать базу
// php bench.php <mode> — get|chunk|chunkById|lazy|lazyById|cursor|chunk-update|chunkById-update|mass-update
require __DIR__.'/vendor/autoload.php';
$app = require __DIR__.'/bootstrap/app.php';
$app->make(Illuminate\Contracts\Console\Kernel::class)->bootstrap();

use Illuminate\Database\Eloquent\Model;
use Illuminate\Support\Facades\{DB, Schema};

config(['database.connections.bench' => [
    'driver' => 'sqlite', 'database' => '/tmp/bench.sqlite',
    'prefix' => '', 'foreign_key_constraints' => false,
]]);
DB::setDefaultConnection('bench');

class Order extends Model { protected $guarded = []; public $timestamps = false; }

$mode = $argv[1];
$N = 100000;

if ($mode === 'seed') {
    @unlink('/tmp/bench.sqlite'); touch('/tmp/bench.sqlite');
    Schema::create('orders', function ($t) {
        $t->id(); $t->string('status'); $t->text('payload'); $t->integer('amount');
    });
    DB::transaction(function () use ($N) {
        for ($i = 0; $i < $N; $i += 500) {
            $rows = [];
            for ($j = 0; $j < 500; $j++) {
                $rows[] = ['status' => 'new', 'payload' => str_repeat('x', 200), 'amount' => $i + $j];
            }
            DB::table('orders')->insert($rows);
        }
    });
    exit("seeded $N\n");
}

DB::table('orders')->update(['status' => 'new']); // сброс перед каждым прогоном
gc_collect_cycles();
memory_reset_peak_usage();
$base = memory_get_usage();
$t = hrtime(true);
$n = 0; $q = 0;
DB::listen(function () use (&$q) { $q++; });

switch ($mode) {
    case 'get':       foreach (Order::all() as $o) { $n++; } break;
    case 'chunk':     Order::query()->orderBy('id')->chunk(1000, function ($c) use (&$n) { $n += $c->count(); }); break;
    case 'chunkById': Order::query()->chunkById(1000, function ($c) use (&$n) { $n += $c->count(); }); break;
    case 'lazy':      foreach (Order::query()->lazy(1000) as $o) { $n++; } break;
    case 'lazyById':  foreach (Order::query()->lazyById(1000) as $o) { $n++; } break;
    case 'cursor':    foreach (Order::query()->cursor() as $o) { $n++; } break;
    case 'chunk-update':
        Order::where('status', 'new')->orderBy('id')->chunk(1000, function ($c) use (&$n) {
            foreach ($c as $o) { $o->update(['status' => 'done']); $n++; }
        });
        break;
    case 'chunkById-update':
        Order::where('status', 'new')->chunkById(1000, function ($c) use (&$n) {
            foreach ($c as $o) { $o->update(['status' => 'done']); $n++; }
        });
        break;
    case 'mass-update':
        $n = Order::where('status', 'new')->update(['status' => 'done']);
        break;
}

$left = DB::table('orders')->where('status', 'new')->count();
printf("%-17s rows=%6d queries=%6d time=%6.2fs peak=+%5.1f MB left_new=%d\n",
    $mode, $n, $q, (hrtime(true) - $t) / 1e9, (memory_get_peak_usage() - $base) / 1048576, $left);
Запуск: php bench.php seed, затем php -d memory_limit=-1 bench.php <mode> для каждого режима (без снятия лимита вариант с all() не уложится в 128 МБ).
Итог
chunk() безопасен только тогда, когда выборка не меняется во время обхода. Если колбэк изменяет или удаляет строки, по которым идёт фильтрация, используйте chunkById()/lazyById(), а если обработка в PHP не нужна — один массовый запрос. Проверяйте такие задачи тестом, в котором строк больше, чем помещается в одну пачку, и проверяется итоговое состояние таблицы.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.