[Перевод] Как развернуть Kimi K3 локально на Cerebras
Один из самых частых вопросов, которые нам задают: как мы разворачиваем большие модели на чипах Cerebras размером с целую кремниевую пластину? На одной пластине Cerebras WSE-3T находится 44 ГБ встроенной памяти, а передовым моделям с триллионами параметров нужны терабайты только для хранения весов.
В этой статье мы объясним, как распределяем большую модель между несколькими пластинами WSE-3T, чтобы запускать модели с несколькими триллионами параметров со скоростью 1000–2000 токенов в секунду и выше.
В качестве наглядного примера возьмём открытую модель Kimi K3, в которой около 3 трлн параметров.
К концу статьи вы будете понимать:
как мы размещаем всю модель во встроенной памяти чипов;
как распределяем её между несколькими чипами;
как обрабатываем большое количество одновременных запросов.
Разбираем на примере Kimi K3
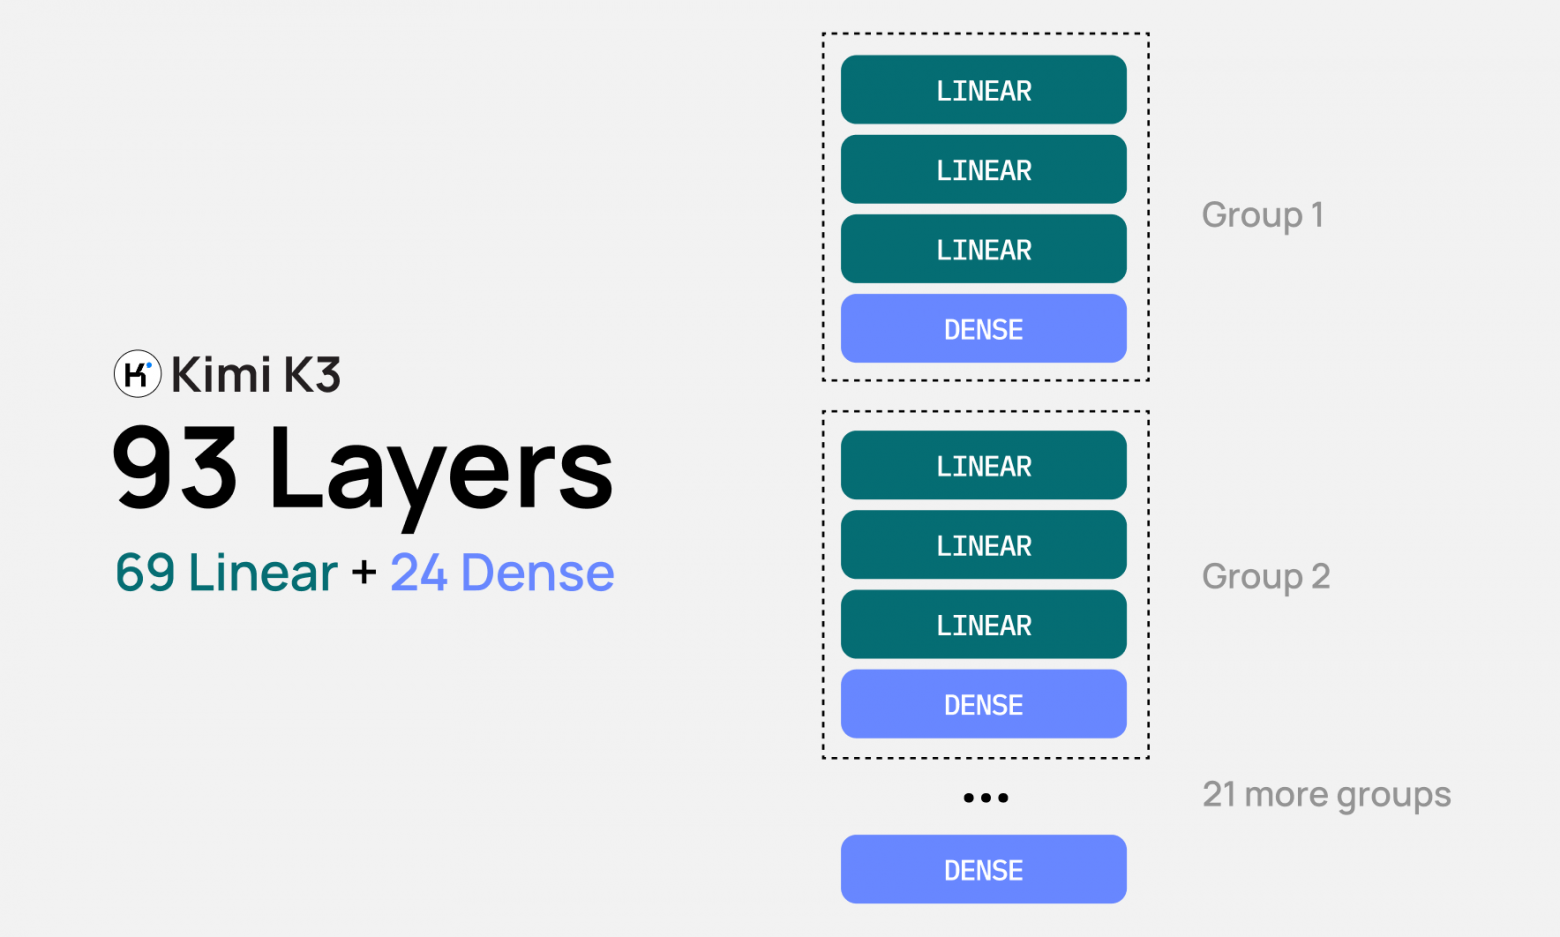
Kimi K3 — открытая модель с 3 трлн параметров, 69 слоями линейного внимания и 24 слоями полного внимания.
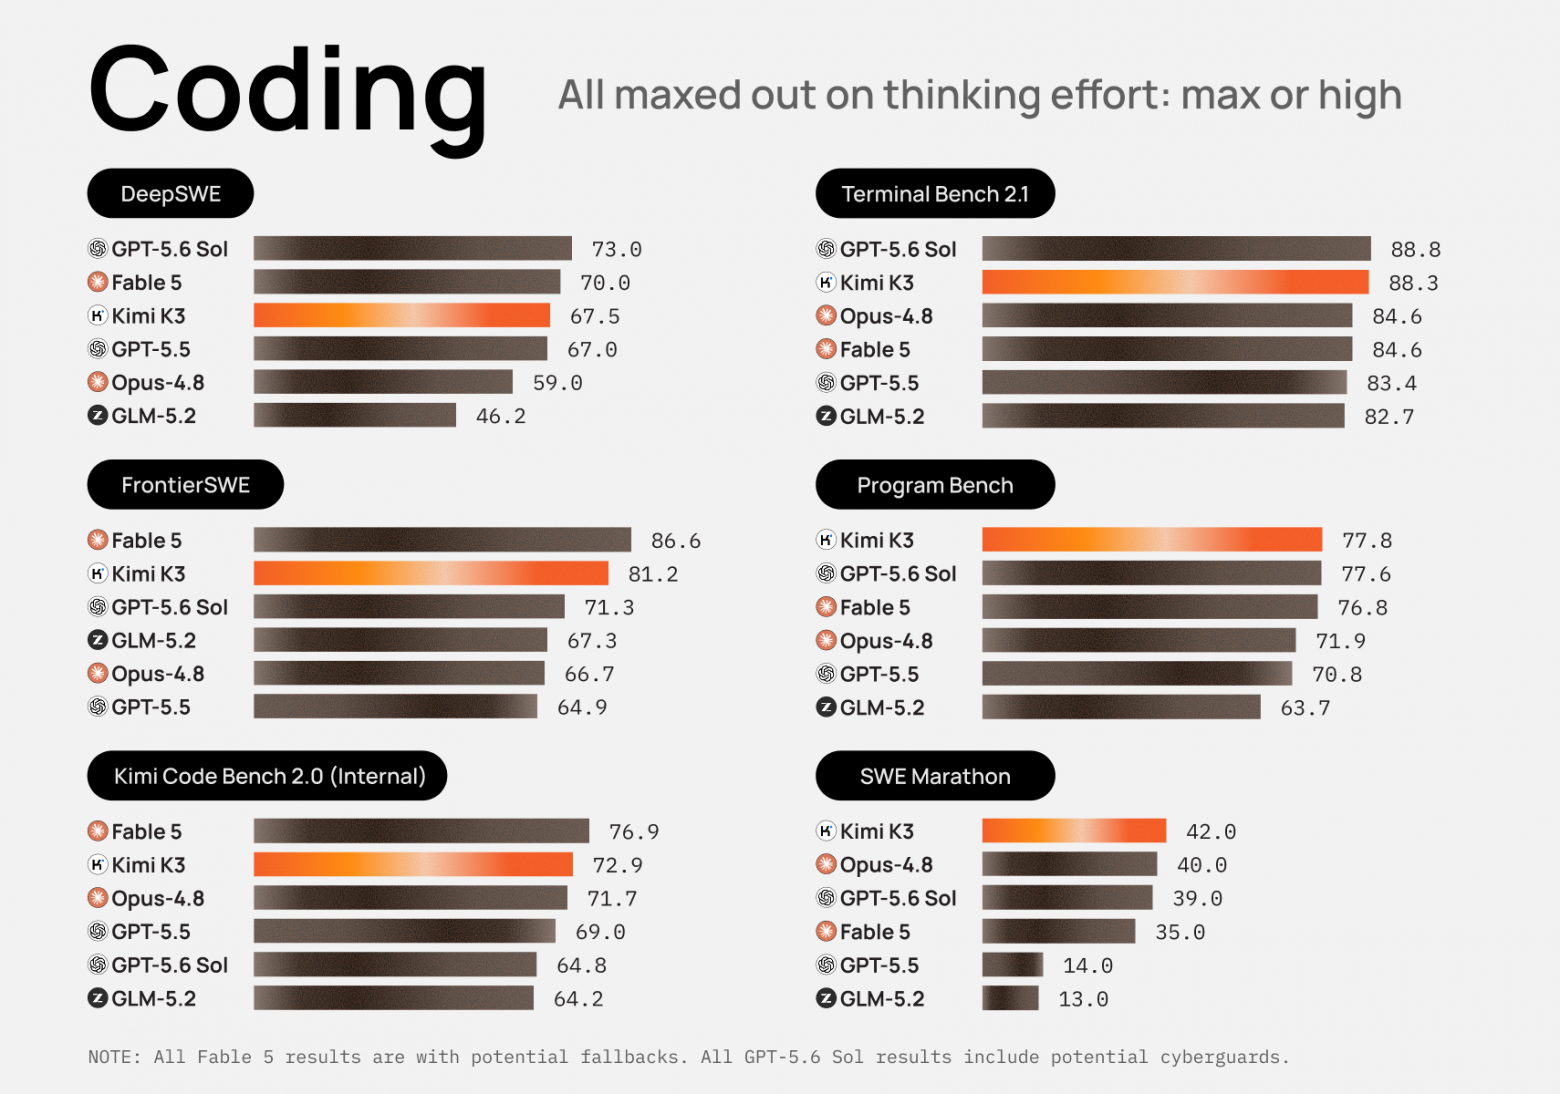
Модель показывает впечатляющий результат: 88,3% на Terminal-Bench 2.1 против 88,8% у GPT-5.6 Sol и 91,2% на BrowseComp против 90,4% у GPT-5.6 Sol. Эти результаты говорят о передовом уровне возможностей в программировании и выполнении агентных задач: в некоторых бенчмарках модель даже опережает ведущие закрытые модели. Подробнее о Kimi K3 можно прочитать здесь.
Для нашего примера примем следующие условия:
средний размер запроса — 256 тысяч токенов;
4-битная квантизация весов, как в реализации на Hugging Face;
8-битный KV-кэш.
1. Размер каждого слоя
Чтобы определить, сколько пластин Cerebras WSE-3T потребуется для запуска Kimi K3, сначала рассчитаем размер каждого слоя модели.
У Kimi K3 3 трлн параметров. Если хранить каждый из них в 4-битном формате, объём самих параметров составит:
3 трлн параметров × 4 бита ÷ 8 бит на байт = 1,5 ТБРазделим этот объём на 93 слоя:
1500 ГБ ÷ 93 ≈ 16 ГБ на слой2. Количество пластин
Теперь мы знаем, что на каждый слой требуется примерно 16 ГБ. Значит, можно определить, сколько слоёв поместится на одной пластине с 44 ГБ памяти. Ответ зависит от типа слоя.
Слоям полного внимания нужно дополнительное место для KV-кэша. Каждый такой слой хранит ключи и значения для каждого токена каждого активного запроса. Поэтому на одной пластине мы размещаем один слой полного внимания, а оставшуюся SRAM отводим под его KV-кэш.
Слоям линейного внимания не нужно дополнительное место для KV-кэша. Вместо того чтобы хранить ключи и значения для каждого токена, такой слой поддерживает небольшое состояние фиксированного размера для каждого запроса — независимо от длины контекста. Благодаря этому на одной пластине помещаются два слоя линейного внимания: 2 × 16 ГБ = 32 ГБ.
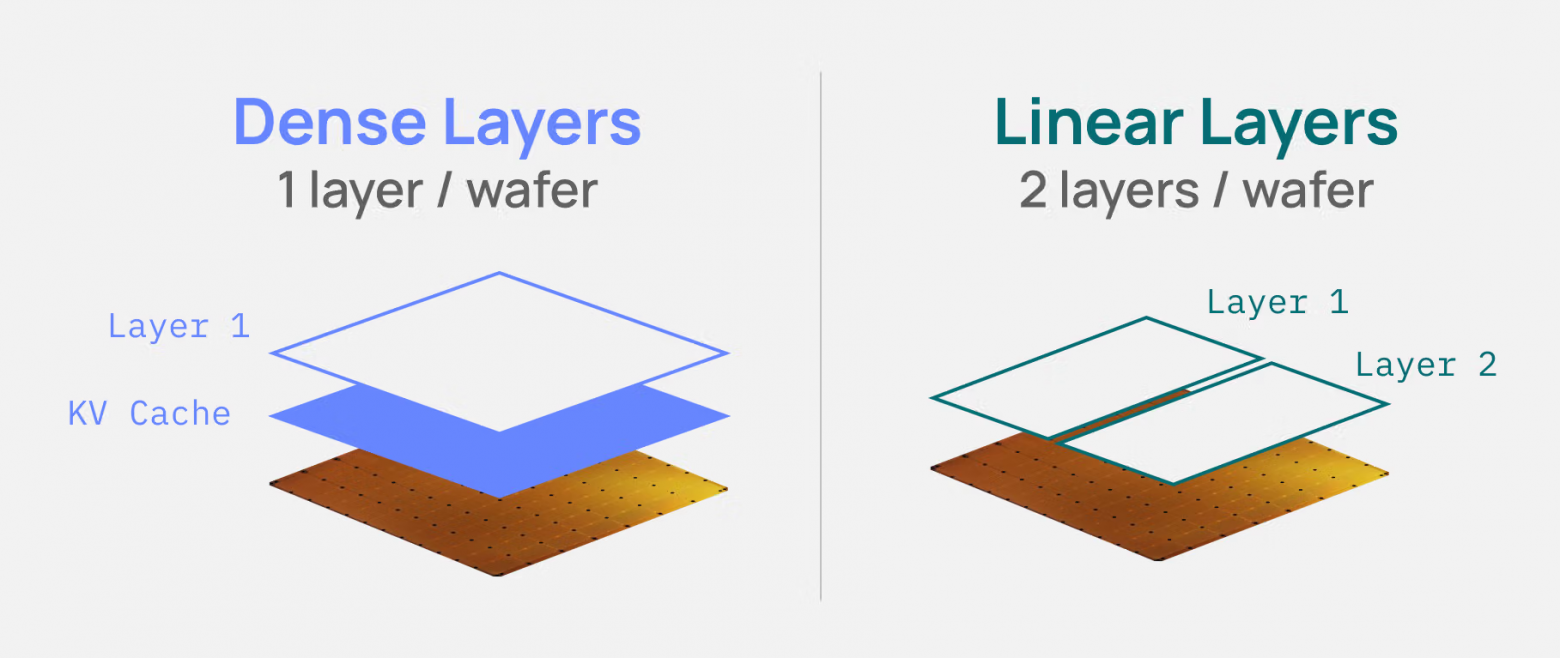
Таким образом, для 69 слоёв линейного внимания и 24 слоёв полного внимания в Kimi K3 получаем:
69 слоёв линейного внимания ÷ 2 слоя на пластину,
с округлением вверх = 35 пластин

24 слоя полного внимания ÷ 1 слой на пластину = 24 пластины
Итого: 35 + 24 = 59 пластин.
Если статья понравится — приглашаю в канал AI for Devs. Каждый день публикую похожие материалы: модели, агенты, практические кейсы и новости из мира AI.
3. Соединяем пластины
Cerebras выполняет вычисления модели конвейерно. Сначала компилятор Cerebras распределяет слои модели по областям пластин, затем среда исполнения определяет маршрут прохождения токенов между ними. Чтобы обеспечить минимальную задержку, между пластинами передаются только активации. Для этого можно использовать RDMA поверх Ethernet. Задержка составляет примерно 2 микросекунды на один переход.
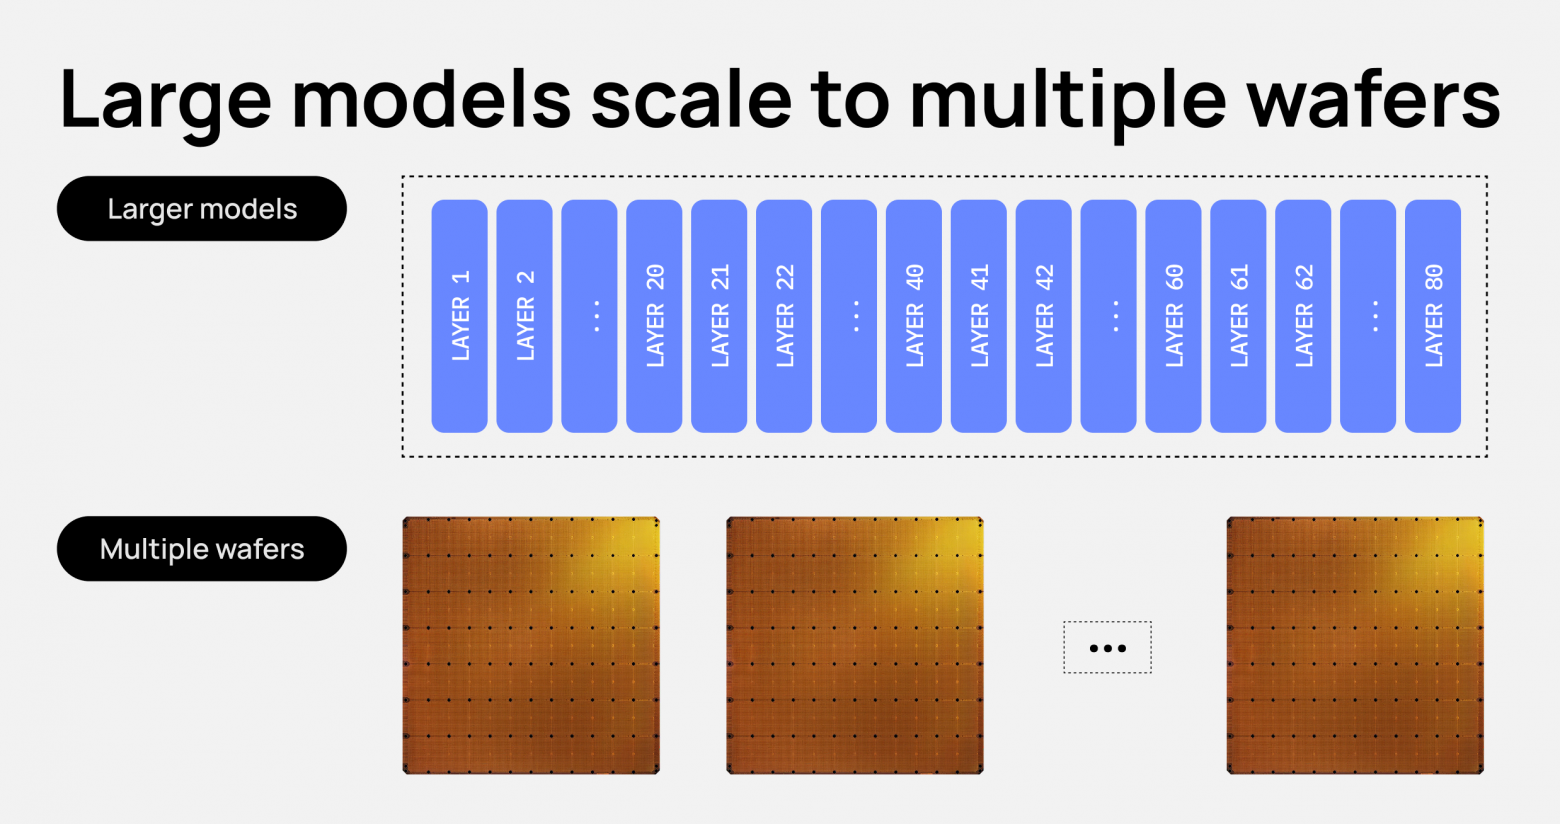
Здесь важно подчеркнуть: поскольку на каждой пластине Cerebras есть 44 ГБ встроенной SRAM, а каждый слой занимает всего 16 ГБ, обычно мы можем размещать слои модели целиком прямо на чипе.
Это означает, что в большинстве случаев веса модели вообще не приходится перемещать, а слои — делить между пластинами. С одной пластины на другую передаются только активации.
4. Как мы обрабатываем один запрос
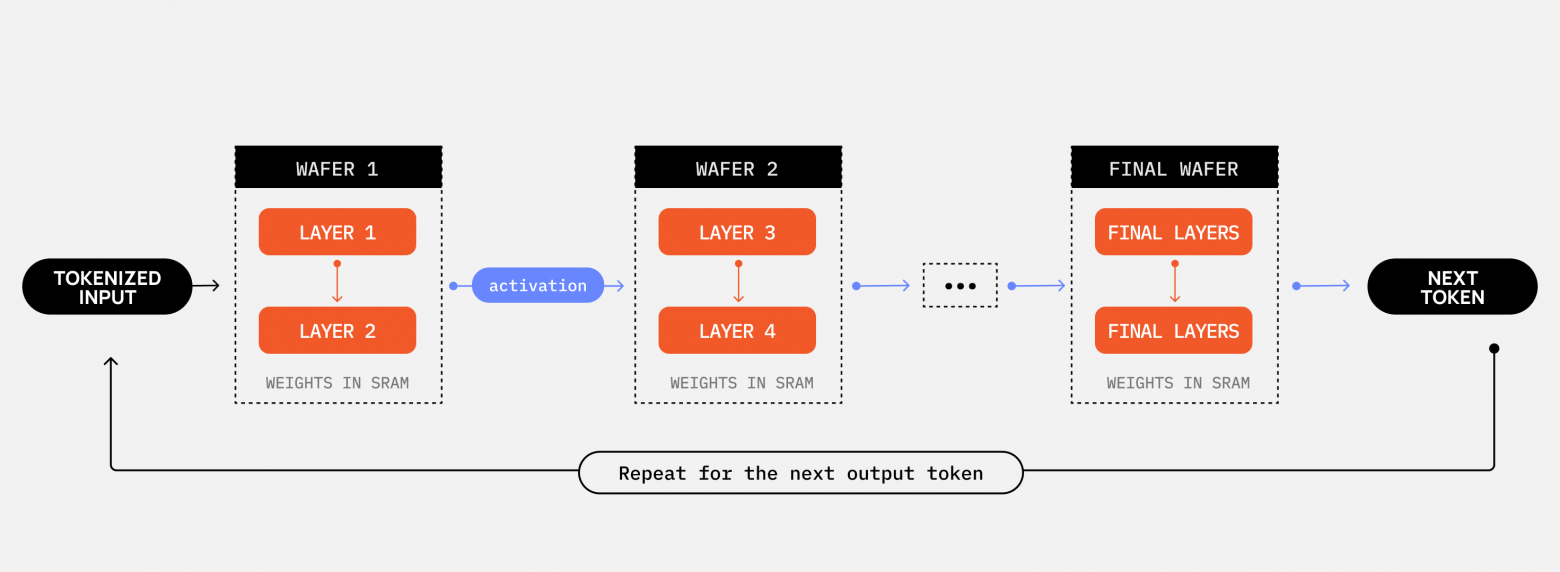
Теперь, когда пластины соединены, а модель распределена между ними, каждую пластину можно представить как этап сборочного конвейера. Веса модели на каждом этапе остаются на месте, а промежуточные результаты запроса проходят через последовательность слоёв.
Например, первая пластина выполняет вычисления для слоёв 1–2 и отправляет активации второй пластине. Вторая выполняет слои 3–4 и передаёт результаты третьей — и так далее, пока последняя пластина не выдаст следующий токен.
5. Как мы обрабатываем много запросов
Здесь возникает распространённое заблуждение. Если токен должен последовательно пройти через каждую пластину, не простаивают ли остальные пластины в ожидании своей очереди? Не получается ли, что система фактически работает с размером батча, равным единице?
Нет! Если бы мы отправляли по конвейеру только один запрос и ждали его завершения, прежде чем запускать следующий, конвейер использовался бы неэффективно. Вместо этого мы постоянно заполняем его разными запросами. Модель уже разбита на этапы, поэтому каждый из них может одновременно работать со своим запросом.
Пока третий этап обрабатывает токен запроса A, второй обрабатывает токен запроса B, а первый — токен запроса C. В нашем примере отдельный слой соответствует одному этапу. В реальной эксплуатации Cerebras использует гораздо более мелкие этапы, и их значительно больше.
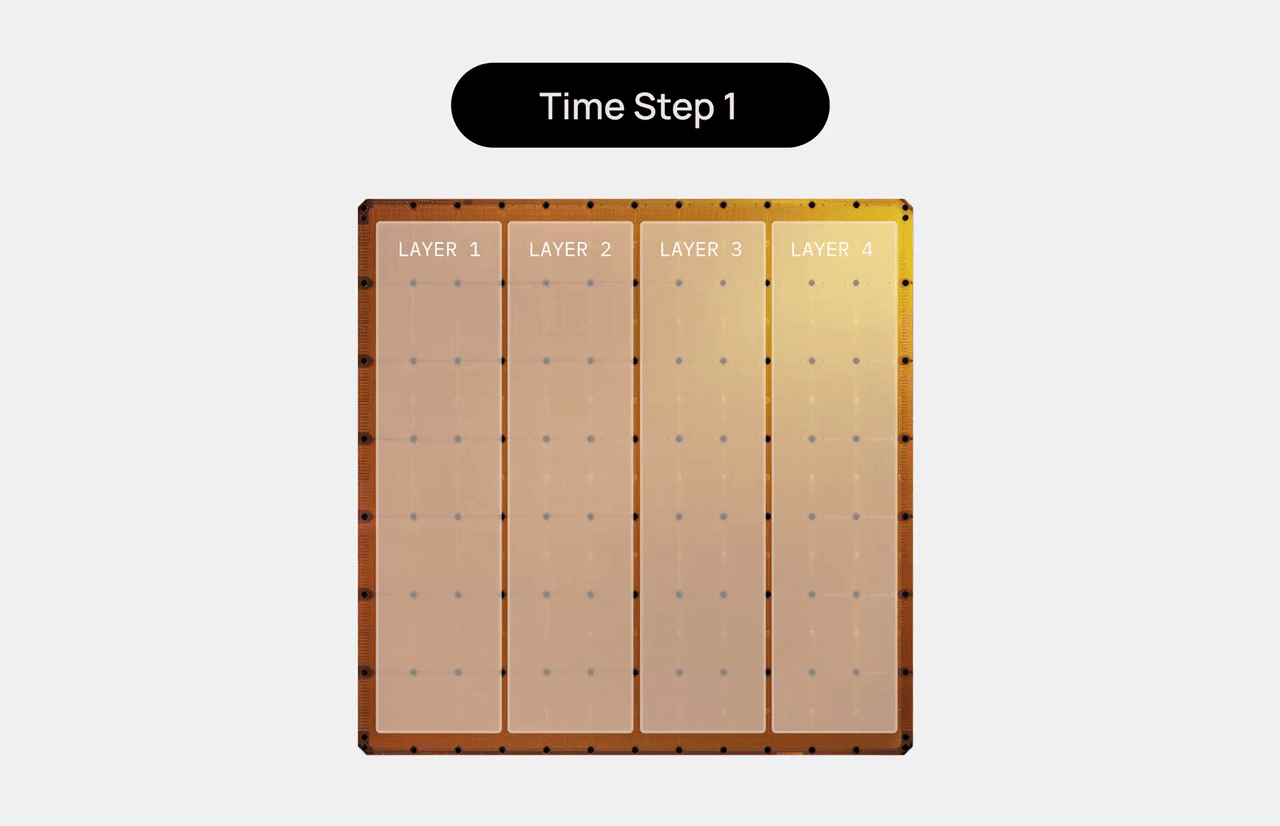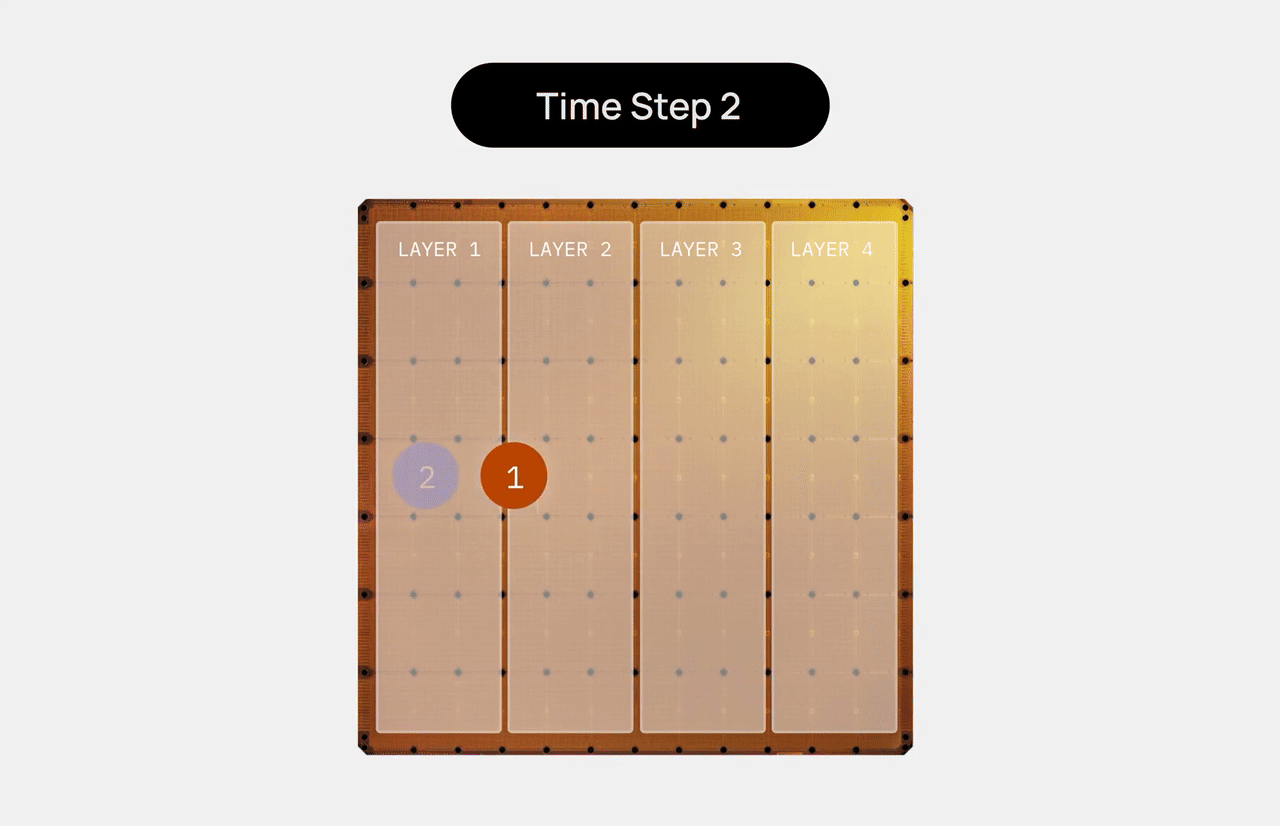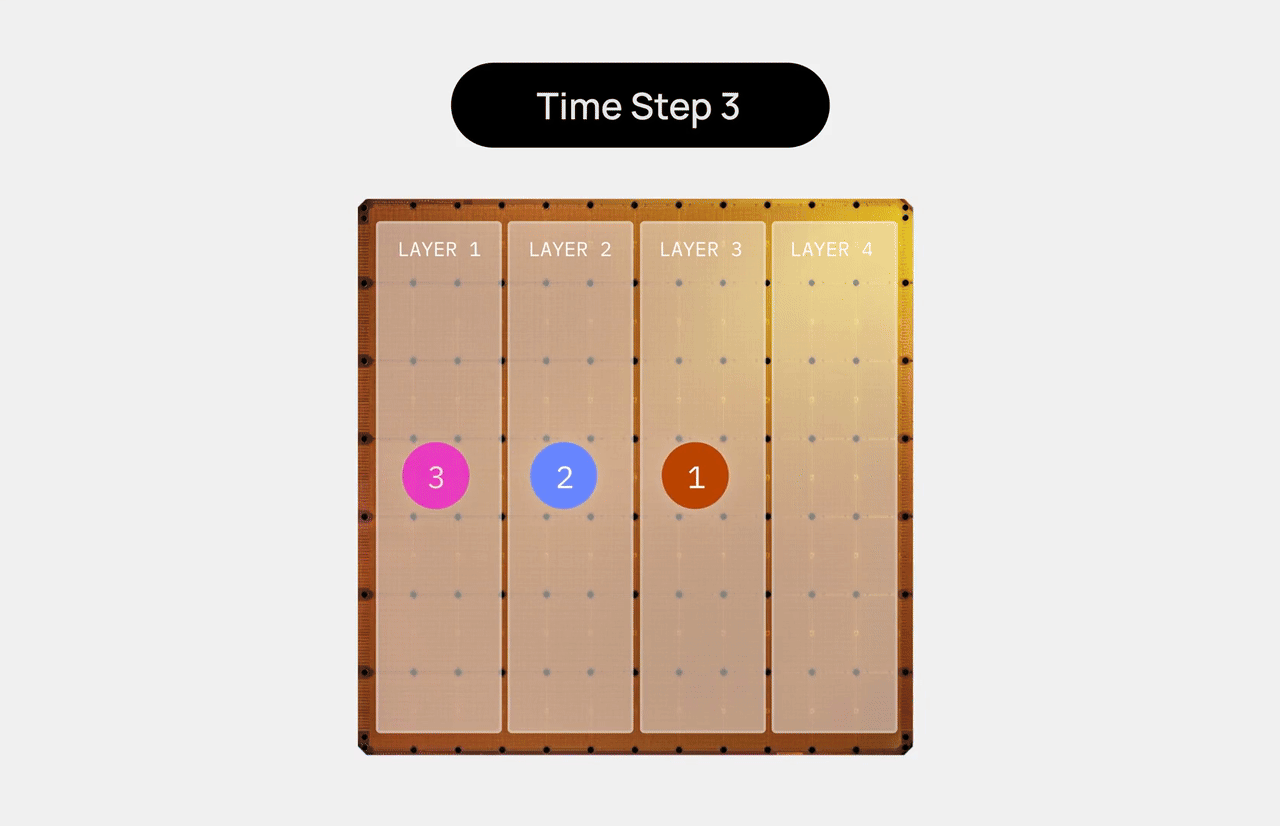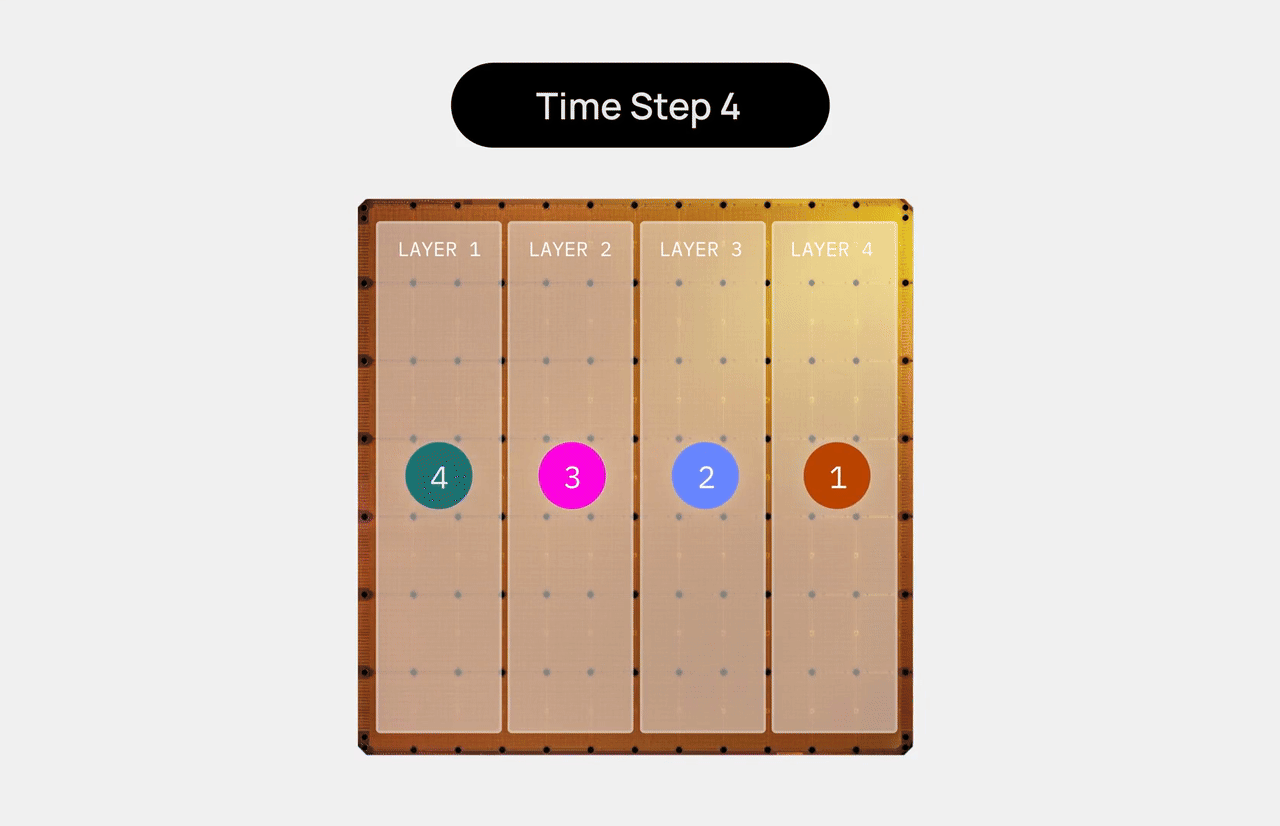
Каждый этап также может обрабатывать микробатч — небольшую группу запросов вместо одного. Поэтому количество запросов, которые одновременно находятся в обработке, примерно равно числу этапов, умноженному на размер микробатча.
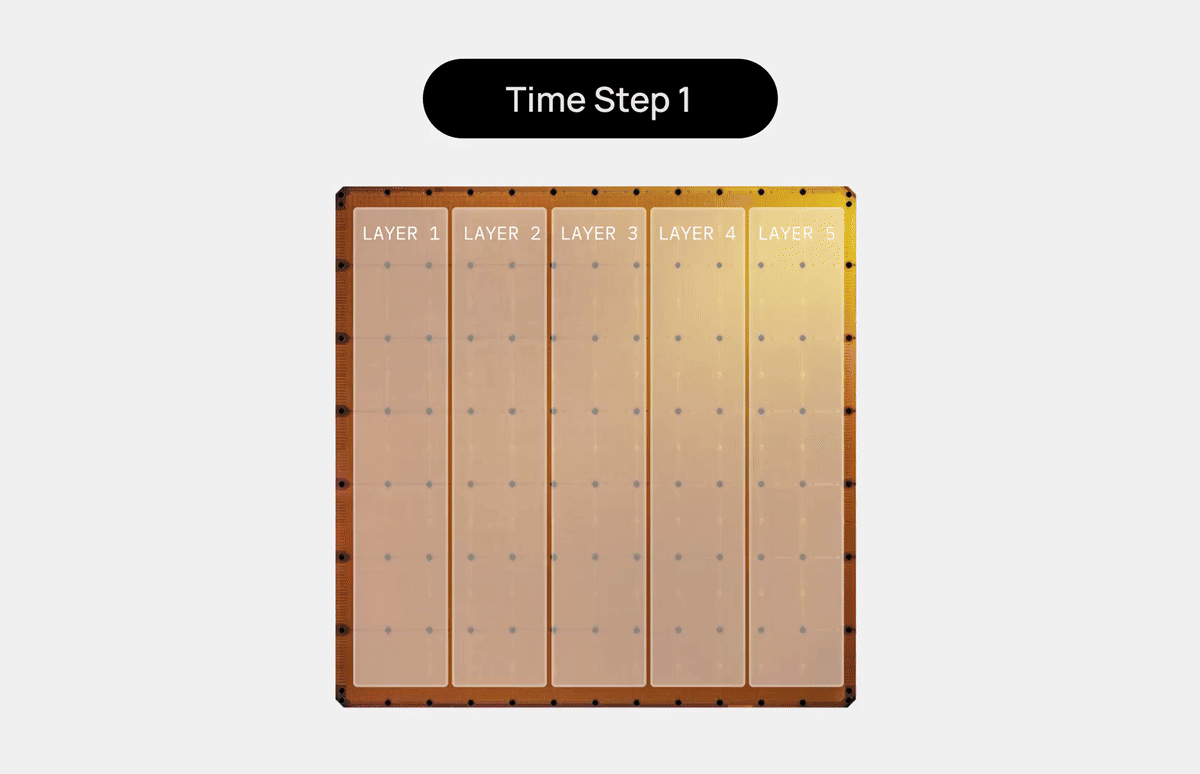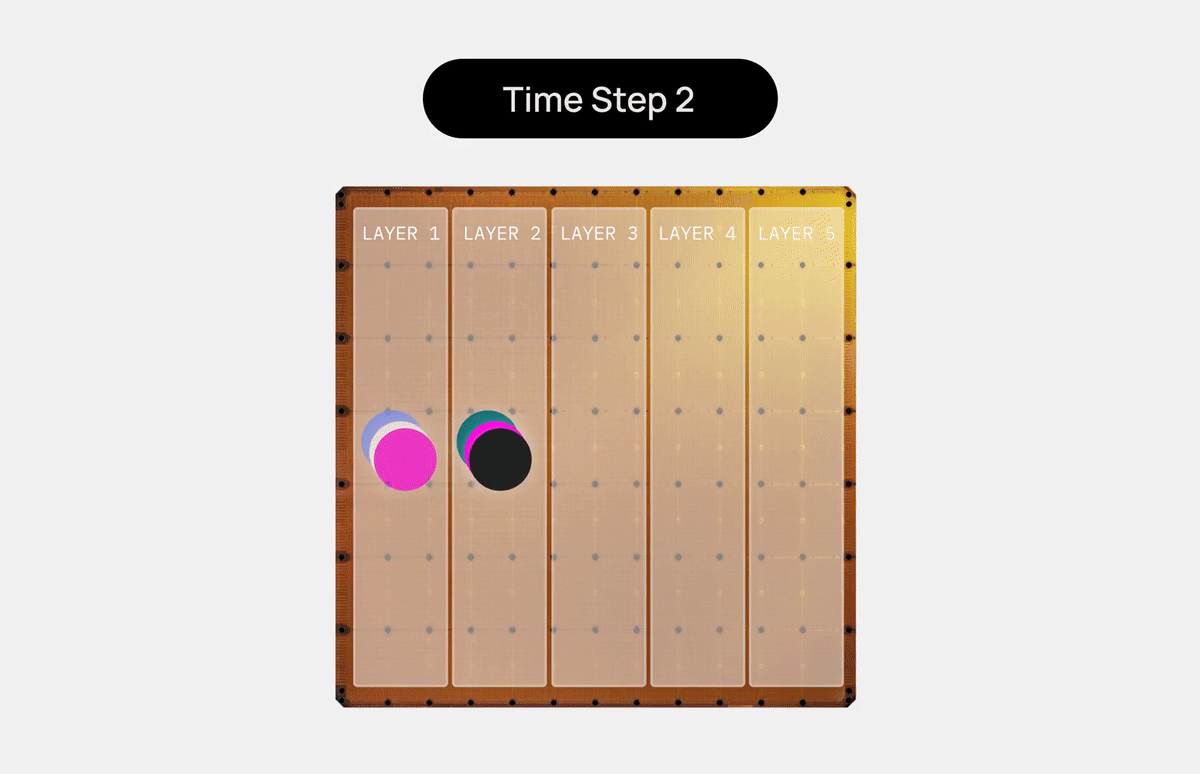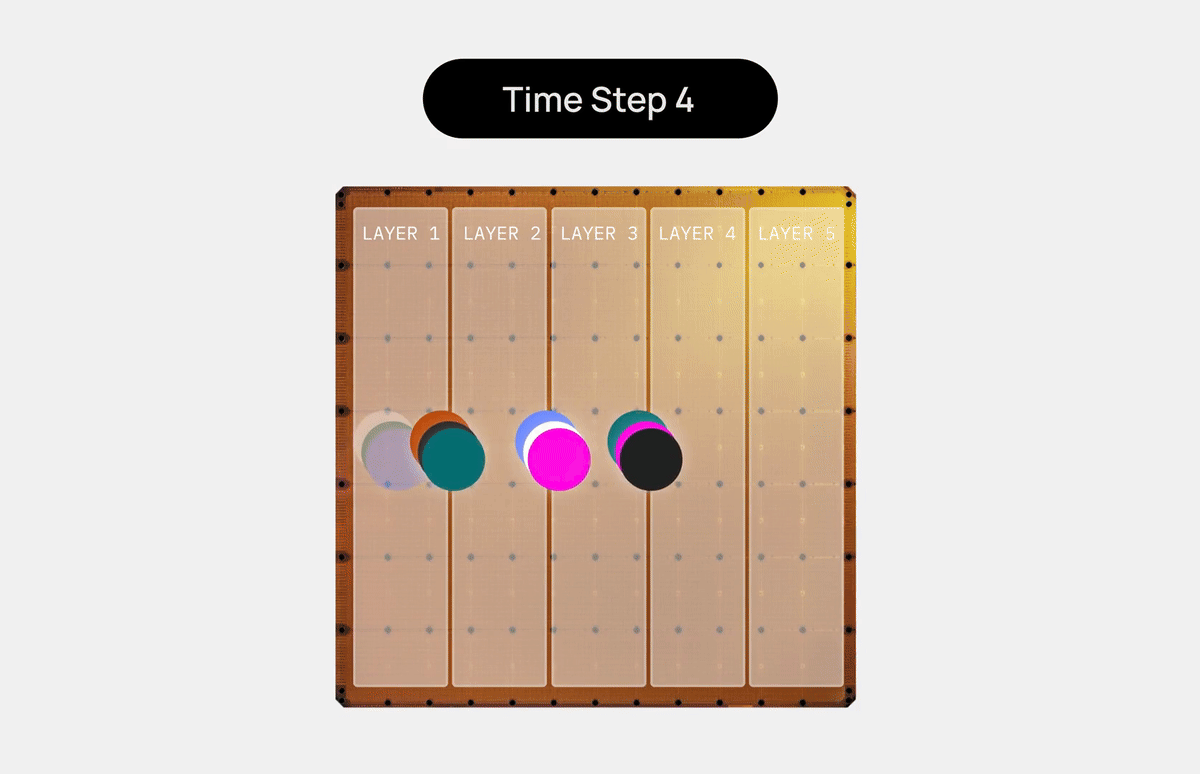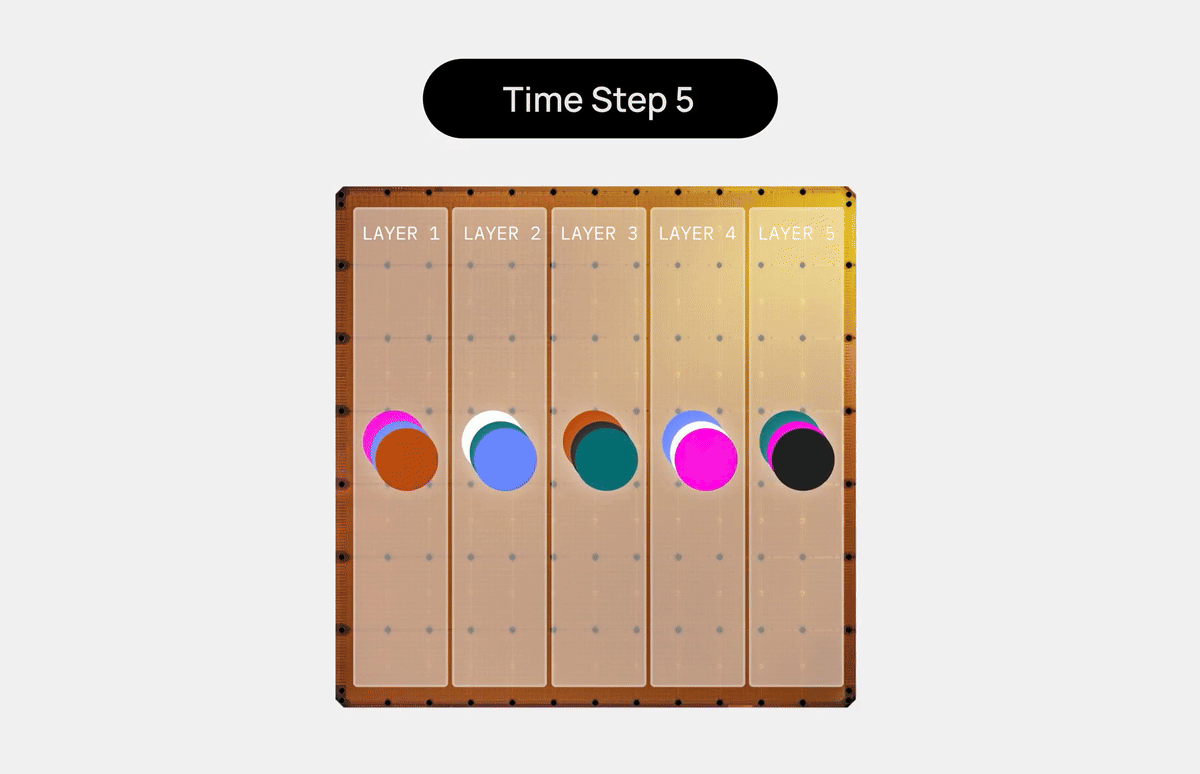
Компромисс следующий: меньшие микробатчи ускоряют обработку каждого отдельного запроса, а большие увеличивают общую пропускную способность.
6. Сколько запросов мы можем обрабатывать
Максимальное количество одновременных запросов определяется объёмом встроенной памяти, выделенным под KV-кэш. Каждому запросу в обработке нужен собственный KV-кэш на каждой пластине со слоем полного внимания. Поэтому объём памяти на чипах задаёт верхний предел числа одновременных запросов. Как мы объяснили выше, рассчитывать потребность в KV-кэше нужно только для слоёв полного внимания.
Для каждой пластины с 44 ГБ памяти, на которой уже размещён один слой полного внимания, оставшееся место под KV-кэш вычисляется так: общий объём памяти пластины минус размер одного слоя полного внимания. В нашем случае:
44 ГБ − 16 ГБ = 28 ГБРассчитываем количество одновременных запросов
Чтобы определить, сколько одновременных запросов поддерживает конкретная схема размещения модели, сначала рассчитаем, сколько кэша занимает один запрос длиной 256 тысяч токенов:
Объём кэша для одной последовательности на одном слое =
    число байт, сохраняемых на токен для этого слоя × длина контекста

576 байт × 256 000 ≈ 147 МБ на последовательность
Затем разделим доступный объём памяти под кэш на объём кэша одного запроса:
28 ГБ ÷ 147 МБ ≈ 190 одновременных запросовОбщее количество одновременных запросов — это число запросов, которые в каждый момент времени проходят через конвейер. В отличие от батча на GPU, эти запросы не ждут завершения друг друга: они непрерывно проходят через конвейер.
Разумеется, ни количество одновременных запросов, ни размер батча сами по себе не показывают, насколько эффективно работает система инференса. При оценке её пропускной способности более содержательная метрика — суммарная скорость генерации токенов на единицу мощности, например токены в секунду на мегаватт, при одинаковой скорости генерации для отдельного запроса.
Как этот подход масштабируется на модели больше 3 трлн параметров
Тот же подход применим и к более крупным моделям: рассчитываем объём памяти для весов и состояний запросов, распределяем модель между пластинами и соединяем их в конвейер. Каждая дополнительная пластина добавляет вычислительные ресурсы и встроенную память. Это позволяет запускать модели, которые не помещаются ни на одном отдельном чипе.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.