Как я предсказал просмотры на Хабре через ML
Чуть больше года назад у меня вышла статья про биржу Kwork (ссылка на статью). Она набрала 30 000 просмотров. Результат неплохой, но в топе того же хабра лежат публикации по 150 000 и 350 000 просмотров. Мне стало интересно, почему одни статьи собирают пару тысяч просмотров, а другие читают сотнями тысяч.
Я решил проверить это с помощью Python и машинного обучения. План был простой: собрать статистику по статьям из моего хаба, оценить качество текстов через языковую модель, загрузить все метрики в Random Forest и посмотреть, какие параметры сильнее всего влияют на просмотры.
В процессе я уперся в лимиты облачного API, локальная нейросеть в LM Studio схитрила на промпте, а сам алгоритм машинного обучения сначала выдал аномальный прогноз из-за утечки данных. Ниже расскажу, как я это исправлял и какие цифры получил в итоге.
Выборка данных и базовые метрики
Для обучения модели нужна была контрастная выборка. Я взял данные по 80 чужим статьям из хабр «Фриланс» (половина из свежей ленты, половина из лучших публикаций за всё время) и добавил к ним свою статью с меткой is_my_article = 1. Всего в таблице habr_dataset.csv оказалась 81 запись.
По каждой статье я собрал базовые структурные параметры:
title_length: длина заголовка в символах.
word_count: общее количество слов в тексте.
images_count: количество изображений.
links_count: количество ссылок внутри материала.
code_blocks_count: количество блоков с кодом.
views: просмотры статьи, переведенные из сокращений вроде 30K в обычные целые числа.
Дополнительно я сохранил первые 3000 символов каждого текста (text_preview), чтобы передать их на анализ нейросети.
Как локальная нейросеть скопировала ответ 81 раз подряд
Одной длины заголовка и количества картинок недостаточно, потому что алгоритм не понимает смысл текста. Поэтому я написал скрипт ai_scorer.py, который отправлял заголовок и начало каждой статьи в LLM. Модель должна была оценить текст по шкале от 1 до 10 по четырем критериям:
clickbait_score: насколько заголовок привлекает внимание.
hook_score: насколько интересно написано вступление.
pain_score: затрагивает ли тема острые проблемы (деньги, конфликты с заказчиками, комиссии бирж).
readability_score: насколько легко читается текст.
Сначала я попытался прогнать датасет через OpenRouter на бесплатной модели google/gemma-4-26b-a4b-it:free. На первой же статье сервер вернул ошибку 429 (temporarily rate-limited upstream) из-за перегрузки общего пула запросов.
Тогда я переключился на локальный запуск. У меня Mac mini M4, поэтому через LM Studio я поднял локальный сервер с квантованной моделью Qwen3 4B 2507 (MLX) весом 2.12 ГБ.
Скрипт быстро прошел все 81 статью. Но когда я открыл терминал, то увидел странный результат:
Абсолютно каждая статья из 81 получила одинаковые оценки: Кликбейт=7, Хук=6, Боль=8, Читаемость=7.
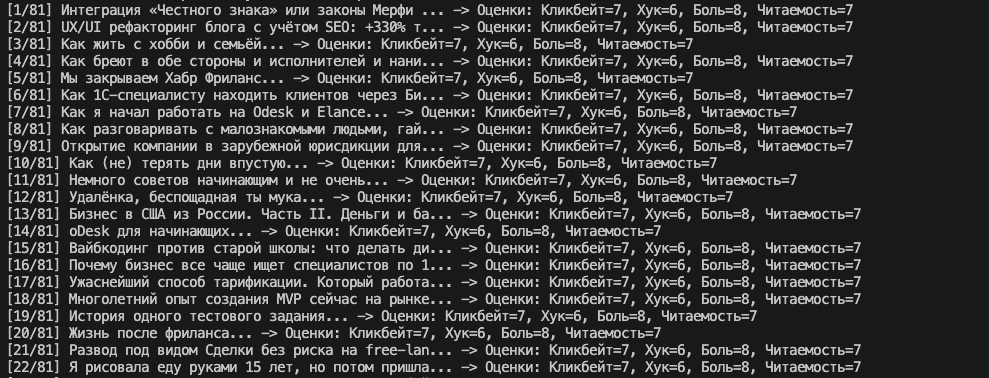
Проблема оказалась в формулировке промпта. В конце инструкции для модели я привел пример правильного JSON:
{"clickbait_score": 7, "hook_score": 6, "pain_score": 8, "readability_score": 7}Маленькая модель на 4 миллиарда параметров не стала анализировать тексты. Она просто скопировала числа из моего примера для каждой статьи. Если подать такой столбец из одинаковых цифр в алгоритм машинного обучения, он получит нулевую значимость.
Feature Engineering и обучение Random Forest
Чтобы не зависеть от галлюцинаций локальной модели, я добавил в аналитический скрипт проверку на уникальность оценок (df['clickbait_score'].nunique() > 1) и написал извлечение объективных признаков из текста через регулярные выражения:
has_question: есть ли в заголовке вопросительный знак.
has_numbers: есть ли в заголовке цифры.
has_triggers: содержит ли заголовок ключевые слова тематики (kwork, fl, upwork, деньг, рубл, обман, ошибк, заказчик и другие).
images_per_1000_words: сколько картинок приходится на каждую 1000 слов текста.
Код обучения модели и сравнения статей (ml_analyzer.py):
import re
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor

df = pd.read_csv('habr_dataset_scored.csv')

df['has_question'] = df['title'].apply(lambda x: 1 if '?' in str(x) else 0)
df['has_numbers'] = df['title'].apply(lambda x: 1 if bool(re.search(r'\d', str(x))) else 0)

trigger_words = ['kwork', 'fl', 'upwork', 'odesk', 'деньг', 'рубл', '$', 'обман', 'кидал', 'ошибк', 'устал', 'кладбище', 'жила', 'бизнес', 'заказчик']
df['has_triggers'] = df['title'].apply(lambda x: 1 if any(w in str(x).lower() for w in trigger_words) else 0)
df['images_per_1000_words'] = (df['images_count'] / (df['word_count'] + 1)) * 1000

features = [
    'title_length', 'word_count', 'images_count', 'code_blocks_count',
    'links_count', 'has_question', 'has_numbers', 'has_triggers', 'images_per_1000_words'
]

X = df[features].fillna(0)
y = np.log1p(df['views']) # Логарифмируем просмотры для сглаживания выбросов

model = RandomForestRegressor(n_estimators=200, random_state=42)
model.fit(X, y)

importances = pd.DataFrame({
    'Признак': features,
    'Влияние (%)': (model.feature_importances_ * 100).round(1)
}).sort_values(by='Влияние (%)', ascending=False)
print(importances.to_string(index=False))
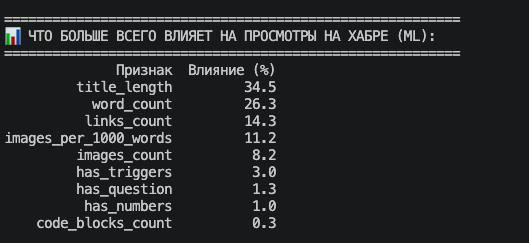
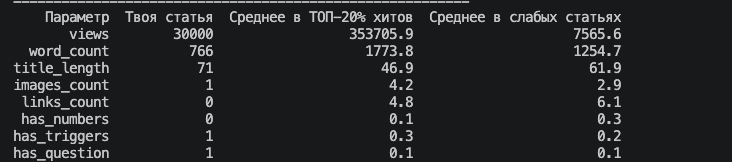
После запуска скрипт вывел веса признаков и сравнил параметры моей статьи с ТОП-20% самых популярных публикаций выборки (порог входа туда составил 148 000 просмотров) и со слабыми статьями (нижние 40% выборки, где средние просмотры около 7 565):
Что показывают эти цифры:
Длина заголовка (title_length) дает 34.5% влияния. Это главный структурный фактор. У слабых статей средняя длина заголовка составляет 61.9 символа. У моей статьи было 71 символ («Kwork — кладбище фрилансеров или золотая жила? Две стороны одной монеты»). А у ТОП-20% самых читаемых статей средняя длина заголовка равна 46.9 символа. Короткие заголовки лучше читаются в ленте. Если убрать из моего заголовка вторую часть («Две стороны одной монеты»), останется ровно 46 символов.
Объем статьи (word_count) дает 26.3% влияния. В моей статье было всего 766 слов. В слабых статьях в среднем 1254.7 слова, а в ТОП-20% средний объем составляет 1773.8 слова. Объемные лонгриды получают больше времени чтения и лучше ранжируются в поиске.
Ссылки и картинки (links_count, images_per_1000_words, images_count) суммарно дают 33.7% влияния. В топовых публикациях в среднем 4.2 картинки и 4.8 ссылки. В моей статье была всего 1 картинка на обложке и 0 ссылок.
Блоки кода (code_blocks_count) влияют всего на 0.3%. Для хаба про фриланс это логично: аудитория приходит туда за разбором рабочих ситуаций и личным опытом, а не за сниппетами кода.
Ошибка с утечкой данных при создании предсказателя
На следующем шаге я решил написать скрипт predictor.py, который бы предсказывал успешность новой статьи до её публикации. Я задал порог «хита» в 25 000 просмотров и обучил две модели: RandomForestClassifier (оценивает вероятность пробить 25К просмотров в процентах) и RandomForestRegressor (предсказывает ожидаемое число просмотров).
Для проверки я прогнал через модель два варианта:
Исходные параметры моей статьи (заголовок 71 символ, 766 слов, 1 картинка, 0 ссылок).
Доработанный вариант по метрикам топа (короткий заголовок с цифрой, 1750 слов, 5 картинок, 4 ссылки).
Неожиданно первый (сырой) вариант получил вероятность успеха выше, чем доработанный второй.
При разборе кода выяснилось, что я допустил две ошибки:
Data Leakage (утечка данных). Моя статья (у которой уже было 30 000 просмотров, что выше порога в 25 000) осталась внутри обучающей выборки. Деревья решений без ограничения глубины просто запомнили конкретную комбинацию (71 символ + 766 слов = больше 25К просмотров). Когда я передал эти же числа на тест, алгоритм выдал завышенную оценку, потому что уже видел этот пример при обучении.
Штраф за цифры в заголовке. Во втором тестовом варианте я добавил в заголовок цифру. А по нашей таблице в слабых статьях цифры в заголовках встречались в три раза чаще (0.3), чем в топовых (0.1), из-за большого количества рекламных кейсов в свежей ленте.
Я исправил скрипт: исключил свою статью из обучающей выборки (train_df = df[df['is_my_article'] == 0]) и ограничил глубину деревьев параметром max_depth=4, чтобы модель искала общие правила, а не запоминала отдельные строки.
Результат честного теста:
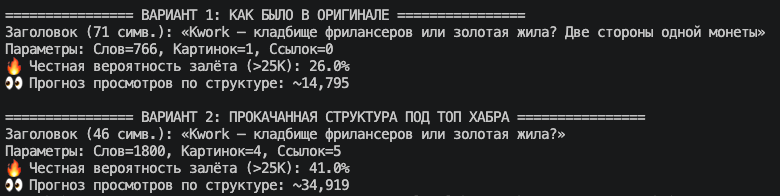
Теперь показатели стали логичными. Моя исходная статья (которую модель раньше не видела) только за счет своей структуры получила 26.0% вероятности набрать больше 25 тысяч просмотров и базовый прогноз в 14 795 просмотров.
А второй вариант с доработанной структурой (заголовок 46 символов, 1800 слов, 4 картинки, 5 ссылок) получил 41.0% вероятности и прогноз в 34 919 просмотров.
Почему модель предсказала 14 795 просмотров, а в реальности вышло 30 000?
Здесь видно главное ограничение структурной модели. Алгоритм оценивал только «упаковку» текста: длину заголовка, число слов, наличие картинок и ссылок. Он не знал, о чем именно написана статья.
Для короткой заметки на 766 слов с одной картинкой и длинным заголовком 14.8 тысячи просмотров — это нормальный средний потолок. То, что статья в реальности собрала 30 000 просмотров (в два раза выше прогноза), дала сама тема биржи Kwork и обсуждение заработка в комментариях.
Но из этого следует практический вывод: если острая тема сама по себе умножает охваты в два раза, то при упаковке этого же материала в полноценный лонгрид (на 1800 слов с 4 картинками и коротким заголовком) базовая планка составила бы уже около 35 000 просмотров, а итоговый охват мог перевалить за 60 000.
Финальный скрипт для проверки черновиков
В итоге я убрал из predictor.py тестовые заглушки и сделал консольную утилиту с ручным вводом параметров через input().
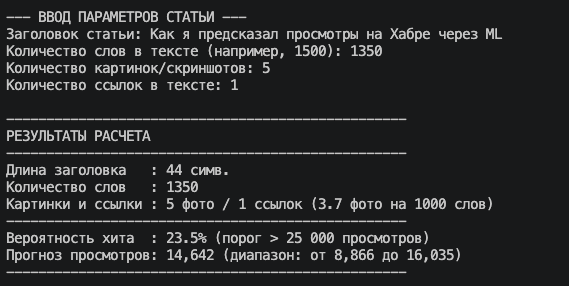
Чтобы не ориентироваться на одно усредненное число, я добавил расчет межквартильного размаха (IQR — диапазон между 25-м и 75-м перцентилями предсказаний всех 200 отдельных деревьев внутри RandomForestRegressor). Это позволяет видеть минимальный и максимальный коридор просмотров для выбранной структуры статьи:
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier

def build_models(csv_path='habr_dataset_scored.csv'):
    df = pd.read_csv(csv_path)
    train_df = df[df['is_my_article'] == 0].copy()

    features = ['title_length', 'word_count', 'images_count', 'links_count', 'images_per_1000_words']
    train_df['images_per_1000_words'] = (train_df['images_count'] / (train_df['word_count'] + 1)) * 1000

    X_train = train_df[features].fillna(0)
    y_views = np.log1p(train_df['views'])
    y_hit = (train_df['views'] >= 25000).astype(int)

    reg = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=42).fit(X_train, y_views)
    clf = RandomForestClassifier(n_estimators=200, max_depth=4, random_state=42).fit(X_train, y_hit)
    return reg, clf, features
Вот предсказания этой статьи:
Выводы по цифрам
Если ориентироваться на данные модели по нетехническим и карьерным публикациям:
Заголовок в районе 45–50 символов. Длинные конструкции из двух предложений снижают кликабельность в ленте.
Объем текста от 1500 до 1800 слов. Короткие заметки до 800 слов теряют в удержании и поисковом трафике.
Минимум 4 иллюстрации и 4–5 ссылок. Графика разбивает полотно текста (оптимальная плотность — около 2.5 картинок на 1000 слов).
Проверка данных после LLM. Маленькие локальные модели требуют жесткой валидации ответов, иначе они легко копируют примеры прямо из системного промпта.
Эта статья написана уже с учетом параметров, которые выдал скрипт. Посмотрим на практике, совпадет ли реальное количество просмотров с расчетным диапазоном модели.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.