数十億人のユーザー数をわずか数KBのメモリで推定できるアルゴリズム「HyperLogLog」とは?
ウェブサイトを訪れたユーザーの数を正確に把握するには、訪問者のIDを記録して重複を取り除く必要があります。しかし、2007年に発表されたアルゴリズム「HyperLogLog」を使えば、わずか数KBのメモリで数十億人規模のユーザー数を推定することが可能です。このHyperLogLogの仕組みについて、科学誌のScientific Americanが解説しています。
The coin-flipping trick that counts the Internet | Scientific American
https://www.scientificamerican.com/article/the-coin-flipping-trick-that-counts-the-internet/
ウェブサイトのページビュー数を数えるのは簡単で、ページが読み込まれるたびにカウンターの数字を1ずつ増やせば済みます。一方、何人のユーザーがページを閲覧したのかを正確に数えるには、訪問したユーザーのIDをすべて記録し、新たなアクセスがあるたびに過去の記録と照合しなければなりません。数百万人が利用するウェブサイトやSNSで記事や投稿ごとにユーザー数を集計すると、膨大な量のデータを保存する必要が生じます。
この問題を解決するため、フランス国立情報学自動制御研究所(INRIA)のフィリップ・フラジョレ氏らは2007年にHyperLogLogを発表しました。
HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm | Discrete Mathematics & Theoretical Computer Science | Discrete Mathematics & Theoretical Computer Science
https://dmtcs.episciences.org/en/articles/3545
HyperLogLogは、重複を除いたデータの個数を正確に数える代わりに、確率を利用して推定することでメモリ使用量を大幅に削減するアルゴリズムです。
例えば、コインを投げて表が出るまでに何回連続で裏が出るかを調べるゲームを想定します。コインを1回投げて裏が出る確率は2分の1、2回連続で裏が出る確率は4分の1、3回連続で裏が出る確率は8分の1です。裏が10回連続で出る確率は1024分の1なので、ゲームを繰り返して最長記録が10回だった場合、およそ1000回のゲームが行われたと推測できます。
同様に、ゲームを100万回繰り返せば裏が20回ほど連続で出ることが期待でき、10億回なら30回ほどになります。つまり、裏が連続で出た回数の最大値さえ記録しておけば、ゲームが何回行われたのかを大まかに推定できるというわけです。
HyperLogLogでは、コイントスの代わりに「ハッシュ関数」を利用します。ハッシュ関数は入力されたデータを一見ランダムな値に変換する関数で、同じデータを入力すれば常に同じ値が得られるという特徴があります。ウェブサイトにアクセスしたユーザーのIDをハッシュ関数で0と1の列に変換し、先頭から0が何個連続しているかを調べれば、コイントスで裏が連続して出る回数を調べるのと同じようにユーザー数を推定できます。
例えば、10人のユーザーがアクセスした結果、先頭に0が連続する回数の最大値が3だった場合、ユーザー数は2の3乗で8人程度と推定できます。同じユーザーが再びアクセスしてもハッシュ関数が生成する値は変わらないため、0が連続する回数の最大値が更新されることはありません。これにより、過去にアクセスしたユーザーのIDを保存しておかなくても、重複を除いたユーザー数を推定できます。
しかし、偶然にも非常に長い0の列を持つユーザーが1人現れただけで、推定値が実際のユーザー数を大きく上回ってしまう可能性があります。そこでHyperLogLogでは、ハッシュ値の先頭部分を利用してユーザーを複数のグループに振り分け、それぞれのグループで独立してユーザー数を推定します。
例えばハッシュ値の先頭2桁を利用すれば、ユーザーを「00」「01」「10」「11」の4グループに振り分けることが可能です。各グループでは振り分けに使用した2桁を除き、残りの桁で最初に1が出現する位置の最大値を記録します。ハッシュ値が「10001……」だった場合、ユーザーは「10」のグループに振り分けられ、残りの「001……」から最初の1の位置である「3」が記録の更新に使用されます。
HyperLogLogでは各グループの記録から得られる推定値を統合する際に調和平均を利用し、さらに補正係数を掛けることで全体のユーザー数を算出します。調和平均には極端に大きな値の影響を抑える性質があるため、一部のグループで偶然長い0の列が出現しても、全体の推定値が大きく狂いにくくなります。
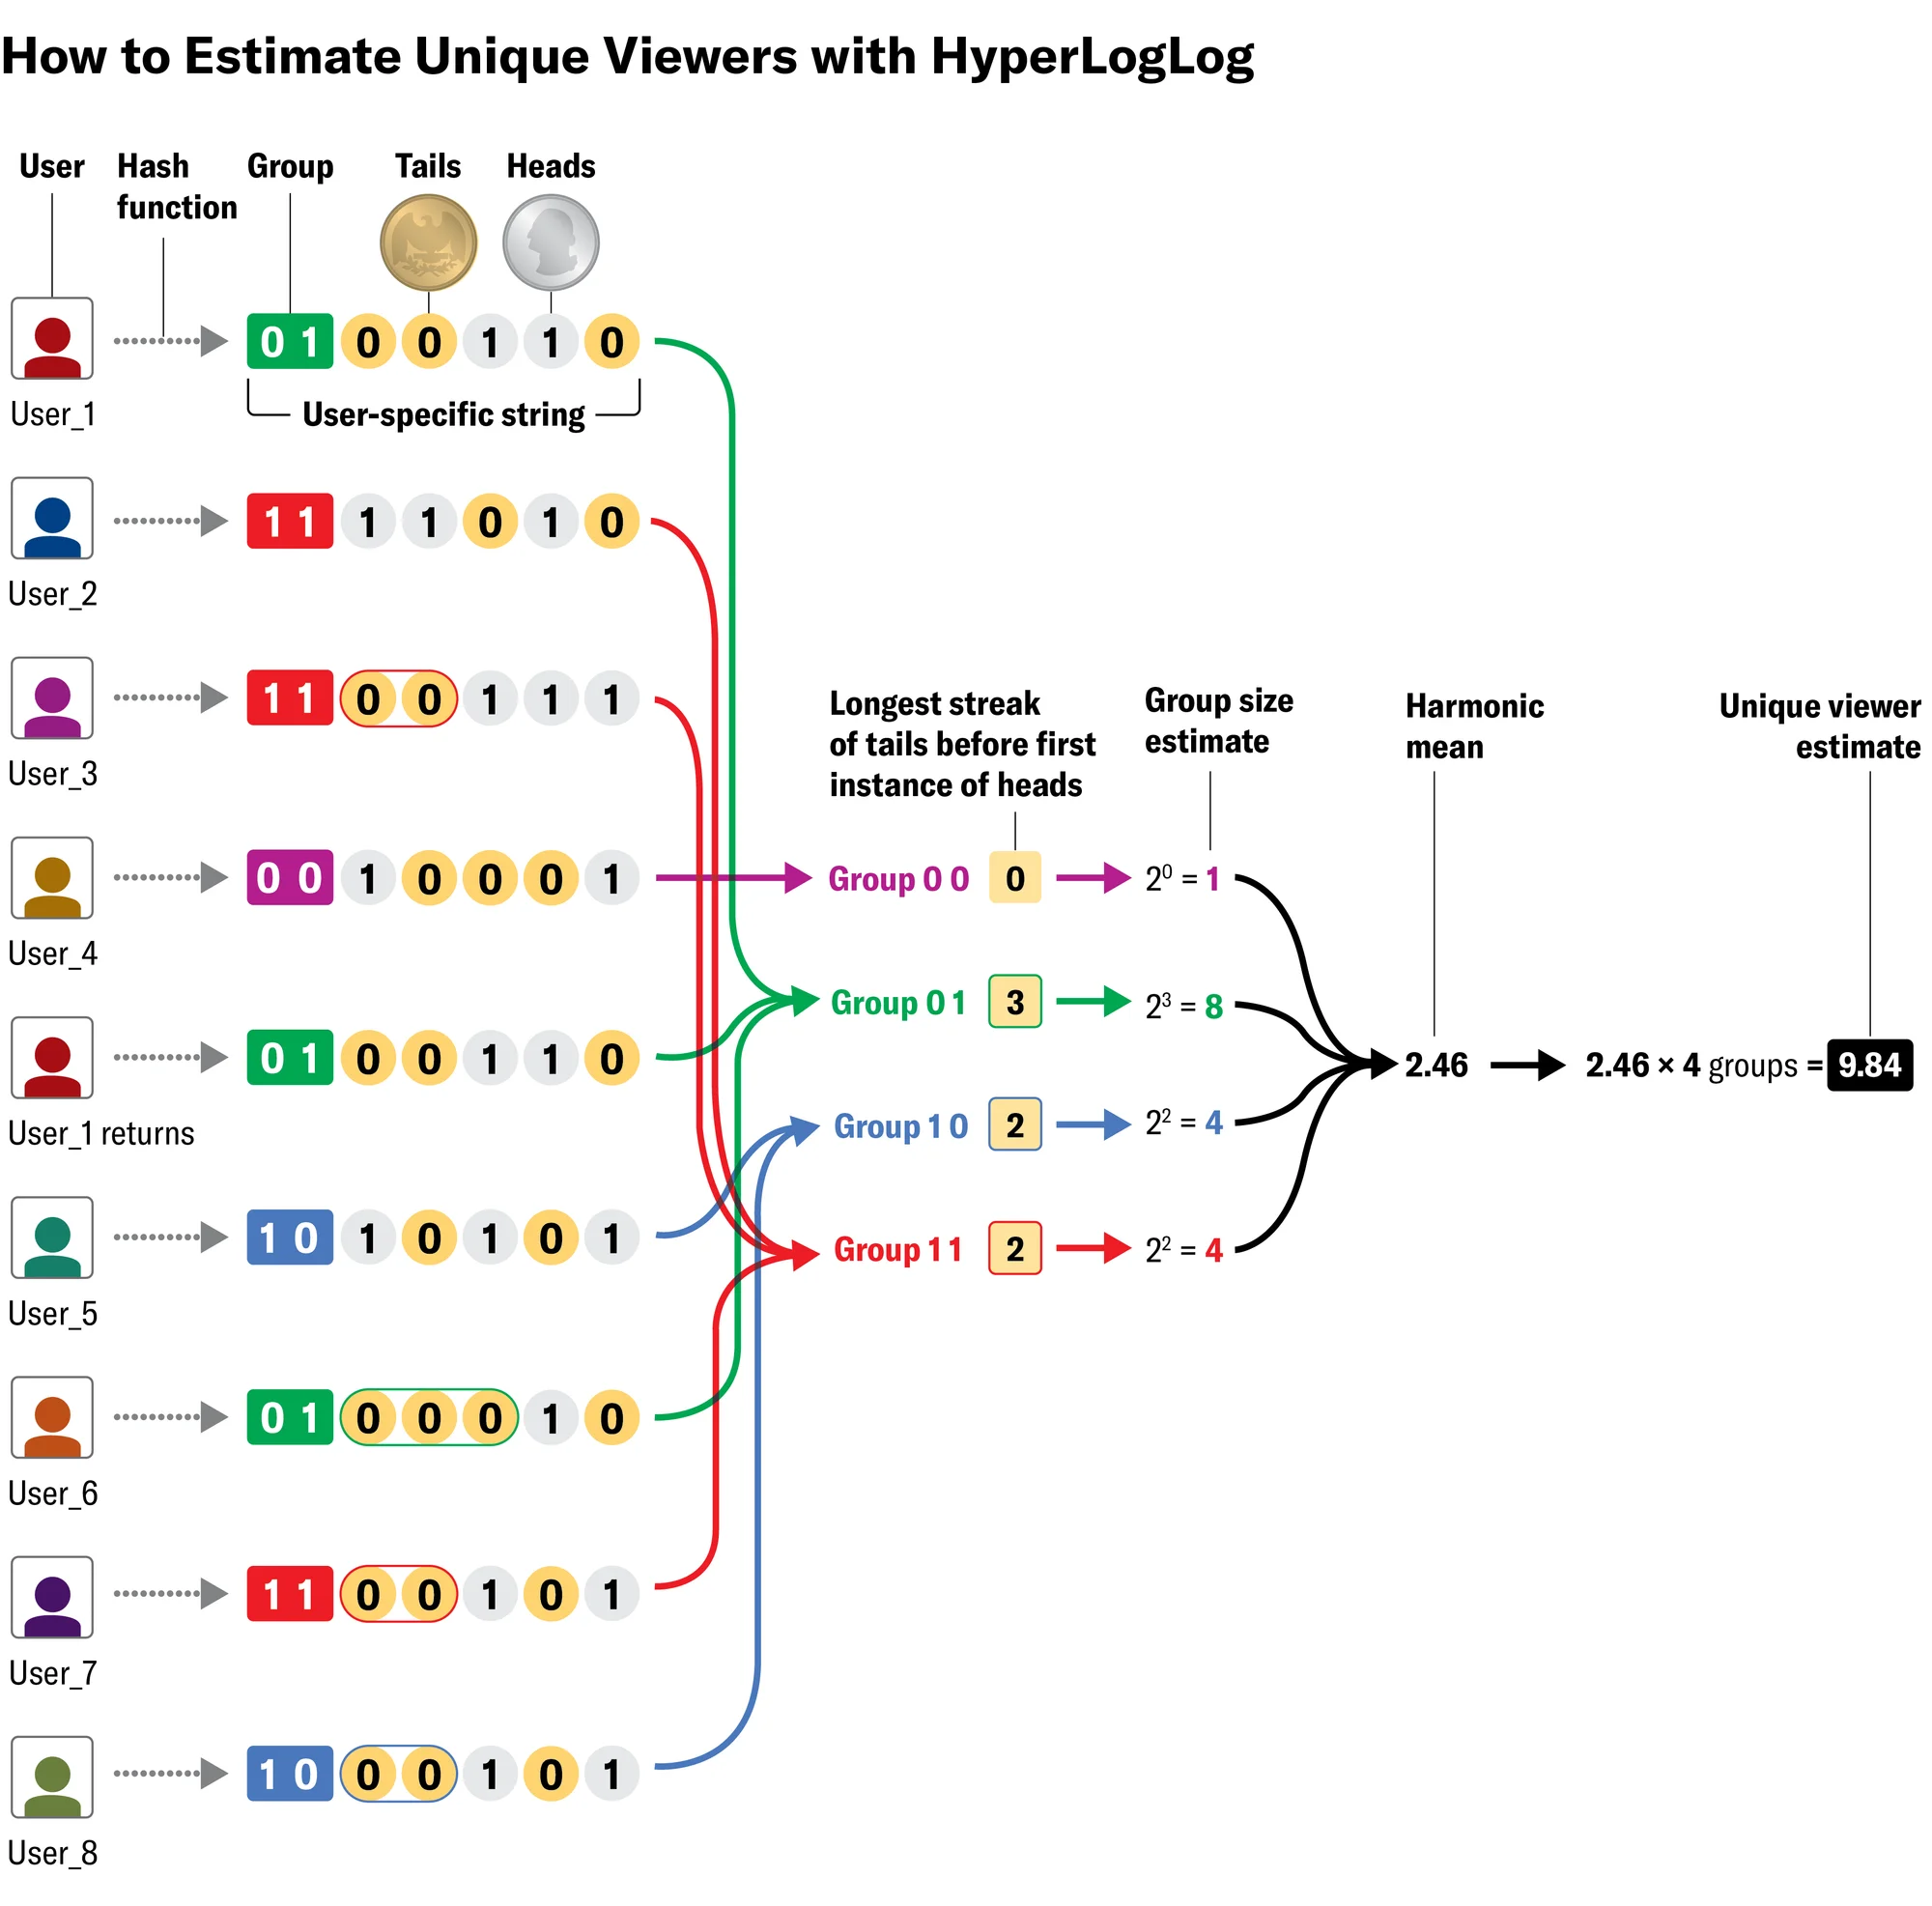
以下はHyperLogLogによるユーザー数の推定を簡略化して示した図。8人のユーザーが計9回アクセスしており、ハッシュ値の先頭2桁に基づいて4つのグループに振り分けられています。各グループの推定人数は1人、8人、4人、4人で、その調和平均である約2.46にグループ数の4を掛けると全体のユーザー数は約9.84人と推定されます。
フラジョレ氏らの論文によると、HyperLogLogの推定値の相対標準誤差は、グループ数の平方根で1.04を割った値にほぼ等しくなります。2048個のグループを用意し、それぞれの記録を5bitで保存する構成では、10億を超える異なるデータの個数を約1.3KBのメモリで、約2%の標準誤差で推定できるとのこと。グループ数を増やせば、標準誤差を1%未満に抑えることも可能です。
2013年にはGoogleの研究チームがHyperLogLogの改良版となる「HyperLogLog++」を発表し、メモリ使用量の削減や推定精度の向上を実現しました。HyperLogLog++はGoogle Analyticsでユーザー数などの推定に利用されているとのこと。
HyperLogLog in Practice: Algorithmic Engineering of a State of The Art Cardinality Estimation Algorithm
https://research.google/pubs/hyperloglog-in-practice-algorithmic-engineering-of-a-state-of-the-art-cardinality-estimation-algorithm/
HyperLogLogの用途はウェブサイトのアクセス解析にとどまりません。サイバーセキュリティの分野ではボットによる異常なアクセスの検出に、生物学の分野ではゲノム間の類似性の調査に利用されるなど、膨大なデータの中から重複を除いた要素の数を知りたい場面で活用されているそうです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.