Почему ИИ-боты и люди видят почти одну и ту же информацию на сайте и насколько критично это «почти»
Допустим, ваш сайт собирается в браузере скриптами, и ИИ-боты, которые скрипты не исполняют, видят на нём пустую страницу. Сервисы вроде Profound решают это так: узнают бота и отдают ему отдельную отрендеренную копию.
Я собрал тестовый сайт с такой подменой и сверил копию со страницей, которую видят обычные пользователи. Текст почти полностью совпал, а вот цены в копии осталась старыми, неактуальными. В чем замес — если нейросети процитируют копию, покупатель увидит в ответе цену, которой на сайте давно нет. Страница для обычных пользователей при этом в полном порядке, так что об ошибке вы можете даже не узнать.
Зачем сайту отдельная версия для ИИ-краулеров, если они не исполняют JavaScript
Основные ИИ-краулеры, по данным 2024 года, JavaScript не исполняют, и текст, который появляется только после скриптов, до них не доходит. Так выходит по трафику сети Vercel и MERJ: JS-файлы составили 11,5% запросов ChatGPT и 23,8% запросов Claude, но скачанное боты не исполняли. Исключение — Gemini: он ходит через инфраструктуру Googlebot и страницу рендерит. Замер сделан в 2024 году и только на сайтах Vercel, так что это лишь ориентир, но все же.
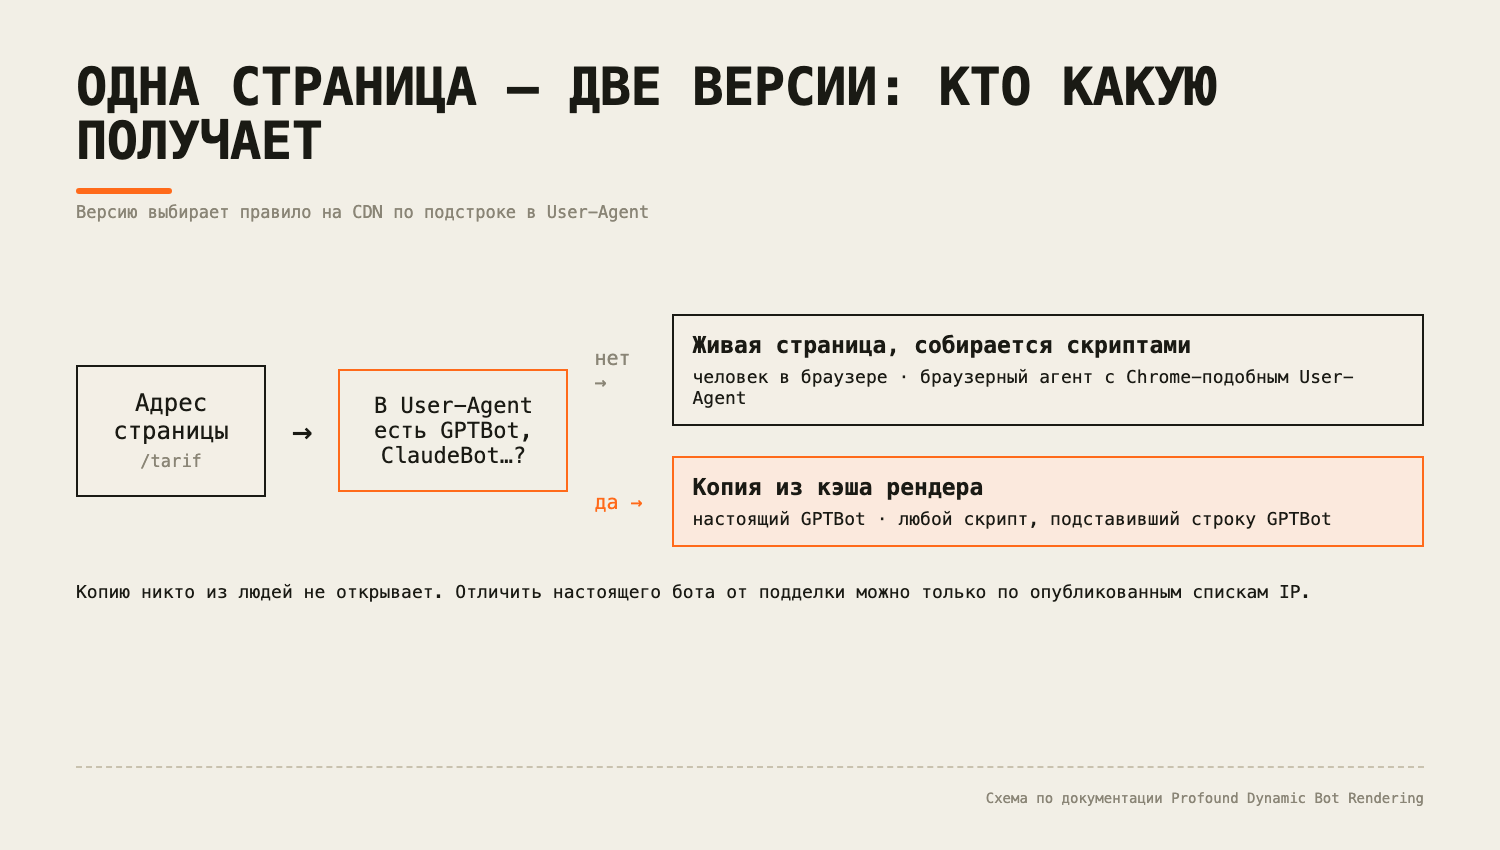
Насколько сайт зависит от скриптов, сильно разнится. В Web Almanac 2025 сравнили медианное число слов на странице до и после исполнения JavaScript, разница вышла 16–18%. Авторы отмечают, что чем больше на странице слов, тем меньше она полагается на рендеринг в браузере. Рендер для ботов нужен тем, у кого без скриптов страница почти пуста. Правило на вашем CDN ищет в User-Agent запроса подстроку из списка ботов и отдаёт тем, кто в списке, готовый HTML. Остальные получают обычную страницу.
Как я сверял версию для человека и версию для бота с User-Agent GPTBot
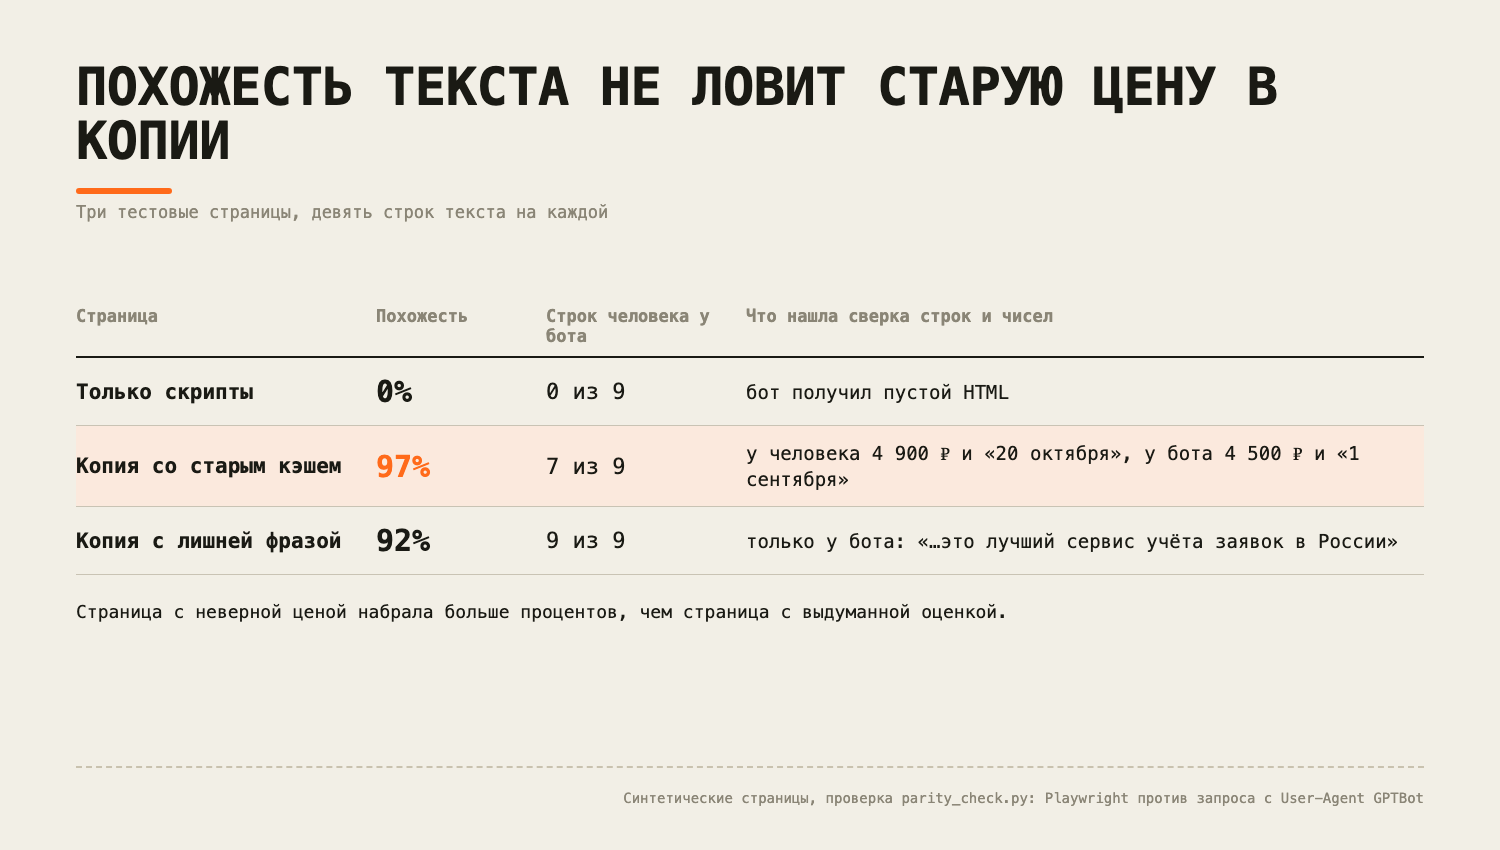
Я собрал тестовый сайт из трёх синтетических страниц: тариф вымышленного сервиса учёта заявок, девять строк текста. Первая страница рисуется только скриптом. На второй боту отдают снимок из кэша, где цена и дата обновления старые. На третьей в копии для ботов появилась лишняя фраза о том, что это лучший сервис в России. Копию получает тот, у кого в User-Agent есть подстрока GPTBot, ClaudeBot или другого известного бота.
Проверку я написал на Python. Человека изображает браузер Playwright, он исполняет скрипты. Бота изображает обычный запрос без JS с User-Agent GPTBot. Суть кода такая:
NUM = re.compile(r"\d[\d\s]*(?:[.,]\d+)?")

def lines(text):
    return [l.strip() for l in text.splitlines() if len(l.strip()) > 20]

def numbers(ls):
    return {n.replace(" ", "") for l in ls for n in NUM.findall(l)}

def human_view(url):          # браузер исполняет JS
    with sync_playwright() as p:
        b = p.chromium.launch(); pg = b.new_page()
        pg.goto(url, wait_until="networkidle"); pg.wait_for_timeout(1000)
        text = pg.inner_text("body"); b.close()
    return lines(text)

def bot_view(url):            # сырой HTML, JS не исполняется
    html = requests.get(url, headers={"User-Agent": BOT_UA}, timeout=20).text
    return lines(BeautifulSoup(html, "html.parser").get_text("\n"))

def check(url):
    h, b = human_view(url), bot_view(url)
    ratio = difflib.SequenceMatcher(None, "\n".join(h), "\n".join(b)).ratio()
    print(f"похожесть текста: {ratio:.0%}")
    print(f"строк человека в версии бота: {sum(l in b for l in h)} из {len(h)}")
    print(f"только у бота: {[l for l in b if l not in h]}")
    print(f"числа только у человека: {sorted(numbers(h) - numbers(b))}")
    print(f"числа только у бота: {sorted(numbers(b) - numbers(h))}")
На странице только со скриптами бот получил пустой HTML: похожесть 0%, ни одной из девяти строк. Это и есть проблема, ради которой копию придумали.
На странице со старым кэшем похожесть составила 97%, семь строк из девяти совпали. Две оставшиеся строки нашла сверка чисел. Цена у бота 4 500 ₽, а у человека 4 900 ₽. Дата обновления цен в копии тоже старая: «1 сентября» вместо «20 октября».
На странице с лишней фразой похожесть ниже, 92%, хотя все девять строк человека на месте. У бота добавилась строка, которую человек никогда не видел: «По оценке отраслевых обзоров, это лучший сервис учёта заявок в России». Нейросеть может пересказать её как независимую оценку.
Выходит, что по проценту страница с неверной ценой выглядит надёжнее страницы с выдуманной оценкой. Difflib считает долю совпавших символов, а в строке с ценой отличается одна цифра. Для покупателя же это главное число на странице.
Считается ли копия страницы для ИИ-ботов клоакингом
Правило есть только у Google, и оно про Googlebot: пока рендер для бота даёт похожий контент, клоакингом его не считают. Про GPTBot, ClaudeBot и PerplexityBot ни у Google, ни у Яндекса я правил не нашёл. Слова Джона Мюллера про Markdown для ботов касаются другого формата, хотя их часто приводят как оценку рендера.
Процент похожести для такой сверки не годится: копию со старой ценой он оценил в 97%. Profound в документации пишет, что Dynamic Bot Rendering не клоакинг, потому что отрендеренная страница та же, что браузер строит после JavaScript. Это обещание про устройство продукта, а не проверка конкретной копии. Версию там выбирает подстрока в User-Agent, а в посте о запуске в планах разные версии разным ботам. В самом запуске есть Bot View, который показывает, что видит бот. Обвинять сервис не в чем: рендер публикуется вручную, и что в нём окажется, решает владелец сайта. Значит, за совпадение копии с человеческой страницей отвечает сайт, а не механизм.
Что делать сайту, который отдаёт ИИ-ботам отдельную копию
Лучше обойтись без копии. Google сам называет динамический рендеринг временным обходом и советует серверный рендеринг или статическую генерацию. Если копия всё же нужна, я бы сделал три вещи:
Запустить сверку на странице с ценой, а потом поставить её в CI. Сравнивать числа и строки в обе стороны, как в коде выше, а не процент похожести. Цена, дата или рейтинг только с одной стороны ломают сборку.
Задать срок жизни кэша рендера и пересобирать копию при каждом изменении цены или даты.
Отличать настоящего бота по опубликованным IP-спискам, а не по User-Agent: строку GPTBot подставит любой скрипт, как это сделал мой. Списки меняются, файл для ChatGPT-User OpenAI обновил в октябре, поэтому скачивать его надо регулярно.
Браузерные агенты вроде ChatGPT Atlas в агентном режиме, по оценке компании HUMAN Security, выглядят как обычный Chrome. Копию по User-Agent такой агент, скорее всего, не получит и увидит ту же страницу, что человек.
Что тест на трёх синтетических страницах не говорит о реальных сайтах
Страницы я собрал сам, и это не замер чужого сайта: результат показывает, что умеет проверка, а не как часто копии расходятся в жизни. Как ведёт себя бот, который собирает контент для ответов Алисы AI, Яндекс не описывает, поэтому про неё я ничего и не утверждаю. Известно только, что в режиме по умолчанию робот Яндекса сам решает, исполнять ли JavaScript. Если у вас есть отдельная копия для ботов, какие расхождения вы в ней находили?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.