« Une étape majeure dans l'histoire de la science » : un chercheur affirme avoir percé le secret des IA

Depuis des années, les chercheurs tentent de comprendre comment fonctionnent les modèles d'intelligence artificielle générative. Ils sont souvent décrits comme des boîtes noires. Il est impossible de savoir ce qui se passe à l'intérieur. On peut déduire certaines règles de fonctionnement en analysant les entrées et les sorties, autrement dit les requêtes et les réponses. Toutefois, il est aussi possible d'analyser les neurones individuels.
Les modèles sont des réseaux de neurones artificiels qui reposent sur différentes architectures : réseaux antagonistes génératifs (GAN), réseaux de neurones récurrents (RNN), transformeurs, réseaux de neurones convolutifs (CNN), etc. Ces neurones ne sont pas des éléments physiques, mais des fonctions mathématiques. Toutefois, jusqu'à présent, leur rôle exact au sein du réseau neuronal est resté assez mystérieux.
Le problème des neurones polysémiques
Dans un long article d'environ 26 000 mots, Nick Cammarata de la startup Goodfire AI et ancien employé chez OpenAI, explique comment il a réussi à comprendre le fonctionnement de ces neurones, ce qui permettrait d'étudier et de mieux comprendre les grands modèles de langage.
Les agents d’intelligence artificielle sont au cœur du développement des nouveaux modèles. De plus en plus autonomes, ils sont désormais capables de planifier et d’exécuter des tâches complexes pour atteindre un objectif. Mais cette autonomie croissante soulève une question essentielle : comment s’assurer qu’une IA fait bien ce qu’on lui demande, et rien d’autre ?... Lire la suite
Le problème que rencontrent les chercheurs est que ces neurones s'activent souvent pour deux concepts a priori sans rapport. L'exemple donné par Nick Cammarata est celui du chat et de la voiture. Pour expliquer pourquoi les mêmes neurones peuvent s'activer pour ces deux concepts, les chercheurs utilisent la superposition. Lorsque le réseau neuronal est à court de neurones, il commencerait à regrouper des éléments sans rapport pour créer des neurones polysémiques. Les concepts seraient suffisamment éloignés pour ne pas interférer, permettant le double emploi des neurones.
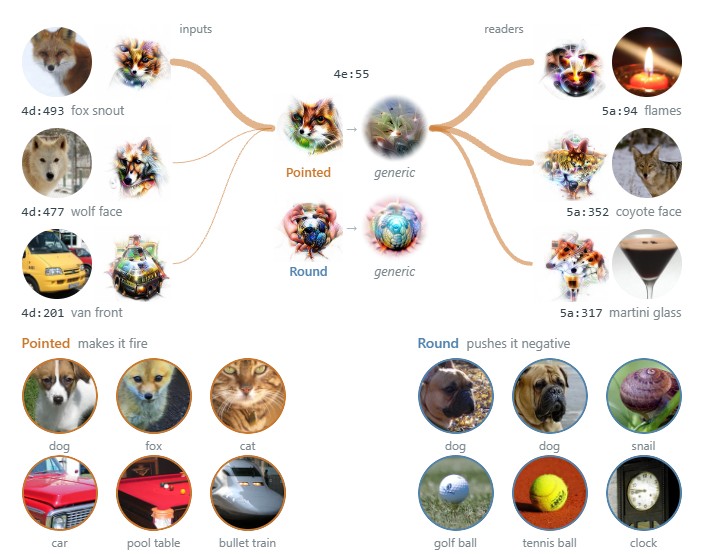 Les images avec des éléments en V activent un neurone artificiel. © Goodfire AI
La génération récursive, plutôt que la superposition ?
On obtient ainsi des nœuds emmêlés, dont l'activation ne permet pas une interprétation. Selon l'auteur, l'explication réelle serait toute autre. La voiture et le chat auraient bien quelque chose en commun. Le visage d'un chat et l'avant d'une voiture contiendraient tous les deux une forme en V. Ce serait ce concept qui s'activerait. Pour preuve, ce neurone ne s'activerait pas pour des choses rondes, comme une balle ou un escargot. Il a baptisé ce fonctionnement « généralisation récursive ».
Les médias se font caisse de résonance sur le danger imminent d’une fin possible de l’humanité causée par les IA. En plus des interviews alarmistes d’un ancien employé d’Anthropic, Goeffrey Hinton, surnommé « le père de l’IA », enfonce le clou avec des propos similaires.... Lire la suite
Une telle avancée permettrait peut-être de résoudre le problème de l'alignement des IA. En parvenant à mieux les comprendre, nous pourrions découvrir pourquoi leur comportement diffère de celui attendu, et trouver comment mieux contraindre les modèles.
« Nous pouvons désormais comprendre la plupart des neurones dans des modèles atteignant plusieurs milliers de milliards de paramètres, et nous pensons que les perspectives de l'interprétabilité mécaniste pourraient être bien meilleures que prévu », résume Nick Cammarata.
Des réactions mitigées
Cette publication a fait couler beaucoup d'encre chez les spécialistes de l'intelligence artificielle. Sam Altman, le président d'OpenAI, a notamment affiché son enthousiasme, tandis que Tarun Gogineni, employé chez OpenAI, a qualifié le texte d'« étape majeure dans l'histoire de la science ». Toutefois, les critiques sont aussi nombreuses. Certains soulignent notamment que même si le phénomène de la généralisation récursive existe, il n'exclut pas la superposition.
— Neel Nanda (@NeelNanda5) October 15, 2026This is interesting work, but I don't think it's a significant update to the big picture of interpretability.
I'm on board with the broad idea of doing exploratory interpretability with neurons, e.g. neuron-based attribution graphs, for pragmatic problems like why did a model do… https://t.co/r9IpQuF1FY
« C'est un travail intéressant, mais je ne pense pas que cela change fondamentalement la donne », a déclaré Neel Nanda, de Google DeepMind. Même en connaissant le fonctionnement de chaque neurone, tenter de prévoir le fonctionnement du réseau complet reviendrait à tenter de prévoir la météo à partir du fonctionnement des atomes.
De plus, il s'agit pour l'instant de résultats qui n'ont pas été évalués par d'autres chercheurs. Néanmoins, étant donné que cette approche pourrait avoir des conséquences importantes pour la sécurité de l'IA, elle sera très certainement examinée à la loupe par de nombreux spécialistes. Affaire à suivre, donc.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.