Заметки с PGConf.EU 2026
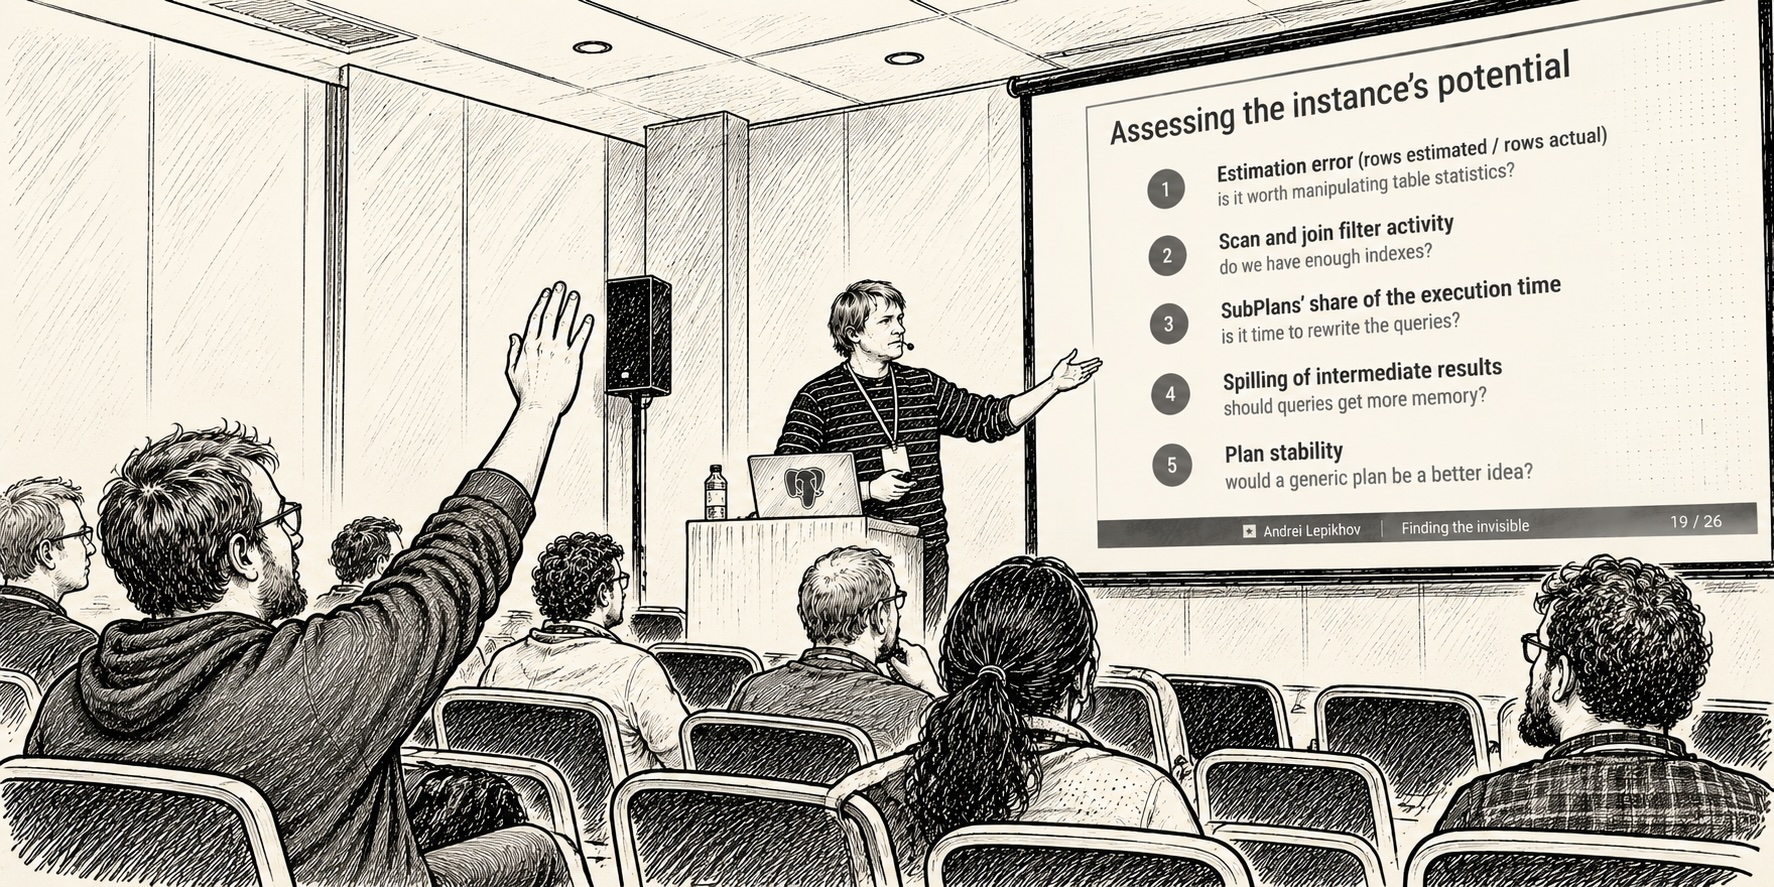
PGConf.EU 2026 в Валенсии стала моей первой постгресовой конференцией. Ощущение любопытное: ты вроде бы никого не знаешь, даже просто по лицам, но, вглядываясь в имена на бейджах, понимаешь, что со многими участниками у тебя есть общие темы и застарелые, так и не решённые вопросы. Чёртова удалёнка!
Дни выдались насыщенными, и несколько технических вопросов для меня прояснились. Зафиксирую здесь самое важное — это может пригодиться и другим разработчикам, которым интересно развитие проекта.
Что говорили со сцены
Начну с выступлений. Каждая презентация — это визитная карточка, декларация текущих интересов её автора. Так что прежде чем подходить с вопросами, стоит сначала посмотреть выступление. Здесь — то, куда я успел попасть.
Robert Treat, REPACK in Core. Похоже, у нас есть два полярных подхода к дефрагментации таблицы: оппортунистическая очистка отдельной страницы и VACUUM FULL / REPACK всей таблицы (и её индексов) целиком. После такой постановки напрашивается следующий шаг — дефрагментация сегмента из двух и более смежных страниц: сдвигать кортежи ближе к началу таблицы, чтобы со временем отрезать пустой хвост. Это может быть важно, поскольку некоторые интенсивно используемые таблицы просто так не перепакуешь.
Bertrand Drouvot, Per-Backend Statistics: See What Every Connection Is Actually Doing. Доклад подтолкнул к идее. Для обычного бэкенда статистика естественным образом привязана к PID. А что делать с background worker’ами? Возьмём воркер логической репликации: он может легитимно периодически перезапускаться и продолжать работу — то есть наследует контекст предыдущего процесса. Логично было бы дать части статистики продолжать накапливаться и после рестарта. Это дало бы нам интересные возможности, как минимум — считать число перезапусков воркера.
Heikki Linnakangas, Signals, Latches, and Interrupts. Судя по всему, сообщество заинтересовано переписать подсистему прерываний и позволить расширениям регистрировать собственные обработчики. Это открывает массу сценариев: например, сигналить модулю, чтобы он обновил приватный кэш без лишней shared memory, или прервать выполнение запроса, чтобы проанализировать его состояние на полпути.
Robert Haas, pg_plan_advice: Plan Stability and User Planner Control for PostgreSQL. После его рассказа мне стало более-менее понятно, почему он так активно двигает эту тему. Его мотив — отладка и исследование запросов. Поэтому он спокойно отнёсся к вопросам о привносимых рисках (use-after-free, для примера) и об ограничениях для разработчиков сторонних расширений. В его мире это расширение (пока) не для прода — отсюда и лёгкое отношение.
Melanie Plageman, Exercising PostgreSQL Performance Enhancing Patches. Доклад о том, как патчи пишутся и тестируются — в каком-то смысле о стадиях их развития. Полагаю, она делала этот обзор скорее для себя, чтобы отрефлексировать процесс разработки. Опытному контрибьютору должно быть достаточно скучно. Однако один тезис меня триггернул: по её словам, сообщество редко коммитит патчи с регрессией. Любопытно было бы найти хоть одну значительную фичу, которая не принесла с собой ни одного кейса с деградацией производительности.
Daniel Gustafsson, The current state of JIT in PostgreSQL. Прошлое, настоящее и будущее JIT — достаточно честно и самокритично, на мой вкус. Главное, что сообщество понимает, где JIT даёт реальную выгоду: generic-планы и вычисление агрегатов. Он же сейчас активно работает над относительной адресацией, без которой переиспользование скомпилированного кода не заработает. Дело за ресурсами: если в сообществе есть специалисты по этой теме, сейчас самое время ему помочь.
Thomas Munro, Where next for parallel query execution? Автор обстоятельно разобрал слабые места параллельной обработки запросов. Посмотрел он действительно глубоко, хотя и не пытался критиковать сами основы текущего подхода. Параллелизм для временных таблиц он не затрагивал — хотя такие технологии уже больше года стоят на службе в 1С-версиях PostgreSQL, см. здесь и здесь.
Rafia Sabih, Unlocking Parallel Query in postgres_fdw. Вполне рядовой проект, но важно другое: в сообществе понимают ограничение postgres_fdw, запрещающее параллелизм на удалённой стороне запроса, реальное решение имеется и развивается. А наблюдаемые регрессии можно попробовать закрыть традиционным cost-based подходом.
Что говорили в кулуарах
Hallway track оказался не менее полезным, чем основная программа.
Умные указатели для путей оптимизатора. Это про то, чтобы детектировать paths, на которые есть ссылки из какого-нибудь варианта дерева плана запроса. Один из разработчиков планировщика подтвердил, что сообщество считает эту задачу важной. Выигрыш тройной: экономия памяти (пути, на которые никто не ссылается, можно освобождать, как только верхний RelOptInfo закончил строить свои пути), закрытие потенциальных UAF-багов и дорога к более сложным оптимизациям, которые затрагивают сразу несколько уровней плана. Времени на это у него сейчас нет, но поддержать чужие усилия он готов. Главная проблема в этом проекте — сложность. Возможно, есть путь проще: например, счётчик, который никогда не декрементируется. Тогда поле счётчика не нужно вовсе — достаточно при первом обращении скопировать путь в выделенный контекст памяти. В общем, тема важная и пространство для творчества большое.
Bloom-фильтры в планировщике. Один из коммитеров считает, что нужно развивать path-based подход: он обещает лучшее качество при выборе дерева джойнов. Главный тормоз для «оппортунистического» варианта — EXPLAIN начинает показывать вводящие в заблуждение числа, и оценка стоимости выглядит некорректной. Этот вариант стоит обсудить подробнее на конкретных примерах. На мой вкус — непрактичное решение, но кто сказал, что OSS — это про клиентоориентированность?
Параллелизм для временных таблиц. Сообщество не против рассматривать проекты, открывающие путь включать временные таблицы в параллельные планы запросов. Там с интересом изучат и попытки распараллелить INSERT INTO … SELECT и аналогичные конструкции, проблема назрела.
Ещё одно наблюдение: сразу несколько компаний создают сервисы для автоматизированной оптимизации PostgreSQL под конкретную нагрузку. Это замечательно, поскольку говорит о наличии спроса. Пользователи чувствуют, что одного горизонтального или вертикального масштабирования мало, и смотрят в более разумную сторону: эффективно использовать то, что уже есть. Это особенно отрадно моему сердцу.
Недосказанное
Естественно, за такое короткое время сложно было успеть всё. Поэтому осталось и необсуждённое. Зафиксирую — вдруг кто-то из докладчиков прочитает и ответит?
Сюжет первый — развитие подсистемы ввода-вывода. Peter Geoghegan, «An Overview of Index Prefetching», Tomas Vondra, «AIO performance — now and in the future» — выступления, которые с точки зрения оптимизатора про одно и то же: executor научился читать диск умнее, а оценка стоимости об этом не знает. По первой теме естественно поднять вопрос, имеет ли вообще смысл GUC random_page_cost для индексного скана с префетчем, или нам нужен отдельный параметр, а то и совсем другая модель — не «страница стоит X», а «очередь глубины N стоит Y». По второй — что делать с effective_io_concurrency, если AIO выбирает глубину сам: оставить как подсказку планировщику или убрать из кост-модели вовсе.
Сюжет второй — управление планом снаружи. Robert Haas с pg_plan_advice, Lukas Fittl с «The Future of Plan Management and Feedback Loops». Вопрос по advice об устаревании: если уж мы умеем рекомендовать хинт для улучшения плана, то было бы неплохо придумать обратное: как рекомендовать удаление хинта. Иначе, если совет зафиксировал порядок джойнов, а статистика через полгода уехала, кто это заметит — расширение, пользователь или никто? Fittl’у вопрос более общий: а не пора ли замахнуться на что-то покрупнее и перейти к feedback loop из мониторинга в планировщик — IBM показала его в DB2 ещё в 2001-м, а Microsoft довела до продакшена в SQL Server 2017 (см. здесь и здесь). Что изменилось технически, кроме появления pg_plan_advice как точки входа?
Направления развития
Что витало в воздухе? Куда направлены основные интересы? Вещь сугубо субъективная, я отметил для себя следующее:
Попытки сделать ядро СУБД эластичным — shared buffers, хранилище, конфигурация. Раньше это были больше разговоры и прототипы, сейчас, как говорят разработчики, это то направление, куда работодатели реально требуют двигаться.
Оптимизация стека ввода/вывода — в основном это про префетчинг и асинхронность.
Разделение хранения и вычислений и развитие сразу нескольких вариантов хранения данных: Google, Microsoft и Databricks — жаль, что это были спонсорские выступления, где глубоко в технику не уходят, но выглядит как что-то, сильно различающееся по существу. Впрочем, разделение физической и логической структуры БД — это одна из сильнейших сторон реляционных СУБД, не так ли?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.