1С через OData: от первого запроса до корпоративной интеграции – гайд для архитекторов и разработчиков
В крупной компании учетная система редко работает в одиночку. Она обменивается сведениями с CRM-, ERP-, ECM- и BPM-системами, интернет-магазином, мобильными приложениями, BI и внешними сервисами. Поэтому заказчики регулярно задают нам вопрос, можно ли связать ее с остальным ландшафтом быстро и без доработки конфигурации.
Можно. Проще всего начать со стандартного протокола. OData – это автоматически формируемый REST-интерфейс платформы: платформа сама публикует объекты базы по HTTP, а внешнее приложение читает, фильтрует, сортирует, переходит по связям и изменяет записи без собственного API.
Ниже разберем подключение 1С через OData: публикацию, первые обращения, параметры выборки, запись, нагрузку, синхронизацию, ошибки и защиту. Текст пригодится архитекторам, аналитикам и разработчикам интеграций.
Отдельно покажем, когда прямых вызовов уже не хватает. В этот момент появляется корпоративная интеграционная платформа: она принимает протокол как один из каналов и централизованно управляет маршрутизацией, преобразованием сообщений, мониторингом и контролем обмена.
Как устроен OData в 1С
OData (Open Data Protocol) – это открытый стандарт работы с данными по HTTP: GET читает, POST создает, PATCH и PUT изменяют, DELETE удаляет. Работа 1С через протокол OData поддерживается с версии 8.3.5 и опирается на третью редакцию спецификации с собственными расширениями и ограничениями.
Протокол появился в Microsoft в 2007 году – единый способ получать и изменять данные по HTTP вместо закрытых форматов каждого поставщика. Позже его передали консорциуму OASIS: версия 4.0 стала открытым стандартом в 2014 году, а в 2016-м – международным стандартом ISO/IEC 20802. Учтите разницу версий: примеры для 4.0 из сторонних руководств в учетной базе работают не всегда.
После публикации каждый объект метаданных становится набором сущностей: справочник превращается в коллекцию, его элемент – в запись. Отсюда и название «автоматический REST-интерфейс 1С»: писать код в конфигурации не нужно. Через интерфейс доступны:
справочники, документы и журналы документов;
константы, планы счетов, видов характеристик, видов расчета и планы обмена;
регистры сведений, накопления, бухгалтерии и расчета;
бизнес-процессы и задачи.
Отчеты, регламентные задания и журнал регистрации не публикуются. Адрес строится по шаблону, где префикс задает вид объекта:
https://сервер/имя-публикации/odata/standard.odata/Catalog_Номенклатура
Дальше начало адреса сокращаем до «…/». Так выглядят адреса основных видов объектов:
…/Catalog_Контрагенты # справочник целиком …/Catalog_Контрагенты(guid'1f3b9a40-…') # одна запись по ключу …/Document_ЗаказПокупателя # документы …/Document_ЗаказПокупателя_Товары # строки табличной части …/InformationRegister_КурсыВалют # регистр сведений …/AccumulationRegister_ТоварыНаСкладах # регистр накопления …/Constant_ОсновнаяВалюта # константа …/$metadata # описание всей модели
Обращение к …/$metadata возвращает машиночитаемое описание: типы сущностей, поля, их типы, ключи и связи. Интерфейс описывает себя сам, и проектирование стоит начинать именно с этой модели. Фрагмент описания справочника выглядит так:
<EntityType Name="Catalog_Контрагенты"> <Key><PropertyRef Name="Ref_Key"/></Key> <Property Name="Ref_Key" Type="Edm.Guid" Nullable="false"/> <Property Name="DataVersion" Type="Edm.String"/> <Property Name="DeletionMark" Type="Edm.Boolean"/> <Property Name="Description" Type="Edm.String"/> <Property Name="ИНН" Type="Edm.String"/> <Property Name="ОсновнойДоговор_Key" Type="Edm.Guid"/> <NavigationProperty Name="ОсновнойДоговор" Relationship="StandardODATA.Catalog_Контрагенты_ОсновнойДоговор" FromRole="Begin" ToRole="End"/> </EntityType>
Структура зависит от конфигурации и ее версии. Набор реквизитов одного типового справочника различается от инсталляции к инсталляции, поэтому маппинг, составленный по одной базе, не переносят на другую без сверки с $metadata.
Мы советуем сначала сверить $metadata, а затем составлять маппинг и контракты сообщений по этой модели, а не по экранным формам конфигурации.
Для проектирования полезно знать и типы данных. Строка приходит как Edm.String, дата – как Edm.DateTime, ссылка – как Edm.Guid, перечисление – как строка. У реквизита составного типа появляется парное поле с суффиксом _Type, где указан фактический тип значения.
Публикуем базу и выполняем первый запрос
Начитать нужно с веб-сервера (Apache или IIS) с модулем расширения платформы. Если доступ нужен за пределами периметра, понадобится еще и сертификат для HTTPS.
В конфигураторе откройте «Администрирование → Публикация на веб-сервере», задайте имя латиницей и отметьте «Публиковать стандартный интерфейс OData». Без прав администратора ОС файл default.vrd сохраняют и передают тому, у кого эти права есть. Включенный интерфейс выглядит в нем одной строкой:
<point xmlns="http://v8.1c.ru/8.2/virtual-resource-system" base="/trade" ib="Srvr="srv-app";Ref="trade";"> <standardOdata enable="true"/> </point>
Состав объектов задают методом «УстановитьСоставСтандартногоИнтерфейсаOData», а в конфигурациях на БСП – формой настроек в разделе «Синхронизация данных». Там же создают служебного пользователя с ролью «УдаленныйДоступOData». Код на встроенном языке выполняют один раз с правами администратора:
Состав = Новый Массив; Состав.Добавить(Метаданные.Справочники.Контрагенты); Состав.Добавить(Метаданные.Справочники.Номенклатура); Состав.Добавить(Метаданные.Документы.ЗаказПокупателя); УстановитьСоставСтандартногоИнтерфейсаOData(Состав);
Включайте только объекты, которые участвуют в обмене. Планы обмена открывать не стоит: их некорректное изменение извне нарушает работу базы.
Если все настроено верно, корневой адрес …/ возвращает список опубликованных сущностей. По умолчанию ответ приходит в XML (Atom), а параметр $format=json переключает его на JSON. Первое обращение к справочнику выглядит так:
GET …/Catalog_ФизическиеЛица?$format=json&$top=1 Authorization: Basic <логин:пароль в Base64> Accept: application/json
Ответ:
{ "value": [ { "Ref_Key": "baebacee-b80e-11e4-826f-001e101fe696", "DataVersion": "AAAAAAAAAAA=", "DeletionMark": false, "Parent_Key": "00000000-0000-0000-0000-000000000000", "IsFolder": false, "Code": "ФР-0000002", "Description": "Абнагимова Ирина Витальевна", "ДатаРождения": "1947-08-05T00:00:00", "Пол": "Женский", "Predefined": false } ] }
Ref_Key – это GUID объекта и ключ для всех последующих обращений. DataVersion меняется при каждой записи, DeletionMark показывает пометку удаления, Code и Description хранят код и наименование. Пустой GUID из одних нулей означает незаполненную ссылку.
GET проверяют прямо в браузере, а POST, PATCH и DELETE – в любом HTTP-клиенте. Тот же запрос из командной строки:
curl -u 'svc_odata:пароль' -H 'Accept: application/json' \ 'https://сервер/trade/odata/standard.odata/Catalog_ФизическиеЛица?$format=json&$top=1'
Размер выборки удобно узнать заранее: адрес …/Catalog_ФизическиеЛица/$count возвращает только число записей, а параметр $inlinecount=allpages добавляет это число к ответу. Так потребитель планирует число страниц до начала чтения.
1С-коннектор и чтение данных: фильтры, сортировка, пагинация
Пока к базе обращается одна служба, параметры можно собирать вручную. Когда потребителей и маршрутов становится много, мы рекомендуем выносить подключение в отдельный компонент. 1С-коннектор – это сервис между учетной базой и интеграционным слоем: он хранит адрес публикации, проходит авторизацию, собирает адрес с параметрами, кодирует значения и передает результат дальше.
В Digital Q.Integration коннектор данных 1С работает асинхронно поверх брокера. Задание с методом GetObjectData или SetObjectData, типом объекта и условиями отбора уходит в топик q1cconnector-start-command, а ответ приходит в reply-топик. Заголовок CorrelationId связывает задание с результатом, поля errorCode и errorMessage дают предсказуемую ветку обработки сбоев, а реквизиты доступа живут в настройках коннектора. Для централизованного учета бизнес-сообщений и управления их обменом в экосистеме есть дополнительные средства.
Задание коннектору собирается из нескольких частей:
Топик: q1cconnector-start-command Заголовки: метод → GetObjectData CorrelationId → идентификатор для связи с ответом префикс → имя «своего» ответного топика Тело: категория → Catalog объект → Валюты отбор, поля, сортировка, порция, уровень раскрытия связей Ответ: <префикс>…-reply: данные в Base64, errorCode, errorMessage
Префикс нужен, когда с коннектором работают несколько потребителей: каждый получает ответы в свой топик. Данные в ответе закодированы в Base64, потому что JSON вложен в JSON-сообщения, и маршрут декодирует их «первым шагом».
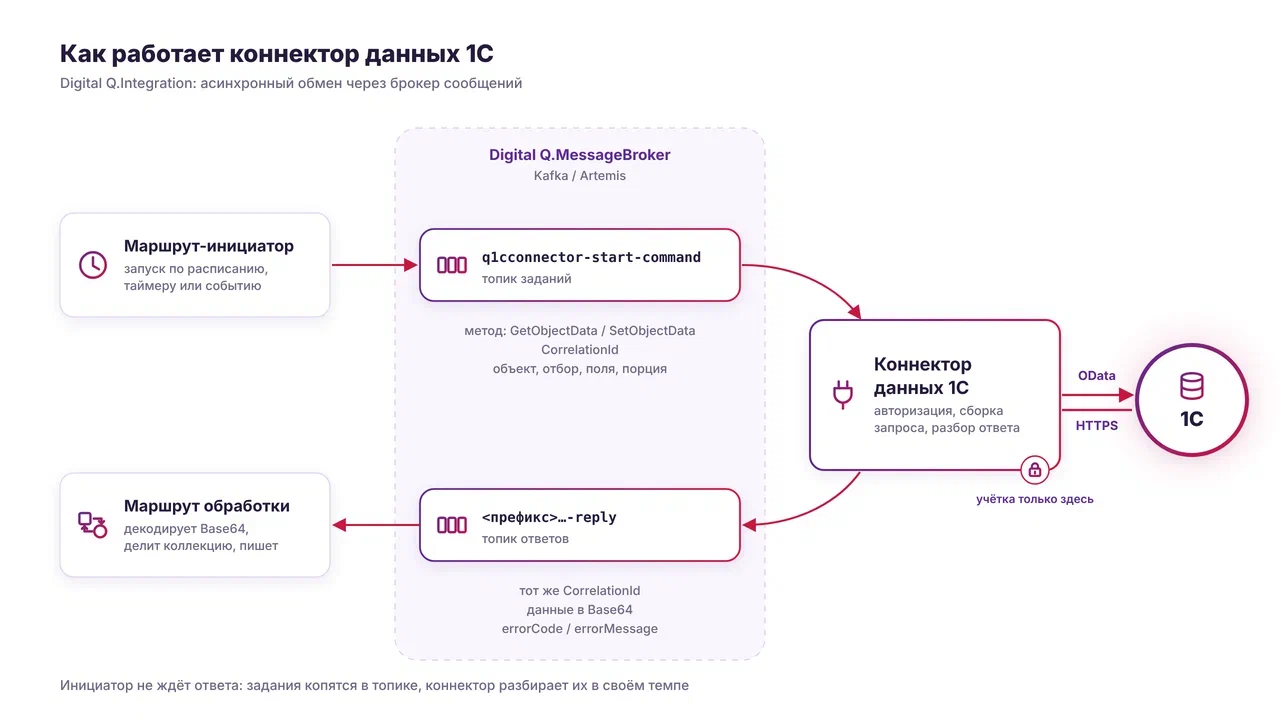
Помимо чтения и записи, коннектор отдает встроенную справку по методам, список опубликованных сущностей и подробные метаданные объекта. Разработчику не нужно разбираться в синтаксисе протокола: параметры выборки задаются отдельными полями, а адрес запроса коннектор собирает сам.
Теперь - примеры запросов на чтение. Каждый параметр отвечает за свою часть выборки:
…/Catalog_ФизическиеЛица?$select=Description,ДатаРождения # только нужные поля …/Document_ЗаказПокупателя?$filter=Date ge datetime'2026-01-01T00:00:00' and Posted eq true …/Catalog_Номенклатура?$orderby=Code asc # сортировка …/Catalog_Номенклатура?$orderby=Code&$top=500&$skip=1000 # третья страница по 500
Обычно запрос сочетает сразу несколько параметров. Например, первые 100 юрлиц с наименованием и ИНН, по алфавиту:
GET …/Catalog_Контрагенты?$format=json &$select=Ref_Key,Description,ИНН &$filter=ЮрФизЛицо eq 'ЮрЛицо' and DeletionMark eq false &$orderby=Description &$top=100
Перенос строк здесь – только для читаемости, в реальном адресе параметры идут подряд. Строки пишутся в апострофах, GUID как guid'…', даты как datetime'…'. $skip применяется раньше $top независимо от порядка в адресе, а страницы без $orderby получаются непредсказуемыми.
Через тот же интерфейс можно вызывать и методы регистров: SliceLast() – для периодических регистров, Balance() и Turnovers() – для остатков и оборотов. Параметры передаются в скобках:
…/InformationRegister_КурсыВалют/SliceLast(Period=datetime'2026-10-01T00:00:00')?$format=json …/AccumulationRegister_ТоварыНаСкладах/Balance(Period=datetime'2026-10-01T00:00:00', Dimensions='Номенклатура,Склад')?$format=json
В отборе доступны и функции: startswith, substringof и like для строк, year, month и dateadd для дат. Отбор по реквизитам вложенных объектов и составного типа выполняют функции cast и isof; обычное сравнение составного поля с GUID всегда вернет пустой результат.
Если на объектах настроены ограничения доступа на уровне записей, добавляйте allowedOnly=true. Иначе выборка, в которую попала закрытая запись, завершится ошибкой прав.
Работа со связанными объектами и табличными частями
Ссылочный реквизит приходит полем Контрагент_Key с GUID и навигационной ссылкой. Чтобы получить контрагента внутри заказа, используют $expand:
GET …/Document_ЗаказПокупателя?$format=json &$expand=Контрагент &$select=Number,Date,Контрагент/Description,Контрагент/ИНН &$top=100
$expand действует только для списков, одиночная запись потребует второго вызова. Каждая раскрытая связь утяжеляет SQL-запрос к СУБД, поэтому $expand всегда сочетают с $select.
GET …/Document_ЗаказПокупателя(guid'5d1e0c2a-…')/Контрагент?$format=json
Табличные части приходят массивом внутри документа, а отдельные строки читаются по адресу с суффиксом. Документы по содержимому строк отбирает лямбда-функция any:
# строки табличной части с количеством больше 10 …/Document_ЗаказПокупателя_Товары?$filter=Количество gt 10 # заказы, где хотя бы одна строка дороже 50 000 …/Document_ЗаказПокупателя?$filter=Товары/any(d: d/Цена gt 50000) # движения регистра от документов конкретного вида (составной тип) …/AccumulationRegister_ТоварыНаСкладах?$filter=Recorder eq cast(guid'5d1e0c2a-…', 'Document_ЗаказПокупателя')
Вспомните типичный клиент, который для каждого заказа отдельно дочитывает контрагента и номенклатуру: сотня заказов превращается в несколько сотен вызовов. Справочник, нужный многим записям, выгружают один раз и кэшируют у получателя, а пару полей связанного объекта раскрывают в том же обращении.
В коннекторе Digital Q для этого есть отдельный вариант чтения: в задании указывают, какие связи и на сколько уровней раскрыть, и получают объект со связанными сведениями за один шаг. Например, договор контрагента сразу с полями валюты взаиморасчетов, а не со ссылкой на нее.
Создание и изменение данных через REST-интерфейс
POST создает объект, PATCH меняет только переданные реквизиты, PUT требует полный набор свойств, DELETE удаляет. Ссылки передаются через поля с суффиксом _Key:
POST …/Document_ЗаказПокупателя?$format=json Content-Type: application/json Accept: application/json { "Date": "2026-10-20T10:00:00", "Контрагент_Key": "1f3b9a40-…", "Товары": [ { "LineNumber": "1", "Номенклатура_Key": "9c0a55e1-…", "Количество": 4, "Цена": 12400 } ] }
В ответ приходят код 201 и созданный объект с новым Ref_Key. Изменение одного реквизита выглядит так:
PATCH …/Document_ЗаказПокупателя(guid'5d1e0c2a-…')?$format=json Content-Type: application/json { "Комментарий": "Подтверждён в CRM" }
Проведение выполняется отдельным действием, отмена – методом Unpost(). Если прикладная логика откажет в проведении, вернется код 500, и причину проще воспроизвести интерактивно.
POST …/Document_ЗаказПокупателя(guid'5d1e0c2a-…')/Post() POST …/Document_ЗаказПокупателя(guid'5d1e0c2a-…')/Unpost()
При записи обработчики событий объекта и проверка прав срабатывают так же, как в штатной работе. Если платформа должна принять данные как при обмене, в обычной базе используют заголовок 1C_OData-DataLoadMode: true, но в сервисе 1cFresh он не поддерживается.
DELETE удаляет объект сразу, без пометки. Внешним системам безопаснее передавать PATCH с "DeletionMark": true, а физическое удаление оставить регламенту внутри базы.
PATCH …/Catalog_Контрагенты(guid'1f3b9a40-…')?$format=json Content-Type: application/json { "DeletionMark": true }
Табличная часть при PATCH передается целиком: строки, не попавшие в тело, исчезнут. Проверка заполнения, привычная по формам, при такой записи не выполняется, поэтому обязательность реквизитов проверяйте до отправки, а не в расчете на отказ базы.
При переносе между двумя базами не передавайте Ref_Key источника: приемник попытается найти у себя запись с чужим ключом. Поля с одинаковыми именами коннектор Digital Q сопоставляет автоматически, а сложный объект вроде договора с контрагентом и адресами раскладывает на части и записывает связанные сущности раньше основной.
Проверку перед отправкой лучше не доверять ни человеку, ни нейросети, если ее можно описать правилом: обязательные реквизиты, формат дат и полноту табличной части скрипт проверит за миллисекунды и одинаково при каждом прогоне. Если же положиться на отказ базы, ошибка всплывет кодом 500 в чужой системе, и разбор займет больше времени, чем сама проверка.
В конфигурациях на БСП запись иногда требует прав на вспомогательные объекты вне опубликованного состава. Их перечисляют в процедуре «ПриЗаполненииЗависимыхТаблицДляВыгрузкиЗагрузкиOData» и проверяют состав роли «УдаленныйДоступOData».
Что происходит при больших объемах данных
Каждое обращение платформа обрабатывает через веб-сервер, сеанс кластера и СУБД. Выборка на сотни тысяч записей формирует тяжелый SQL, держит сеанс минутами, упирается в тайм-ауты прокси и раздувает JSON до сотен мегабайт.
Поэтому выборку делят на страницы и подбирают размер порции на тестах, отталкиваясь от времени ответа. $select заметно сокращает трафик: карточка справочника несет десятки служебных полей. Фильтры по функциям, вложенным полям и раскрытым связям мешают СУБД использовать индексы. Если выгруженные данные нужно дополнительно подготовить к передаче, в экосистеме есть средства обработки данных.
Постраничное чтение с повторами при сбоях сети укладывается в короткий скрипт на Python:
import requests from requests.adapters import HTTPAdapter from urllib3.util.retry import Retry BASE = "https://сервер/trade/odata/standard.odata" # адрес публикации s = requests.Session() s.auth = ("svc_odata", get_secret("svc_odata")) # пароль из хранилища секретов s.headers["Accept"] = "application/json" # GET безопасно повторять: до трёх попыток при 502/503/504 с нарастающей паузой s.mount("https://", HTTPAdapter(max_retries=Retry( total=3, backoff_factor=2, status_forcelist=[502, 503, 504]))) def pages(entity, select, flt=None, size=500): skip = 0 while True: params = {"$format": "json", "$select": select, "$orderby": "Ref_Key", "$top": size, "$skip": skip} if flt: params["$filter"] = flt r = s.get(f"{BASE}/{entity}", params=params, timeout=120) r.raise_for_status() rows = r.json()["value"] if not rows: return yield rows skip += size for rows in pages("Catalog_Номенклатура", "Ref_Key,DataVersion,Code,Description"): save_to_target(rows)
Библиотека сама кодирует кириллицу в адресе, а размер порции задается одним параметром, и его удобно подбирать на нагрузочном тесте.
Обратная крайность тоже вредна: поток мелких вызовов по одной записи упирается в лимит одновременных сеансов раньше, чем в производительность базы. Реже и порциями, а не поминутно и поштучно.
Нагрузку оценивают вместе с сервером приложений: у файловой базы вызовы обслуживает веб-сервер, у клиент-серверной – узел кластера. Еще один частый предел связан с длиной адреса: кириллические имена реквизитов кодируются, и один символ развертывается в несколько, поэтому длинный отбор внезапно упирается в лимит. При нагрузочном тестировании мы проверяем:
время ответа по 95-му перцентилю;
число активных сеансов и их длительность;
долю ответов 5xx и тайм-аутов;
загрузку сервера кластера и СУБД;
объем ответа в мегабайтах.
В асинхронной схеме нагрузку сглаживает брокер: задания копятся в топике, и коннектор разбирает их в своем темпе. По словам команды разработки продукта, при построении корпоративного хранилища данных коннектор обработал миллионы таких заданий, а структуру таблиц хранилища собрали механически по метаданным учетной базы.
Регулярная синхронизация данных без полной выгрузки
Полная выгрузка каждые полчаса нагружает базу без пользы. Регулярный обмен строят на инкременте, который держится на шести элементах:
изменения после последнего обмена: отбор по дате изменения или по регистру, где конфигурация фиксирует правки;
checkpoint: отметка последнего обработанного момента хранится в интеграционном слое и сдвигается только после подтверждения записи в получателе;
повторы: после сбоя порция читается заново с перекрытием в несколько минут, чтобы не потерять записи на границе окна;
идемпотентность: получатель сверяет Ref_Key и DataVersion и не создает дубль при повторной доставке;
удаленные объекты: физически удаленная запись в выборку не попадет, поэтому удаление ведут через пометку или отдельный журнал;
периодическая сверка: регулярное сравнение количества записей и ключей между системами.
В коде инкремент для документов выглядит так (функция pages из предыдущего раздела):
from datetime import datetime, timedelta OVERLAP = timedelta(minutes=5) # перекрытие окна на случай сбоя started = datetime.now() since = checkpoint.load() - OVERLAP # отметка хранится в интеграционном слое flt = f"Date ge datetime'{since:%Y-%m-%dT%H:%M:%S}'" for rows in pages("Document_ЗаказПокупателя", "Ref_Key,DataVersion,Number,Date,DeletionMark", flt): for row in rows: if target.version_of(row["Ref_Key"]) == row["DataVersion"]: continue # эту версию уже записали: повтор без дубля if row["DeletionMark"]: target.mark_deleted(row["Ref_Key"]) else: target.upsert(row) # создать или обновить по Ref_Key checkpoint.save(started) # сдвигаем только после успешной записи
В отборе по дате есть слепая зона: в типовых справочниках такого поля обычно нет, а правки задним числом в окно не попадают. Там, где такое расхождение стоит денег, надежнее план обмена: регистрацию изменений ведет платформа, а пакет отдается повторно, пока приемник не подтвердит получение.
Еще одна ловушка – данные, которые меняются во время постраничного чтения: записи сдвигаются между страницами, и часть из них выпадает. Помогает сортировка по признаку изменения и запись через upsert: существующий объект обновляется, новый создается, повтор ничего не ломает.
Какие ошибки возникают при обмене данными и как их искать
Протокол отвечает HTTP-статусом и внутренним кодом: 4xx означает ошибку клиента, 5xx указывает на сервер или прикладную логику. Внутренний код и текст приходят в теле ответа:
HTTP/1.1 404 Not Found { "odata.error": { "code": "9", "message": { "lang": "ru", "value": "Не найден экземпляр сущности с ключом …" } } }
Чаще всего встречаются:
400 с кодами 1–6 или 14: синтаксис фильтра, неверный адрес, ошибка кодировки кириллицы;
401 или 403 с кодом 20: нет прав на объект, или в выборку попала закрытая запись;
404 с кодом 9: экземпляр по ключу не найден, или объект не входит в состав публикации;
500: исключение в обработчике либо отказ проведения, причину ищут в журнале регистрации базы;
502 и 504: истек тайм-аут прокси или веб-сервера, помогает уменьшение порции.
Работает в браузере, но не из приложения? Сверьте учетную запись, заголовок Accept, кодирование адреса, прокси и сертификат. Права проверяют входом под служебным пользователем. Если у пользователя нет доступа к отдельному реквизиту, запрос завершится ошибкой, и маршрут должен обработать ее явно.
Полезно знать и внутренние коды: 15 означает, что сущность с таким ключом уже существует, 19 говорит о запрещенном в данном контексте методе, 21 указывает на нереализованную функцию или неверные аргументы. Они сокращают поиск причины. Внезапные 400 и 404 после обновления конфигурации обычно означают, что реквизит переименован или удален: маршрут правят под новую модель из $metadata.
GET можно повторять без изменения данных. Повтор PATCH с теми же значениями безопасен только после проверки прикладных обработчиков: при модификации данных платформа исполняет связанные с ней обработчики, и они могут иметь побочные эффекты. POST повторяют только после проверки того, не создан ли объект первой попыткой.
В журнал интеграции пишут адрес, метод, время, код ответа, длительность, текст ошибки и идентификатор корреляции. Одна запись выглядит так:
{ "ts": "2026-10-20T10:00:03.412+03:00", "method": "PATCH", "url": "…/Document_ЗаказПокупателя(guid'5d1e0c2a-…')", "status": 500, "duration_ms": 1840, "error": "Не удалось провести документ: недостаточно остатка", "correlation_id": "c7e1f0a2-…", "route": "crm-orders-to-erp" }
Для сбора и анализа логов можно использовать дополнительный инструмент.
Как защитить интеграцию
Опубликованная база – это API к учетным сведениям компании. Открывать ее во внешнюю сеть без дополнительных мер нельзя: Basic-авторизация без сетевых ограничений уязвима к подбору пароля. Минимальный набор мер:
отдельный служебный пользователь только с нужными правами;
HTTPS, в том числе внутри периметра;
пароли в хранилище секретов, а не в конфигурационных файлах;
ограничение доступа по сети и IP-адресам;
обратный прокси или API-шлюз для внешних потребителей с лимитами и ограничением методов;
журнал обращений и оповещение об аномальных выгрузках.
Сетевые ограничения, лимиты и запрет записи удобно задать на обратном прокси. Пример для nginx, где внешнему потребителю разрешено только чтение:
# в блоке http: не больше 10 запросов в секунду с одного адреса limit_req_zone $binary_remote_addr zone=odata:10m rate=10r/s; server { listen 443 ssl; server_name erp-api.company.local; location /trade/odata/ { allow 10.20.0.0/16; # только внутренняя сеть deny all; limit_except GET { deny all; } # запись для этого потребителя закрыта limit_req zone=odata burst=20; proxy_read_timeout 120s; proxy_pass http://srv-web-1c; } }
Для управления доступом в экосистеме также предусмотрены соответствующие средства.
На практике первой ломается организационная часть: одна административная учетка на все системы и забытые после «пилота» публикации. Администратор может изменить что угодно, а разобрать инцидент потом не по чему. Учетная запись администратора для внешнего обмена недопустима.
В схеме с Digital Q.Integration реквизиты служебного пользователя хранятся в настройках коннектора, и потребители их не видят: CRM, портал или мобильное приложение обращаются к интеграционному слою, а к учетной базе «ходит» только коннектор. Так одна учетная запись с узкими правами обслуживает все маршруты, а при компрометации ее меняют в одном месте, без правки каждой внешней системы.
Когда OData достаточно, а когда нужен HTTP-сервис или интеграционная платформа
К учетной базе ведут два пути. Первый – доработка конфигурации: HTTP-сервисы, веб-сервисы SOAP с контрактом WSDL или обмен через промежуточные объекты и файлы. Логика живет внутри базы, но нужен отдельный разработчик, а доработанная конфигурация перестает быть типовой, и каждое обновление превращается в проект по переносу и проверке обмена.
Второй путь – стандартный протокол: конфигурация не меняется, публикация занимает часы, а не недели, обновления проходят без переноса доработок. Стандартного механизма хватает для витрин остатков, личных кабинетов, портала на «Битрикс», выгрузки справочников в BI и загрузки первичных документов. Это быстрая интеграция 1С через OData без изменения конфигурации.
Ограничения начинаются в трех местах. Сценарий из нескольких шагов с откатом одним вызовом не выполнить, его пишут HTTP-сервисом на встроенном языке. Асинхронной доставки с очередями нет. А когда к одной базе обращаются десятки приложений со своими учетками и пагинацией, сопровождение становится главной статьей затрат.
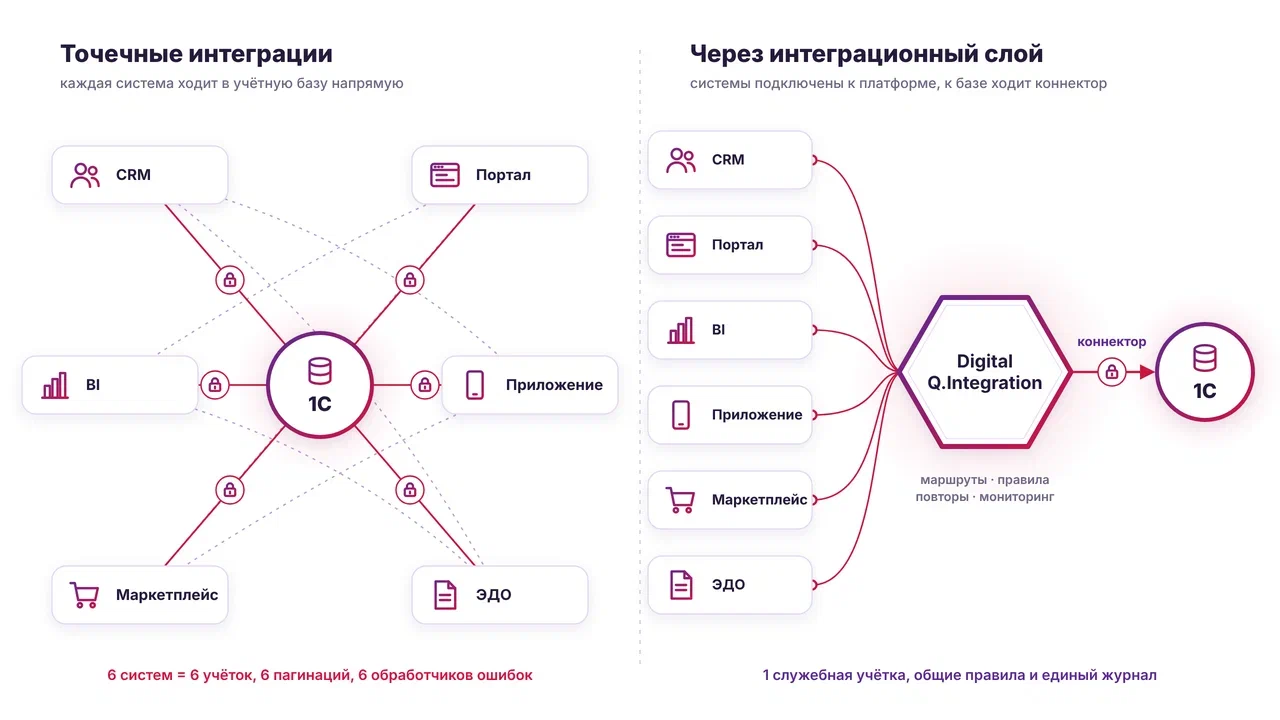
Очереди нужны в трех типичных случаях: получатель бывает недоступен, и сообщение должно дождаться его, нагрузка приходит пиками, и ее нужно сгладить, одно событие должны получить сразу несколько систем. Прямой вызов во всех трех случаях либо теряет данные, либо заставляет каждого потребителя писать свои повторы и буферы.
Сравнение ниже помогает понять, где стандартного интерфейса не хватает, а где нужен другой слой.
Задача | OData | HTTP-сервис | Интеграционная платформа |
Быстрое чтение | Хорошо подходит | Требует разработки | Может быть избыточна |
Простая запись | Подходит при корректных правах и модели | Можно контролировать логику | Удобна при нескольких системах |
Сложная бизнес-логика | Ограничена стандартной моделью | Реализуется в коде конфигурации | Можно строить маршруты, но логику все равно проектируют |
Асинхронный обмен | Нет «из коробки» | Нужно реализовывать | Обычно есть очереди, повторы, буферизация |
Большие объемы | Нужны пагинация и фильтрация | Оптимизируется под сценарий | Управление потоками и нагрузкой |
Много систем | Прямые связи быстро усложняются | Растет число сервисов | Централизация, но появляется отдельный компонент |
Мониторинг | Делают отдельно | Зависит от реализации | Обычно централизованный |
Правильный вопрос звучит не «что лучше», а «кто владеет логикой обмена». Критерии: число систем, требования к доставке и аудиту, сложность преобразований и нагрузка. При трех-пяти системах с низкой нагрузкой отдельный слой избыточен.
События в реальном времени стандартный интерфейс не доставляет. Для телефонии, электронной подписи и брокеров сообщений в платформе 8.3.27 есть отдельный объект – WebSocket-клиент, и это самостоятельный канал, а не замена стандартному интерфейсу.
Пример архитектуры с интеграционным слоем
Типичный поток при передаче данных о клиентах в CRM выглядит так:
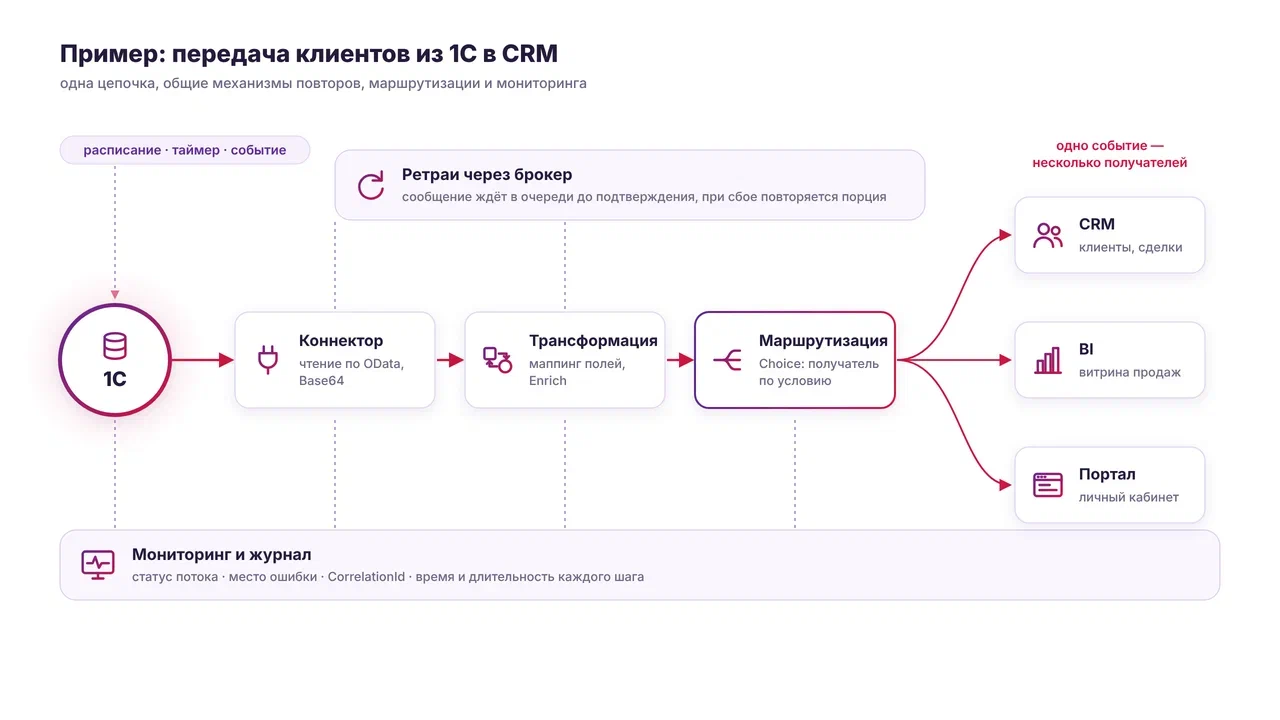
В Digital Q.Integration он собирается на Apache Camel и более чем 300 готовых компонентах; транспорт обеспечивает Digital Q.MessageBroker на Kafka и Artemis. Для каждой системы работает свой коннектор-микросервис, а каждый поток живет как независимый сервис и обновляется без остановки остальных.
Как это выглядит в Digital Q.Integration
Маршрут собирается в визуальном дизайнере из готовых шагов. Перенос справочника из одной базы в другую выглядит так:
Маршрут собирается в визуальном дизайнере из готовых шагов. Перенос справочника из одной базы в другую выглядит так:
1. Чтение ответа коннектора из топика <префикс>…-reply.
2. Декодирование данных из Base64 и приведение к строке.
3. Split: деление коллекции на отдельные записи.
4. Удаление Ref_Key источника и служебных заголовков чтения.
5. Заголовок метода → SetObjectData, тело в Base64.
6. Отправка задания в q1cconnector-start-command.
7. Ответ на запись → журнал, ошибка → отдельная ветка обработки.
Запускается такой маршрут по расписанию, по таймеру или по событию в другой системе. За каждый шаг отвечает свой механизм:
маршрутизация: компонент Choice направляет сообщение по условию, одно событие расходится по нескольким получателям;
трансформация: сопоставление реквизитов настраивается в визуальном дизайнере, Enrich дозагружает сведения из смежной системы, нестандартная логика оформляется Java-классом через компонент Bean;
ретраи: сообщение остается в очереди брокера до подтверждения обработки, и при сбое повторяется конкретная порция;
мониторинг: реестр показывает статус потока, логирование фиксирует каждое преобразование и место ошибки, записи фильтруются по времени, пользователю и типу события.
Многошаговые сценарии описываются во встроенном редакторе BPMN 2.0: аналитик размечает точки взаимодействия, разработчик настраивает для каждой свой поток. Так у нас работает двусторонний обмен Digital Q.CRM с учетной системой: контрагенты, контакты, справочники, лиды, сделки, продуктовый справочник и связи объектов, а также запуск процедур на стороне учетной базы.
Журнал регистрации через стандартный интерфейс не отдается, поэтому сквозной след обращений ведут в интеграционном слое. Это важно и юридически: при установлении факта неправомерной или случайной передачи персональных данных, повлекшей нарушение прав субъектов, первичное уведомление Роскомнадзора направляют в течение 24-х часов, а результаты внутреннего расследования – в течение 72-х часов. Без записей о выгрузках установить, что ушло наружу, невозможно.
Поэтому интеграцию мы строим от спецификации, а не от кода. Модель из $metadata, контракты сообщений и правила маппинга фиксируются до разработки, а тест-кейсы пишутся независимо от реализации. Когда структура источника меняется, исправляют спецификацию, а не латают код. Часть этой работы у нас выполняют ИИ-агенты: они работают в изолированных контейнерах и получают доступы только под конкретную задачу, что для проектов с учетными данными принципиально. Как устроена их координация, мы подробно рассказывали в статье про Digital Q.Agents.
Заключение
Стандартный протокол остается самым быстрым способом открыть учетную базу остальному ландшафту. Публикация занимает часы, конфигурация не меняется и остается типовой, а обращения строятся по открытому стандарту. Для витрин, кабинетов, выгрузки справочников и простой записи этого достаточно.
С ростом ландшафта приходят новые требования: несколько получателей одного события, преобразование форматов, гарантированная доставка, единые учетные данные и сквозной журнал. Прямые связи их не закрывают, и каждая новая система добавляет еще одну копию логики: свою пагинацию, свои повторы, свою обработку ошибок.
Главным мы считаем порядок шагов: опубликовать только нужные объекты под служебным пользователем, прочитать модель через $metadata, собрать один поток и измерить реальные объемы и ошибки. Когда точечных связей становится больше, обмен разумно переносить под единое управление.
В Digital Q.Integration 1С через OData остается одним из каналов, а маршрутизация, трансформация, повторы и мониторинг собираются в одном контуре. Коннектор берет на себя авторизацию, сборку запросов и разбор ответов, поэтому прикладная команда работает с маршрутами, а не с синтаксисом протокола. Проверить этот подход можно на бесплатном демостенде Digital Q.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.