Опыт QA-автоматизатора: как я подключил нейросеть к wiki, базам данных и тест-менеджменту
«Давайте скормим модели документацию, а она сама нагенерит тест-кейсы». Вот что обычно слышишь, когда разговор заходит про нейросети в тестировании. Звучит красиво, но в моей работе это оказалось чуть ли не самым бесполезным сценарием. Я занимаюсь автоматизацией, ручные кейсы пишу не каждый день, и генерация их «по щелчку» закрывает не ту боль. Для меня настоящая боль в другом. Как понять, что вообще нужно проверять, где лежат данные, какая логика сейчас актуальна, какие сценарии уже покрыты и где документация расходится с тем, как система ведёт себя на самом деле.
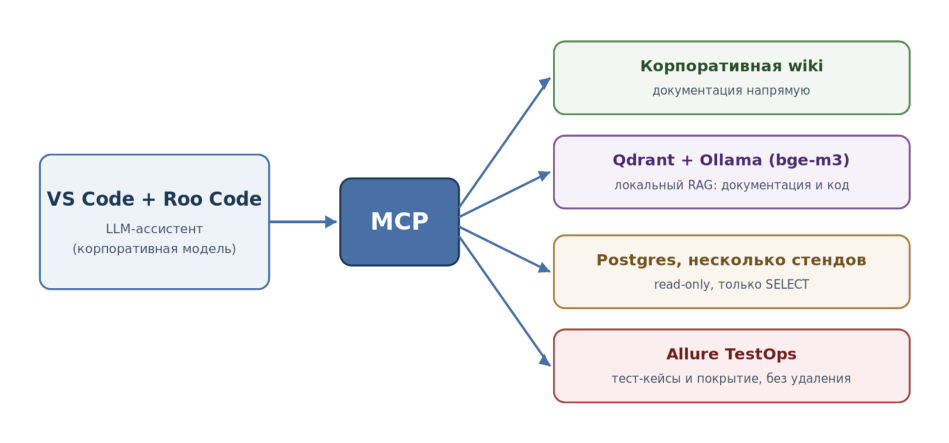
Поэтому я стал относиться к LLM как к ассистенту, которому можно постепенно отдавать доступ к рабочему контексту: документации, векторному поиску по ней, базам данных, тест-кейсам и репозиторию автотестов. Всё это я подключал через MCP. И дальше расскажу, как именно всё подключал, на какие грабли наступил, а что в итоге реально выстрелило.
Это помогло. Я стал быстрее вникать в незнакомую бизнес-логику и проверять гипотезы по данным, не перечитываю каждый раз всё заново, и трачу меньше умственных сил на механический поиск. По кнопке LLM так и не генерирует ручные тест-кейсы, но это, я думаю, нормально.
С чего всё началось
Меня зовут Григорий Звягинцев, я старший специалист по тестированию в X5 Tech. Когда я пришёл в команду, то столкнулся с классической болью адаптации. Информации очень много, бизнес-логика сложная, расчёты нетривиальные, а коллеги загружены так, что дёргать их по каждому вопросу совесть не позволяет. Можно, конечно, читать документацию вручную, искать похожие автотесты, открывать тест-кейсы, лазить в БД, но всё это съедает кучу умственных сил, особенно когда вокруг всё новое.
Внутри компании уже была развёрнута инфраструктура для корпоративной LLM с доступом по OpenAI-совместимому API, и были токены к разным внутренним сервисам. А я и так после работы вожусь со своими проектами, иногда занимаюсь вайб-кодингом, и мне захотелось применить эти навыки в деле: дать нейросети руки, подключить её к тем источникам, которыми я и так пользуюсь каждый день.
Я работаю из VS Code с расширением Roo Code. Это AI-агент прямо в редакторе, который умеет в MCP. Корпоративную модель подключил к нему как обычного OpenAI-совместимого провайдера. Сначала так и пользовался. Агент помогал с кодом, с формулировками, с разбором автотестов, и это уже было неплохо. Но он довольно быстро упёрся в потолок. Без доступа к проектному контексту модель знает что-то «вообще», а не «про нас». Она объяснит синтаксис SQL, подскажет, как структурировать тест на Python, но про нашу систему, роли, стенды и особенности бизнес-логики не знает ничего. И вот тут начался самый интересный этап, подключение источников через MCP.
Лайфхак
Чтобы накидывать модели контекст голосом, а не печатать простыни руками, я пользуюсь локальной утилитой голосового ввода Handy. Половину этой статьи я, кстати, тоже надиктовал этой программой, пока обдумывал, о чём хочу написать.
Документация: первый слой контекста
Первым по-настоящему полезным подключением стал доступ к документации в корпоративной wiki. Я поднял MCP-сервер, через который ассистент стал получать страницы напрямую.
Это сразу поменяло характер работы. Раньше я вручную искал нужную страницу, читал здоровенный раздел и потом руками перетаскивал куски в чат. Теперь просто спрашиваю, как работает вот этот расчёт, какие у сценария ограничения, какие роли участвуют в процессе, что здесь считается крайним случаем, с какой соседней системой это связано. Модель не стала экспертом по нашей системе, но начала быстро поднимать релевантные куски документации. На этапе адаптации мне это очень помогло. Стало меньше механического поиска и больше времени на то, чтобы реально вникнуть. Ускорение онбординга заметил не только я, но и вся команда.
А теперь про грабли, потому что в корпоративной среде «поставил пакет, запустил и всё работает» почти не бывает. Нужен VPN, токены, переменные окружения — это база.
Проблемы начались при первой встрече с корпоративным HTTPS. MCP-сервер для wiki не доверял внутреннему корпоративному CA. С этим получилось отделаться малой кровью. У этого сервера есть штатная настройка, отключающая проверку сертификата, и для внутреннего сервиса, доступного только из-под VPN, я посчитал это приемлемым компромиссом. Но встал вопрос безопасности. На руках .env с токенами и конфиг MCP с доступами. Всё это нельзя случайно закоммитить. Так что отдельный пункт настройки, про который легко забыть в азарте, это аккуратный .gitignore, нормальное хранение секретов и проверка, что в репозиторий не уедет ничего лишнего.
Векторная база: когда документации становится слишком много
Дальше вылезла следующая беда. Часть страниц в документации просто огромные. Прямой доступ к wiki это хорошо, но не всегда удобно, потому что поиск идёт долго, в контекстное окно влетает гора лишнего текста, и модель захлёбывается. А окно у локальной корпоративной модели и так не резиновое.
Покажу на реальной задаче, ради чего я вообще полез в вектор. Мне надо было разобраться в ролевой модели: ролей много, у каждой свои права, и в голове это не удержать. Сначала я навёл ассистента на документацию через wiki-MCP, и с небольшими вопросами он справлялся. Но нужная страница оказалась слишком большой и целиком не влезала, контекст просто кончался. Тогда я и прикрутил векторную базу. После индексации ассистент стал доставать из этой страницы релевантные куски, а не пытаться проглотить её целиком.
Дальше важный шаг, который я не пропускаю. Надо сверить выдачу wiki-MCP с первоисточником, убедиться, что он достаёт верную информацию, и только потом на него опираться. После этого проверять «доступен ли такой-то экран этой роли, разрешено ли действие» стало быстрее. Не нужно каждый раз перечитывать всё заново.
Под капотом связка такая: Qdrant как векторная база, локальная модель эмбеддингов через Ollama и MCP-сервер, который занимается индексацией и поиском.
Модель эмбеддингов я выбирал осознанно. Взял bge-m3 по нескольким причинам:
она мультиязычная и нормально жуёт русский технический текст, а у нас почти вся документация на русском;
размерность эмбеддингов 1024, для семантического поиска по требованиям этого хватает с запасом;
весит немного: качается порядка 600 МБ, в ollama list отображается как ~1.2 ГБ, для локального запуска вполне подъёмно;
крутится локально, без обращений во внешние API, что в корпоративной среде ценно само по себе.
Англоязычные модели вроде nomic-embed-text я не стал рассматривать как основной вариант. Формально они работают, но семантику русских требований, описаний расчётов и внутренних терминов ловят заметно хуже. Плюс важный практический момент. При смене модели меняется размерность вектора (bge-m3 1024, nomic-embed-text 768). Старые коллекции в Qdrant с другой размерностью просто несовместимы, их придётся пересоздавать и переиндексировать. Так что модель эмбеддингов лучше выбрать один раз и осознанно.
Технически схема собралась так. Qdrant крутится локально в Docker, данные коллекций лежат в volume, чтобы после перезагрузки не переиндексировать всё заново. Ollama запущена на хосте. MCP-сервер ходит к Ollama из контейнера через host.docker.internal, считает векторы для чанков и складывает их в Qdrant.
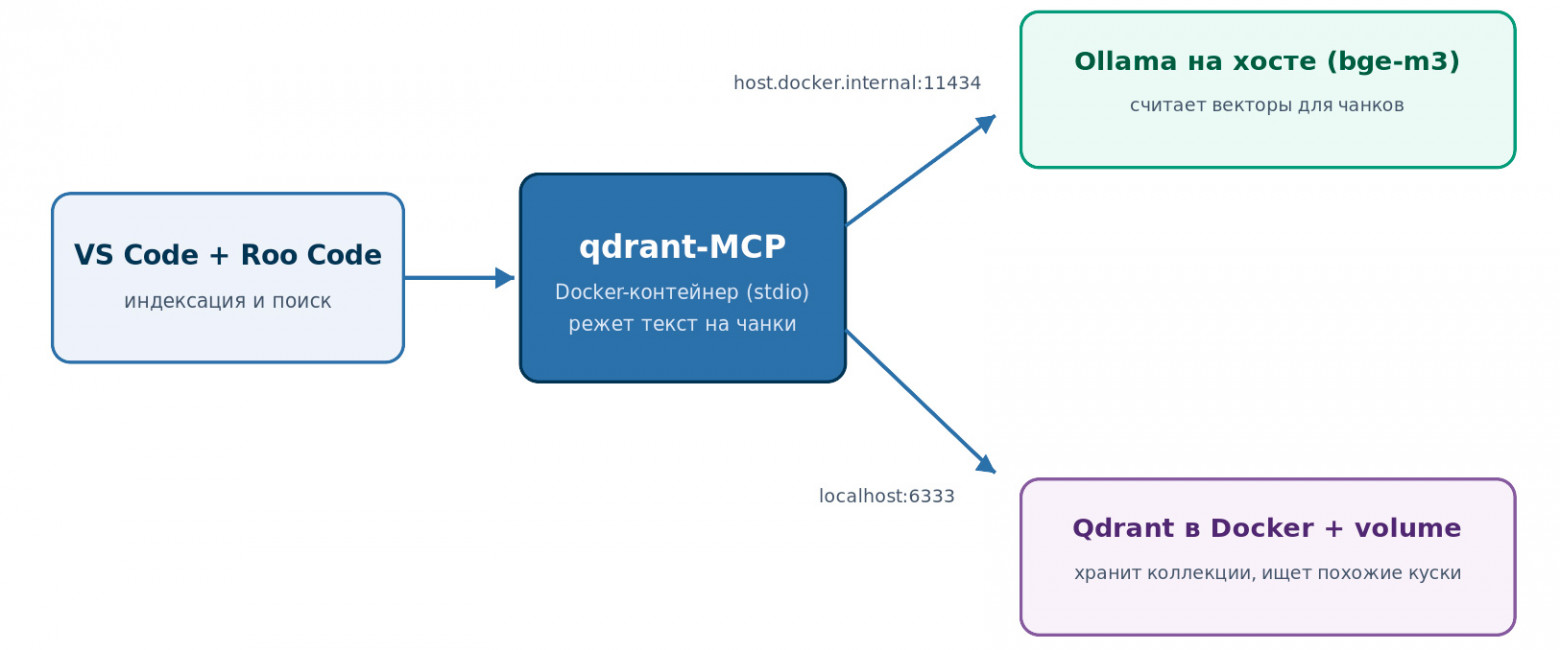
И тут стоит не путать два параметра: размер чанка текста для эмбеддинга, который у меня составляет около 1500 токенов, и размерность выходного вектора, которая равна 1024. Это разные вещи.
Дальше про честную цену вопроса, потому что в статьях этого обычно не пишут.
У меня не самый свежий ноут. MacBook Pro 2019 на Intel i7 восьмого поколения, 32 ГБ оперативки и видеокарта AMD. Ollama на таком железе считает всё строго на CPU. Metal-ускорение у неё работает только на Apple Silicon, а AMD-видеокарты под macOS она не поддерживает вовсе. Драйверной обвязки ROCm для маков просто нет, поэтому AMD-ускорение у Ollama живёт по сути только на Linux. В итоге все векторы молотит не самый свежий процессор, и первичная индексация нужных мне разделов wiki занимала около пяти часов непрерывной работы. На Apple Silicon то же самое проходит в разы быстрее, но в любом случае это не «нажал кнопку и через минуту готово». К такому объёму вычислений надо быть морально готовым.
Отдельная история — индексация самого кода. В Roo Code есть встроенная индексация кодовой базы. Она работает по той же схеме через эмбеддинги плюс Qdrant, и тоже частично помогает. В автотестах зашита бизнес-логика, названия сущностей, проверки и старые решения. Поэтому найти похожий тест или хелпер через семантический поиск часто быстрее, чем вспоминать точное имя файла или класса. Но именно тут я уткнулся в стабильность. При индексации кода летело много параллельных запросов, и процесс не доходил до конца, а падал с ошибкой. Помогло банальное решение. Я скрутил число параллельных запросов до двух. Стало медленнее, зато индексация наконец-то добралась до финиша, а на весь проект ушло около часа.
Но магии тут нет. RAG регулярно находит «близкое, но не то». Иногда всё равно нужен полный исходный текст страницы. Иногда сама документация устарела, и красиво найденный кусок просто врёт. Поэтому векторная база у меня работает как быстрый слой навигации, а спорные места я всё равно перепроверяю по исходной странице.
Postgres: проверять гипотезы по данным
Следующим шагом стал read-only-доступ к нескольким Postgres-базам. Я взял готовый crystaldba/postgres-mcp и поднял его в режиме --access-mode=restricted: ассистент может смотреть данные и собирать SELECT-запросы (list_schemas, list_objects, execute_sql, explain_query), но физически не может выполнить INSERT/UPDATE/DELETE или DDL-команды. Это принципиально. Все изменения данных я выполняю сам, руками в DBeaver, а нейросеть только подсказывает и помогает обсудить запрос.
Снова покажу на реальной задаче. Заводили новую группу в справочнике, и мне нужно было привязать к ней конкретную позицию, а потом убедиться, что после пересчёта она правильно появляется в UI. Проблема в том, что полной документации по этим таблицам не было. Я не разработчик и залезаю в них не каждый день, а полей там много, и сразу непонятно, что куда. Поэтому я уточнил у разработчика, что примерно делают нужные таблицы, потом сам посмотрел схему и поля через read-only Postgres MCP и набросал, каким хочу видеть запрос. Дальше обсудил с ассистентом логику JOIN и заодно проверил, правильно ли понимаю связи и не сломаю ли что-нибудь.
Сам запрос на изменение выполнил руками в DBeaver. Данные появились, я проверил в UI, что новая группа и позиция отображаются. Всё сошлось. А поскольку задачу потом пришлось повторять на демо, я оформил аккуратный скрипт с алиасами, чтобы вывод читался по-человечески и его можно было переиспользовать. Похожий заход был с логированием действий по заказам. Там, кроме самой проверки, попросили подготовить аккуратный скрипт для разбора инцидентов, чтобы сразу было видно, кто и когда что делал, его я тоже причесал и отдал бизнес-аналитикам.
Теперь нюансы настройки, на которые у меня ушло время.
Один MCP-сервер работает с одним
DATABASE_URI. Так что если у вас несколько стендов и несколько систем, это не один «универсальный Postgres», а пачка отдельных серверов: условноpostgres-test-a, postgres-dev-a, postgres-test-b, postgres-dev-b. Заводите по отдельности и по отдельности же включайте только под конкретную задачу.Самое коварное, это сеть. У меня внутренний
hostnameбазы прекрасно резолвился в обычном клиенте, но наглухо отказывался резолвиться изнутри Docker-контейнера. Причина оказалась в VPN-клиенте. Он не пробрасывал корпоративный DNS через системный резолвер. Симптом издевательский. DBeaver к базе подключается, а MCP падает по таймауту. Лечится внешним DNS-алиасом вместо внутреннего хоста. Самый надёжный способ, открыть настройки своего рабочего подключения в DBeaver и скопироватьhostnameоттуда. А если контейнер всё равно продолжит отваливаться по таймауту даже с правильным хостом , это уже известная беда связки «корпоративный VPN плюс Docker Desktop на macOS». Туннель не пробрасывается в контейнер. Воркэраунд, нужно запустить postgres-MCP не в Docker, а прямо на хосте через uvx. Тогда трафик пойдёт через нативный сетевой стек macOS.Мелочь, но бесит. Это URL-encoding пароля в строке подключения. Если в пароле есть
@, #, !, /или другой спецсимвол, наивная URI-строка ломается на ровном месте, а ошибка при этом максимально невнятная. Лечится тем, что спецсимволы надо закодировать:@в%40,#в%23и так далее.
Главное ограничение модели лучше всего видно именно на БД. Если просто бросить ей «посмотри, почему расчёт такой», она не поймёт, куда смотреть. В большой базе куча схем, таблиц, связей и исторического мусора, и без понимания предметной области модель уверенно уйдёт не туда. А вот когда направление задаю я, как в примере выше, польза появляется: накидай SELECT, уточни JOIN, проверь гипотезу, найди соседнее поле. Своё знание SQL и системы всё равно понадобится, просто путь от «а что если» до проверенного ответа становится заметно короче.
Allure TestOps: связать документацию, тесты и покрытие
Последним слоем я подключил систему тест-менеджмента, Allure TestOps. Сделал токен, поднял MCP, и вот тут корпоративный HTTPS отыгрался по полной. Сервер написан на Python и крутится в Docker-контейнере, и картина выходит издевательской. С хоста всё прекрасно! Браузер ходит, терминал ходит, но контейнер падает с классическим:
[SSL: CERTIFICATE_VERIFY_FAILED] self-signed certificate in certificate chain
Трюк с отключением проверки, который прошёл с wiki, здесь не сработал. Переменные вроде PYTHONHTTPSVERIFY=0 или NODE_TLS_REJECT_UNAUTHORIZED=0 ненадёжны. Популярные Python-клиенты вроде httpx и aiohttp их попросту игнорируют. Нормальное решение, отдать контейнеру сам корпоративный CA. Я вытащил сертификаты из системного хранилища в один PEM-файл, положил рядом с проектом, смонтировал внутрь контейнера и прокинул переменные, чтобы их видели разные библиотеки:
SSL_CERT_FILE=/certs/corp-ca.pem
REQUESTS_CA_BUNDLE=/certs/corp-ca.pem
CURL_CA_BUNDLE=/certs/corp-ca.pem
NODE_EXTRA_CA_CERTS=/certs/corp-ca.pem
Больше всего времени стоили два нюанса. Во-первых, в PEM обязательно должен лежать корневой Root CA, а не только промежуточный. Иначе Python продолжает ругаться на self-signed certificate in chain, даже когда промежуточный на месте. Во-вторых, не держите этот файл в /tmp: на macOS он чистится при перезагрузке, и SSL-ошибка возвращается на следующее утро. Поэтому я храню его рядом с проектом в отдельной папке, разумеется, добавленной в .gitignore.
Доступ к тест-менеджменту тоже держу урезанным. Я оставил чтение и аккуратное создание кейсов, а удаление и правку чужого запретил на уровне конфига.
Кажется, что главный сценарий здесь очевиден: «сгенерируй тест-кейсы по документации и сразу залей их». Мне как автоматизатору это нужно нечасто. Куда полезнее оказалось другое:
найти уже существующий кейс;
посмотреть ожидаемый результат;
свериться, что не делаю дубль уже покрытого сценария;
понять, как раньше формулировали похожую логику;
обсудить, что вообще стоит автоматизировать, а что разумнее оставить ручным.
Создавать и обновлять кейсы через ассистента тоже можно, но на автопилот я это не отдаю. Скажу прямо: работает не всегда быстро и не всегда удобно. Но даже в таком виде это полезный слой, благодаря которому модель перестаёт жить в вакууме и начинает сопоставлять документацию с реальным тестовым покрытием.
Когда всё собрано, всплывает неочевидный момент с порядком запуска. У меня каждое утро перед работой выходит небольшой ритуал: сначала Docker Desktop, потом контейнер Qdrant, потом Ollama, и только после этого я проверяю, что нужные MCP-серверы в редакторе «зелёные». Если поднять qdrant-MCP раньше, чем Ollama успела стартовать, индексация и поиск просто упадут, потому что серверу будет некому считать векторы.
И приятная мелочь: stdio-MCP-серверы не висят фоном. Контейнер стартует только в момент вызова инструмента и сразу умирает его завершения, поскольку используется запуск с --rm. То есть между запросами docker ps пуст, это нормально, а не «у меня всё отвалилось».
Что в итоге пригодилось, а что не сработало как магия
Главная польза оказалась в скорости, с которой теперь собирается рабочий контекст.
Когда у ассистента есть доступ к документации, векторному поиску, БД, тест-кейсам и репозиторию автотестов, он начинает работать как младший бизнес-аналитик под рукой: быстро поднимает информацию, накидывает варианты, задаёт уточняющие вопросы, помогает посмотреть на проверку под другим углом.
Для меня это в первую очередь экономия умственных сил, даже больше, чем времени. Особенно полезно, когда адаптируешься в новой команде и каждый день врезаешься в незнакомые сущности. Вместо того чтобы держать в голове три десятка вкладок, страниц и обрывков SQL, можно собрать первичный контекст в одном диалоге, а инженерное решение принять самому.
Ограничений хватает, рассказываю честно, иначе получится реклама.
Модель плохо работает без чёткого направления. Если я сам не понимаю, какую часть системы копаю, она тем более не поймёт. По сути, ей нужно нормальное ТЗ. Без него получаешь поток уверенных, но бесполезных предположений.
Контекст ограничен, и это ощущается физически. Каждый подключённый MCP-сервер тащит за собой описания своих инструментов, и всё это занимает место. У меня на одних только подключённых серверах набегало порядка 20-30 тысяч токенов, а это может съесть заметную часть и без того небольшого окна локальной модели. Поэтому в реальности я держу включёнными не все источники сразу, а только нужные под текущую задачу, и переключаю их по ходу.
Корпоративная модель не топ с рынка. У компании свои ограничения по безопасности, инфраструктуре, стоимости и доступу к данным. Это нормально, но ответы надо проверять критически. У модели бывают артефакты, и на сложных вопросах она ошибается увереннее, чем хотелось бы. Хотя для большинства не самых заумных задач, а их в работе большинство, этого уровня вполне достаточно.
И документация не всесильна. В реальном проекте часть знаний живёт в головах команды. Что-то не успели описать, что-то срочно поменяли, где-то логика уехала после релиза. Модель работает только с тем, к чему у неё есть доступ, а доступ всегда ограничен.
Почему это не замена QA-инженеру
Для меня этот опыт стал хорошим противоядием от крайностей. И от хайпа «ИИ всех заменит», и от снобизма «да это просто игрушка».
Модель видит только то, к чему её подпустили, а подпускают её не ко всему. Поэтому человек остаётся тем, кто собирает контекст, задаёт правильные вопросы, проверяет выводы и отвечает за результат. Ассистент может предложить SQL, но понимать, что именно проверяется, должен инженер.
Получается даже забавно: чем больше у ассистента доступов, тем важнее становится роль инженера. Так всегда было при масштабировании любого производства. Сначала появляются новые инструменты, которые надо осваивать и которые позволяют одному человеку держать в руках больше контекста, чем раньше. MCP оказался просто очередным таким витком.
Что хочу развивать дальше
Кое-что я уже начал. В редакторе есть кастомные режимы под типовые задачи. Например, они помогают с генерацией UI- и backend-тестов, работой с тест-кейсами, связкой документации и проверок. Дальше хочется довести это до состояния, когда такими вещами пользуется вся команда, а не только я на своём ноуте:
командные режимы и skills под наш проект, чтобы каждому не настраивать всё с нуля;
готовые команды под рутину;
review автотестов с учётом правил и стиля нашего фреймворка;
отдельные сценарии под анализ документации и сверку ожидаемых результатов;
эксперимент с заменой части универсальных MCP на более точечные project-specific инструменты, чтобы, например, проверить, насколько хорошо заходит специализированный скилл вместо «голого» Playwright MCP.
Общая идея построить вокруг инженера управляемый, предсказуемый контекст, а не свалку из всех MCP подряд.
Всё, о чём я рассказал выше, пока остаётся моим личным набором настроек на ноуте. Самое интересное начинается там, где это превращается в командную практику. Как это внедрять, чтобы пользовались все, а не один энтузиаст? Где подводные камни, что заходит, а что нет? Как не сделать из этого очередную игрушку, которую забросят через месяц? Но это уже большая отдельная тема, и, скорее всего, она станет моей следующей статьёй об опыте внедрения ИИ-практик в команде QA и как к этому подступиться.
И вывод, к которому я в итоге пришёл. ИИ с MCP не делает QA-автоматизатора ненужным. Он делает хорошего QA-инженера быстрее.
Это мой первый заход на Хабр и довольно сырой опыт, так что буду рад обратной связи и вопросам в комментариях, особенно от тех, кто прикручивал подобное в своих корпоративных контурах. Интересно сверить грабли.
Также можно прочитать статьи о том, как ИИ получает рабочий контекст и встраивается в инженерные процессы:
– DS MCP: как дать AI-агенту знание о вашей дизайн-системе
– Text2SQL в аналитике: как мы научили ИИ понимать бизнес-запросы без посредников
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.