Как агенты общаются друг с другом: делегирование, DAG, сообщения и цена координации
Когда говорят о мультиагентных системах, обычно рисуют примерно такую картину: есть Lead, он раздаёт задачи Coder, Reviewer и Researcher, они общаются между собой, обмениваются результатами, а Lead собирает всё в финальный ответ.
На диаграмме получается почти идеальная команда.
В реальности возникает несколько вопросов.
Как агент узнаёт, кому можно поручить работу?
Что делать, если две подзадачи зависят друг от друга?
Как передать результат так, чтобы не пересылать всю историю разговора?
Нужно ли ждать ответа или можно продолжать работу?
Что происходит, если один из участников ошибся?
Как не допустить, чтобы два агента одновременно переписывали один файл?
И главное: сколько токенов мы потратили на то, чтобы агенты договорились о работе, вместо того чтобы её выполнять?
Я занимаюсь разработкой Temporality — среды исполнения и контура управления для агентных систем. В ней межагентное взаимодействие реализовано несколькими разными механизмами: delegate, plan, ask_agent и get_collaborators.
Они решают разные задачи. И это принципиально: универсальный механизм общения между агентами не обязательно является хорошим механизмом организации их работы.
Разберём распространённые подходы, их сильные и слабые стороны, а затем посмотрим, почему мы пришли к такой архитектуре.
1. Какие способы взаимодействия агентов вообще существуют
Если отбросить названия конкретных фреймворков, основные механики можно свести к нескольким моделям.
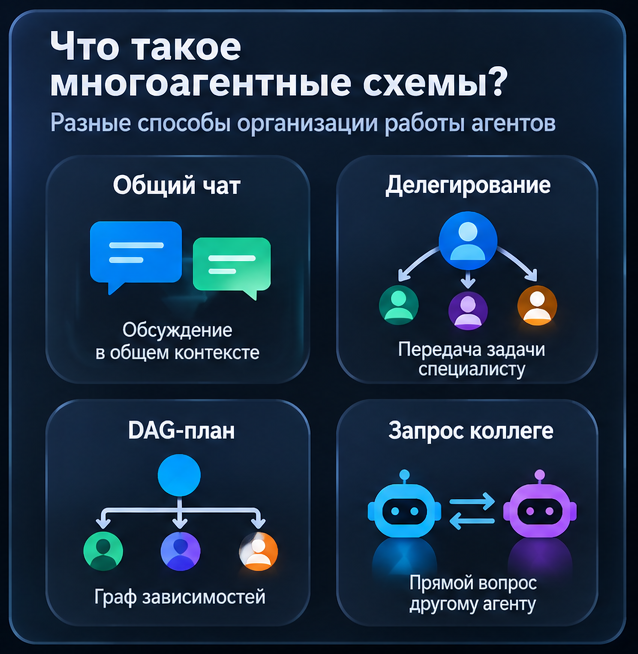
1.1. Общий контекст
Самый простой вариант: несколько агентов работают с одной историей или общей памятью. Каждый видит сообщения остальных и может продолжать обсуждение.
Это напоминает общий чат команды.
Плюсы:
практически не нужна отдельная инфраструктура;
легко реализовать;
агенты могут использовать результаты друг друга;
удобно для небольших дискуссий и brainstorming.
Минусы:
контекст быстро разрастается;
агенты читают сообщения, которые им не нужны;
трудно отделить факты от предположений и промежуточных рассуждений;
нет естественной границы между обсуждением и исполнением;
ошибки одного агента могут повлиять на всех участников.
Главная проблема — масштабирование контекста.
Если в команде пять агентов, каждый из которых должен прочитать историю из десяти тысяч токенов, это ещё не означает, что они стали в пять раз умнее. Возможно, они просто пять раз прочитали одну и ту же переписку.
Общий контекст полезен, когда участникам действительно нужно совместно рассуждать над одной проблемой. Но как универсальный транспорт для выполнения задач он довольно дорог.
1.2. Делегирование с ожиданием результата
Второй подход — родительский агент передаёт подзадачу дочернему и ждёт результата.
Это уже не разговор, а вызов исполнителя.
Условно:
Lead
├── Researcher: исследовать API
├── Coder: реализовать функцию
└── Reviewer: проверить результат
Каждый дочерний агент получает собственный системный промпт, модель, инструменты и ограничения. После завершения возвращает результат родителю.
Плюсы:
отдельные контексты;
понятная ответственность;
результаты можно ограничивать по объёму;
удобно использовать специализированные роли;
родителю не нужно наблюдать за каждым шагом ребёнка.
Минусы:
родитель должен правильно сформулировать задачу;
ребёнку нужно передать весь необходимый контекст;
при последовательном выполнении увеличивается общее время;
если результат одного агента нужен другому, приходится организовывать дополнительную передачу.
Это один из наиболее практичных вариантов. Для многих задач его достаточно.
1.3. Параллельный fan-out / fan-in
Здесь родитель запускает несколько независимых агентов одновременно, а затем собирает их ответы.
         ┌── Researcher A ──┐
Lead ────┼── Researcher B ──┼─── Lead
         └── Researcher C ──┘
В отличие от последовательного делегирования, здесь можно сократить wall-clock время.
Например, три независимых исследования по 40 секунд каждое не обязательно должны занимать две минуты. При параллельном исполнении они могут завершиться примерно за время самого длинного исследования.
Но есть нюанс: параллельное исполнение не означает уменьшение количества токенов.
Три агента по-прежнему должны прочитать свои инструкции, обработать данные и сформировать ответы. Иногда они ещё и дублируют часть работы.
Поэтому fan-out — способ уменьшить время ожидания, а не автоматически повысить экономическую эффективность.
1.4. Граф задач (DAG)
Следующий уровень — не просто список независимых подзадач, а граф зависимостей.
             ┌── API research ──┐
Lead ────────┤                  ├── Implementation ── Tests ── Review
             └── Data research ─┘
Задачи запускаются не потому, что родитель перечислил их в определённом порядке, а потому, что выполнены их зависимости.
Это позволяет:
запускать независимые задачи параллельно;
не запускать зависимые раньше времени;
автоматически передавать результаты по графу;
локализовать последствия ошибок;
добавлять контрольные точки и приёмку.
По существу, здесь уже появляется оркестрация, а не просто взаимодействие агентов.
1.5. Прямые сообщения между агентами
Наконец, есть модель, в которой агент может обратиться к другому агенту напрямую.
Например, Coder обнаружил изменение API и хочет уточнить у Researcher, совместимо ли оно с существующей интеграцией.
Coder ── вопрос ──▶ Researcher
Coder ◀─ ответ ─── Researcher
Родитель при этом необязательно участвует в каждом обмене.
Такая механика полезна, когда необходимость общения возникает уже во время исполнения, а заранее описать все зависимости невозможно.
Но если дать агентам возможность бесконтрольно обмениваться сообщениями, получится ещё один чат. Только вместо людей в нём будут дорогие языковые модели.
2. Почему универсальный Agent Messaging — не всегда хорошая идея
В какой-то момент возникает соблазн сделать полноценную подсистему сообщений:
общие комнаты;
presence;
личные и групповые сообщения;
подписки;
broadcast;
очереди;
произвольные адресаты;
отдельный mailbox для каждого агента.
Выглядит солидно. Но давайте посмотрим, какую задачу мы на самом деле решаем.
Если Lead поручил Coder реализовать API, а Reviewer проверить результат, им не нужен общий чат. Им нужны:
понятная задача;
результат выполнения;
возможность вернуть замечания;
повторное выполнение после исправлений.
Это гораздо проще выразить через граф задач и acceptance gate.
Если же Coder в процессе работы обнаружил вопрос, который может решить другой агент, нужен адресный запрос. Не комната, не broadcast и не постоянное присутствие коллег.
Поэтому мы сознательно не стали строить в Temporality отдельный универсальный messaging layer.
Вместо этого используем уже существующие механизмы:
Saga определяет область совместной работы;
delegation запускает дочерние выполнения;
Journal фиксирует события;
steering доставляет входящие сообщения на границах ходов;
Temporal обеспечивает долговременное исполнение и восстановление.
Меньше отдельных сущностей — меньше состояний, которые нужно синхронизировать и восстанавливать.
3. delegate: передать задачу специалисту
В Temporality delegate — это инструмент самого агента.
Он может выбрать другого агента из доступного workspace, сформулировать самостоятельную подзадачу и дождаться результата.
Упрощённый пример:
{
   "agent_id": "researcher",
   "prompt": "Исследуй обратную совместимость API v2. Проверь изменения схем, найди затронутые клиенты и верни список рисков с доказательствами."
}
Дочерний агент запускается как полноценный AgentRun, реализованный через Temporal Child Workflow.
Это важное отличие от ситуации, когда родитель просто просит модель ответить в другой роли.
У дочернего запуска есть:
собственный идентификатор;
собственная траектория выполнения;
собственная конфигурация модели и системного промпта;
собственные capabilities;
собственные инструменты и песочница;
собственный бюджет ходов;
связь с родительским запуском.
Результат возвращается родителю как результат tool-вызова.
Что здесь важно с точки зрения безопасности
Родитель не может передать ребёнку больше полномочий, чем тот уже имеет.
Конфигурация дочернего агента разрешается из его собственного определения. Нельзя написать в промпте «теперь у тебя есть доступ к production» и считать, что это сработает.
Наследуется security context инициатора, а права дочернего агента остаются ограничены его конфигурацией и политиками.
Делегирование также не включено автоматически: это отдельная capability, которую должен разрешить человек.
Глубина цепочки ограничена двумя уровнями. Это не даст агентам бесконечно передавать работу друг другу, пока исходная задача не превратится в дерево из сотни запусков.
Параллельное делегирование
Если модель выдаёт несколько вызовов delegate в одном ответе, они могут стартовать конкурентно.
Например:
Lead
├── Researcher: исследовать API
├── Analyst: проверить требования
└── QA: изучить существующие тесты
Родитель получает результаты в конце хода. Ширина параллельного делегирования ограничена восемью дочерними запусками.
Есть важное ограничение: дочерние агенты работают в общем workspace проекта без изоляции.
Поэтому параллельно хорошо запускать исследования, поиск, анализ и независимые read-only задачи. А вот два агента, одновременно редактирующие один файл, собирающие проект или выполняющие git-операции, — уже не параллелизм, а лотерея.
В таких случаях задачи нужно выстраивать последовательно.
Когда delegate эффективнее всего
Исследование отдельного вопроса.
Проверка гипотезы.
Независимый аудит.
Работа специалиста с узкой компетенцией.
Подготовка самостоятельного артефакта.
Задача, которую можно описать без постоянного вмешательства родителя.
Главное правило: подзадача должна быть самодостаточной. Дочерний агент не должен угадывать, что имел в виду родитель, или читать всю его переписку.
В этом и состоит одна из главных экономий: передаём не историю, а необходимую постановку задачи.
4. plan: когда делегирование превращается в граф исполнения
delegate хорош, когда нужно передать одну или несколько самостоятельных задач.
Но если есть зависимости, ревью, сборка, тестирование и возврат на доработку, набор отдельных вызовов становится неудобным.
Для этого в Temporality есть plan.
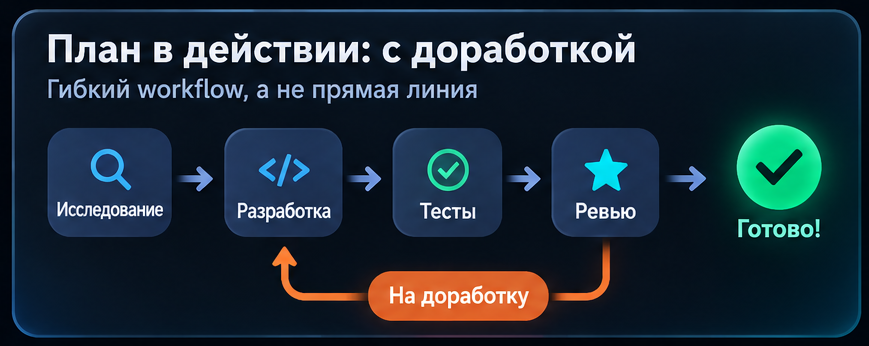
Агент описывает DAG, а дальше его исполняет ядро — без необходимости каждый раз вызывать модель-родителя, чтобы решить, какую задачу запускать следующей.
Пример:
{
   "goal": "Реализовать и проверить новую API-функцию",
   "tasks": [
     {
        "id": "research",
        "agent_id": "researcher",
        "prompt": "Изучи существующий API и ограничения."
     },
     {
        "id": "implementation",
        "agent_id": "coder",
        "depends_on": ["research"],
        "prompt": "Реализуй функцию с учётом результатов исследования."
     },
     {
         "id": "tests",
         "agent_id": "qa",
         "depends_on": ["implementation"],
         "prompt": "Подготовь и запусти тесты."
     },
     {
         "id": "review",
         "agent_id": "reviewer",
         "review_of": ["implementation", "tests"],
         "prompt": "Проверь реализацию и тесты."
     }
   ]
}
Это упрощённый пример: в реальном проекте можно добавить независимые исследовательские ветки, несколько этапов проверки и разные политики обработки ошибок.
Почему это экономит токены
Представим, что родитель последовательно вызывает четыре агента:
вызывает Researcher;
получает ответ;
анализирует его;
вызывает Coder;
получает ответ;
анализирует его;
вызывает QA;
получает ответ;
вызывает Reviewer.
Каждый переход между этапами может требовать нового обращения к модели-родителю.
При plan родитель один раз описывает структуру работы. Дальше ядро само:
запускает готовые задачи;
ждёт завершения зависимостей;
передаёт ответы downstream-задачам;
обрабатывает ошибки;
собирает сводку.
Результаты зависимых задач автоматически добавляются в их промпты как секция Upstream results. При необходимости можно явно вставить конкретный ответ через {{task-id.answer}}.
То есть родителю не нужно выступать диспетчером на каждом шаге.
Важная деталь: DAG не означает, что всё нужно запускать параллельно
В нашем случае действует принцип: по умолчанию последовательность безопаснее параллелизма.
Параллелить можно, если:
задачи работают с непересекающимися файлами;
между ними нет передачи данных;
ни одна из них не собирает, не тестирует и не выполняет git-операции.
Если есть сомнения, лучше указать зависимость.
Неправильный граф может испортить результат гораздо эффективнее, чем медленный агент.
Что происходит при ошибках
Для plan есть три политики:
Политика | Поведение | Когда применять |
|---|---|---|
| Независимые ветки продолжают работу | Ошибка локальна и не обесценивает остальные задачи |
| Новые задачи не запускаются, текущие завершаются | Нужно ограничить дальнейшие расходы, но не убивать полезную работу |
| Текущие дочерние запуски отменяются | После ошибки весь оставшийся план бессмыслен |
Это гораздо лучше, чем заставлять родителя каждый раз разбираться, что именно произошло и какие ветки ещё можно выполнять.
Два режима возврата управления родителю
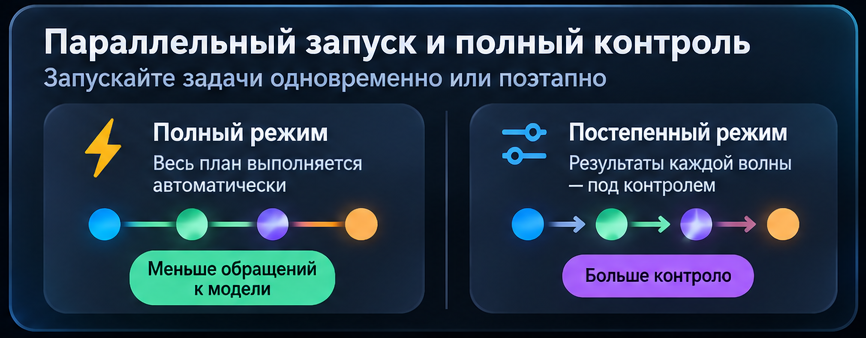
Здесь есть одна интересная особенность.
plan поддерживает два режима: full и wave.
full — автоматическое исполнение всего графа.
Родитель описывает DAG, ядро выполняет его целиком и возвращает сводку. Это наиболее экономичный вариант по количеству промежуточных обращений к родительской модели.
wave — исполнение волнами.
Ядро выполняет только текущую готовую партию задач, после чего возвращает управление родителю.
Родитель получает результаты, может оценить их, изменить оставшийся план, отменить дальнейшую работу или сформировать новый DAG.
Например:
Wave 1:  Research API  Research requirements  Inspect tests
↓ результаты родителю
Родитель оценивает результаты и корректирует план
↓
Wave 2:  Implement API  Prepare migration
↓ результаты родителю
Родитель решает, продолжать ли
↓
Wave 3:  Tests  Review
Ответы уже завершённых задач остаются доступны по их идентификаторам. Повторно запускать их не нужно.
При этом есть важное архитектурное отличие: состояние остатка DAG несёт модель-родитель, а ядро сохраняет результаты уже завершённых задач. После получения очередной волны родитель формирует следующую версию плана.
Это компромисс между автономностью исполнения и возможностью вмешательства.
full — меньше управляющих вызовов модели, меньше задержек и обычно меньше токенов на координацию.
wave — больше контроля, но дополнительные обращения к модели и повторная передача описания оставшейся работы.
Если процесс достаточно предсказуем, незачем заставлять родителя просыпаться после каждой мелочи. Если результат промежуточного этапа может существенно изменить стратегию — контрольная точка оправдана.
5. Review и rework: как сделать из графа рабочий цикл
Обычный DAG ацикличен. Но разработка почти никогда не бывает строго линейной.
Кодер написал код, ревьюер нашёл ошибки, кодер исправил, ревьюер проверил снова.
Если просто добавить обратное ребро, мы получим цикл, который сложно корректно исполнять и ограничивать.
В Temporality для этого есть review_of и submit_review.
Ревьюер явно указывает, какие задачи он принимает:
{
   "id": "review",
   "agent_id": "reviewer",
   "review_of": ["implementation", "tests"],
   "prompt": "Проверь реализацию и тесты."
}
Ядро автоматически добавляет эти задачи в зависимости ревьюера. Когда он заканчивает проверку, вызывается:
submit_review(
  verdict: "accept" | "rework",
  feedback?: {    "implementation": "Не обработан случай X"  }
)
Если вердикт accept, граф продолжается.
Если rework, отклонённые задачи возвращаются в работу с замечаниями ревьюера. Их потребители, уже использовавшие старые результаты, инвалидируются и пересчитываются. Независимые ветки при этом продолжают работу.
Это принципиально важная деталь.
Допустим, QA уже протестировал старую реализацию. Ревьюер вернул её на доработку. Нельзя просто заменить результат Coder и оставить старые тесты как будто они всё ещё подтверждают новую версию.
Результаты downstream-задач должны быть признаны устаревшими.
Число циклов ограничено max_rework — от нуля до четырёх, по умолчанию два. Бесконечного диалога «не нравится — переделай» не получится.
В журнале остаётся история: кто отклонил результат, почему, сколько раз его возвращали и какие задачи пришлось пересчитать.
Таким образом, ревью — не сообщение в чате, а управляемый переход состояния рабочего процесса.
6. ask_agent: когда коллега нужен прямо сейчас
delegate и plan решают задачу организации работы.
Но иногда агенту нужна не новая подзадача, а конкретный ответ от другого участника текущей работы.
Например:
Coder обнаружил несовместимость API и хочет уточнить у Researcher, почему было принято такое решение.
QA нашёл странное поведение и хочет получить объяснение от Coder.
Reviewer хочет уточнить у автора реализации, является ли изменение намеренным.
Один агент обнаружил информацию, которую нужно передать другому, пока тот ещё работает.
Для этого появился ask_agent.
Но прежде агент должен понимать, с кем вообще можно взаимодействовать.
get_collaborators: обнаружение участников
Инструмент возвращает участников текущей Saga — как агентов, так и людей, которые уже участвовали в работе.
Для каждого доступны:
идентификатор;
тип участника;
роль;
задача;
статус;
идентификатор запуска, если это агент.
Это не глобальный каталог всех агентов компании. Область видимости ограничена текущей Saga.
Зачем это нужно?
Потому что возможность отправить сообщение произвольному агенту в системе и возможность обратиться к коллеге, который действительно участвует в этой работе, — разные вещи.
Кроме того, агент не должен самостоятельно определять, что ему разрешено. Переданный моделью адресат проверяется ядром. Нельзя обратиться к чужому агенту просто потому, что модель угадала его ID.
Два режима ask_agent
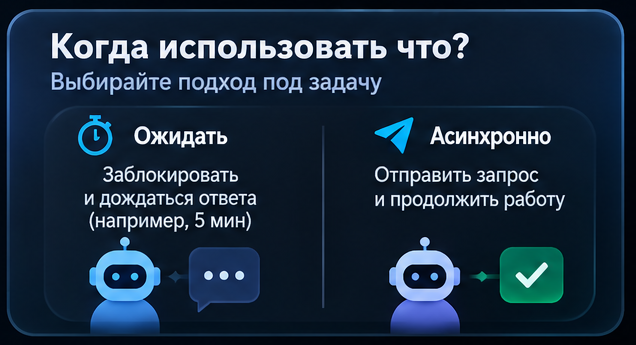
У инструмента есть два режима.
wait — дождаться ответа.
{
   "to": "agent:researcher",
   "type": "compatibility.check",
   "payload": { "api_change": "Удаляем параметр legacy_id" },
   "mode": "wait"
}
Агент отправляет запрос и ждёт ответ в рамках текущего вызова.
Это удобно, когда дальнейшая работа действительно зависит от ответа.
Есть timeout: по умолчанию 300 секунд, максимум 3600. Важная особенность: истечение ожидания не отменяет уже зарегистрированный запрос. Если адресат ответит позже, ответ всё ещё может быть доставлен асинхронно.
async — отправить и продолжить работу.
Это режим по умолчанию.
Агент получает request_id и статус pending, после чего продолжает выполнение.
Получатель обрабатывает запрос и отвечает через answer_agent. Ответ автоматически доставляется отправителю через steering на следующей границе хода.
Отправителю не нужно опрашивать адресата и проверять, готов ли ответ.
Можно иметь несколько одновременно ожидающих запросов. Ответы сопоставляются по request_id, поэтому порядок их получения не обязан совпадать с порядком отправки.
А если адресат уже завершил работу?
Это интересный случай.
Предположим, Researcher завершил исследование, но через десять минут Coder обнаружил вопрос к его результатам.
Если разрешать общение только с активными запусками, придётся либо запускать нового Researcher вручную, либо отказываться от взаимодействия.
В Temporality для этого предусмотрен relay-run: если адресат уже завершил выполнение, ядро может создать короткий дочерний запуск того же агента для обработки запроса.
Он получает самодостаточный контекст вопроса и отвечает через answer_agent.
При этом это не произвольный новый запуск: он связан с исходной работой, имеет ограниченный бюджет и не может делегировать дальше.
Почему сообщения доставляются на границах ходов
Входящее сообщение не должно внезапно прерывать текущую работу агента.
Представим, что Coder сейчас редактирует файл. В этот момент приходит вопрос от Reviewer. Если немедленно прервать текущую операцию, можно получить непредсказуемое состояние.
Поэтому запросы и ответы поступают через steering и обрабатываются на границах ходов.
Это может добавить задержку доставки, но сохраняет предсказуемость исполнения.
Межагентное сообщение также не становится бесконтрольным дополнением к системному промпту: оно имеет идентификатор, отправителя, тип и запись в журнале.
События взаимодействия фиксируются отдельно:
agent.asked    ↓
agent.message.received    ↓
agent.replied    ↓
agent.answer.received
Если запрос не удалось доставить или истёк срок ожидания, это также отражается в журнале.
Иными словами, общение становится частью наблюдаемой траектории работы.
7. Сравним подходы: скорость, надёжность и токены
Теперь самое интересное. Какой механизм быстрее, какой надёжнее и какой дешевле?
Здесь важно не смешивать три разных показателя:
Wall-clock latency — сколько времени ждёт пользователь.
Token cost — сколько токенов потрачено на модели.
Operational reliability — насколько предсказуемо система ведёт себя при ошибках, рестартах и повторных попытках.
Один механизм может быть быстрым по времени, но дорогим по токенам. Другой — экономным, но требовать больше времени на последовательное исполнение.
Ниже — качественная оценка типичных сценариев, а не результаты сравнительного benchmark на одинаковых моделях и задачах.
Подход | Скорость | Расход токенов | Надёжность координации |
|---|---|---|---|
Общий контекст / чат | Зависит от числа участников | Высокий при длинной истории | Низкая без дополнительного протокола |
Последовательный | Низкая/средняя | Средний | Хорошая при чётких контрактах |
Параллельный fan-out | Высокая | Средний/высокий | Хорошая для независимых задач |
| Высокая при наличии параллельных веток | Обычно низкий для координации | Высокая при корректном DAG |
| Ниже, чем | Выше из-за дополнительных обращений родителя | Высокая, больше точек контроля |
| Зависит от времени ответа | Низкий/средний | Хорошая при корректной обработке timeout |
| Не блокирует отправителя | Низкий/средний | Хорошая при устойчивой доставке и корреляции |
Что быстрее
Для независимых задач — параллельный fan-out или plan.
Для зависимых задач — DAG с автоматическим ожиданием зависимостей. Последовательные вызовы модели-родителя добавляют лишние round-trip.
Для короткого уточнения — ask_agent, особенно асинхронный режим, если ответ не блокирует текущую работу.
Общий чат не обязательно быстрее: каждый участник должен прочитать накопленный контекст, а иногда ещё и дождаться реакции нескольких агентов.
Что меньше ест токены
Здесь нет универсального победителя.
На расход влияют:
размер исходного контекста;
объём постановки задачи;
количество дочерних запусков;
объём ответов;
число повторных попыток;
количество обращений к родительской модели;
необходимость повторно передавать результаты.
Самая дорогая ошибка — запускать агентов без необходимости.
Если задачу можно выполнить одним агентом за пять ходов, запускать для неё ещё троих специалистов — не оптимизация.
Вторая дорогая ошибка — передавать полную историю вместо самодостаточной постановки и необходимых артефактов.
Третья — заставлять родителя многократно пересказывать результаты между этапами.
Именно в этом plan/full часто выигрывает у ручной последовательности delegate: модель-родитель не участвует в каждом промежуточном переходе.
Но wave может оказаться экономичнее полного плана, если промежуточный результат позволяет отменить ненужные следующие этапы. Дополнительные токены на контроль могут окупиться предотвращённой работой.
Что надёжнее
Надёжность определяется не количеством сообщений и даже не самим наличием Temporal.
Нужны:
устойчивые идентификаторы запусков и запросов;
явные состояния;
сохранение истории;
корректная отмена;
обработка timeout;
проверка прав;
ограничение повторных попыток;
понятная семантика ошибок;
отсутствие неконтролируемых побочных эффектов.
delegate и plan используют durable child workflows. ask_agent использует сигналы Temporal, связь запросов и ответов через request_id, а также записи Journal.
Это позволяет переживать поддерживаемые рестарты worker и kernel. Но не означает exactly-once execution для любых внешних побочных эффектов. Такие эффекты требуют отдельной идемпотентности и reconciliation.
Надёжность — это не обещание, что ошибки никогда не произойдут. Это способность системы корректно зафиксировать, что произошло, и продолжить работу в определённых границах.
8. Небольшая матрица выбора
Если свести всё к практическим правилам:
Ситуация | Что использовать |
|---|---|
Нужно поручить самостоятельную работу специалисту |
|
Несколько независимых исследований | Параллельный |
Есть последовательность зависимых этапов |
|
Нужны обязательные ревью и возврат на доработку |
|
Нужно контролировать каждый промежуточный результат |
|
Нужно уточнить конкретный вопрос у коллеги |
|
Ответ нужен для продолжения текущего шага |
|
Можно продолжить без ответа |
|
Нужно узнать, кто участвует в текущей работе |
|
Нужен ответ или решение человека |
|
Последний пункт принципиален. Человек и агент — не взаимозаменяемые адресаты. Для человека есть отдельный HITL-механизм с формами, каналами, валидацией и историей решений. Не нужно превращать его в ещё одного участника агентского чата.
9. Несколько ошибок, которые стоит учитывать при проектировании
Из практики разработки таких систем я бы выделил несколько правил.
Не делегируйте то, что проще сделать самому.
Если передача контекста и ожидание результата стоят дороже самой работы, делегирование бессмысленно.
Не запускайте параллельно задачи с общими изменяемыми ресурсами.
Общий workspace без изоляции означает, что два агента могут конфликтовать даже при идеально сформулированных промптах.
Не заставляйте родителя быть диспетчером каждого шага.
Если граф зависимостей известен заранее, пусть его исполняет ядро.
Не делайте бесконечные циклы ревью.
Нужны лимиты rework, явные вердикты и история замечаний.
Не путайте сообщение с задачей.
Вопрос «совместимо ли изменение API?» — сообщение. «Проверь совместимость API, подготовь отчёт и перечисли затронутые клиенты» — задача. Это разные виды взаимодействия и разные затраты.
Не путайте timeout с отменой.
Если отправитель перестал ждать, это не означает, что получатель должен забыть запрос. И наоборот: отмена родительской работы должна иметь понятную семантику для дочерних процессов.
Не считайте успешный ответ доказательством успешной работы.
Важны не только финальные ответы, но и траектория: сколько было попыток, что возвращалось на доработку, какие результаты были инвалидированы.
10. К чему мы пришли
В Temporality мы не пытаемся построить виртуальный офис, в котором агенты постоянно переписываются друг с другом.
Мы исходим из того, что взаимодействие должно соответствовать типу работы.
delegate— передача самостоятельной задачи.plan— исполнение графа зависимых задач.ask_agent— адресный запрос коллеге во время работы.get_collaborators— обнаружение участников текущей совместной работы.ask_human— получение решения человека.
Каждый механизм имеет свою семантику, стоимость и ограничения.
Мне кажется, это важнее, чем количество агентов в системе или наличие у них общего чата.
В конце концов, мы ведь не считаем хорошей организацией компанию, в которой все сотрудники постоянно сидят в одной комнате и пересылают друг другу сообщения. Мы ожидаем, что у них есть задачи, ответственность, сроки, правила передачи результатов и понятные точки принятия решений.
С агентами почему-то часто пытаются сделать наоборот: сначала создают чат, потом добавляют туда десять моделей и надеются, что из этого получится команда.
Иногда получается. Но чаще получается десять моделей, которые очень старательно обсуждают, кто должен сделать работу.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.