Я раздаю root на своём сервере всем подряд — и он до сих пор жив
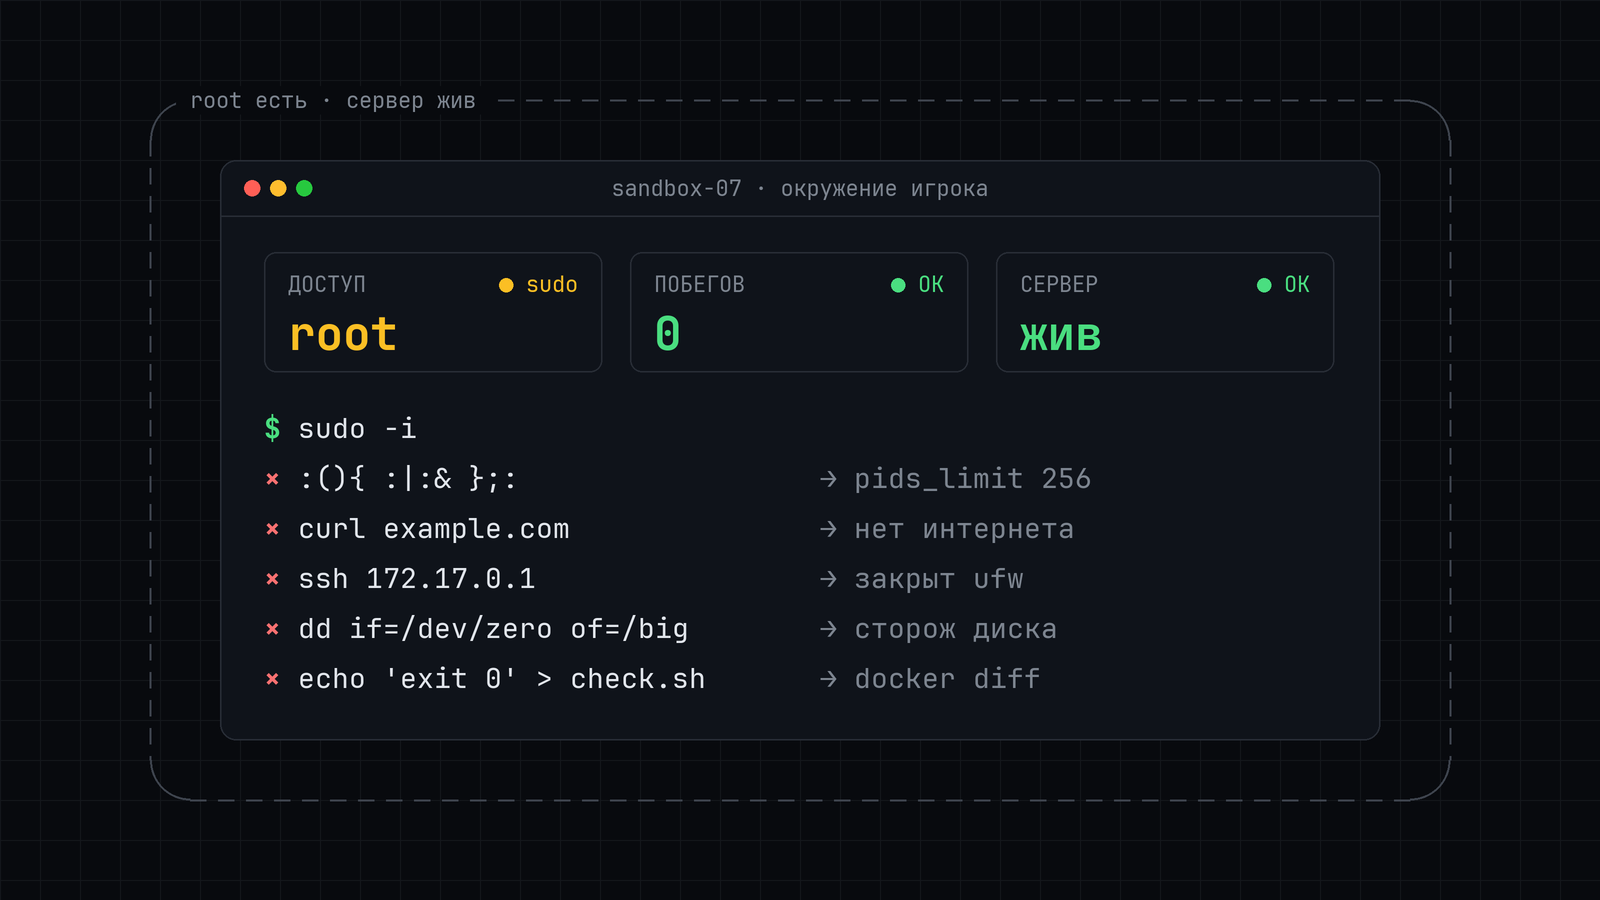
На prodisdown.ru любой посетитель за несколько секунд получает терминал в браузере. За ним — «сервер», на котором что-то сломано, и права sudo, чтобы это починить. Для первого кейса даже регистрация не нужна.
Всё это крутится на одном VPS с 3 vCPU и 6 ГБ памяти. Одновременно на нём живут до девяти таких окружений чужих людей.
Сразу честно: root у игрока — внутри песочницы, а не на самом хосте. Но песочница — это контейнер, а у контейнера с root есть много способов испортить жизнь хосту и соседям. Ниже — четыре слоя защиты, грабли, на которые я наступил по дороге, и сколько всё это стоит в железе.
Сам тренажёр я описывал в первой статье. Здесь — только про то, как раздавать shell незнакомцам и спать спокойно.
Что может сделать человек с root в контейнере
Я исходил из того, что каждый игрок рано или поздно наберёт :(){ :|:& };:. Не из злобы — просто интересно, что будет. А кто-то решит проверить, нельзя ли выбраться на хост.
Вот список, с которым я сел проектировать защиту:
Что делает игрок | Чем это опасно | Чем закрыто |
|---|---|---|
Ищет дыру в ядре или в Docker | Побег на хост — и дальше уже всё | gVisor, |
Стучится в SSH сервера изнутри | Перебор паролей в обход внешнего фаервола | Правило ufw для подсети контейнеров |
Качает майнер, шлёт спам, сканирует интернет | Абузы хостеру и бан IP | Сеть без выхода в интернет |
Лезет в окружение соседа | Ломает чужую игру | Отдельная сеть на каждый запуск |
| Сайт тормозит у всех | Квота CPU и низкий приоритет |
Форк-бомба | Кончаются процессы на хосте |
|
Съедает всю память | OOM-killer приходит за сайтом | 512 МБ без swap |
| Кончается диск, падает всё | Сторож диска |
Открывает 50 вкладок | Занимает все места на сервере | Лимиты на игрока и IP, очередь |
Подменяет проверку | Первое место в рейтинге за две команды | Скрипт проверки из репозитория и docker diff |
Дальше по слоям, снизу вверх.
Слой 1: gVisor вместо обычного runc
Обычный Docker-контейнер делит ядро с хостом. Любая дыра в ядре, доступная из контейнера, означает root на сервере. Для своих сервисов это приемлемый риск, для sudo в руках незнакомцев — нет.
gVisor ставит между процессами контейнера и ядром своё ядро в user space — Sentry. Системные вызовы игрока обрабатывает он, а до настоящего ядра доходит узкий набор вызовов. Чтобы выбраться на хост, нужны уже две уязвимости подряд.
Подключается он как ещё один runtime в /etc/docker/daemon.json:
{
  "runtimes": {
    "runsc": {
      "path": "/usr/local/bin/runsc",
      "runtimeArgs": ["--allow-suid", "--overlay2=none"]
    }
  }
}
А в коде запуска — один параметр из переменной окружения. Если gVisor что-то сломает, откат — пустая строка в .env:
if SCENARIO_RUNTIME:
    run_kwargs["runtime"] = SCENARIO_RUNTIME   # "runsc" или пусто = runc
Оба флага нашлись не из документации, а из поломок:
--allow-suid. Без него gVisor игнорирует setuid-бит, иsudoперестаёт работать. В тренажёре по чинке серверов это конец игры.--overlay2=none. По умолчанию изменения файлов остаются внутри песочницы. Тогдаdocker diffпустой, и сторож диска с защитой проверки (о них ниже) слепнут.
Поверх gVisor контейнер стартует с cap_drop: ALL. Обратно возвращаются только семь возможностей, без которых не работают sudo и сами кейсы: CHOWN, SETUID, SETGID, DAC_OVERRIDE, AUDIT_WRITE, KILL, SYS_PTRACE. Побочный эффект: без CAP_FOWNER root в контейнере может сделать chown чужого файла, но не chmod. В скриптах подготовки кейсов пришлось менять порядок: сначала chmod, потом chown.
Что сломалось под gVisor
gVisor — не Linux, а его тщательная имитация. В тренажёре, где кейсы строятся на тонкостях Linux, расхождения вылезли сразу:
Что сломалось | Почему | Как обошёл |
|---|---|---|
dnsmasq в DNS-кейсе не стартует | gVisor поддерживает только группу netlink | Прослойка через |
В кейсе про иноды иноды не кончаются | tmpfs внутри gVisor игнорирует | tmpfs монтирует Docker на хосте анонимным томом |
В кейсе про память | gVisor не считает его для процессов | Никак: на решение не влияет, живём с нулём |
Прежде чем включить gVisor на проде, я прогнал все 39 вариантов 13 кейсов под обоими рантаймами. Сценарий теста: старт → проверка не проходит → команда из третьей подсказки → проверка проходит. Без такого прогона первые две строки таблицы нашли бы игроки.
Слой 2: сеть
Каждый запуск получает свою Docker-сеть с internal=True. У такой сети нет выхода в интернет, а контейнеров других игроков в ней нет. Майнеру не достучаться до пула, сканеру — до чужих машин, игроку — до соседа.
network = client.networks.create(
    name, driver="bridge", internal=True,
    labels={"role": "scenario-network", "scenario_id": scenario_id},
)
network.connect(WEB_CONTAINER)   # веб проксирует терминал игрока
Сеть удаляется вместе с контейнером, а сборщик мусора по метке подчищает брошенные. Это важно: свободных подсетей у Docker по умолчанию всего около 30.
На бумаге всё изолировано. На деле нашлись три дыры.
Дыра 1: сайт сидит в сети игрока. Терминал проксирует веб-приложение, поэтому оно подключено ко всем сетям запусков. Значит, из контейнера можно постучаться в gunicorn напрямую, мимо Caddy, и прислать любой X-Forwarded-For. А по IP у меня считаются лимиты на вход, регистрацию и запуск окружений. Стандартный ProxyFix верит заголовку от кого угодно, поэтому я обернул его: заголовок учитывается, только если соединение пришло с адреса Caddy или с localhost.
def __call__(self, environ, start_response):
    if self.is_trusted(environ.get("REMOTE_ADDR")):
        return self.via_proxy(environ, start_response)   # ProxyFix(x_for=1)
    return self.wsgi_app(environ, start_response)        # IP = адрес соединения
Дыра 2: хост виден из любой сети контейнера. У bridge-сети есть адрес на самом сервере, а sshd слушает все интерфейсы. Игрок может стучаться в SSH сервера изнутри, и внешний фаервол хостера этого не увидит. Вход по паролю у меня и так выключен, но стучаться туда вообще не должно быть возможно. Первое правило ufw запрещает 22/tcp из подсетей Docker.
Подвох в том, что подсети Docker — это не только 172.16.0.0/12. По умолчанию он раздаёт 15 сетей из 172.17–172.31, а дальше берёт 192.168.0.0/16. Правило только для 172.16.0.0/12 работает, пока окружений мало, и молча перестаёт работать при масштабировании. Надёжнее явно задать пулы в daemon.json и закрыть фаерволом именно их:
{
  "default-address-pools": [
    { "base": "172.20.0.0/14", "size": 24 }
  ]
}
Дыра 3: Docker ходит мимо ufw. Это классика, но напомню. Порт, опубликованный через ports: "5000:5000", Docker открывает своими правилами iptables раньше, чем до них дойдёт ufw. Поэтому наружу смотрит только Caddy на 80 и 443, а веб опубликован как 127.0.0.1:5000:5000. Контейнеры игроков не публикуют ничего.
Слой 3: ресурсы
Самая частая «атака» на таком сервисе — не взлом, а обычный while true. В моём случае его запускают даже не игроки: в двух кейсах процесс, съедающий CPU, — это и есть инцидент, который надо найти. Так что лимиты тут не только защита, но и часть игры.
Ресурс | Лимит на окружение | Зачем |
|---|---|---|
CPU |
| Один игрок не заберёт весь сервер |
Приоритет CPU |
| Когда процессора не хватает, сайт получает его первым |
Память | 512 МБ, swap запрещён | OOM-killer приходит в контейнер, а не за сайтом |
Процессы |
| Форк-бомба упирается в потолок |
Логи контейнера | один файл на 5 МБ | Кейсы нарочно шумят в логи и за час забили бы диск |
Диск | 1 ГБ записи, дальше контейнер удаляется | См. ниже |
Время | 10 минут без активности, 60 минут максимум | Забытая вкладка не держит место |
Количество | 2 на игрока, 2 на IP, 10 новых с IP за 10 минут | Скрипт со свежими cookie не займёт все места |
Трюк с четвертью ядра: дашборд тренажёра показывает CPU относительно лимита контейнера. Игрок видит привычные 100%, top по-прежнему показывает виновника первым, а сервер платит за это вчетверо меньше, чем при лимите в целое ядро.
Диск: лимит, который молча не работает
У Docker есть --storage-opt size=1G. На обычном ext4 с overlayfs он ничего не ограничивает: ему нужен xfs с квотами. А один dd или fallocate в контейнере за минуту съедает весь диск — и встают база, Docker и сайт.
Переезжать на xfs ради одного флага я не стал и написал сторожа — фоновый поток в веб-приложении:
Каждые 2 секунды он смотрит свободное место через
statvfs— это почти бесплатно.Если место убыло на 256 МБ или прошло 30 секунд, пересчитывает размер контейнеров. Это дорого: Docker обходит их файлы.
Контейнер, записавший больше 1 ГБ, удаляется. Сами кейсы пишут меньше мегабайта, так что ложных срабатываний нет.
При свободных меньше 2 ГБ новые окружения не запускаются.
for info in client.api.containers(all=True, filters=SCENARIO_LABEL_FILTER, size=True):
    if (info.get("SizeRw") or 0) > CONTAINER_DISK_LIMIT:   # 1 ГБ
        stop_container(info["Id"])
SizeRw считает занятые блоки, поэтому ловит и fallocate, который ничего не пишет, а только резервирует место. И тут снова всплывает gVisor: без --overlay2=none записи не доходят до слоя контейнера, и сторож видит ноль.
Места кончаются не от атак, а от рекламы
Первая версия поднимала окружение, как только открывалась страница кейса. В день рекламы во ВКонтакте нулевой кейс открыли 148 раз — и ни разу не взяли инцидент в работу. Зато 14 запусков получили отказ: места заняли те, кто заглянул на секунду и ушёл.
Теперь так:
Окружение готовится после первого действия на странице или через 5 секунд, если вкладка видна.
Невзятое окружение живёт, пока страница опрашивает сервер. Закрыл вкладку — через 2 минуты место свободно.
Когда мест нет, сервер отвечает
503 {"queued": true, "position": N}, а страница показывает место в очереди. Очередь живёт в памяти процесса. Кто 20 секунд не спрашивал, из неё выпадает.
Слой 4: проверке нельзя верить ничему внутри
Когда игрок жмёт «Проверить», в его контейнере выполняется check.sh. Если он вернул 0 — кейс решён, очки идут в рейтинг. Но у игрока в этом контейнере sudo. Первая версия брала check.sh из самого контейнера, и решение любого кейса выглядело так:
echo 'exit 0' | sudo tee /path/to/check.shХорошо, скрипт читаем из репозитория и передаём текстом. Но он всё равно выполняется внутри и зовёт systemctl, curl, grep. Каждую из этих программ игрок может подменить. Может дописать свою библиотеку в /etc/ld.so.preload. Может поправить параметры варианта, против которых сверяется проверка.
Итоговая схема из трёх шагов:
Скрипт — из репозитория. Он уходит аргументом в
/usr/bin/bash -c. Именно/usr/bin, а не/bin: ссылку/binигрок мог бы подменить целиком.docker diffперед каждой проверкой. Если изменено что-то в/usr,/bin,/sbin,/lib,ld.so.preload,sudoersили в файлах-помощниках кейса, проверка не запускается. Сами кейсы туда не пишут, а честному решению там нечего делать.Отпечаток параметров. sha256 файлов варианта снимается, когда игрок берёт инцидент. Терминала у него в этот момент ещё нет. Перед проверкой отпечаток сверяется.
tampered = tampered_paths(container.diff(), scenario_id)
if tampered:
    return {"solved": False, "message": TAMPERED_MESSAGE.format(paths=...)}
shell, script = _check_script(scenario_id)          # из репозитория
result = container.exec_run([shell, "-c", script, "check.sh"])
Игрок видит честное сообщение: «С подменёнными программами проверке нельзя верить — сбрось кейс и реши его заново».
Заодно нашлась дыра похитрее. Одна старая проверка засчитывала решение по тексту в выводе команды, а часть этого вывода игрок контролирует сам. Правило на будущее: проверка смотрит на состояние системы, а не на строки, которые можно напечатать.
Чего это не ловит: фейковый сервис на Python, который отвечает «200 OK» вместо починенного nginx. От этого защищают только сами проверки, и чем больше они смотрят на конфиги и состояние системы, а не только на код ответа, тем дороже фейк. А человек, который написал правдоподобный фейк, проблему обычно уже понял.
Сколько это стоит в железе
Память оказалась не проблемой: окружение тратит около 70 МБ из выделенных 512. Упираюсь я в процессор. И до замера я об этом не знал: лимит на сервере стоял 6 окружений, а влезало три.
Как мерил
В админке есть кнопка «Технический перерыв»: новые игроки получают 503, а те, кто уже играет, спокойно доигрывают. На пустом сервере запускается тест внутри веб-приложения. Он добавляет окружения по одному, в той же смеси кейсов, что выбирают игроки, и на каждом шаге ждёт около 45 секунд. Останавливается на первом шаге, где случилось хотя бы одно:
свободной памяти (
MemAvailable) меньше 20%;swap вырос больше чем на 100 МБ;
процессор сервера занят больше чем на 85% по
/proc/stat;p95 ответа
/healthzбольше 500 мс;какое-то из окружений умерло.
Две метрики, которые врут
В первой версии теста нагрузку на процессор я оценивал по тому, во сколько раз замедлился короткий бенчмарк на Python. Тест остановился на двух окружениях: однопоточный бенчмарк измерял везение в планировщике, а не запас сервера. Правильный ответ оказался скучным — доля занятого времени всех ядер из /proc/stat.
А вот две метрики, на которые хочется посмотреть сначала, и которым с десятком cpu_quota верить нельзя:
Load average. Потоки, которые упёрлись в квоту и ждут своего куска времени, считаются готовыми к работе. LA растёт, хотя процессор ещё свободен.
PSI (
/proc/pressure/cpu). Доляsomeдержалась на 80–97% уже при одном окружении. Причина та же: ожидание в квоте выглядит как нехватка CPU. Как порог — бесполезно.
Результаты
Сервер | Квота «прожорливых» кейсов | Окружений до 85% CPU | Память на окружение | p95 сайта |
|---|---|---|---|---|
2 vCPU, 3,8 ГБ | 0,5 ядра | 3 | ~75 МБ | ≤ 45 мс |
3 vCPU, 6 ГБ | 0,25 ядра | 9 | ~70 МБ | ≤ 31 мс |
На старом сервере занятость CPU шла так: 31%, 61%, 74%, 90% на одном–четырёх окружениях. При этом по памяти тот же сервер спокойно держал 16 окружений без единого мегабайта в swap.
Самое интересное — цена одного окружения по кейсам, в процентах от трёх ядер:
Кейс | В чём инцидент | +CPU сервера |
|---|---|---|
База данных не отвечает | Упал PostgreSQL | 7–16% |
OOM Killer убивает процессы | Утечка памяти | 10% |
Первое дежурство | Процесс съел CPU | 8% |
Высокая нагрузка на CPU | Воркеры съели CPU | 7% |
Диск заполнен на 100% | Закончилось место | 3% |
Самым дорогим оказался кейс, в котором нет никакого прожорливого процесса. Там API раз в секунду пытается переподключиться к упавшей базе, а дашборд раз в 3 секунды снимает метрики через docker exec. На тестовой машине один только сбор метрик стоил около 11% ядра, пока страницу смотрят. Наблюдение за инцидентом обходится дороже самого инцидента.
Итог: четверть ядра вместо половины для «прожорливых» кейсов и одно дополнительное ядро превратили 3 места в 9. Лимит на сервере теперь тоже 9, а десятый игрок встаёт в очередь.
Чек-лист: если тоже хотите раздавать shell
Всё выше сжато в список, который я хотел бы прочитать до первого игрока:
Контейнеры чужих людей — под gVisor, а не под голым runc. И все сценарии прогнаны под ним до включения.
cap_drop: ALL, обратно только то, без чего не работает sudo.Отдельная
internal-сеть на каждую сессию.Если ваше приложение само сидит в этих сетях, оно не верит
X-Forwarded-Forоттуда.SSH и другие сервисы хоста закрыты фаерволом от всех подсетей Docker. Пулы адресов заданы явно в
daemon.json.Никаких
ports: "X:X"без127.0.0.1:— Docker ходит мимо ufw.Лимиты:
cpu_quotaиcpu_shares,mem_limit=memswap_limit,pids_limit, размер логов.Диск контролирует сторож по
SizeRw:--storage-opt sizeна ext4 молча не работает.У каждого окружения есть таймаут простоя и жёсткий срок жизни.
Лимиты на игрока и на IP, а когда мест нет — очередь вместо ошибки.
Окружение поднимается, когда человек правда начал играть, а не при открытии страницы.
Проверка не доверяет ничему внутри: скрипт из репозитория,
docker diff, отпечаток параметров.Вместимость измерена на настоящем сервере по CPU из
/proc/stat. Не по load average и не по PSI.
Если найдёте способ выбраться из песочницы или обмануть проверку, напишите мне в личку, а не в комментарии. Хороший отчёт об уязвимости попадёт в следующую статью с благодарностью
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.