«Дроби» находятся, «дробь» — нет: как я чинил поиск на Django
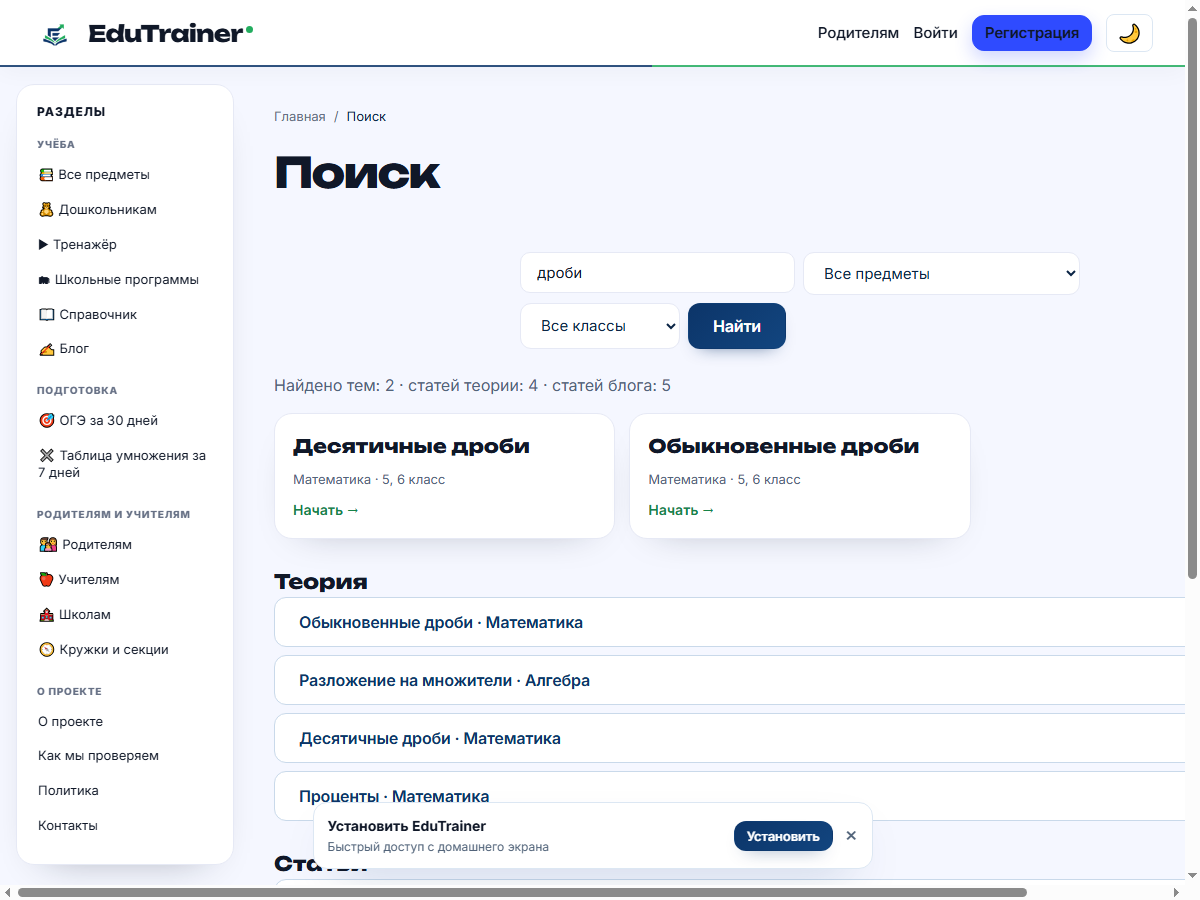
Так поиск вёл себя до исправления: по запросу «дроби» две темы находились.
Поиск по темам я сделал по принципу «лишь бы работало». Берём строку, приводим к нижнему регистру и проверяем, входит ли запрос в заголовок. Для «дроби» это работало. Для «дробь» — нет.
Первый раз я заметил это случайно. Открыл сайт, ввёл «дроби», получил две темы: «Обыкновенные дроби» и «Десятичные дроби». Потом ввёл «дробь» — и увидел:
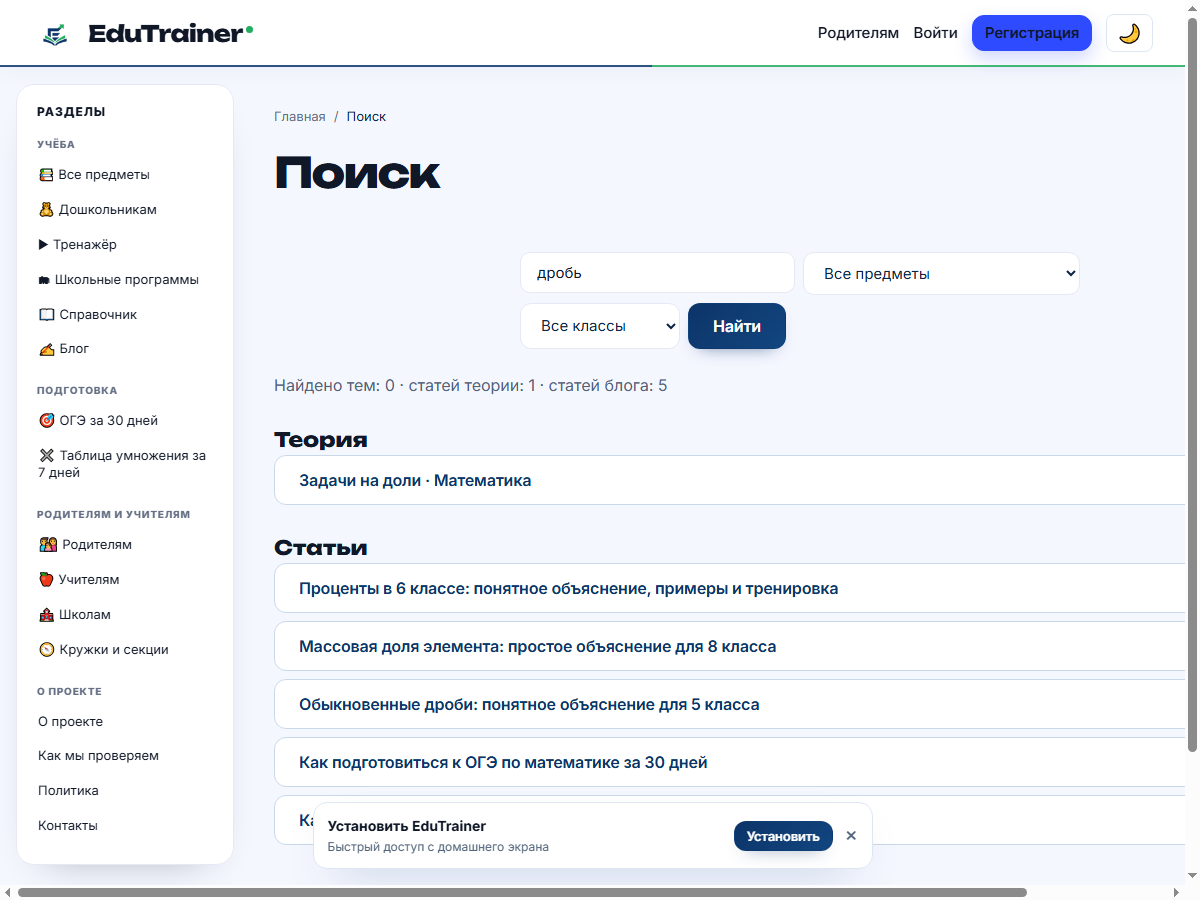
Ноль тем. При этом одна статья теории и пять статей блога почему-то нашлись.
Разница в одну букву. Для человека «дробь» и «дроби» — одно и то же слово. Для query in haystack — разные строки.
Что было в коде
Упрощённо поиск выглядел так:
python
query = request.GET.get("q", "").strip().lower()
tokens = query.split()

for topic_id, topic in TOPICS.items():
    haystack = f"{topic['title']} {topic['subject']} {topic_id}".lower()
    if not all(token in haystack for token in tokens):
        continue
    ...
Проблема не в Django и не в базе. Проблема в том, что я искал подстроку, а не слово. «Дробь» не является подстрокой «дроби»: там дроб + и, а не дробь.
С «процентами» повезло: «процент» входит в «проценты». С «дробями» — нет. С запросом «как решать дроби» — тоже нет, потому что слова «решать» в заголовке темы вообще не было.
Первая мысль: добавить исключение
Самое быстрое решение — написать:
python
if query == "дробь":
    query = "дроби"
Это работает ровно до следующего слова. «Задача» и «задачи», «функция» и «функции», «угол» и «углы» — список можно продолжать до бесконечности. Через неделю в коде появился бы словарь на двести строк, который всё равно не покрывал бы падежи.
Мне нужен был не словарь, а нормальная форма слова.
Что сделал
В проекте уже был pymorphy3 — я добавлял его для других задач. Использовал его для лемматизации:
python
@lru_cache(maxsize=16384)
def _normal_form(word):
    return _MORPH.parse(word)[0].normal_form

@lru_cache(maxsize=4096)
def search_terms(text):
    words = re.findall(r"[a-zа-яё0-9]+", text.lower())
    return tuple(sorted({
        _normal_form(word)
        for word in words
        if len(word) > 1 and word not in STOP_WORDS
    }))
Теперь «дроби», «дробь», «дробями» и «дробей» дают одну основу — дробь. «Обыкновенные» и «обыкновенных» — обыкновенный.
Сравнение стало таким:
python
def _prefix_match(term, candidate):
    if term == candidate or candidate.startswith(term) or term.startswith(candidate):
        return True
    return len(term) >= 4 and len(candidate) >= 4 and term[:4] == candidate[:4]


def terms_match(query_terms, haystack_terms):
    return all(
        any(_prefix_match(term, candidate) for candidate in haystack_terms)
        for term in query_terms
    )
Запас на префикс нужен для неполного ввода: «дроб» должно находить «дроби», пока человек ещё печатает.
И ещё один случай, который я не ожидал: pymorphy3 приводит «дроб» не к «дробь», а к «дроба». Поэтому сравнение по первым четырём буквам пришлось оставить — иначе короткий запрос снова давал ноль.
Ещё добавил список служебных слов. Без него запрос «как решать дроби» требовал, чтобы в заголовке темы было слово «решать». Его там нет — и поиск снова возвращал ноль. Теперь «как» и «решать» не участвуют в сравнении, а «дроби» находит тему.
Что получилось
После исправления тот же запрос «дробь»:
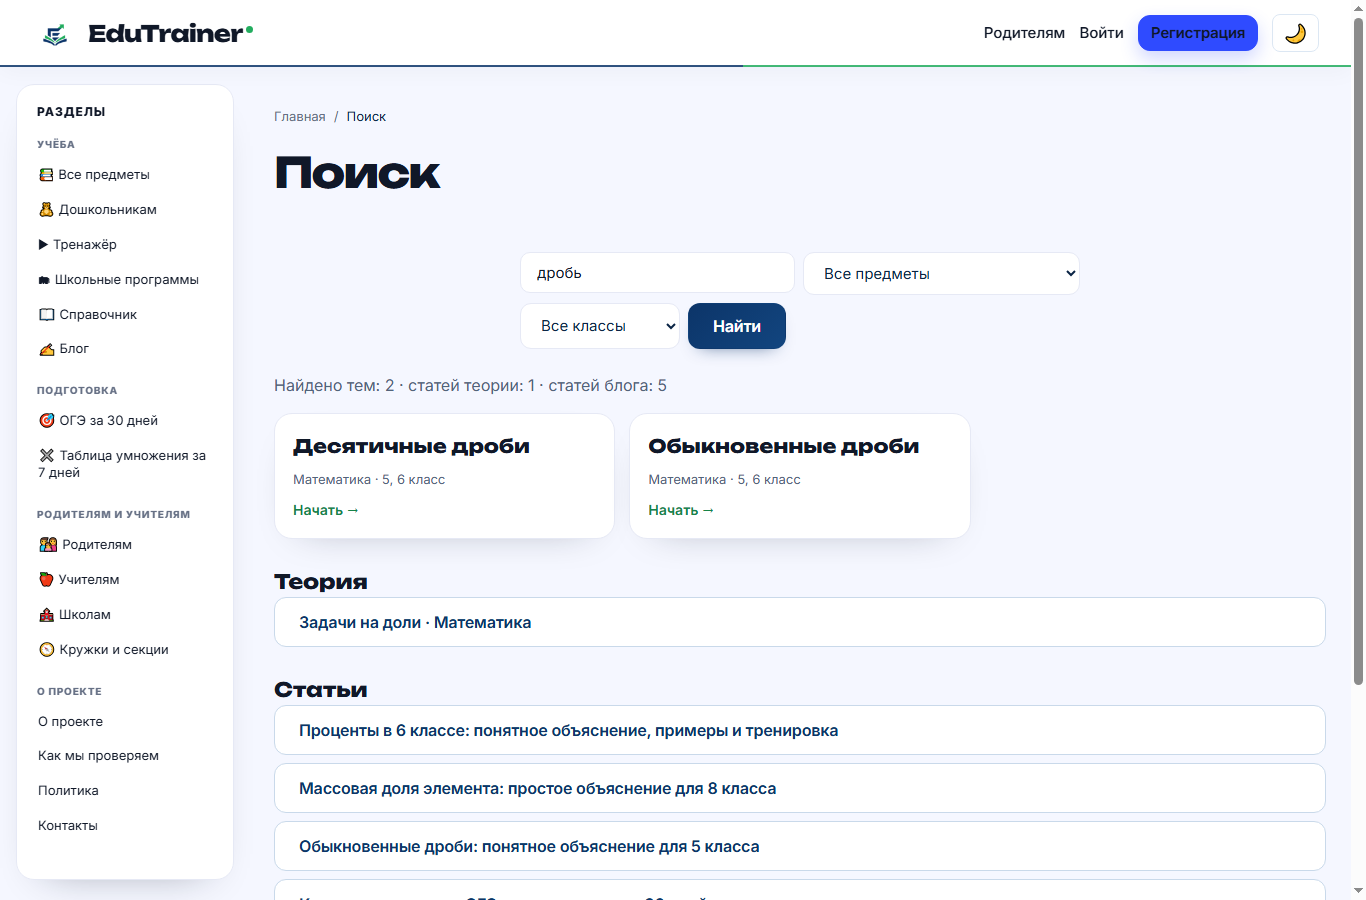
Две темы на месте. Статьи теории и блога остались прежними — их поиск я пока не трогал.
Три теста проверяют, что «дробь» находит «Обыкновенные дроби» и «Десятичные дроби», что подсказки возвращают те же темы и что «как решать дроби» не блокируется словом «решать».
Что осталось
Поиск тем стал лучше, но это всё ещё не полноценный поиск.
Во-первых, статьи теории и блога ищутся через icontains по тексту. Поэтому по запросу «дробь» в результатах есть «Задачи на доли» и статьи про проценты: они нашлись по вхождению в текст, а не по смыслу. Это отдельная задача.
Во-вторых, нет ранжирования по релевантности. Сейчас точное совпадение заголовка даёт больший вес, но это грубая эвристика, а не поисковый движок.
В-третьих, нет устойчивости к опечаткам. «Дробь» и «дробь» с опечаткой — разные запросы. Для образовательного сайта это важно: дети печатают быстро и не всегда проверяют.
Я не стал тащить Elasticsearch или отдельный поисковый сервис. Для 600 тем хватает лемматизации и кэша. Когда тем станет больше или понадобится поиск по текстам статей, вернусь к PostgreSQL full-text search. Но сначала нужно было убрать самую глупую ошибку: поиск, который не понимает, что «дробь» и «дроби» — одно слово.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.