「LFM2.5-24B-A2B」が登場、Gemma 4 26B-A4BやQwen3.6 35B-A3Bより高性能でローカルエージェントとして能力を発揮
AI開発企業のLiquid AIが「LFM2.5-24B-A2B」を公開しました。LFM2.5-24B-A2Bは自身より規模の大きなGoogle製モデルやAlibaba製モデルより高い性能を発揮し、ローカルでAIエージェントを実行させる用途に適しているとアピールされています。
LFM2.5-24B-A2B: Built for Fast On-Device Agents | Blog | Liquid AI
https://www.liquid.ai/blog/lfm2-5-24b-a2b
LFM2.5-24B-A2Bは総パラメーター数240億・アクティブパラメーター数24億5000万のMoEモデルです。33兆トークンのデータを用いて事前学習されており、追加学習によってエージェントワークフローに適した能力を獲得しています。
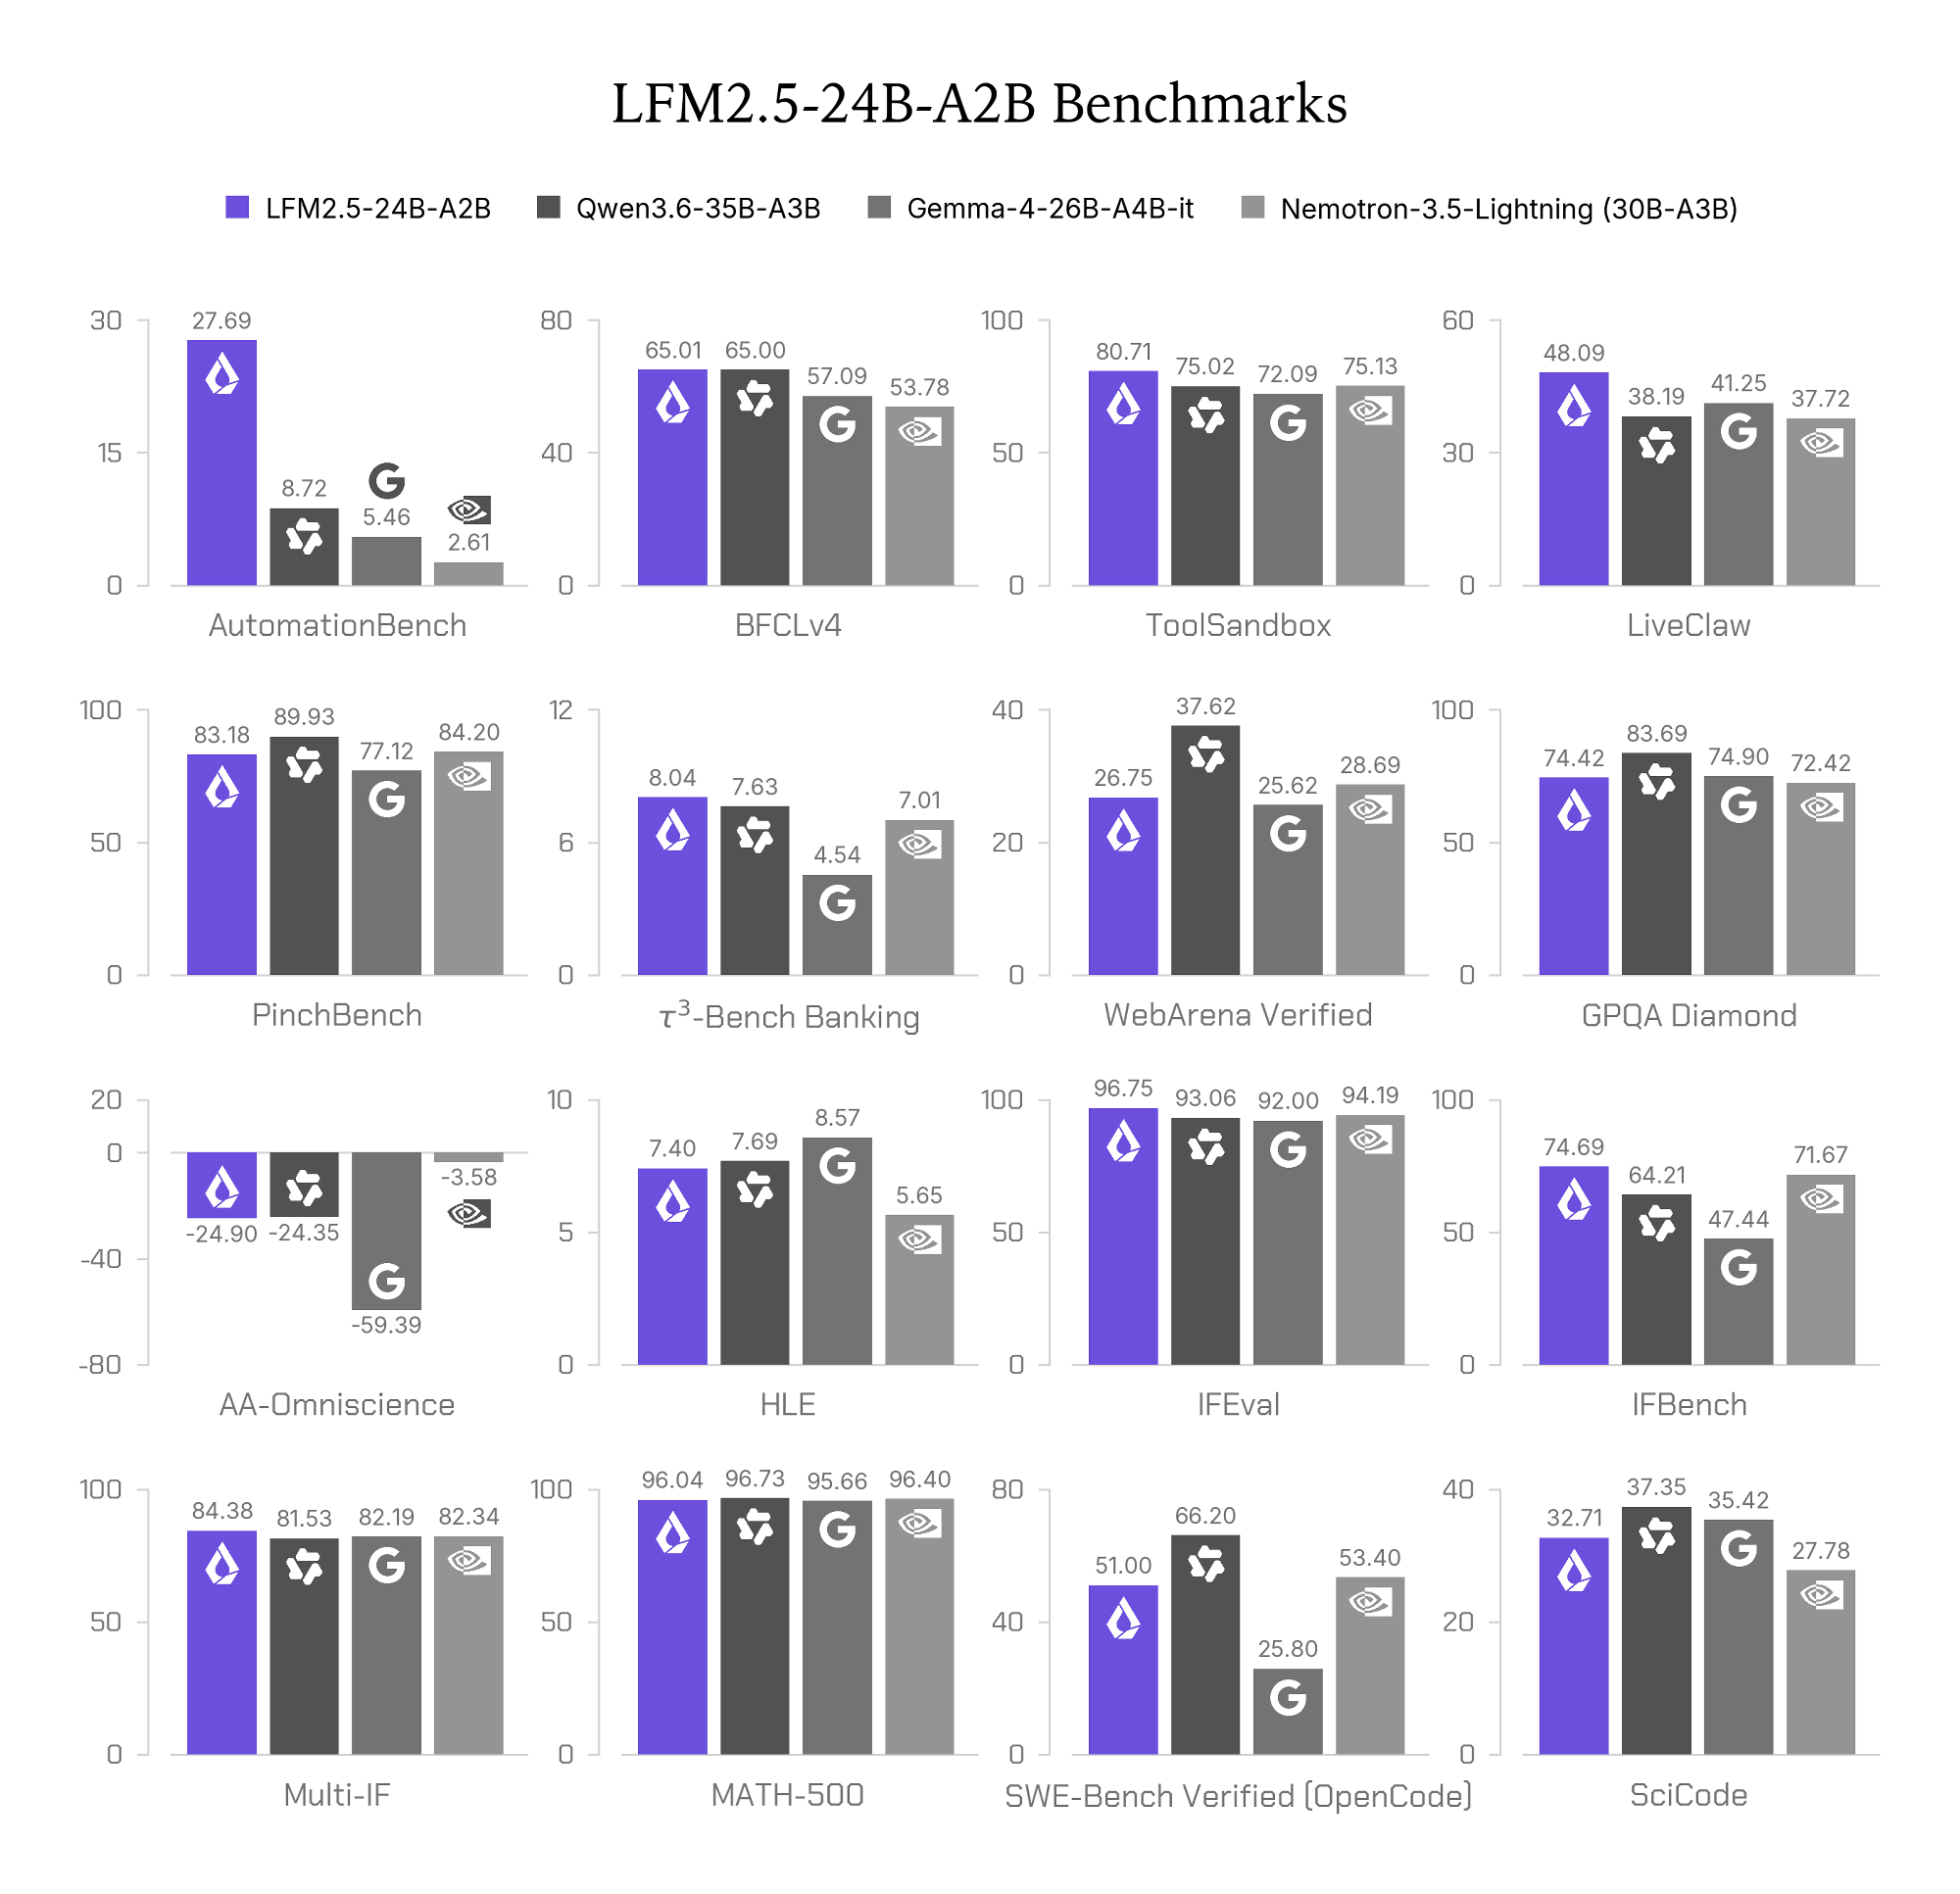
「LFM2.5-24B-A2B」「Qwen3.6-35B-A3B」「Gemma-4-26B-A4B-it」「Nemotron-3.5-Lightning(30B-A3B)」の各種ベンチマーク結果を示したグラフが以下。LFM2.5-24B-A2Bはパラメーター数で上回る競合モデルと比べて高いスコアを記録しています。特にAutomationBenchやBFCLv4といったエージェント性能を測定するテストで競合モデルを上回っていることから、Liquid AIはLFM2.5-24B-A2Bを「エージェントとって理想的な基盤となる」とアピールしています。
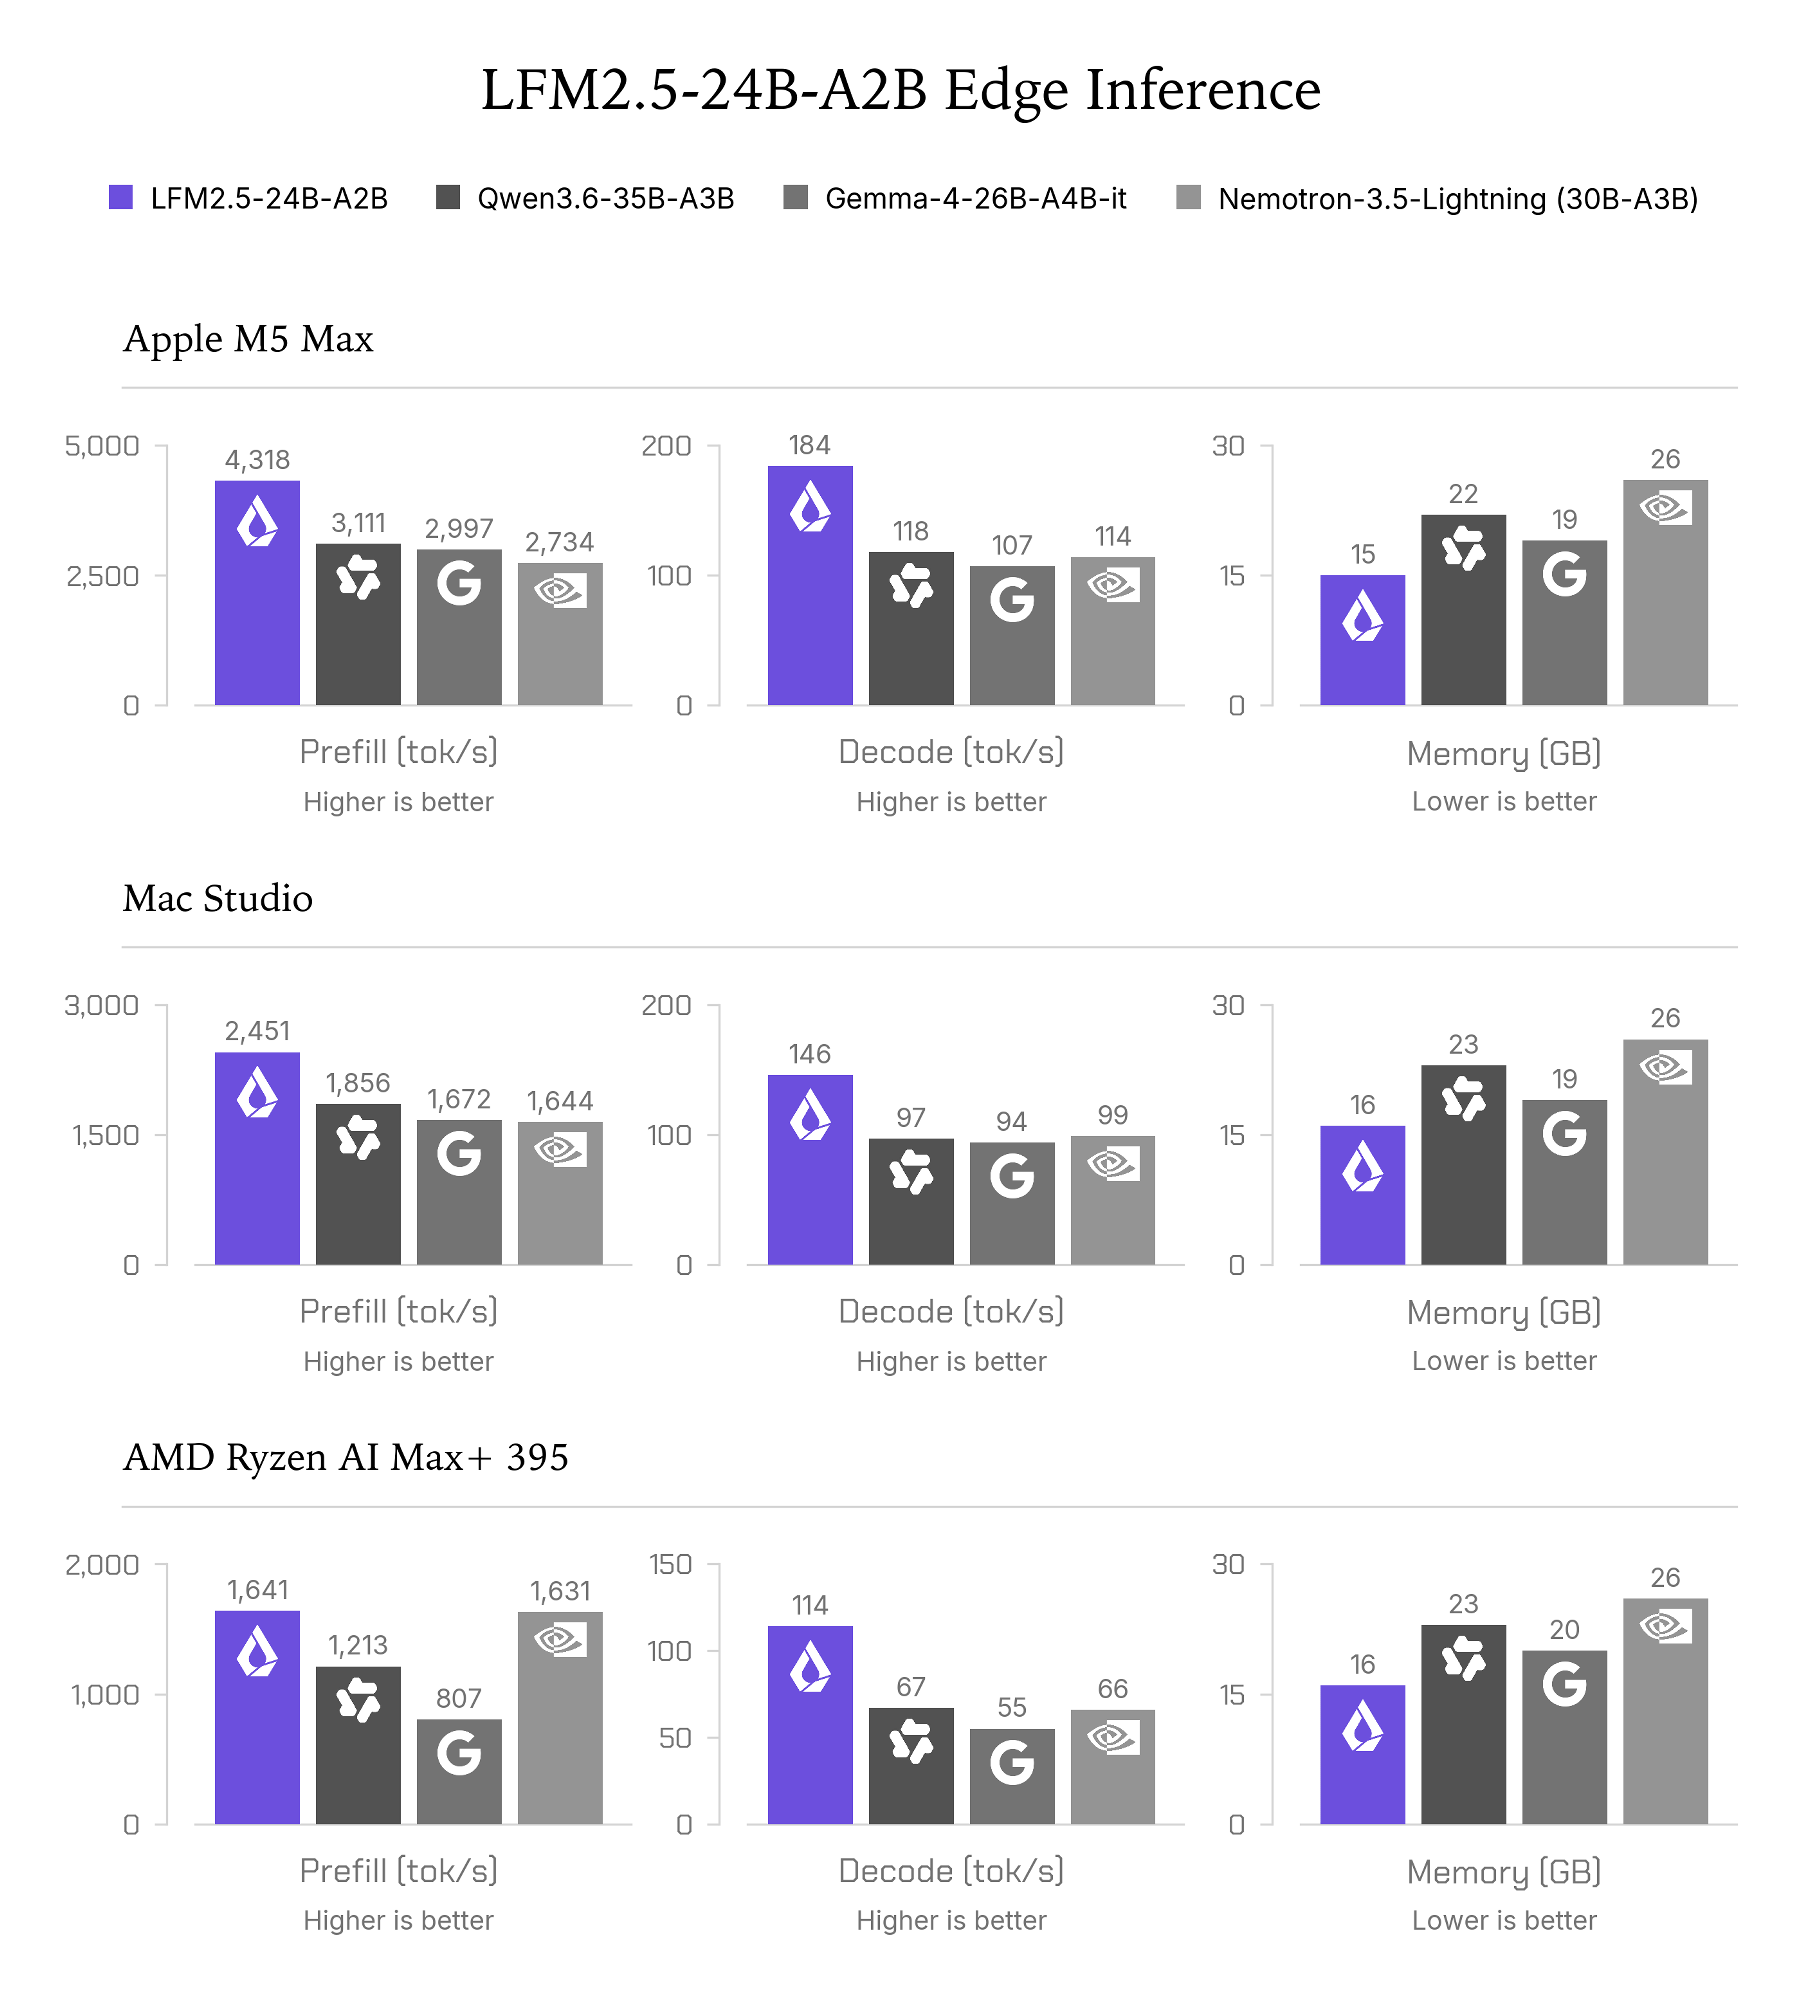
「llama.cpp」「MLX」「vLLM」「SGLang」「ONNX」が既にLFM2.5-24B-A2Bの推論に対応しており、WindowsやMacなど幅広い環境で実行可能です。各種デバイスでLFM2.5-24B-A2BのQ4_K_M量子化版を実行した結果が以下。M5 Maxを搭載したMacBook Proでは毎秒184トークンという高速なデコード処理が可能で、使用メモリは15GBでした。Ryzen AI Max+ 395を搭載したPCでも毎秒114トークンでのデコードが可能です。
M5 Max搭載MacBook ProでHermes Agentを起動し、LFM2.5-24B-A2Bを使って「Hugging Faceで話題になっているAIモデルについてのブリーフィングを作成する」というタスクを実行するデモ動画も公開されています。
— Liquid AI (@liquidai) October 13, 2026In this demo, the open-source desktop agent Hermes Agent runs on 𝙻𝙵𝙼𝟸.𝟻-𝟸𝟺𝙱-𝙰𝟸𝙱. A single laptop. Local model inference, with no cloud model API calls or model API keys. Build agents that reason and act where your data lives.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.