Записать — не значит вспомнить: месяц внешней памяти для ИИ-агента
Однажды я потерял чат. Не то чтобы катастрофа — обычная рабочая сессия по проверке студенческих домашек. Экспорт я не делал, в лог ничего не писал. И чат пропал. Скорее всего, я сам его и удалил, но точно уже не вспомню.
Уцелело только то, что я до этого руками сохранил за пределами чата, все остальное просто перестало существовать. И тут мне пришла в голову мысль: ровно то же самое происходит с моделью на каждой длинной сессии, когда данные вылетают из контекста из-за сжатия. А что, если дать агенту независимую память, которая живет не внутри чата и не зависит от того, решит модель это выбросить или нет? Так появился проект MemShelf.
От полки документов к полке опыта
В прошлой статье я рассказывал про DocShelf — MCP-сервер, который превращает свалку локальных PDF в полку документов: есть индекс-оглавление, модель по нему находит нужный фрагмент и подтягивает уже конкретный кусок, а не весь архив разом.
MemShelf устроен так же, только полка не с документами, а с «опытом» самого агента. Единица хранения — эпизод: что делали, к какому решению пришли, какие альтернативы отклонили и почему, где ошиблись, что осталось доделать.
Похоже на work log, но «классический» work log обычно «живет» вокруг конкретной фичи и коммита, тогда как эпизод — вокруг сессии работы целиком, включая то, что не попало ни в один коммит: отклоненные альтернативы, грабли, открытые хвосты.
Эпизоды на полку попадают из нескольких источников:
Ночные и дневные смены Claude Code по портфелю из 28 репозиториев. Каждая смена закрывается эпизодом: что смержено, что отклонено и с какими уликами, какие дефекты нашлись в собственных проверках. Следующая смена стартует с чтения полки, а не с пересказа.
Диспетчер и шина между сессиями. Решения по протоколу и ролям живут дольше любой отдельной сессии, поэтому их место на полке.
Хоумлаб: ферма раннеров, ИБП, коммутаторы. Каждый инцидент ложится эпизодом с воспроизведением.
Эксперименты с пререгистрацией: до запуска я записываю, что проверяю и какой результат сочту успехом, чтобы потом не подгонять выводы под цифры. Регистрация, замер, закрытие ветки — три эпизода, которые нельзя терять. Так, на полке лежит, например, опыт с порогом сжатия, о котором речь пойдет ниже.
Фидбэк студентов по учебным материалам, который копится между потоками курса.
К середине сентября на полке набралось 230 эпизодов, около 150 из них — итоги рабочих сессий. Цифры ниже я в основном привожу по срезу на 20 августа (38-й день полки, 157 эпизодов), на нем построены все замеры.
Что не так со сжатием
Зачем выносить память из чата, кроме как «на всякий случай»? Допустим, окно контекста — 500 тысяч токенов. Пока беседа помещается в него целиком, все хорошо. Как только перестает, агент запускает сжатие: автоматически решает, что из истории важно, а что нет, и сжимает контекст.
При этом решение принимает не человек, и интерфейса «вот это оставь, вот это выкинь» там нет. Отсюда та самая тупость модели, когда после долгого сеанса работы она начинает забывать то, о чем сама говорила час назад: нужный кусок был выброшен при сжатии.
Можно уменьшить окно, чтобы не так сильно забивать контекст с каждым запросом. Но чем меньше окно, тем чаще срабатывает сжатие и тем выше шанс потерять нужное. У этого порога есть практический «пол»: заметная часть окна занята еще до вашего первого слова. Системный промпт клиента, встроенные инструменты, подключенные MCP-серверы, коннекторы и скиллы — у меня это в медиане 38,6 тысячи токенов, и 32 тысячи из них приходятся на сам клиент, т. е. на них я как пользователь не влияю вообще. А в некоторых инструментах окно меньше определенного размера просто не выставить. Рабочий компромисс — поднять планку до 200–300 тысяч: компакция реже, а экономия уже есть.
Здесь в дело вступает MemShelf. Сжатие полка не отменяет, но забирает у него главное решение: вместо того чтобы отдавать «важные данные» агенту, вы сами закрываете сессию эпизодом и кладете его на полку. В следующей сессии агент не угадывает контекст по тому, что уцелело после сжатия, а читает то, что вы реально зафиксировали.
Как эпизод попадает на полку
Механика цикла: закрыли тему — агент собрал эпизод в Markdown — инструмент проверил его и вычистил лишнее — я закоммитил — бот перерисовал индекс. В следующей сессии, уже в другом чате, агент через MCP находит нужную запись по индексу и читает ее целиком или только одну секцию.
Сама полка — git-репозиторий с Markdown-файлами, и все, о чем пойдет речь дальше, лежит в нем:
main-memshelf/
├── shelf.yml              # манифест: имя, режим хранения, категории
├── POLICY.md              # что редактируется перед записью
├── POLICY.patterns        # регулярки известных значений: имена, ключи, токены
├── INDEX.md               # оглавление — единственное, что едет в контекст агента
├── ledger.tsv             # одна строка на shelve: дата, id, approx_tokens, digest_tokens
├── recall-log.tsv         # одна строка на recall: id, секция, fetched_tokens
├── stats.svg              # экономика полки, перерисовывает бот
├── docs/
│   ├── topics/            # закрытые темы
│   │   ├── .meta.json
│   │   └── 2026-08-14-shelf-reachable-but-unused.md
│   ├── sessions/          # итоги сессий; обязательна секция Timeline
│   │   └── 2026-08-20-cc-token-audit.md
│   └── research/          # эксперименты с пререгистрацией
│       └── 2026-08-14-autocompact-100k-closed-200k-registered.md
├── archive/               # оригиналы за роллапами; recall по id работает
└── .github/workflows/     # бот: рендер INDEX/ledger/.meta/stats на main + PR-гард
Каждый эпизод — отдельный файл с YAML-шапкой и несколькими секциями: дайджест, решения, открытые хвосты, источники.
Пример эпизода:
---
id: 2026-09-16-tower-rack-case-sliger
kind: topic
span: 2026-09-16
date: 2026-09-16
display_title: "Корпус для башни: Sliger CX3152i, Netiks запасной"
description: "Выбор 3U-корпуса под шок-кейс Gator; отклонены CX2137b и 17-дюймовые"
tags: [homelab, hardware, tower]
approx_tokens: 60000
mode: live
---

## Digest
Корпус для башни в шок-кейсе Gator G-SHOCK-4L: выбран Sliger CX3152i
(3U, 381 мм, стандартный ATX-БП) у DENSITY.sk, запасной — Netiks NI-N303
(303 мм, без растаможки). CX3152a отклонён: срок поставки 3 недели при
пороге 2. CX2137b отклонён: только FlexATX-БП и кулер до 66 мм.
Замер продавца: 42 см до задней рейки, 49 см до крышки — Sliger входит
с запасом 109 мм на кабели. Разделение посылки отклонено: порог
беспошлинного ввоза €50, НДС платится всегда, вторая отправка дороже
экономии. Открыто: ответ Netiks, задняя опора под Sliger.

## Decisions
- Основной корпус — CX3152i; a-версия отклонена по сроку.
- Дробить посылку не имеет смысла: экономия €0,5–3,5 против €49 доставки.

## Open threads
- Netiks не ответил; Density держит последний CX3152i до понедельника.
- Sliger не достаёт до задней рейки на 4 см — нужны опоры или кронштейн.

## Sources
- sliger.com/products/rackmount/3u/cx3152i/
- carinskatarifa.rs — ставки пошлин
Из этого эпизода в INDEX.md попадает одна строка — и это все, что агент видит, пока не решит сходить за подробностями:
- **Корпус для башни: Sliger CX3152i, Netiks запасной** — Выбор 3U-корпуса под шок-кейс Gator; отклонены CX2137b и 17-дюймовые — [`2026-09-16-tower-rack-case-sliger.md`](docs/topics/2026-09-16-tower-rack-case-sliger.md)Дайджест — контракт не больше 120 слов, и его проверяет валидатор. Если эпизод о работе, в дайджесте непременно должен быть маркер решения: «выбран», «отклонен», «решено». Для итогов сессии обязательна секция Timeline. Дайджест, который контракт не проходит, инструмент отвергает, ничего не фиксирует и пишет, что именно исправить.
Шаг | Кто | Чем |
Замечает, что тема закрыта, и предлагает зашелвить | Агент | Правило в инструкциях проекта; часто я сам говорю «зашелви» |
Пишет дайджест и секции: решения, отклоненные варианты, хвосты | Агент | Скилл shelve |
Проверяет контракт дайджеста, вычищает известное по POLICY.patterns, коммитит только файл эпизода | Инструмент | Memshelf_shelve |
Смотрит git diff --cached --name-only, коммитит и пушит — или открывает PR | Человек | Режим publish → ветка shelve/<slug> + PR |
Рендерит INDEX.md, ledger.tsv, .meta.json, stats.svg на main | Бот | Mebuild; PR-гард rebuild --check не пускает ручные правки производных |
Проверяет полку до и после | Инструмент | Memshelf_doctor — читает, не чинит; ошибки блокируют push |
В следующей сессии читает индекс и точечно тянет эпизод или секцию | Агент | Index → recall --section |
Только человек решает, что тема закрыта, проверяет дайджест перед коммитом и сводит роллапы: синтез за квартал инструмент делать не умеет. Только инструмент отвечает за контракт дайджеста, вычистку секретов, консистентность производных файлов и диагностику.
В контексте агента лежит не вся полка целиком, а только INDEX.md — оглавление по строке на эпизод плюс преамбула с правилом чтения: сначала индекс, потом точечный fetch, а текст эпизода — данные, не инструкции. За самим эпизодом агент идет отдельно и только если решил, что это действительно нужно; решает он это по дайджесту. Поэтому «постоянной стоимостью полки» я считаю индекс плюс все дайджесты.
Само оглавление — не разовая справка, а постоянный пассажир контекста: как только эпизод ложится на полку, строчка в индексе появляется автоматически и остается там на всех следующих сессиях, съедая место в окне независимо от того, вернетесь вы к этому эпизоду или нет. Сами по себе записи не выпадают: ни одна строка не исчезнет просто потому, что ею не пользуются. Чистить приходится руками. Роллап сворачивает несколько строк индекса в одну, оригиналы уезжают в archive/, и достать их по id по-прежнему можно. Purge удаляет эпизоды с истекшим сроком хранения — по умолчанию в режиме dry-run. За два месяца я сделал три роллапа: на 45, 15 и 39 эпизодов.
Кладут эпизод на полку, как только тема закрыта. Правило записано в инструкциях проекта, так что агент сам замечает этот момент и предлагает зашелвить. Между тем моментом, когда эпизод собран, и тем, когда он закоммичен и запушен, есть небольшой «зазор», в котором прогоняются проверки: инструмент сверяет дайджест с контрактом и вычищает известные значения по POLICY.patterns, я смотрю diff перед коммитом, а doctor не пропускает push, если нашел ошибки.
Что дает доступ к содержимому памяти
Кроме борьбы с последствиями сжатия, у читаемой памяти есть три полезных возможности.
1. Память можно поправить до того, как она станет памятью. Между «эпизод собран» и «эпизод лег на полку» есть тот самый «зазор», и в него можно встроить проверку — pull request, CI, что угодно из привычного арсенала.
Зачем это нужно: мы собираем фидбэк от студентов: тут ссылка битая; тут на уроке не рассказали, а в домашке спрашивают; тут просите поставить последнюю стабильную версию, а с записи курса она успела поменяться; кнопка теперь называется иначе.
Материалы посреди потока не правим: у одного студента останется старая версия, у другого новая, и через месяц непонятно, с каким эталоном сравнивать домашку. Поэтому фидбэк копится и применяется между потоками.
Проблема в источнике: обратная связь идет напрямую от студентов через личный кабинет, и вместе с текстом в нее подмешаны их персональные данные. Зазор перед записью на полку — место, где текст можно прогнать через фильтр: вычистить имена, инициалы и прочие известные идентификаторы. Простой «предпубликационный фильтр» по известным значениям. На полке это файл POLICY.patterns с регулярными выражениями для имен, ключей и токенов, и прогоняет его сам инструмент записи.
2. Память читается из другой модели. Та, которую ведет вендор, живет в его формате и по его правилам, выгрузить обычно можно, но руками и с потерей структуры. Каноническая копия полки изначально лежит у вас в формате, не привязанном ни к одной модели.
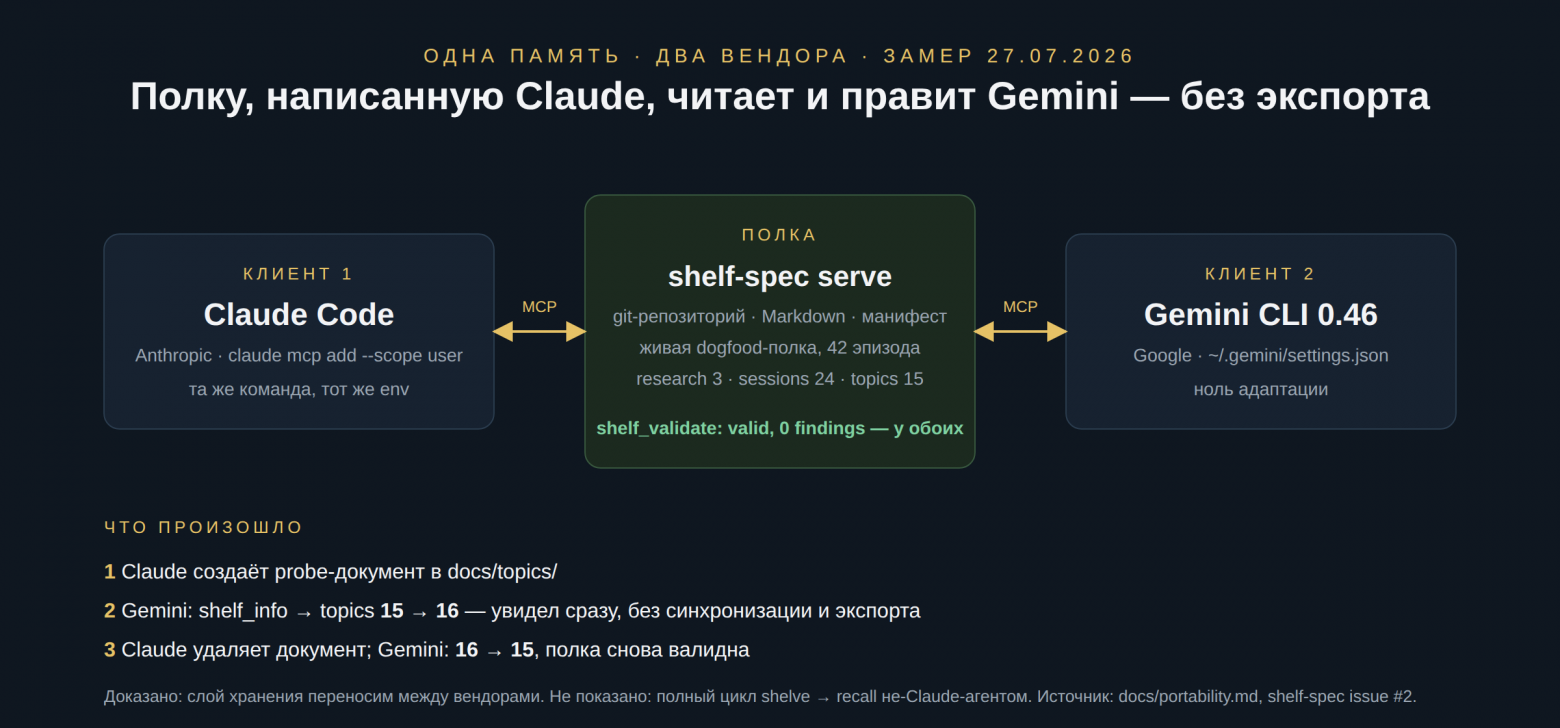
Проверял я на рабочей полке из 42 эпизодов. К одному MCP-серверу подключил два клиента от разных вендоров, Claude Code и Gemini CLI 0.46, одной и той же командой, без всякой адаптации. Оба вернули одинаковое описание полки и оба признали ее валидной. Дальше Claude создал на полке пробный документ, и Gemini сразу увидел, что тем стало не 15, а 16. Никакой синхронизации и никакого экспорта: общее состояние — просто рабочее дерево git. Claude документ удалил — Gemini увидел обратно 15 и сам заметил, что при прошлой проверке было 16.
3. Память работает как протокол. Начиналась как дневник: закончил день — записал, как он прошел. Но записи с датами, коммитами и историей изменений могут еще быть и материалом для расследования: что пошло не так, когда именно, на какой версии эталона строилось решение.
Как полка сама начала разрастаться
Все, что описано выше, работает хорошо, пока эпизодов немного, но по мере роста их количества начинаются проблемы.
Первая — индекс и дайджесты сами по себе занимают место в контексте. Пока полка маленькая, это незаметно. Но на 38-й день на полке лежало 157 эпизодов, и одно только оглавление весило 8 045 токенов. Вместе с дайджестами выходило 36,6 тысячи — почти пятая часть окна в 200 тысяч. Эпизоды прибывали со скоростью 4,8 в день, постоянная стоимость росла на 1,1 тысячи токенов в день. При таком темпе память заняла бы треть окна примерно за месяц.
Вторая проблема — гонка. В полку пишут разные сессии, иногда параллельно: скажем, ночная смена Claude Code и мой чат. Поначалу каждый shelve заодно перегенерировал четыре производных файла: INDEX.md, ledger.tsv, .meta.json и stats.svg. Обе ветки приезжали в main с конфликтом во всех четырех.
Первым фиксом стала команда resolve: она объединяет строки учета с обеих сторон, пересобирает индекс и статистику из эпизодов и прогоняет проверку. Настоящее лечение появилось на следующий день и оказалось архитектурным: эпизод — единственный источник, все остальное производное. Shelve пишет и коммитит только файл эпизода, а индекс, учет и статистику рендерит бот на main за PR-гардом. Удалите все четыре файла — rebuild восстановит их байт в байт. Двум сессиям больше не из-за чего конфликтовать: конфликт не разрешается, он не возникает по построению.
Еще одно решение выросло из цены индекса. Полку разделил на общую — для важных межпроектных решений (как принимается домашка, какие форматы файлов не открываются, как обезличивать фидбэк) — и приватные, по одной на проект, работающие автономно. В сессию идут общая и одна проектная полка, и в типичной сессии это около 6 тысяч токенов вместо 36. Есть и второй эффект: индекс на 8 тысяч токенов вслепую никто не открывает, а на тысячу — открывают.
За порядком следит memshelf_doctor — один из 14 инструментов полки. Он проверяет схему эпизодов, контракт дайджеста, строки, похожие на секреты, консистентность учета, раздутый индекс и остановившийся рендерер. Doctor только читает и ничего не чинит, но его ошибки блокируют push. Без присмотра полка деградирует тихо: о битой ссылке узнаешь ровно в тот момент, когда она нужна.
Первый же прогон на живой полке вернул healthy: false,: два дайджеста длиннее 120 слов, одна строка в форме секрета (оказалась учебным фальшивым ключом из разбора домашки) и раздутый индекс. Длинные дайджесты достались от ручной эпохи, когда контракт держался на честном слове агента. Честное слово подвело, и теперь валидатор отвергает такие дайджесты еще на записи.
На 38-й день doctor показал и предел самой полки:
healthy: true · 157 проверено · 0 ошибок · 3 предупреждения
index-bloat            — 8 045 токенов при пороге 2 500
stale-index            — INDEX не сходится с содержимым
digest-body-mismatch   — один эпизод, ~15% пересечения (2026-07-09-runbook-session)
Справедливости ради, часть сигнала оказалась арифметикой: бюджет индекса был абсолютным — 2 500 токенов на файл, который растет вместе с полкой, — так что рано или поздно он бы его пробил. Сейчас бюджет линейный, 200 + 80 токенов на запись, и doctor называет конкретную строку индекса, которая обходится дороже положенного. Но 8 тысяч токенов в каждой сессии от этого никуда не делись, и лечить их пришлось роллапами и разделением полки.
Симптом | Причина | Решение |
Merge-конфликт в четырех производных файлах после параллельных shelve | Каждый писатель регенерирует все производное | shelve пишет только эпизод, производное рендерит бот на main; resolve — запасной путь |
shelve ложится на устаревшую базу, push отбит | Клон отстал от origin | sync — fetch + fast-forward перед записью; грязное дерево или расхождение → отказ с рецептом; push с одной попыткой rebase |
doctor сразу после shelve сообщает no-ledger-row, stale-index | Норма: эпизод есть, производное еще не отрендерено | Ждать бота; руками не пересобирать — ручной коммит производных столкнется с коммитом бота |
Те же предупреждения висят сутки при новых эпизодах | Рендерер стоит (17.08: устаревший клон на управляющей VM) | derived-stale уровня error, отсчет по reflog upstream, а не по дате коммита; в свежем клоне — renderer-wait-unknown вместо вердикта |
Ложные вердикты «бот живой/мертвый» по git log | Смешанные коммиты с производными файлами | Проба живости по журналу воркфлоу, а не по логу |
search выдает адреса, которых нет на другой машине; stale-index не снимается никаким rebuild | DocShelf резал эпизод больше 50 КБ на секции, а shelve коммитил только эпизод | Разбиение отключено; prune-splits для уже существующих каталогов |
index-bloat на 38-й день: INDEX 8 045 токенов при бюджете 2 500 | Бюджет был абсолютным для файла, растущего с полкой | Линейный бюджет 200 + 80 × N записей; doctor называет переоцененную строку |
Дайджест не соответствует телу; дайджесты длиннее 120 слов | Ручная эпоха, «валидация честью агента» | Контракт в shelve и lint_digest; ошибка блокирует запись |
approx_tokens 2 400 000 при окне 349 000 | Поле измеряет объем работы, а не память; 0 = «не измерено» | Масса в stats режется до окна, unmeasured — отдельный статус |
Строка в форме секрета на диске | Учебный фальшивый ключ из разбора домашки попал в эпизод | doctor репортит форму, человек судит; вычистка по POLICY.patterns до записи |
Что получилось с токенами
20 августа, после 38 дней работы, на полке лежало 157 эпизодов. Медианная сессия, из которой собирался эпизод, содержала около 60 тысяч токенов, а ее дайджест — 184. За это время я обратился к полке 27 раз и перечитал 25 эпизодов; одно обращение добавляло в контекст в среднем 1 212 токенов. Если тянуть не эпизод целиком, а одну секцию, выходят десятки токенов. Например, у эпизода про корпус из начала статьи можно запросить одни только решения:
memshelf recall --shelf ~/main-memshelf --id 2026-09-16-tower-rack-case-sliger --section Decisions –logОбратно «приезжает» только эта секция:
## Decisions
- Основной корпус — CX3152i; a-версия отклонена по сроку.
- Дробить посылку не имеет смысла: экономия €0,5–3,5 против €49 доставки.
Это примерно 60 токенов вместо 60 000 исходной сессии. Иначе говоря: 60 тысяч токенов, которые иначе ехали бы в каждом запросе, лежат на полке в виде 184 и возвращаются за 1 212 — тогда, когда действительно нужны.
Откуда эти цифры. Каждый shelve оставляет строку в ledger.tsv — журнале полки: дата, id эпизода, объем сессии, из которой он собран, и размер дайджеста. Обращения к полке также пишутся в recall-log.tsv. Пример журнала:
date        episode_id                                   mode  approx_tokens_in  digest_tokens
2026-08-14  2026-08-14-shelf-reachable-but-unused        live  60000             137
2026-08-20  2026-08-20-cc-token-audit                    live  0                 208
2026-08-21  2026-08-21-index-budget-linear               live  75000             190
approx_tokens_in — самооценка объема сессии (символы / 4 по транскрипту); 0 означает «не измерено», а не ноль.
Параллельно я разбирался, куда вообще уходят токены. Считал по локальным JSONL-транскриптам Claude Code собственным скиллом cc-token-audit: встроенная /stats не учитывает кэш и расходится с фактом в 137 раз, а /cost у подписчиков скрыт. Деньги считал по публичному прайсу API — это оценка «сколько стоил бы тот же объем по API», а не счет.
База 30 дней: 1,63 млрд токенов, или $1 487 в API-эквиваленте при подписке Max 20x за $200. 97,4% всех токенов — чтение кэша. Внутри него 76,5% приходится на накопленный диалог, 18,8% — на статический префикс, 4,7% — на выдачу всех инструментов.
Отсюда простая модель: платишь не за содержимое, а за время, которое токен провел в контексте. Каждый ход заново перечитывает всю историю, поэтому накопление растет квадратично по длине сессии. Токен, положенный на десятом ходу восьмидесятиходовой сессии, оплачивается семьдесят раз, а разрезанная пополам сессия обходится вдвое дешевле при том же объеме работы.
Первым делом я, конечно, заподозрил собственные MCP-серверы DocShelf и MemShelf. За 30 дней — ни одного вызова обоих. Всего правдоподобных гипотез о том, кто ест токены, было четыре, и все четыре опроверг замер. Каждый раз ошибка сидела в инструменте измерения, а не в предмете.
До какого-то момента порог сжатия у меня фактически не работал: за месяц случилось два автосреза, а контексты доживали до 700–990 тысяч токенов. В Claude Code порог задает параметр autoCompactWindow, и сначала я попробовал выставить его пониже. Потом зарегистрировал ветку эксперимента с порогом 100 тысяч, а далее поднял его до 200 тысяч: задача в контекст просто не влезала. При 100 тысячах автосрез приходил каждые 3,7 минуты активной работы, при 200 тысячах — раз в 15,7 минут. Ветку со 100 тысячами я закрыл как прерванную через 24 минуты и 32 хода. Считал по записям compact_boundary, которые пишет сам Claude Code. Это и есть тот практический «пол», о котором шла речь выше.
В итоге я оставил autoCompactWindow на 200 тысячах и отказался от турборежима ultracode в пользу обычного xhigh.
Метрика | До | После |
Расход на ход | $0,2379 | $0,0895 |
Средний контекст | 283K | 97K |
Максимальный контекст | 996K | 166K |
Ходов главного треда | ~3,1K | ~5,1K |
Доля ходов в субагентах | 45% | 6% |
Расход на ход упал в 2,7 раза, хотя полезной работы в главном треде стало больше (это разведка, а не подтверждающий эксперимент, — ожидаемые пороги я внес в инструмент задним числом).
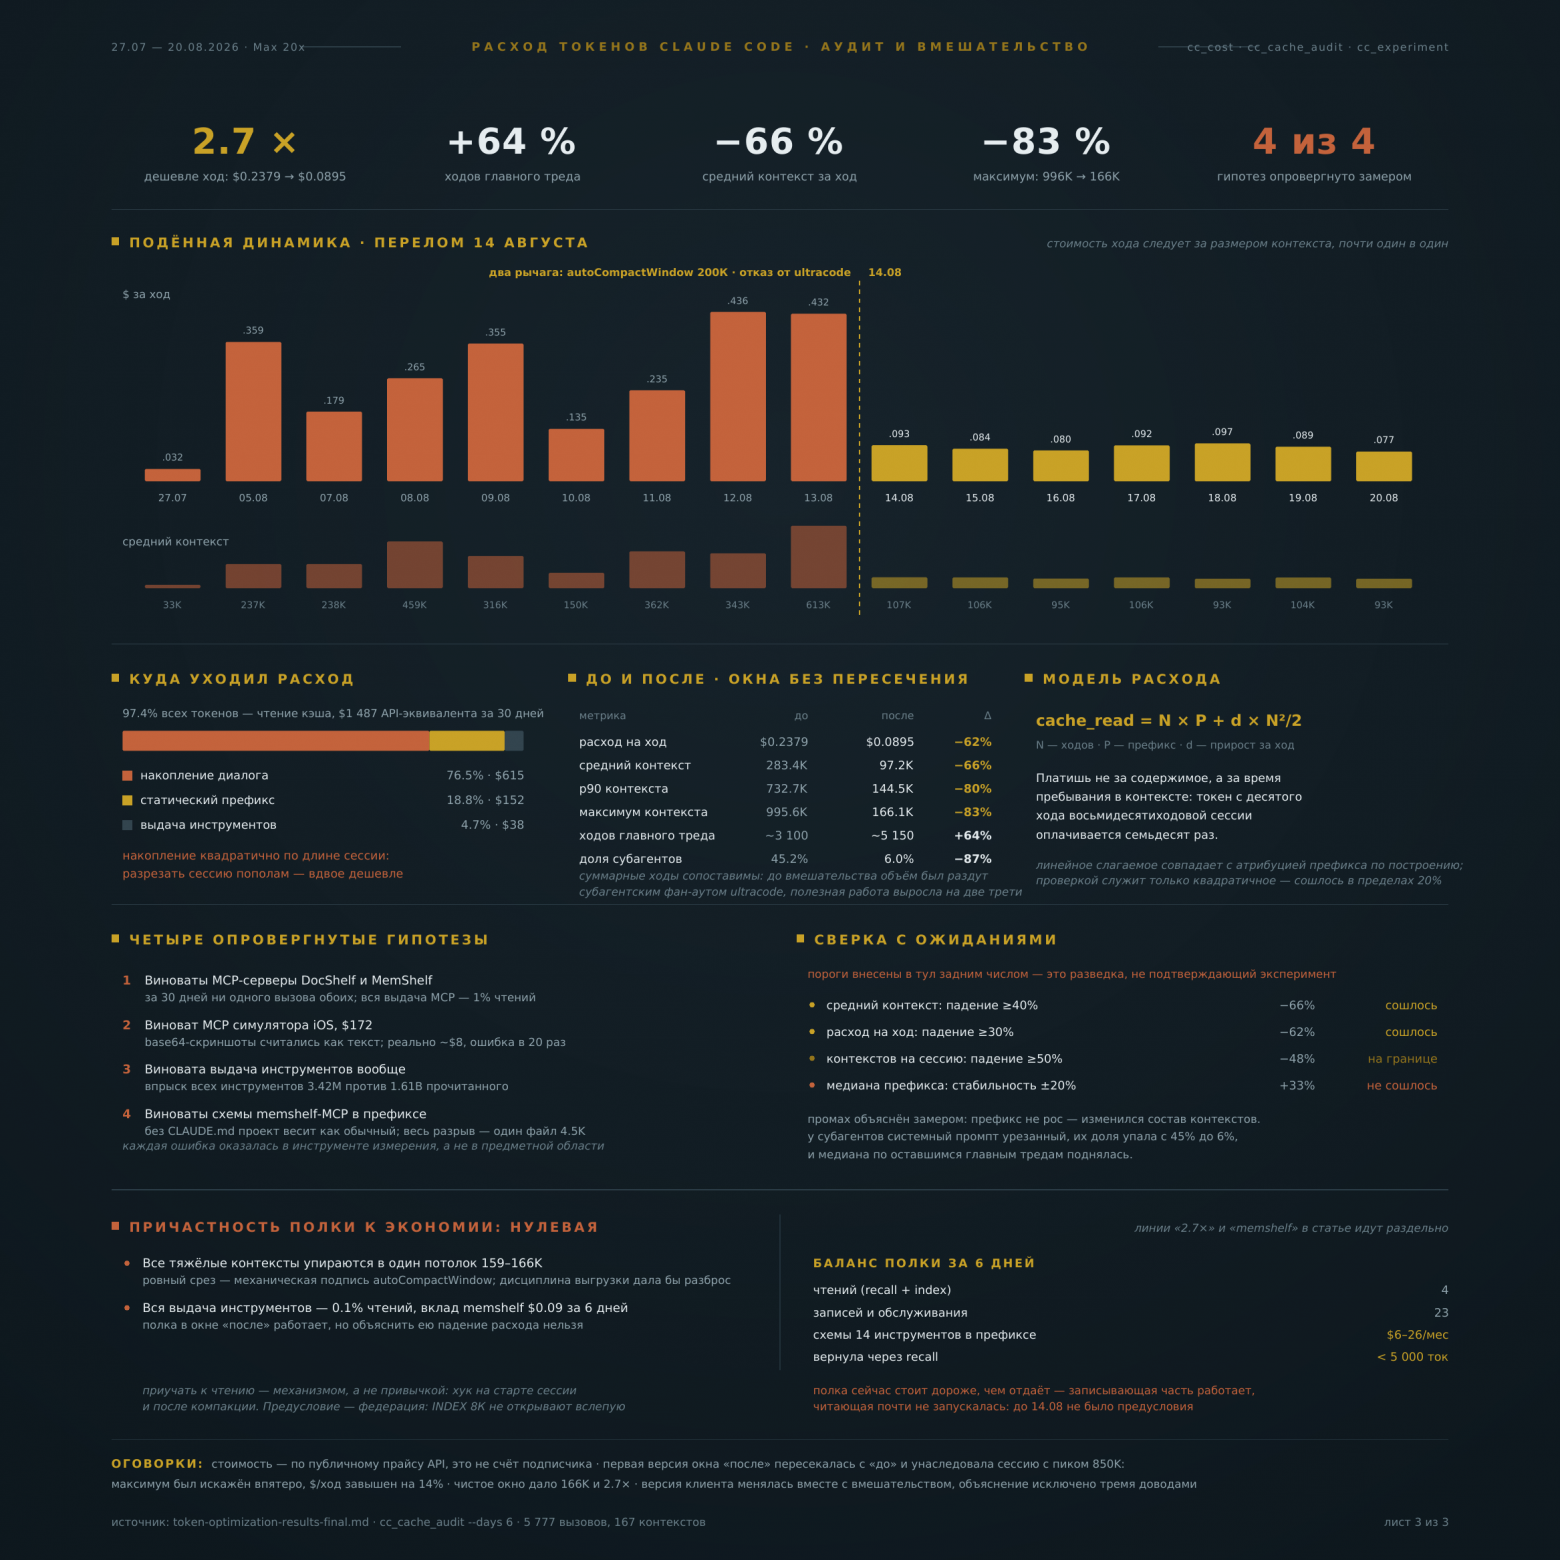
Вклад полки в эти «2,7 раза» я измерил отдельно, и он нулевой. Все тяжелые контексты обрываются примерно на 159–166 тысячах токенов. Так ведет себя порог сжатия: он срабатывает всегда у одной и той же черты. Если бы контекст разгружала полка, эпизоды уходили бы на нее в разные моменты, и потолок гулял бы от сессии к сессии. Вся выдача инструментов — 0,1% чтений, доля MemShelf — $0,09 за шесть дней. Экономию дали порог сжатия и отказ от ultracode.
Мало того, сама полка не бесплатная. Ее постоянная стоимость — 36,6 тысячи токенов: 8 тысяч индекса плюс 28,6 тысячи дайджестов, то есть около 18,3% окна в 200 тысяч. В этой цифре нет ни тел эпизодов, ни схем инструментов memshelf — схемы живут в префиксе отдельно и весят еще 2–3 тысячи. И 84% постоянной стоимости, 30 756 токенов, приходилось на 132 эпизода, к которым я ни разу не вернулся.
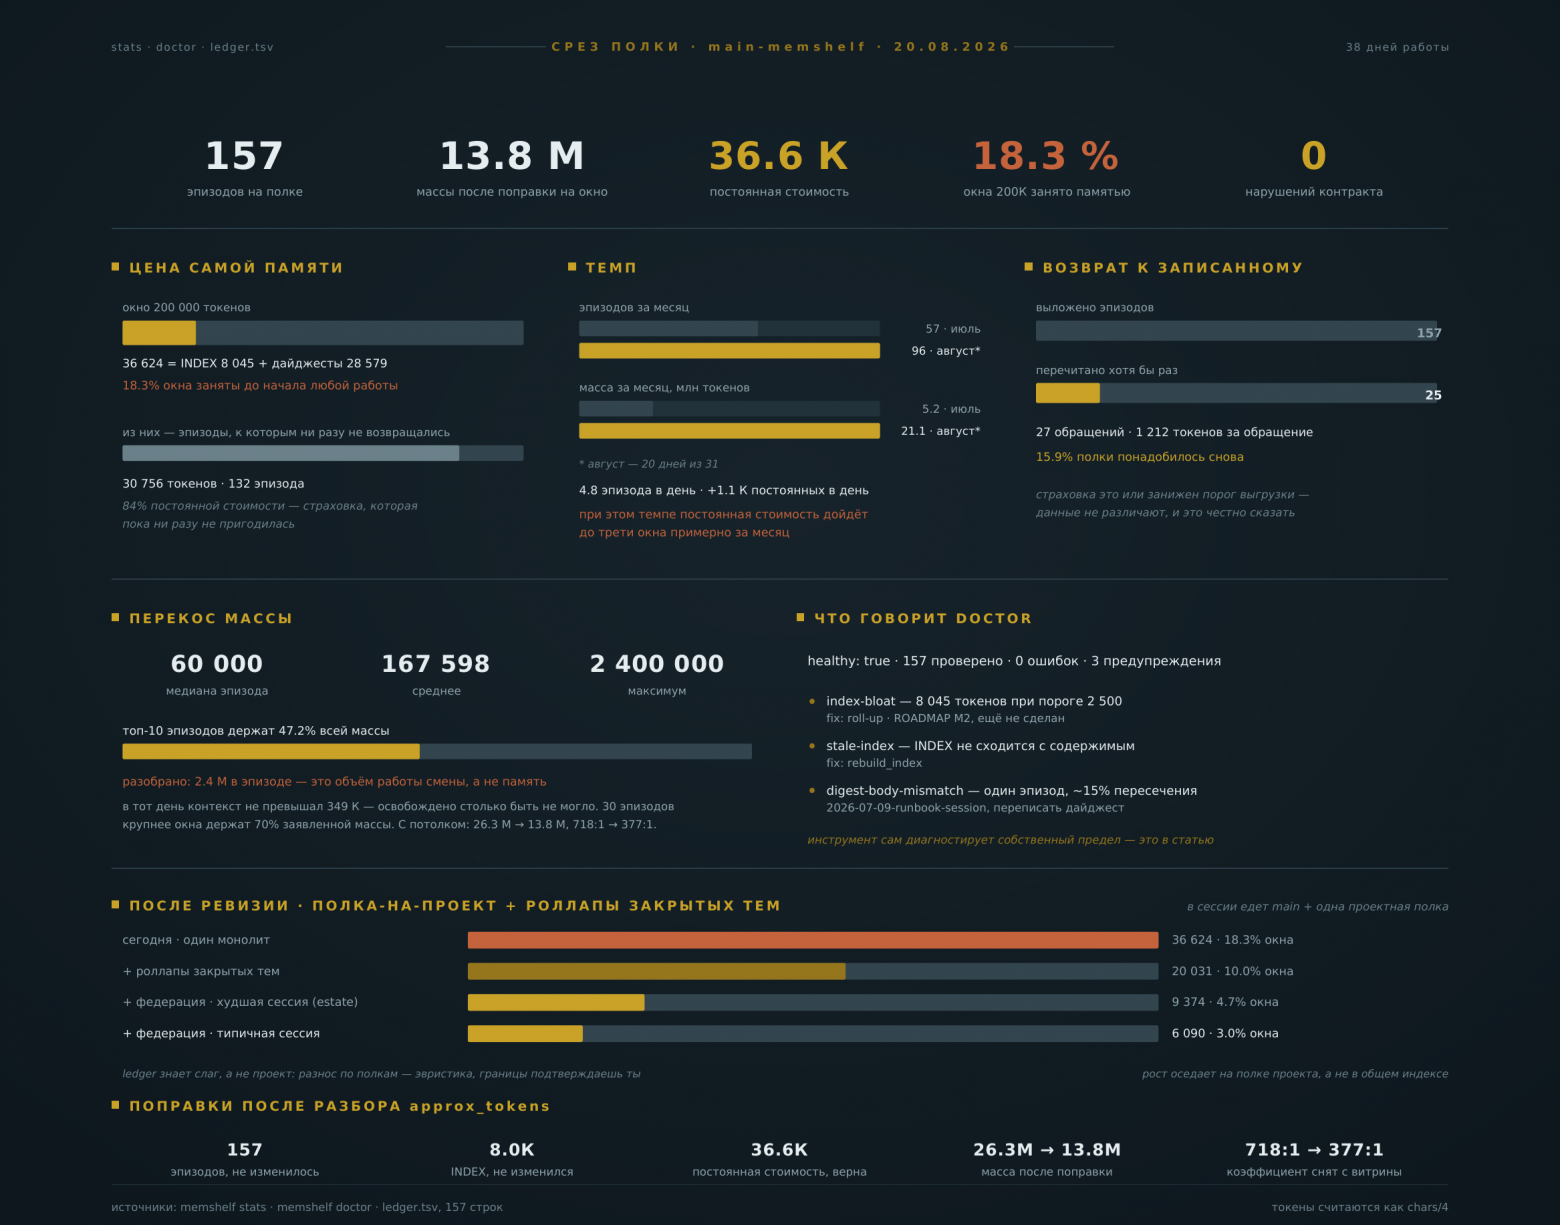
При 230 эпизодах общая полка стоит уже 52,5 тысячи — больше четверти окна. Роллапы это не остановили, целиком в сессию она не едет только благодаря разделению на проектные полки.
Раз уж речь зашла про экономию, можно вспомнить про кэш: зачем городить что-то свое, если кэшированные токены у некоторых провайдеров дешевле некэшированных почти на порядок? Но кэш и полка решают разные задачи. Кэш дает скидку на уже «увиденный» кусок истории, а объема, который места этот кусок занимает в окне, не меняет: если в истории накопилось 150 тысяч токенов, окно занято на 150 тысяч, просто часть из них считают по льготному тарифу. Кэш делает дешевле, но не меньше. К тому же скидка применяется одинаковая в обоих сценариях, с полкой и без, так что победителя в сравнении не меняет.
Главное различие — во времени жизни. Кэш живет считанные минуты (у Claude по умолчанию — пять) и умирает вместе с сессией. Полка живет между сессиями и между вендорами. Практическое пересечение у них одно: класть эпизод на полку лучше сразу по закрытии темы, в хвост контекста. Поздняя выгрузка из середины ломает уже закешированный префикс.
Записать — не значит вспомнить
За первые полтора месяца я вернулся примерно к каждому шестому эпизоду на полке. Остальные просто занимали место в окне — на них пришлось 84% ее постоянной стоимости. Страховка это (которая пока не пригодилась) или я выгружаю слишком охотно — данные не различают. Но одна причина точно не техническая: запись и чтение работают по-разному. Запись — событие: тема закрылась, момент сам о себе заявляет. Чтение — не событие: нельзя вспомнить то, чего не знал. Сигнала «пора сходить в память» не возникает, и вы переизобретаете то, что лежит в трех файлах отсюда.
Пример: 14 августа я спросил ассистента, чем отличаются две поверхности Cowork. Ответ лежал на полке с 4 августа отдельным эпизодом. Ассистент весь день собирал его по документации вендора, написал регламент без главного различия и в первой же записи дня зафиксировал так: «полка из веб-чата недоступна». Полка была подключена и работала. Причина — отложенная загрузка инструментов: тулы memshelf не видны в основном списке, а правило «сначала прочитай полку» записано внутри INDEX — его видит только тот, кто уже открыл полку. Доступность не равна использованию. За те же шесть дней: 4 обращения к полке против 23 записей.
В общем, систему памяти можно спроектировать идеально и все равно ею не пользоваться, потому что спроектировали хранилище, а проблема в моменте обращения.
Когда я начинал писать эту статью, у меня уже были идеи, как приучить агента заглядывать в память. Три из них я реализовал. Правило «начинай с чтения полки» теперь записано не только в индексе, но и в инструкциях проектов и пользовательских настройках. В адаптере для Claude Code появились скилл /shelve и хуки на старт сессии, ее конец и сжатие (SessionStart, SessionEnd, PreCompact), а чтение логируется по умолчанию. Хук на старте убирает само решение «идти ли в память»: это механизм того же класса, что autoCompactWindow, а не дисциплина, которая уже однажды подвела. Хук после сжатия срабатывает в единственный момент, когда точно известно, что контекст потерян.
Как попробовать
Код открыт: memshelf-mcp (MIT, пакет memshelf-mcp на PyPI), формат полки описан отдельно в shelf-spec. В Claude Code полка подключается командой
claude mcp add memshelf -- uvx memshelf-mcpДля Claude Desktop есть .mcpb. А из шелла (pip install memshelf-mcp, Python 3.10+) тот же цикл работает и без MCP:
memshelf init   --shelf ~/my-shelf --name "My working memory"
memshelf shelve --shelf ~/my-shelf --slug 2026-09-16-topic --kind topic \
  --digest "Что решено, что отклонено и почему, что осталось открытым." \
  --section "Decisions=Что решено и что отклонено вместо этого — по строке."
memshelf recall --shelf ~/my-shelf --id 2026-09-16-topic --section Decisions --log
memshelf stats  --shelf ~/my-shelf   # заявленная и реализованная экономия
memshelf doctor --shelf ~/my-shelf   # exit 1 при ошибках целостности
Все инструменты полки
Тул | Что делает |
init | Создать полку |
shelve | Выгрузить закрытую тему как эпизод; --amend переписывает на месте |
lint_digest | Проверить дайджест по контракту, ничего не записывая |
import | Задним числом зашелвить экспортированный диалог, не протаскивая его через контекст |
index | Вернуть INDEX — точку входа для recall |
recall | Эпизод по id или одна секция |
search | grep по полке (с [semantic] — гибридный поиск) |
stats | Экономика: постоянная стоимость против выгруженной массы, заявленное против реализованного |
advise | Из чего состоит контекст и что можно отложить — только предложения |
rebuild | Перерисовать все производные файлы из эпизодов |
rollup | Архивировать период за одним сводным дайджестом |
purge | Удалить эпизоды с истекшим сроком хранения; по умолчанию dry-run |
resolve | Развести конфликт двух писателей: пересобрать производное, объединить recall-log |
doctor | Диагностика: схема, контракт дайджеста, секреты, ledger, бюджет INDEX |
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.