アメリカ産のAIでオープンモデル「Ripple-65B Preview」登場、パラメーター数10倍の大型モデルを上回る性能で開発費は10分の1
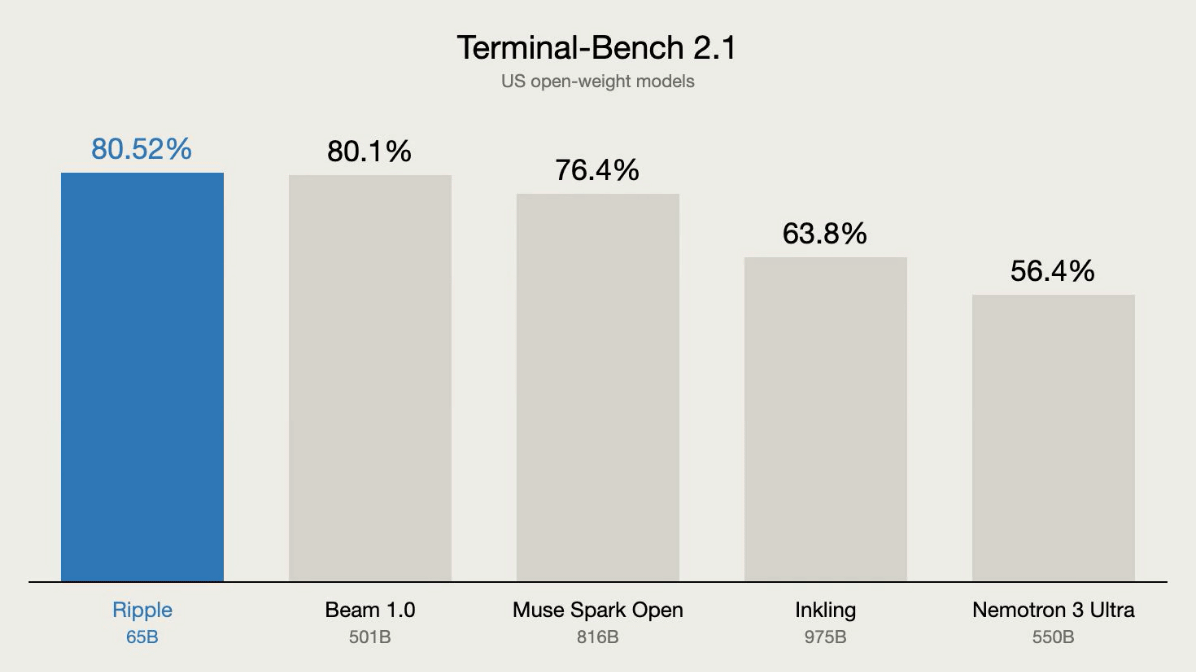
AIを使用してシリコンチップを設計する再帰的自己改善に取り組むアメリカのスタートアップ「Ricursive Intelligence」が、アメリカ産のオープンウェイトモデル「Ripple-65B Preview」をリリースしました。Ripple-65B Previewはエージェント型コーディングのベンチマーク「Terminal-Bench 2.1」で80.52点を記録し、より大規模なAIモデルを上回ったと報告されています。
Ripple-65B Preview, a Frontier Open-Weight Model | Ricursive Intelligence
https://www.ricursive.com/ripple
Ripple-65B Previewは12兆トークンで事前学習されており、最大1Mのコンテキスト長をサポートしています。Ripple-65B Previewはエージェントコーディングで優れた結果を示し、 TerminalBench 2.1でアメリカのオープンウェイトモデルにおける最先端である「80.52」のスコアを達成しました。
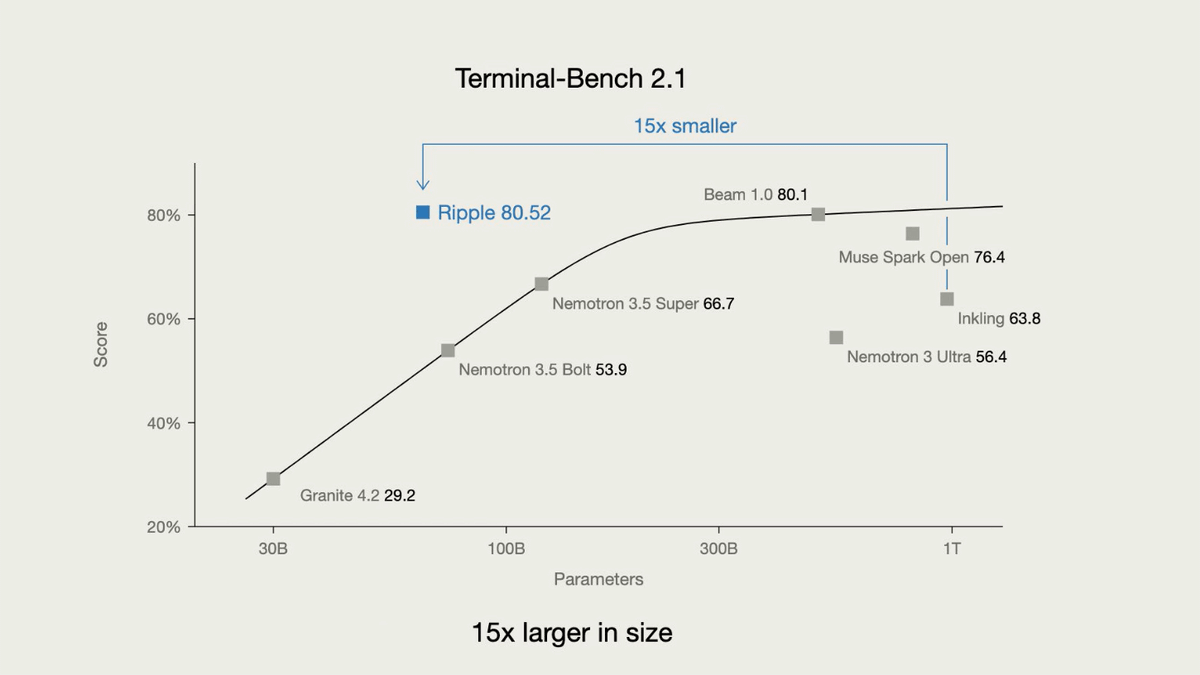
以下は横軸がパラメーター数、縦軸がスコアを示したグラフ。5010億パラメータの「Beam 501B」はスコア「80.1」、Metaの8160億パラメーターのオープンウェイトAI「Muse Spark Open」はスコア「76.4」、約1兆パラメーターの「Inkling 975B」はスコア「63.8」です。一方で、Ripple-65B Previewのパラメーター数は650億でありながら、パラメーター数ではるかに大規模なアメリカ産オープンウェイトモデルを上回るスコアを発揮したと報告されています。
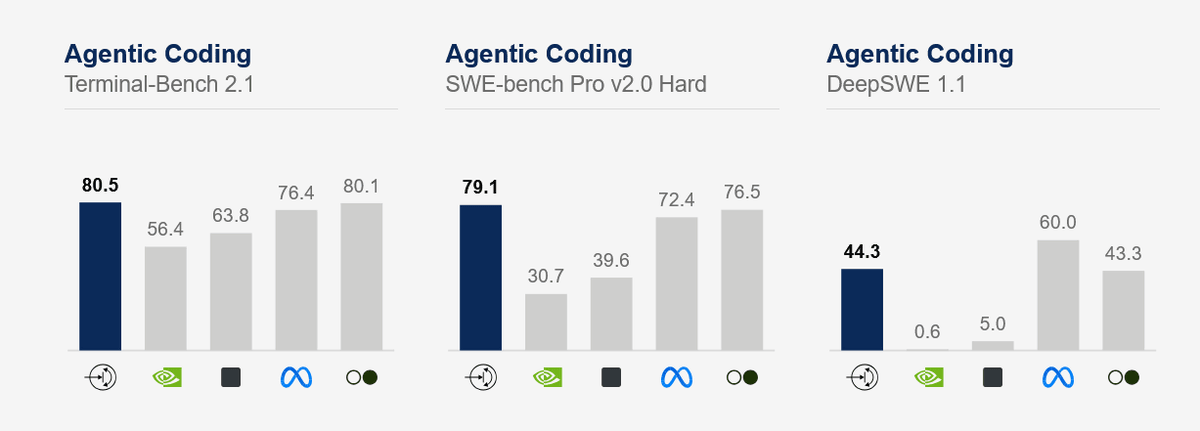
以下はエージェントコーディングのベンチマーク「Terminal-Bench 2.1」「SWE-bench Pro v2.0 Hard」「DeepSWE 1.1」において、アメリカ産オープンモデルと比較したグラフ。
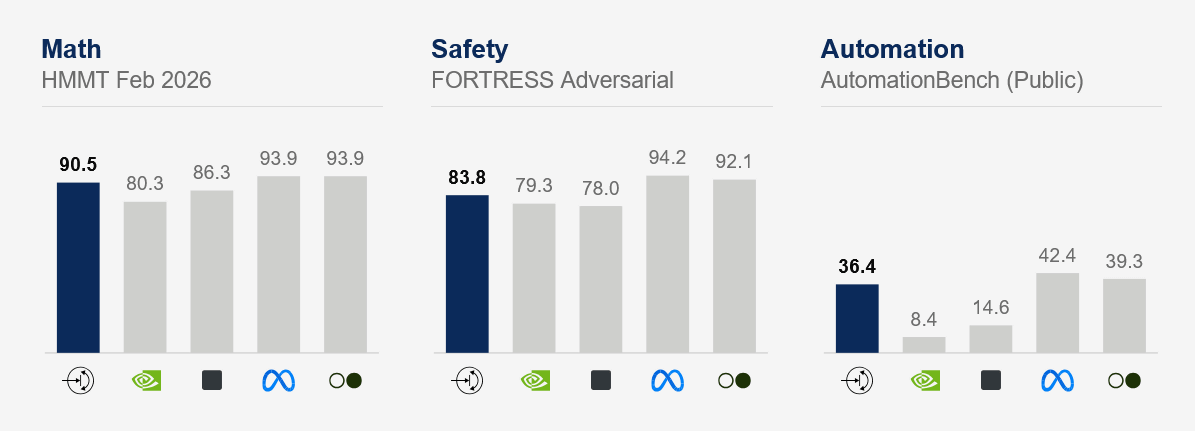
また以下は、左から数学ベンチマークの「HMMT Feb 2026」、安全性ベンチマークの「FORTRESS Adversarial」、AIエージェントの実務能力を測る「AutomationBench (Public)」のスコア。いずれも、MuseのSpark Openが首位、Beam 501Bが次点、Ripple-65B Previewは3番手となっています。
Ripple-65B Previewの大きな特徴として、開発コストの低さが挙げられています。OpenAIのサム・アルトマンCEOは「GPT-4の学習コストが1億ドル(約150億円)を超えた」と述べていたり、Anthropicのダリオ・アモデイCEOは「最先端のAIモデルの学習には最大10億ドル(約1500億円)かかる可能性があり、事前学習だけでも2026年から2027年までに1000億ドル(約15兆円)に達する」と予測していたりと、学習コストが非常に高額なことで知られています。一方でRicursive Intelligenceによると、Ripple-65B Previewをゼロから開発するためにかかった費用は3200万ドル(約50億円)だったとのこと。この金額には、事前学習の規模を段階的に拡大する実験やデータの調整、評価、デバッグ、合成データの生成、追加学習の手法開発、最終的な学習など、研究開発全体の費用が含まれています。
開発コストを抑えることができた理由について、Ricursive Intelligenceは「力任せの強化学習に投資するのではなく、計算効率を重視しながら、SFTと強化学習の手法を慎重に改良しました。学習後のデータは一切購入せず、独自の合成データパイプライン、品質フィルタリング、カバレッジ指標を開発しました。これにより、従来のオープンウェイトモデルの最高性能記録を更新したモデルの開発費と比較して、約10分の1に抑えることができました」と説明しています。実際に、Terminal-Bench 2.1のスコアを80.5点まで引き上げるために必要だった試行回数は140万回で、従来の最高スコアを記録していたBeamの試行回数の約70分の1となるそうです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.