IBMが音声AI「Granite Speech 5.0」をオープンソースで公開、騒がしい場所でも高精度に文字起こし可能で複数人の会話を識別するAIも強化
新たに発表されたGranite Speech 5.0では従来モデルを改良した「Granite Speech 5.0 2B」が登場。パラメーター数は従来と同じ20億で、日本語、英語、フランス語、ドイツ語、スペイン語、ポルトガル語の文字起こしに対応しています。音声認識の精度を高めるために39万時間分の公開音声データなどを使って学習したとのこと。
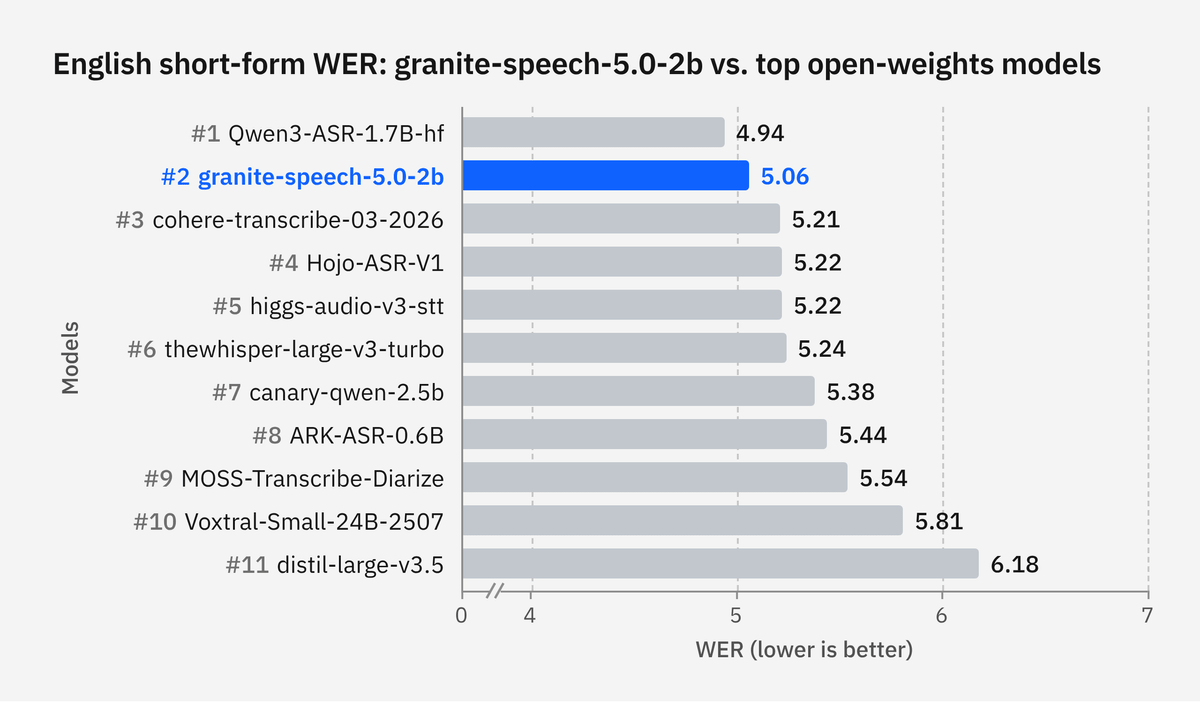
特に騒音や反響への対応が強化されており、Granite Speech 5.0 2Bは雑音が混じった音声やマイクから離れた場所で録音された音声を従来より正確に認識できるようになっています。IBMが公開した英語の音声認識テストでは文字起こしの単語誤り率が平均5.06%となり、評価対象となった公開モデルの中で2位を記録しました。
また、音声認識AIが人名や商品名、略語などを間違える問題への対策として最大2000語のキーワードを指定できるようになりました。文字起こしや翻訳の際に認識してほしい単語を事前に登録することで、専門用語が多い会議などでも正確な記録を作成しやすくなります。
翻訳機能も強化され、英語と日本語などの間で音声を翻訳しながら文字起こしすることが可能に。従来モデルと比べて長時間の音声や自然な会話の翻訳精度が向上したほか、入力する音声の言語を指定して認識精度を高める機能も追加されています。
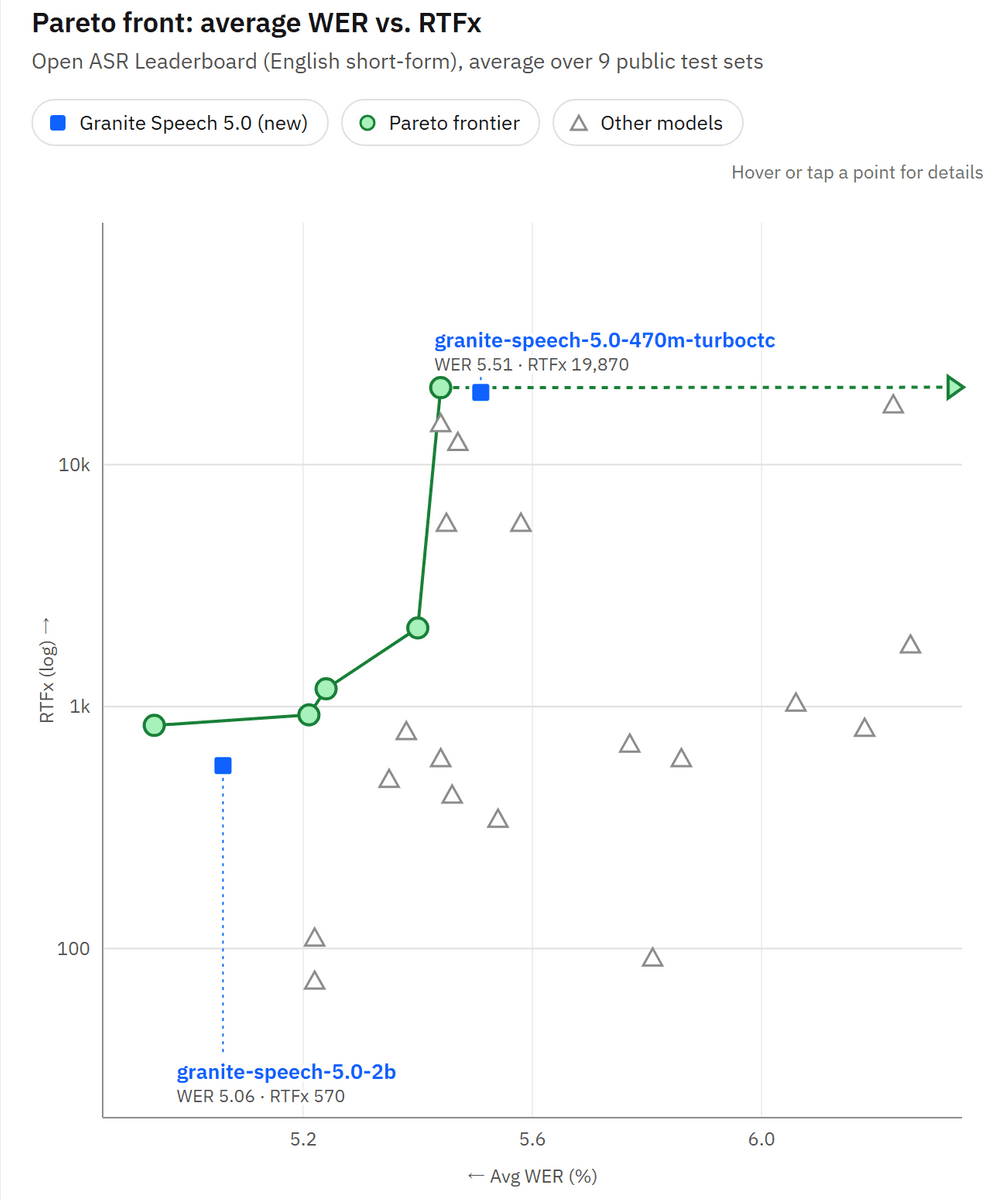
大量の音声を素早く処理したい場合に向けて、軽量モデル「Granite Speech 5.0 470M Turbo CTC」も更新されました。軽量モデルのパラメーター数は4億7000万で、従来の英語専用モデルから日本語を含む7言語対応へと拡張されています。文章の句読点や英語の大文字も自動的に補完できるようになり、処理速度は従来の約1.6倍に向上したとのこと。
以下の画像は音声認識の精度と処理速度を比較したグラフ。Granite Speech 5.0 470M Turbo CTCでは高速処理に重点が置かれており、端末上での文字起こしなどが想定されています。
さらに、複数人の会話を文字起こしするための既存モデル「Granite Speech 4.1 2B Plus」も改良されました。話者の識別は「誰がどの発言をしたか」を判別する機能で、会議やインタビューの記録に役立ちます。
改良版では発言者の識別に関する誤り率が約7%低下し、長時間の音声における文字起こしの誤り率も24%減少しました。発言のタイミングを記録する精度も向上しており、字幕の作成や録音内容の検索がしやすくなっています。
Granite Speech 5.0 2B、Granite Speech 5.0 470M Turbo CTC、改良版Granite Speech 4.1 2B PlusはいずれもApache 2.0ライセンスで公開されており、商用利用やカスタマイズが可能です。IBMは高精度な文字起こしや翻訳にはGranite Speech 5.0 2B、高速処理にはTurbo CTC、複数人の会話記録にはGranite Speech 4.1 2B Plusを推奨しています。各モデルの学習データや評価結果、使用方法も公開しており、用途に応じてモデルを選択できるとのことです。
Granite Speech - a ibm-granite Collection
https://huggingface.co/collections/ibm-granite/granite-speech
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.