«client prematurely closed connection», хотя пользователь никуда не уходил
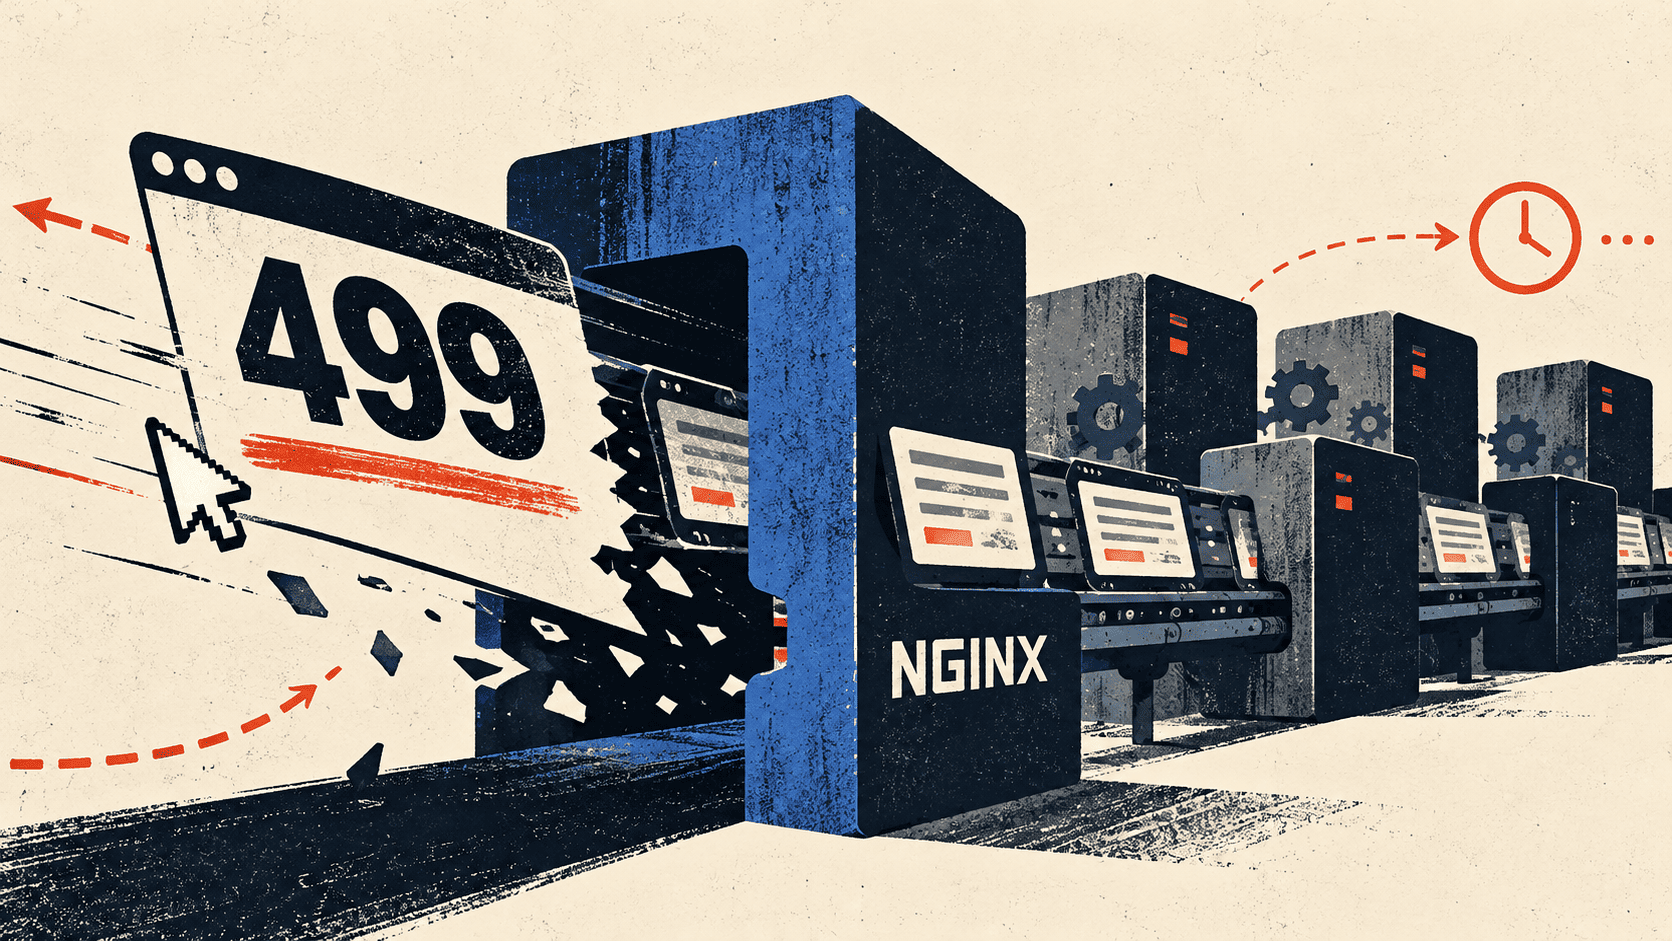
Строку client prematurely closed connection в error.log nginx видел каждый, кто хоть раз поднимал уровень логов до info, а в access.log напротив того же запроса стоит 499. Читают её обычно буквально, как «клиент ушёл сам».
Пользователь закрыл вкладку, мобильный интернет моргнул, к серверу претензий нет. Алерт на 5 xx молчит, 499 в него не входит, и про этот код вспоминают, только когда таких строк набираются тысячи в час.
Кода 499 нет ни в одном RFC. Его придумали в nginx. Нужен он был, чтобы было что записать в лог, когда отвечать уже некому.
Иногда пользователь действительно ушёл с сайта. Иногда «пользователем» оказывается балансировщик, который устал ждать и уже отдал клиенту 504, а бэкенд в это время спокойно дорабатывает запрос, результат которого никто не увидит.
Такие ситуации особенно важно учитывать при проектировании инфраструктуры высоконагруженных систем, где таймауты, повторные запросы и лишняя работа бэкенда могут заметно влиять на производительность.
А с 24 марта 2026 года, когда в nginx 1.29.7 keepalive к апстримам включили по умолчанию, каждый такой обрыв ещё и выбивает соединение из пула.
Код, который придумали для лога
Определение 499 находится в src/http/ngx_http_request.h, и комментарий над ним объясняет, зачем код понадобился:
/*
 * HTTP does not define the code for the case when a client closed
 * the connection while we are processing its request so we introduce
 * own code to log such situation when a client has closed the connection
 * before we even try to send the HTTP header to it
 */
#define NGX_HTTP_CLIENT_CLOSED_REQUEST     499
Граница записана в последних словах комментария: «before we even try to send the HTTP header».
Клиенту 499 никогда не отправляется. Он существует только в access log и записывается, если клиент ушёл раньше, чем nginx начал отдавать ответ.
Обрывать запросы я пробовал на nginx 1.31.8 и Angie 1.12.4 разными способами, от таймаута curl и отмены в браузере до gRPC‑дедлайна и клиента, который пропал без единого пакета, а за nginx стояли бэкенды на Go и на aiohttp.
Проще всего 499 получить через curl --max-time 2 на ручку, которая отвечает 6 секунд, и в логе это выглядит так:
st=499 rt=2.002 urt=2.002 us=- uht=- bbs=0
[info] epoll_wait() reported that client prematurely closed connection,
       so upstream connection is closed too while sending request to upstream
$upstream_status пустой, потому что бэкенд не успел ответить. $upstream_response_time равен тем же 2 секундам и показывает только время до обрыва, о работе бэкенда он ничего не говорит.
Хвост while sending request to upstream сбивает с толку, ведь запрос давно отправлен и nginx ждёт первый байт ответа.
Текст действия в коде меняется на reading response header только после события чтения на соединении с апстримом, а оно наступает, когда приходит ответ или истекает таймаут.
Пока бэкенд молчит, в логе написано, что nginx всё ещё отправляет. Пишется это сообщение с уровнем info.
Услышит ли бэкенд, что nginx закрыл соединение
Заметив обрыв, nginx сразу закрывает соединение к бэкенду.
В Go r.Context() входящего запроса отменяется, когда закрылось клиентское соединение. Обработчик, который проверяет контекст, получает context canceled через 2,002 секунды и бросает работу.
Если обработчик контекст не проверяет, он доработает все 6 секунд, а w.Write в конце вернёт nil, потому что ответ просто ушёл в буфер.
От aiohttp я ждал того же и ошибся. По умолчанию он закрытия не слышит. Отмену обработчика при обрыве соединения убрали в версии 3.7.0 в 2020 году. Параметр handler_cancellation, который её возвращает, появился в 3.9.0 и по умолчанию выключен.
В логе nginx у такого запроса тот же 499 через 2 секунды, а обработчик на aiohttp доходит до конца и пишет в свой лог WORK DONE after 6.0s.
Если внутри был запрос в базу или вызов платёжного API, они доделываются для клиента, которого уже нет.
Включается отмена одним параметром:
web.run_app(app, handler_cancellation=True)Авторы библиотеки рекомендуют её тем, кто уверенно работает с asyncio или кому важна масштабируемость, а то, что обязательно надо довести до конца, советуют защищать через aiojobs.aiohttp.shield().
Списание денег под shield() тогда завершится, а отчёт, который никто не ждёт, обработчик бросит сразу и не потратит на него лишние 4 секунды.
В Go то же самое работает без настроек, но только если контекст запроса доходит до каждого вызова, будь то db.QueryContext(r.Context(), ...) или http.NewRequestWithContext(r.Context(), ...).
Обработчик, который где‑то посередине создаёт context.Background(), теряет отмену в этом месте, и дальше по стеку она не дойдёт.
Проверить свой бэкенд можно тем же curl --max-time 2, если обработчик пишет строчку в лог, когда доходит до конца.
Я отправил 100 параллельных запросов с длительностью от 1 до 8 секунд через цепочку «внешний балансировщик с таймаутом 5 секунд → nginx → бэкенд»:
                   клиент        внешний LB     nginx          бэкенд
aiohttp            58×200 42×504 58×200 42×504  58×200 42×499  100 доработано
Go                 58×200 42×504 58×200 42×504  58×200 42×499  58 доработано, 42 прервано
Из 100 запросов 42 до пользователей так и не дошли. aiohttp всё равно выполнил все 100. Go бросил те 42, которые никто не ждал, но только на пятой секунде, когда nginx закрыл соединение.
Первые 5 секунд работы по ним ушли впустую.
Часть 499 — это чужой 504
В том же выводе 42 ответа 504 снаружи совпадают с 42 записями 499 внутри.
Пользователи тут ни при чём, ждать перестал внешний прокси. Для внутреннего nginx клиент — это балансировщик, и когда тот по своему proxy_read_timeout закрывает соединение, внутренний nginx записывает это как уход клиента.
Если пробросить ID запроса через proxy_set_header X-Request-Id $request_id; на внешнем уровне, строки склеиваются:
[внешний] rid=99e054b8 "GET /go/slow?d=10" st=504 rt=5.003 us=504 bbs=167
[внутр.]  xrid=99e054b8 "GET /go/slow?d=10" st=499 rt=5.019 us=-
У таких 499 $request_time упирается в одно и то же значение, и оно совпадает с таймаутом соседа сверху.
За ними стоит медленный бэкенд, ответа которого кто‑то выше не дождался и уже посчитал ошибкой. Лучше всего это видно на гистограмме $request_time, построенной по одним только 499.
Пик на таймауте балансировщика лечат там же, где 504.
У AWS ALB idle timeout по умолчанию 60 секунд, у nginx proxy_read_timeout по умолчанию тоже 60, и два одинаковых таймаута подряд дают гонку, в которой один и тот же запрос попадает в один лог как 499, а в другой как 504.
У Cloudflare Proxy Read Timeout сейчас 125 секунд, по его истечении клиент получает 524. Если у вашего origin таймаут больше 125 секунд, Cloudflare отдаст 524 раньше, и в логе origin, скорее всего, будет 499.
При ретраях 499 пишется на каждом узле, куда ушла попытка.
Внешний nginx с двумя внутренними узлами, proxy_read_timeout 3s и proxy_next_upstream по умолчанию (error timeout) получил один GET:
client got 504 after 6.009s
[внешний] st=504 rt=6.009 urt=3.006, 3.003 us=504, 504
[узел 1]  st=499 rt=3.005
[узел 2]  st=499 rt=3.003
бэкенд на aiohttp: два START d=8.0 и два WORK DONE after 8.0s
Один запрос пользователя превратился в один 504 снаружи, два 499 внутри и две полностью выполненные восьмисекундные задачи на aiohttp‑бэкенде.
Go бросил бы обе на третьей секунде. По таймауту nginx повторяет GET, а POST и PATCH с версии 1.9.13 не повторяет, если не добавить в proxy_next_upstream параметр non_idempotent.
Keepalive по умолчанию и цена обрыва
С 24 марта 2026 года, с версии 1.29.7, nginx держит keepalive к апстримам по умолчанию: keepalive 32 local в каждом блоке upstream, proxy_http_version 1.1 и без заголовка Connection: close.
Касается это только именованных upstream. proxy_pass http://127.0.0.1:8000 без блока пул не получает.
Соединение возвращается в пул, только если ответ от бэкенда дочитан до конца. У 499 ответа нет. Соединение закрывается, и Go‑бэкенд видит это так:
conn 127.0.0.1:39942 -> new / active    запрос 1, 200
conn 127.0.0.1:39942 -> idle / active   запрос 2, 200, то же соединение
conn 127.0.0.1:39942 -> active          запрос 3, клиент ушёл через 2 с
conn 127.0.0.1:39942 -> idle -> closed  nginx закрыл, в пул не вернул
conn 127.0.0.1:44686 -> new             запрос 4, новое TCP
Каждый 499 оборачивается закрытым соединением к бэкенду и новым рукопожатием на следующем запросе, а если до бэкенда TLS, то и новым TLS.
В прогоне со 100 запросами 42 обрыва дали 42 закрытых соединения. До 1.29.7 keepalive к апстримам включали руками, и после обновления эти переподключения получает любой конфиг с именованным upstream.
Angie 1.12.4 основан на nginx 1.31.2, но это умолчание не перенял и без директивы keepalive закрывает соединение к бэкенду после каждого запроса, с обрывом или без.
Где 499 не будет, хотя клиента нет
Чтобы обрыв клиента не доходил до бэкенда, в nginx есть proxy_ignore_client_abort on.
Директива есть с 2006 года. По умолчанию стоит off. С ней nginx не следит за клиентским сокетом, бэкенд дорабатывает запрос, соединение по HTTP/1.1 остаётся в пуле, а 499 из логов исчезает совсем:
proxy_ignore_client_abort on, клиент ушёл через 2 с, бэкенд отвечает 4 с
st=200 rt=4.002 us=200 bbs=9 rc=OK
Я ждал, что обрыв хоть как‑то проступит в полях лога, но брошенный запрос записан как успешный, с полным временем бэкенда и даже с rc=OK.
nginx записал 9 байт в сокет, куда клиент уже прислал FIN, и ошибки не получил. Маленький брошенный ответ в логе ничем не отличается от доставленного.
След остаётся, только если ответ не влез в буфер сокета. На 5 МБ получилось bbs=8035 и writev() failed (32: Broken pipe), $request_completion пустой, а $body_bytes_sent меньше Content-Length.
proxy_ignore_client_abort onя бы держал только в техlocation, где бэкенду правда нужно доделать запрос. Брошенные запросы там становятся обычными 200.
Без всякой директивы 499 не возникает и тогда, когда клиент ушёл посреди тела ответа, потому что заголовки уже отправлены.
В логе остаётся 200 с обрезанным bbs=393059 при Content-Length 2 621 440. Оборванная загрузка тела запроса превращается в 400 с client prematurely closed connection, а бэкенд при proxy_request_buffering on, которое стоит по умолчанию, такого запроса не увидит вовсе.
Клиента, который пропал, не закрыв соединение, nginx вообще не замечает. Я имитировал это, выбросив пакеты клиента на фаерволе.
Маленький ответ записался как 200 rc=OK. Большой, на 5 МБ, записался как 200 bbs=3874659, хотя клиент не прочитал ни байта.
$body_bytes_sent считает байты, отданные ядру в буфер сокета, а не дошедшие до клиента. Сколько длился такой запрос, зависело только от того, когда я убрал правило с фаервола. В жизни такое соединение закроет send_timeout, по умолчанию через 60 секунд.
Клиент может отправить запрос, закрыть через shutdown(SHUT_WR) только свою половину соединения и продолжать читать ответ.
При проксировании nginx считает это уходом и пишет 499 через ноль секунд, и ответа клиент так и не получает. Так делают некоторые самописные клиенты, например на Java через Socket.shutdownOutput(), чтобы показать «запрос закончен».
С proxy_cache, пока ответ считается кэшируемым, nginx при обрыве апстрим не рвёт и ждёт ответ, рассчитывая положить его в кэш.
В логе остаётся 200 bbs=0, бэкенд дорабатывает. Только в кэш ответ так и не попадает, и следующий такой же запрос снова получает MISS и ждёт те же 4 секунды.
Отмена в браузере и дедлайн в gRPC
В Chromium 499 дают AbortController, уход со страницы с незавершённым fetch и закрытие вкладки, и обрывает браузер запрос по‑разному в зависимости от протокола.
HTTP/1.1. По HTTP/1.1 он рвёт TCP‑соединение целиком, и следующий запрос открывает новое.
HTTP/2. По HTTP/2 он шлёт кадр
RST_STREAMс кодомCANCEL. Соединение остаётся открытым, а в error.log пишетсяclient canceled stream 3.
У HTTP/2-потока нет своего сокета, поэтому nginx его не проверяет и об уходе клиента узнаёт только из RST_STREAM или из закрытия всего соединения.
Поиск с подсказками, который отменяет предыдущий запрос на каждую новую букву, может давать пачку 499 в секунду от одного пользователя, на HTTP/1.1 ещё и с новым TCP‑соединением на каждую букву.
Интерфейс в этот момент работает так, как его написали.
gRPC‑клиент по истечении дедлайна шлёт тот же RST_STREAM, и в логе nginx это тоже 499:
client: StatusCode.DEADLINE_EXCEEDED after 1.50s
nginx:  "POST /demo.Slow/Work HTTP/2.0" st=499 rt=1.497 us=-
backend: ctx.is_active()=False after 1.50s
Заголовок grpc-timeout nginx пробрасывает на бэкенд, и тот знает свой дедлайн заранее. Даже если этот заголовок вырезать, бэкенд всё равно получит отмену от nginx через те же 1,5 секунды.
Директивы grpc_ignore_client_abort нет. В коде модуля значение жёстко выставлено в 0.
В $status у gRPC попадает HTTP‑статус, а grpc-status из трейлеров туда не доходит, поэтому ошибки бэкенда в логе выглядят как 200.
Считать ли 499 ошибкой
Angie в своём API вообще не считает 499 ответом и кладёт такие запросы в счётчик requests.discarded вместо responses, а документация называет 499 «not a response but an internal service code».
В Prometheus‑шаблоне Angie для этого есть отдельная метрика angie_http_server_zones_requests_discarded.
AWS ALB для того же события использует свой код 460.
Envoy пишет код 0 с флагом
DCилиDR.Google Cloud LB пишет 0 с
client_disconnected_before_any_response.
Cloudflare в январе 2026 начал логировать отменённые HTTP/3-запросы как 499 и в посте с этой новостью предложил подумать, не исключить ли их из error rate.
Из моих прогонов вышло два разных 499.
Первый оставляет пользователь, который ушёл сам, отменив запрос, перейдя на другую страницу или закрыв вкладку, и считать такой 499 в SLO доступности ошибкой сервера незачем.
Второй nginx записывает, когда вышестоящий прокси не дождался медленного бэкенда и сам отдал клиенту 504, и такой 499 относится к проблемам сервера.
Различаются они по $request_time, который у первого разбросан, а у второго упирается в таймаут соседа.
Разобраться с одним кодом ошибки — полдела. Проверить, насколько хорошо вы понимаете работу инфраструктуры высоконагруженных систем в целом, можно во вступительном тесте OTUS.
Чтобы это видеть, хватит пары полей в логе:
log_format n499 '$remote_addr "$request" st=$status rt=$request_time '
                'urt=$upstream_response_time us=$upstream_status '
                'bbs=$body_bytes_sent rc=$request_completion '
'rid=$request_id xrid=$http_x_request_id';$request_completionловит обрезанные 200 с большим телом;ridиxridсклеивают строки между уровнями прокси;urtиrtпоказывают, во что упёрся запрос.
Сам по себе 499 сообщает только, что соединение закрылось раньше, чем nginx начал отвечать. Кто его закрыл и чем в это время был занят бэкенд, видно по
$request_time, поridв логах прокси уровнем выше и по логу самого бэкенда.
Пока этих полей в логе нет, 42 брошенных запроса из сотни выглядят в дашборде обычным фоном, и aiohttp тем временем дорабатывает каждый из них до конца.
Что оказалось за 499 у вас — свой балансировщик с таймаутом, ретраи между узлами или мобильный клиент, который рвёт соединения по‑своему?
На курсе «Инфраструктура высоконагруженных систем» разбирают работу веб-серверов, балансировку нагрузки и поиск узких мест в инфраструктуре.
Как показывает история с 499, за одной строкой в логе могут стоять совершенно разные причины: от таймаута балансировщика до медленного бэкенда. Чтобы лучше понимать, как система ведёт себя под нагрузкой и что происходит при сбоях, приходите на бесплатные вебинары:
2 ноября в 19:00. «Оптимизация Nginx и Angie под высокие нагрузки». Записаться
19 ноября в 20:00. «Восстанавливаем MBR, GPT и LVM после критических сбоев». Записаться
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.