אפליקציית ההקראה המצוינת של ElevenLabs משתדרגת עם מודל חדש, עברית מעולה ודיבור אנושי
חברת ה-AI הקולי ElevenLabs חושפת את גרסה v4 של המודל שלה שזמין גם באפליקציית ההקראה שלה
תמונה: ElevenLabs
אם יצא לכם להשתמש לאחרונה באפליקציית ההקראה של ElevenLabs (כמו שהמלצנו לכם לפני שנתיים), לא צריך לחפור לכם יותר מדי למה היא פופולרית כל-כך. האפליקציה, שזמינה לאנדרואיד ול-iOS, הצליחה לשבור את התפיסה של מנועי ההקראה הרובוטיים והמונוטוניים, ועל הדרך היא גם הוסיפה לפני כשנה תמיכה מפתיעה ולא רעה בעברית. עכשיו, החברה משחררת שדרוג משמעותי מתחת למכסה המנוע, כשהיא מטמיעה באפליקציה ובפלטפורמה את דור המודלים החדש והמתקדם שלה, ה-v4 וגרסת ה-Turbo.
מודל חדש
המעבר לארכיטקטורת ה-v4 משנה את כל מה שהכרנו על TTS וקול מג'ונרט שנשמע כמו קריין חסר רגש. המודל החדש לא פשוט קורא את המילים בצורה לינארית, אלא ממש מנתח את ההקשר המלא של המשפטים והטקסט לפני ובזמן ההקראה ויכול להתאים את הטון לטקסט. כלומר האינטונציה, קצב הדיבור ואפילו העצירות הקטנות לנשימה בין המשפטים, מותאמים לתוכן באופן דינמי. זה הופך את חוויית ההאזנה למאמרים ארוכים במיוחד, דוחות משמימים או ספרים דיגיטליים, לחלקה והרבה יותר טבעית לאוזן.
הדגמה של המודל החדש:
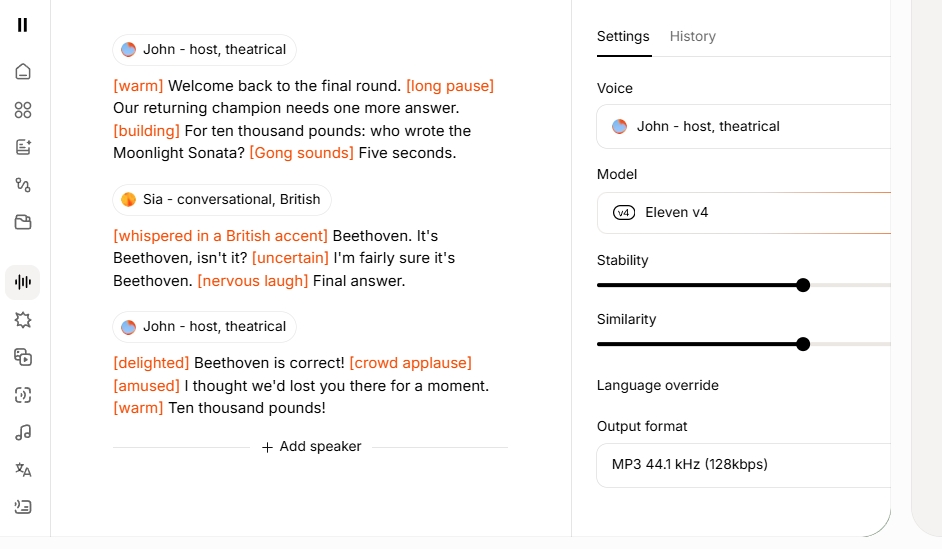
אבל גם אם אתם לא סומכים על ה-AI, ורוצים לייצר לבד קטע קריינות ולקבוע כיצד הוא יישמע בדיוק, אתם יכולים, כי אחד הפיצ'רים המעניינים שמגיעים עם השדרוג הזה, הוא היכולת לשלוט במדויק ברגש ובהבעה של הקריין באמצעות תגיות טקסט מובנות. במקום לחכות שהמודל ינחש מתי צריך להנמיך את הקול, אתם יכולים פשוט להדביק את הטקסט לו אתם רוצים להאזין ואז לשתול פקודות ספציפיות ישירות בתוך הטקסט. רוצים שהקריין ילחש לפתע? פשוט הוסיפו את התגית [whisper]. רוצים צחקוק קליל? אנחה או קול עצוב? תוכלו להשתמש בתגיות כמו [laugh], [sigh] או [sad]. המערכת יודעת לעבד כמה תגיות כאלו ברצף, כך שהקול הווירטואלי יכול לעבור מטון מקצועי ורציני ללחישה דרמטית בלי להישבר בדרך. כמובן שאם תרצו, תוכלו פשוט ללחוץ על הכפתור וה-AI יוסיף את התגיות במקומכם.
עוד דוגמה שיצרנו:
עבור מפתחים שבונים סוכנים קוליים ונעזרים ב-API של החברה, גרסת ה-v4 Turbo מביאה איתה קפיצת מדרגה גם בגזרת הביצועים – עם זמני שיהוי נמוכים במיוחד שעומדים על כמאה מילישניות בלבד. כך המערכת מאפשרת בפועל לנהל שיחות שוטפות מול בוטים שמבוססים על מודלי שפה גדולים. כלומר, האודיו נוצר ברגע שהמודל מתחיל לפלוט את המילים הראשונות, בלי העיכובים המביכים שמאפיינים לא פעם עוזרות קוליות, כשאתם שואלים משהו ומחכים לג'ינרוט הקול.
חידושים נוספים בגרסה v4 הם תמיכה ב-90 שפות (כאמור, עברית כבר ביניהן כשנה) וכן אפשרות לשכפול מהיר של כל קול שתרצו (בגבולות הקניין הרוחני כמובן) על ידי האכלת המודל הרעב בדגימות קול שלכם.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.