Энергетическая дискриминация: ИИ тратит на запросы на некоторых языках до 180 раз больше энергии, чем на английский

Опрос
реклама
| Новости Software |
Самое интересное в обзорах
06.11.2026 [20:41],
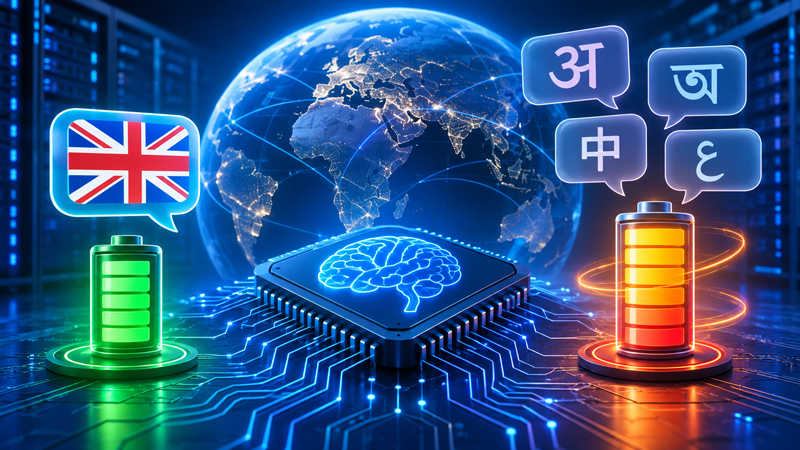
Учёные из Мичиганского университета (University of Michigan) показали, что обработка запросов искусственным интеллектом на разных языках требует существенно различающихся энергозатрат. В зависимости от языка и модели энергозатраты на обработку запросов на национальных языках могут превышать показатели для англоязычных запросов в 1,4–180 раз.
Источник изображения: ИИ-генерация ChatGPT/3DNews
Проверка ИИ на языковую и энергетическую дискриминацию охватывала 122 языка и пять вариантов моделей: Qwen 3 с 8, 14 и 32 млрд параметров (разработчик — Alibaba), Gemma 3 с 27 млрд параметров (Google) и Llama 3.1 с 8 млрд параметров (Meta✴). Для измерений использовалась разработанная исследователями система ML.Energy, позволяющая оценивать энергопотребление при выполнении вычислений ИИ-моделями. В качестве аппаратной платформы применялись два графических ускорителя NVIDIA — L40S и RTX 6000 Pro Blackwell.
Одной из основных причин разницы в энергопотреблении для обработки моделями ИИ запросов на разных языках оказалось увеличение количества токенов — минимальных единиц текста, на которые модель разбивает входные данные и формирует ответы. Токенизаторы, обученные преимущественно на латинском алфавите, менее эффективно обрабатывали некоторые другие системы письменности, разбивая слова на большее количество фрагментов.
Кроме того, для языков с ограниченными ресурсами для обучения модели нередко генерировали значительно более длинные ответы, иногда в 20–25 раз превышающие английские по числу выходных токенов. Увеличение количества токенов повышало требования к памяти и заставляло обрабатывать запросы меньшими пакетами, что снижало эффективность использования графических процессоров и увеличивало энергозатраты.
В исследовании максимальная разница в энергопотреблении на один выходной токен достигала 8,3 раза, а суммарные затраты на обработку одинакового набора запросов различались в 179 раз: от 17,6 кДж для английского языка до 3147 кДж для пушту.
Особенно заметна разница для языков, не использующих латиницу и представленных меньшим объёмом цифровых материалов для обучения ИИ. Например, генерация текста на хинди требует в среднем в 7,9 раза больше энергии, а на бенгальском — в 15,3 раза больше, чем на английском. Однако не стоит надеяться на латинский алфавит: для большинства западноевропейских языков также характерна разница в энергозатратах на обработку запросов, и по сравнению с английским она может быть двукратной.
Исследователи также обнаружили связь между энергозатратами и точностью ответов: языки, требующие больше вычислительных ресурсов, в среднем демонстрировали худшие результаты при выполнении тестовых заданий. Для проверки использовались тест Belebele на понимание прочитанного на 122 языках, математические задачи GSM8K и набор открытых пользовательских запросов LM-Arena. В дополнительных экспериментах англоязычные задания переводились на другие языки с помощью системы Meta✴ No Language Left Behind.
По оценке исследователей, около 5,2 млрд человек в мире говорят на языках, обработка которых требует как минимум вдвое больше энергии, чем обработка английского языка. Это будет увеличивать стоимость использования коммерческих ИИ-сервисов для людей из разных языковых групп, поскольку многие поставщики рассчитывают стоимость услуг исходя из количества обработанных и сгенерированных токенов.
«Большинство людей захотят использовать модели ИИ, задавая вопросы на своих родных языках, и это будет неизбежным, поскольку ИИ внедряется во всё больше сфер жизни общества, но двойной “штраф” [за неанглийский] повышает вероятность того, что некоторые люди не смогут позволить себе ИИ, а компании будут неохотно предоставлять модели на определенных языках», — делают неутешительный вывод авторы работы.
В качестве возможных способов сокращения разрыва авторы предлагают создавать модели, специально оптимизированные для отдельных языков, направлять запросы к наиболее подходящим языковым моделям или предварительно переводить их на английский перед обработкой универсальной системой. Последний подход, по их мнению, применим при условии достаточно высокого качества перевода.
Ещё одно направление — расширение обучающих корпусов за счёт материалов на языках, которые пока недостаточно представлены в цифровом виде, в том числе с привлечением носителей этих языков.
Источник:
Если вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.