Очередь на Postgres: масштабирование, inbox и сравнение с Kafka и RabbitMq
В прошлой статье я утверждал, что Kafka не нужна, если событие и результат бизнес-операции пишутся в PostgreSQL одной транзакцией. Только ленивый не написал Главное Возражение в комментариях: слот логической репликации не делится между читателями, каждый вычитывает журнал целиком — значит, читатели и станут узким местом.
Я решил проверить это утверждение. Сравнить сколько ресурсов потребляют консьюмеры очередей по сравнению сравнению с чтением логической репликации при увеличении их количества.
Это не вердикт по выбору транспорта: в конце будут условия, при которых брокер нужен, и они следуют из тех же цифр.
Короткий ответ для тех кому лень читать
Метрика — суммарное процессорное время всех участников (база, брокер, CDC-звено, веб-сервис, тест), делённое на число обработанных сообщений:
мс CPU на сообщение = сумма CPU-секунд всех процессов за окно прогона / число обработанных сообщений
100 000 сообщений на прогон, 200 отправителей:
конвейер | 1 получатель | 2 | 4 | 8 |
|---|---|---|---|---|
прямое чтение WAL (логическая репликация) | 1.19 | 1.21 | 1.48 | 1.88 |
прямое чтение, 64 шарда | 1.27 | 1.33 | 1.66 | 1.60 |
Debezium → Kafka | 2.35 | 1.99 | 2.03 | 2.16 |
Debezium → RabbitMQ quorum | 2.20 | 2.10 | 2.25 | 2.21 |
мс CPU на сообщение, суммарно по всем участникам; меньше — дешевле.
Три оговорки сразу, чтобы таблицу не прочитали шире, чем она есть.
Это стоимость, а не скорость. Ни задержка, ни предельная пропускная способность тут не измерены: стенд упирается в отправителей (запись в outbox), а не в конвейеры, и на больших N получатели разбирают поток почти в реальном времени.
Точка пересечения не измерена: в диапазоне 1–8 получателей прямое чтение дешевле на всех точках.
Один прогон на ячейку при измеренном дрейфе стенда 10%, поэтому разницы меньше 10% значения не имеют: 2.16 против 2.21 и 1.60 против 1.88 — внутри погрешности, а 1.19 против 2.35 — нет.
Далее длинный ответ какой код замерялся и почему именно так.
Стенд
Машина | одна, 16 потоков, 31 ГБ, Windows; брокеры и Debezium в контейнерах, веб и тест — процессы рядом |
PostgreSQL | 18 (протокол pgoutput V4 с |
Kafka | confluent-local 8.2, топик |
RabbitMQ | 4.3, quorum-очередь (Raft, fsync на сообщение) |
CDC | Debezium Server 3.6.2.Final, два контейнера с одинаковым источником |
Сообщение | строка |
Поток | 4900–8000 событий в секунду, то есть порядка 1 МБ/с: на порядок ниже границы 10 МБ/с из первой статьи, но максимум что вытягивает docker в wsl |
Ключевые настройки базы — в AppHost:
.WithArgs("-c", "wal_level=logical")
.WithArgs("-c", "max_wal_senders=64")           // 8 слотов веера + 2 Debezium + запас; дефолт 10
.WithArgs("-c", "max_slot_wal_keep_size=4096")  // 4 ГБ; дефолт -1 - безлимитное удержание WAL
Число читателей упирается не только в процессор, но и в max_wal_senders, а отставший слот без max_slot_wal_keep_size съест диск parimary-сервера целиком.
Надёжность брокеров этот стенд не проверял: топик с одной репликой, отказов не вносилось. Любые утверждения про потери Kafka или RabbitMQ — не отсюда.
Архитектура
Общий у всех сценариев путь до строки в таблице и вся обработка после доставки. Различается только участок между базой и получателем.
Отправитель
Просто аутбокс, без дополнительной работы. Почему он необходим я писал в прошлой статье.
app.MapPost("/load/messages", async (Message dto, AppDbContext db, CancellationToken ct) =>
{
    db.Messages.Add(new Message { Content = dto.Content });
    await db.SaveChangesAsync(ct);
    return Results.Created();
});
entity.Property(x => x.CreatedAt).HasDefaultValueSql("now()");
Время вставки ставит база: у всех сценариев одни часы, и это же значение едет и в WAL, и в конверт Debezium.
CDC-звено
Оба CDC-сценария — один и тот же Debezium Server, различается только приёмник.
debezium.source.plugin.name=pgoutput            # то же декодирование, что у прямого чтения
debezium.source.publication.name=load_test_pub  # та же публикация
debezium.source.snapshot.mode=no_data           # меряем поток, а не initial load
debezium.source.skipped.operations=t,u,d        # в конвейер едут только insert
debezium.source.max.batch.size=8192
debezium.source.max.queue.size=32768
debezium.source.poll.interval.ms=100
debezium.source.offset.storage=...MemoryOffsetBackingStore
debezium.source.slot.drop.on.stop=true
debezium.format.value.schemas.enable=false      # конверт без схемы: меньше байт и CPU
debezium.sink.kafka.producer.acks=all
debezium.sink.kafka.producer.linger.ms=10
Не трогал compression.type и batch.size продюсера — тюнинг сжатия мог бы отъесть часть разрыва, и это честное ограничение замера. Хранение позиции в памяти и slot.drop.on.stop — ради чистоты прогонов, в продакшене так нельзя.
Получатель Kafka
Простейший вид — одно сообщение за итерацию:
var result = consumer.Consume(ct);
var message = DebeziumEnvelope.ReadMessage(result.Message.Value);

await web.Work.PostAsJsonAsync("/send-email", message, ct);
consumer.StoreOffset(result);          // позиция - только после работы
new ConsumerConfig
{
    GroupId = $"{Name}-{Guid.NewGuid():N}",   // своя группа на прогон: чужие оффсеты не нужны
    AutoOffsetReset = AutoOffsetReset.Earliest,
    EnableAutoCommit = true,
    EnableAutoOffsetStore = false,            // позицию запоминаем сами
    PartitionAssignmentStrategy = PartitionAssignmentStrategy.CooperativeSticky,
}
Партиций вдвое больше числа получателей, группа одна на прогон: именно группа делит партиции, и каждое сообщение достаётся ровно одному получателю.
Получатель RabbitMQ
Клиент отдаёт сообщения пушем, поэтому работа живёт прямо в обработчике доставки:
consumer.ReceivedAsync += async (_, delivery) =>
{
    var message = DebeziumEnvelope.ReadMessage(delivery.Body);

    await web.Work.PostAsJsonAsync("/send-email", message, ct);
    await channel.BasicAckAsync(delivery.DeliveryTag, multiple: false, ct);
};

await channel.BasicQosAsync(prefetchSize: 0, prefetchCount: 1000, global: false);
await channel.BasicConsumeAsync(queue, autoAck: false, consumer);
Очередь одна на всех, получатели конкурирующие — сообщение снова достаётся одному. Prefetch 1000 — аналог упреждающей выборки Kafka, без него брокер отдаёт следующее сообщение только после подтверждения предыдущего.
Читатель репликации
Здесь брокера нет, и это меняет всё: слот отдаёт весь поток каждому подписчику, поэтому одну и ту же строку видят все N читателей.
await using var conn = new LogicalReplicationConnection(connectionString);
await conn.Open(ct);

var slot = new PgOutputReplicationSlot($"load_test_slot_{reader}");   // свой слот на каждого читателя
var options = new PgOutputReplicationOptions("load_test_pub", PgOutputProtocolVersion.V4, binary: true);

await foreach (var walMessage in conn.StartReplication(slot, options, ct))
{
    if (walMessage is InsertMessage insert)
    {
        var message = await ReadRowAsync(insert, ct);

        if (await TryClaimAsync(walMessage.WalEnd, slotName, ct))      // разыгрываем право на работу
            await web.Work.PostAsJsonAsync("/send-email", message, ct);
    }

    conn.SetReplicationStatus(walMessage.WalEnd);   // в том числе Begin/Relation/Commit/keep-alive
    await conn.SendStatusUpdate(ct);
}
Позицию двигать надо и на служебных сообщениях: работы по ним нет, но неподтверждённый слот не даёт базе чистить WAL.
Розыгрыш — одна вставка в общую таблицу: кто вставил, тот и работает.
insert into inbox_wal (wal, slot) values ($1, $2)
on conflict do nothing
returning wal                          -- вернулось: работа наша; пусто - её делает сосед
Брокерным сценариям такая таблица не нужна: там конкуренцию за сообщение уже решил брокер. В репликации такая таблица — единственный арбитр, и без неё N читателей выполнили бы работу N раз. Называется таблица inbox_wal неспроста, дальше расскажу почему.
Строка распаковывается по именам колонок:
switch (columns[i].ColumnName)
{
    case "id": message.Id = await value.Get<int>(ct); break;
    case "content": message.Content = await value.Get<string>(ct); break;
    case "created_at": message.CreatedAt = await value.Get<DateTime>(ct); break;
}
Контракт отправителя и получателя — имена колонок рабочей таблицы, и это “цена” подхода, а не деталь.
Чем различаются получатели
Kafka | RabbitMQ quorum | прямое чтение WAL | |
|---|---|---|---|
Кто делит поток | партиции внутри группы | одна очередь, конкурирующие получатели | никто: каждый видит всё |
Модель чтения | пулл, | пуш, обработчик доставки | пулл, перечислитель потока |
Кому достаётся сообщение | одному | одному | всем |
Нужен ли арбитр | нет | нет | да, таблица |
Подтверждение |
|
|
|
Лишнее в потоке | не-insert по конверту | не-insert по конверту |
|
“Полезная” работа
app.MapPost("/send-email", async (Message message, LoadStats stats) =>
{
    stats.Work(message.Id);
    await Task.Yield();
    return Results.Accepted();
});
Необратимое действие — то, что нельзя откатить вместе с транзакцией. Вся его стоимость здесь — HTTP-хоп (около 0.3 мс); stats.Work считает вызовы и уникальные id для проверки корректности прогона.
Зачем нужен инбокс
Все три конвейера дают at-least-once: Kafka перечитывает топик от закоммиченного оффсета, RabbitMQ перевыдаёт неподтверждённое, репликация проигрывает журнал от подтверждённого LSN. Транспорт не знает, что HTTP-вызов наружу уже случился, поэтому отметка «взято в работу» пишется в базе получателя до работы.
В общем случае идемпотентность получателя достигается именно инбоксом: если у хранилища нет собственного механизма — естественного ключа с upsert, уникального индекса на бизнес-операцию, — то эта отметка остаётся единственным местом, где повтор отличим от первой доставки.
Инбокс для Kafka и RabbitMQ
Ключ — id сообщения, владелец — имя получателя:
with claimed as (
    insert into inbox (id, consumer) values ($1, $2)
    on conflict do nothing
    returning id
)
select id from claimed                        -- закрепили сейчас: работа наша
union all
select id from inbox
where id = $1 and consumer = $2                -- отметка уже наша: это перечитка, работу повторяем
Все части инструкции с data-modifying CTE видят один снимок, поэтому вторая ветка возвращает только прошлые отметки, а свежая приходит через returning — двойного счёта нет. Без второй ветки сообщение, перечитанное после падения собственного получателя, осталось бы без работы навсегда.
Что отметка гарантирует, а что нет:
параллельной работы над одним id не будет;
чужая отметка означает «закреплено другим», а не «обработано другим»;
завершение работы она не доказывает — для этого нужна вторая отметка,
done, уже после работы.
Инбокс для репликации
Таблица inbox_wal из раздела про читателя — тот же инбокс, но ключ другой: LSN строки, он же подтверждаемая позиция, а владелец — имя слота.
insert into inbox_wal (wal, slot) values ($1, $2)
on conflict do nothing
returning wal
Запрос проще, но работает он медленнее. У брокеров конкуренция появляется только на повторной отправке сообщения — то есть почти никогда. При чтении репликации каждая вставка конкурентна: при N читателях каждую строку пытаются закрепить все N, и на каждую обработанную строку приходится N обращений к базе. Эта операция на горячем пути.
Отсюда веерный налог, который потом виден в цифрах: skipped-доставки, по которым работы не было, — ровно (N−1)×M, то есть 700 000 на 100 000 сообщений при восьми читателях.
Именно поэтому чтение логической репликации плохо масштабируется.
Чтение пачками (бачтами)
Пачка из 100 сообщений превращает сто обращений к базе в одно — 0.01 обращения на сообщение. Ровно это и измеряется дальше, поэтому все четыре сценария читают пачками.
Пачка у Kafka и RabbitMQ
while (batch.Count < BatchSize)                       // BatchSize = 100
{
    var result = consumer.Consume(batch.Count == 0 ? PollDelay : FlushDelay);
    if (result is null)
    {
        if (batch.Count > 0) break;                   // добор не пришёл - идём с тем, что есть
        if (state.IsDrained || state.IsExpired) return false;
        continue;
    }

    batch.Add(result);
}

var claimed = await InboxBatch.ClaimAsync(dataSource, Ids(batch), consumerName, ct);
Ожидание первого сообщения 100 мс, добор неполной пачки 50 мс: так получатель замечает конец прогона и не ждёт сотого сообщения, которого уже нет.
У RabbitMQ к этому добавляется буфер — клиент пушит, а циклу нужен пулл:
consumer.ReceivedAsync += (_, delivery) =>
{
    buffer.Writer.TryWrite((delivery.DeliveryTag, delivery.Body.ToArray()));
    return Task.CompletedTask;
};
Тот же запрос инбокса, но на массив:
with claimed as (
    insert into inbox (id, consumer)
    select unnest($1), $2
    on conflict do nothing
    returning id
)
select id from claimed
union all
select id from inbox where id = any($1) and consumer = $2
В пачке теперь соседствуют наши сообщения и чужие, и подтверждать позицию по мере разбора нельзя: оффсет Kafka и LSN слота позиционные — подтверждая номер, подтверждаешь и всё, что перед ним.
public void Hold(T position) => _inflight.Add(position);

public bool TryResolve(T position, out T confirmed)
{
    _inflight.Remove(position);
    _resolved.Add(position);

    var moved = false;
    while (_resolved.Count > 0 && (_inflight.Count == 0 || _resolved.Min!.CompareTo(_inflight.Min!) < 0))
    {
        _confirmed = _resolved.Min;
        _resolved.Remove(_confirmed!);
        moved = true;
    }

    confirmed = _confirmed!;
    return moved;
}
Hold — взяли в работу, TryResolve — закрыли (работа сделана, либо её не будет); позиция двигается только до последнего закрытого, перед которым не осталось незакрытых:
foreach (var item in batch)
{
    if (claimed.Contains(item.Id)) { Watermark(item.Partition).Hold(item.Offset); pending.Enqueue(item); }
    else Resolve(item);                               // чужая отметка: работы не будет
}
Этот дефект нашёл ИИ уже после прогонов: до правки подтверждение чужого закрепления перепрыгивало через нашу незавершённую работу.
Quorum-очереди на RabbitMq она не касается: basic.ack адресует delivery tag, а не позицию.
Пачка у репликации
Источник другой — перечислитель, и незавершённое чтение нельзя терять между вызовами:
var move = moving[index] ??= stream.MoveNextAsync().AsTask();
if (!move.IsCompleted && await Task.WhenAny(move, Task.Delay(wait, ct)) != move) { /* добор не пришёл */ }

if (stream.Current is not InsertMessage insert)
{
    Resolve(index, stream.Current.WalEnd);   // служебное: работы нет, позиция есть
    continue;
}
Закрепление пачки LSN возвращает не сами LSN, а номера позиций в пачке — сопоставление без поиска по массиву:
with input as (
    select ord, txt::pg_lsn as wal
    from unnest($1::text[]) with ordinality as t(txt, ord)
),
claimed as (
    insert into inbox_wal (wal, slot)
    select wal, $2 from input
    on conflict do nothing
    returning wal
)
select i.ord from input i join claimed c on c.wal = i.wal     -- выиграли гонку: работаем
union all
select i.ord from input i join inbox_wal w
  on w.wal = i.wal and w.slot = $2                            -- свой LSN: перечитка
Проигравшие конфликт работу не делают — только закрывают позицию у себя. Веерный налог остался, но стал дешевле.
Шардирование репликации
Пачки сократили число запросов, но не число лишних розыгрышей: каждую строку по-прежнему пытаются закрепить все N читателей. Хочется, чтобы каждый ходил в базу только за своими строками. Строки делятся на 64 шарда по остатку от id — дальше весь вопрос в том, кто владеет шардом.
Лок как единица владения
Владение — это сессионный advisory-лок PostgreSQL. Берётся и отдаётся он так:
select pg_try_advisory_lock(0x7761, 5);   -- true, если шард 5 был свободен; false - занят
select pg_advisory_unlock(0x7761, 5);     -- отдали
Первое число — пространство ключей (у шардов это 0x7761), второе — номер шарда. Важны три свойства:
try-вариант никогда не ждёт и не отбирает: либо лок свободен и становится нашим, либо нет;лок живёт ровно столько, сколько живёт сессия: процесс упал, сеть порвалась, контейнер убили — PostgreSQL снимает его сам;
все локи видны в
pg_locks, то есть владение можно прочитать запросом, а не выяснять перепиской между читателями.
Берём и отдаём сразу несколько
Шарды добираются и отдаются пачкой, по одному запросу на операцию. У добора важен возврат: взялись не обязательно все.
select s, pg_try_advisory_lock(0x7761, s) from unnest($shards::int[]) as s;   -- добор
select pg_advisory_unlock(0x7761, s)      from unnest($shards::int[]) as s;   -- отдача
Сколько шардов брать
Своя доля — это 64, делённые на число живых читателей, значит надо знать, сколько нас. И тут мешает деталь: в pg_locks не видно того, кто не держит ни одного шарда. Первый запустившийся читатель увидел бы пустую группу, счёл себя единственным и забрал все 64.
Поэтому при старте читатель занимает ещё один лок — регистрационный, в отдельном пространстве ключей:
-- вход в группу: первый свободный номер участника
select m from generate_series(0, $members_max - 1) as m
where pg_try_advisory_lock(0x7762, m)   -- 0x7762 - пространство регистрации
limit 1
limit 1 останавливает генерацию на первом успехе: табличная функция в FROM вычисляется лениво, поэтому лишних локов не захватывается.
Теперь один запрос отвечает сразу на оба вопроса — сколько нас и кто что держит:
select objid::bigint as shard, pid, classid::bigint as ns
from pg_locks
where locktype = 'advisory'
  and classid in (0x7761::oid, 0x7762::oid)   -- шарды и регистрации
  and objsubid = 2 and granted
Строки с classid = 0x7762 — это участники, их число и есть размер группы; строки с 0x7761 — занятые шарды.
Ребаланс: проверяем, что шарды всё ещё наши
Раз в секунду читатель перечитывает pg_locks и сравнивает своё хозяйство с причитающейся долей:
var (others, members) = await ReadLocksAsync(ct);
var target = (int)Math.Ceiling(shardCount / (double)members);

if (mine.Count > target)      await ReleaseAsync(Largest(mine, mine.Count - target), ct);
else if (mine.Count < target) await AcquireAsync(Free(others, target - mine.Count), ct);
Лишнее отдаём, недостающее добираем — но только из ничейных: Free исключает и свои, и чужие шарды, а try-вариант всё равно не дал бы забрать занятый. Поэтому шард всегда переходит от одного владельца к другому через ничейное состояние, и договариваться читателям не о чем.
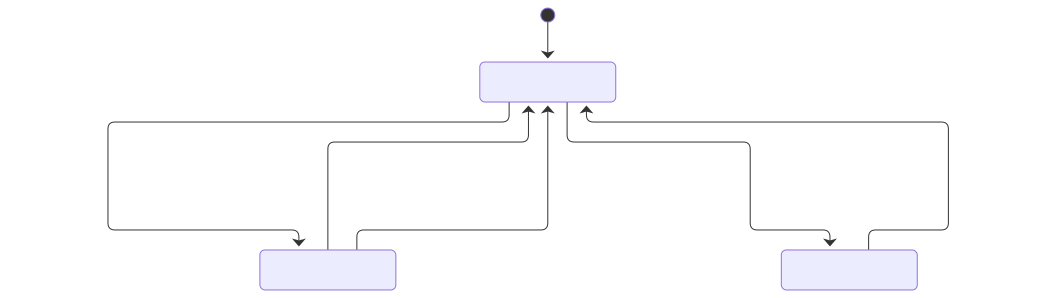
Переход «сессия оборвалась» и есть вся отказоустойчивость схемы: ни heartbeat-таблицы, ни эпох, ни сборщика мёртвых владельцев — умерший читатель освобождает шарды сам, самим фактом смерти.
Проверка строки ничего не стоит
Результат ребаланса — две битовые маски в памяти, поэтому решение по конкретной строке принимается без похода в базу:
var shard = (int)(id % shardCount);
bool mayClaim = isMine[shard] || !heldByOthers[shard];
Условие «мой или ничей» асимметрично намеренно: пропустить строку можно, только если её шард точно держит кто-то другой. Ничейный шард читатель берёт, даже если тот ему не причитается — пока шарда никто не подобрал, работу обязан сделать кто-то. Если ничейный шард возьмут двое, разрулит inbox_wal: расхождение безопасно в сторону лишней работы, но не в сторону пропущенной. В цифрах это видно как skipped = 1044 вместо нуля — столько строк попало в окно передачи шардов.
Две ловушки
var connection = new NpgsqlConnection(
    new NpgsqlConnectionStringBuilder(connectionString) { Pooling = false }.ConnectionString);
Сессионный лок на пулящемся соединении живёт своей жизнью: соединение вернётся в пул вместе с локом, а сессия под ним продолжит его держать за уже освободившимся владельцем.
И второе: ребаланс идёт тем же потоком, что и обработка, строго между пачками. Иначе шард можно отдать посреди собственной незавершённой работы, и новый владелец продублирует её.
Границы надёжности
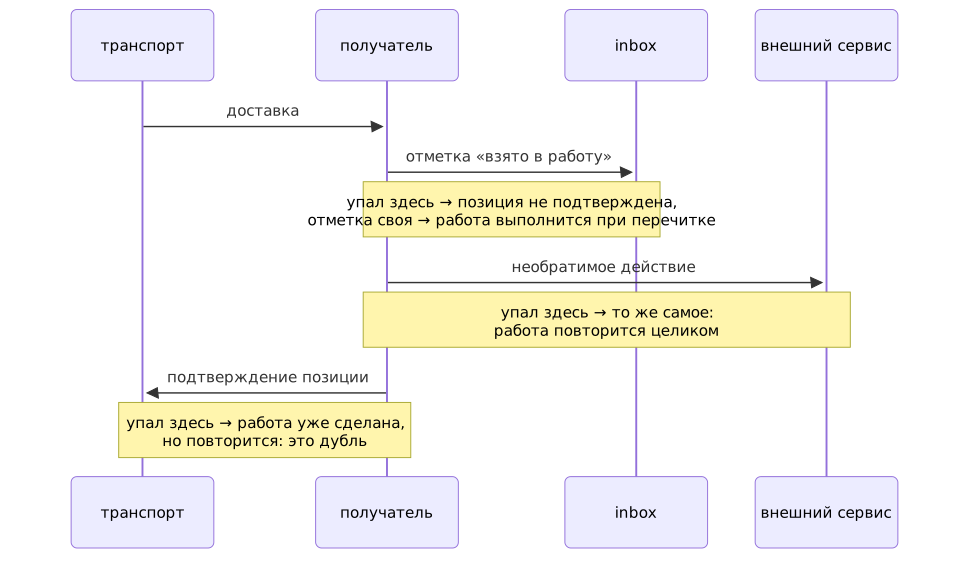
Первые две проблемы из-за падений закрывает inbox. Третью проблему падения принято закрывать отметкой done после работы. Это отдельная транзакция и нагрузка на базу данных, которая искажает замеры. Но окно дублей она не закрывает, а сдвигает: падение между выполненной работой и записью done даёт ровно тот же повтор. В тесте такой отметки нет.
Причина не в схеме, а в условии задачи: необратимое действие происходит вне транзакции базы. Между ним и любой отметкой о нём всегда есть момент, в который процесс может умереть, и после перезапуска «сделал, но не записал» неотличимо от «не сделал». Поэтому инбокс даёт одного владельца обработки и отсутствие потерь, а ровно-однократность эффекта достижима только там, где в ней участвует приёмник — ключ идемпотентности на его стороне, — либо там, где действие можно затащить в ту же транзакцию, что и отметку, и тогда инбокс не нужен вовсе.
Идемпотентным должен быть не код консъюмера, а сама запись в хранилище в этом консьюмере.
Прогоны
Корректность проверяется счётчиками, а не рассуждением:
public bool Success => Error is null && SendFailed == 0 && Sent == Messages && Processed == Messages
                       && DistinctIds == Messages
                       && WorkCalls == Messages && WorkDistinct == Messages;
WorkCalls и WorkDistinct приходят из no-op сервиса, который про инбокс ничего не знает. Все 16 прогонов дали OK — но это корректность конкретных прогонов, а не отказоустойчивость схемы: сбоев в них никто не вносил.
Отправители стартуют только после того, как слот действительно стримит: живой контейнер этого ещё не значит, а записанное до слота в поток не попадёт.
SELECT count(*) FROM pg_replication_slots s
WHERE s.slot_name = $1 AND s.active_pid IS NOT NULL AND s.restart_lsn IS NOT NULL
  AND EXISTS (SELECT 1 FROM pg_stat_replication r WHERE r.pid = s.active_pid AND r.state = 'streaming')
SELECT slot_name FROM pg_replication_slots WHERE slot_name LIKE $1 AND active_pid IS NOT NULL
Этим тест проверяет, что журнал не читает никто лишний: чужой CDC-конвейер декодирует те же вставки и ложится в прогон фоном.
Остальное из той же серии: топик пересоздаётся на каждый прогон, а метаданные запрашиваются по всему кластеру (запрос по имени при включённом автосоздании сам создаёт топик с одной партицией); exchange и очередь создаются до выпуска отправителей, иначе непривязанный routing key тихо потерял бы весь поток. Запусков в серии 18: прогрев на 20 000 сообщений, 16 прогонов таблицы и зонд дрейфа — повтор первой комбинации в конце.
Результаты
100 000 сообщений на прогон, 200 отправителей, свои слоты и топик на каждый прогон:
конвейер | 1 получатель | 2 | 4 | 8 |
|---|---|---|---|---|
прямое чтение WAL | 1.19 | 1.21 | 1.48 | 1.88 |
прямое чтение, 64 шарда | 1.27 | 1.33 | 1.66 | 1.60 |
Debezium → Kafka | 2.35 | 1.99 | 2.03 | 2.16 |
Debezium → RabbitMQ quorum | 2.20 | 2.10 | 2.25 | 2.21 |
мс CPU на сообщение, суммарно по всем участникам.
Полная таблица результатов по ссылке.
Откуда берётся двукратная разница при одном получателе, что происходит с ней при росте числа получателей и почему быстрее ни один сценарий не стал.
Разложим двукратную разницу по участникам, CPU-секунды за прогон:
PostgreSQL | Kafka | RabbitMQ | Debezium | веб | тест | сумма | |
|---|---|---|---|---|---|---|---|
прямое чтение WAL | 64.0 | 0.7 | 0.3 | — | 38.5 | 15.2 | 118.7 |
Debezium → Kafka | 78.0 | 16.9 | 0.4 | 75.8 | 45.7 | 18.3 | 235.1 |
Колонки простаивающих брокеров не нули: контейнеры подняты и в тех прогонах, где не участвуют. Они одинаково, но незначительно искажают все замеры.
Брокер не разгружает базу
В пути через Kafka PostgreSQL тратит 78 CPU-секунд против 64 при прямом чтении — не меньше, а больше. Debezium читает тот же WAL через тот же pgoutput и ту же публикацию, просто декодирование потребляет он, а не получатели. Сверху — 76 секунд Debezium и 17 самой Kafka.
Эти же ресурсы можно отдать базе
93 CPU-секунды на Kafka и Debezium — это 0.93 мс на сообщение, почти столько же, сколько весь путь прямого чтения целиком. В пересчёте на ядра за окно прогона в 46.4 секунды:
Debezium: 75.8 / 46.4 = 1.63 ядра
Kafka:    16.9 / 46.4 = 0.36 ядра
вместе                  2.0 ядра
Плюс память: Debezium Server 820–900 МБ в среднем за прогон, Kafka 980–1150 МБ. Схема с кафкой ест два ядра и два гб памяти. При отказоустойчивости можно умножать на три.
Отдайте те же ресурсы Postgres и он выдержит больше нагрузки.
Ускорения нет
Все замеры выше сделаны в лучшем для брокера режиме: работа почти бесплатна, 0.3 мс. Контрольный опыт — та же обвязка, но вместо Task.Yield() стоит Task.Delay(1), что на Windows даёт 15.3 мс (системное разрешение таймера). 20 000 сообщений:
консьюмеров | Kafka | RabbitMQ | репликация | разброс |
|---|---|---|---|---|
2 | 147 | 150 | 144 | 4 % |
4 | 282 | 299 | 290 | 6 % |
8 | 556 | 588 | 571 | 6 % |
сообщений в секунду.
Это соответствует циклу обработки 13.6 / 14.2 / 14.4 мс вместо 15.3 — на 6–12% быстрее оценки N / 15.3 мс, потому что HTTP-вызов частично перекрывается ожиданием соседних консьюмеров. Линейность по числу получателей при этом точная, а разница между транспортами исчезает полностью.
Порог, за которым транспорт перестаёт быть виден, — порядка половины миллисекунды на сообщение: это оценка по двум точкам, 0.3 мс и 15.3 мс, а не измеренная константа. Любая реальная обработка лежит далеко за ним.
Реальный эффект можно получить только если вы можете бесконечно масштабировать консьюмеров. Тогда в сценариях с логической репликацией можно упереться в скорость декодирования WAL на сервере. Но и это ограничение можно преодолеть, читая синхронизированные слоты с реплик Postgres.
Масштабирование читателей
Цена CDC для брокера от числа получателей не зависит — журнал декодирует один процесс. Цена прямого чтения зависит: база платит около 9.4 CPU-секунды за каждого дополнительного читателя, то есть
1.19 + 0.094 × (N − 1) мс на сообщение // N = 8: модель 1.85, измерено 1.88
Пересечения в измеренном диапазоне нет: при восьми получателях оба прямых сценария (1.88 и 1.60) дешевле обоих брокерных (2.16 и 2.21). По линейной модели горизонталь CDC (2.16) пересекается при N ≈ 11 — но это экстраполяция из четырёх точек, а не результат.
Любопытное совпадение: max_replication_slots и max_wal_senders в Postgres по умолчанию равны 10, а по этим же данным веер перестаёт окупаться примерно на одиннадцатом читателе. В стенде оба подняты до 64, и это понадобилось только чтобы дойти до восьми получателей с запасом. Дефолт в десять слотов выглядит ровно той границей, за которой схему всё равно пора менять, а не настройкой, которую нужно задирать.
Шардирование снимает половину налога: skipped падает с 700 000 до 1044, раздача выравнивается — самый незагруженный и самый загруженный получатель закрепили 12392 и 12783 сообщения против 9600 и 15800 у неразделённого веера. Но процессорное время базы снижается лишь со 130 до 107 секунд: основная работа — не закрепление, а декодирование журнала в восьми walsender-ах.
Отдельное число не в пользу всех четверых: веб-сервис и тест вместе стоят 50–71 CPU-секунду за прогон — больше любого из брокеров. Доля транспорта в общем счёте невелика, и это довод против того, чтобы оптимизировать именно её; зато эта часть одинакова у всех сценариев и в разнице между ними сокращается.
Цена эксплуатации
Процессор — не единственная статья расходов, и по остальным прямое чтение дороже.
прямое чтение WAL | CDC → брокер | |
|---|---|---|
Где копится лаг отставшего читателя | WAL на диске примари | журнал брокера |
Ограничение роста лага |
| retention брокера |
Что мониторить |
| лаг группы |
Переезд при failover |
| брокер живёт отдельно |
Раздача работы | своя, на advisory-локах, с | группа консьюмеров брокера |
Эволюция схемы | контракт — имена колонок рабочей таблицы | конверт CDC со своей схемой |
Строка про wal_status — главный эксплуатационный риск подхода: один залипший читатель кладёт примари по диску, и это весомее одной миллисекунды процессорного времени. В стенде лимит выставлен в 4 ГБ, но по умолчанию его нет.
Важно: с PostgreSQL 16 логическое декодирование работает со standby-реплики (но только с 17 отказоустойчиво и без лишних накладных расходов) — веер можно целиком убрать с мастера. В этом замере этого нет.
Чего нет в сравнении
Измерения задержки и скорости чтения. На практике она зависит от скорости консъюмера, а не транспорта.
Отказов. Сбоев между отметкой, работой и подтверждением никто не вносил.
Горизонтального масштабирования. Это тема отдельно статьи и замеров, появляется слишком много переменных.
Тюнинга сжатия и
batch.sizeу продюсера Kafka.
Аутбокс-поллинга (SELECT … FOR UPDATE SKIP LOCKED по таблице событий) здесь нет намеренно: он мерялся в первой статье и проиграл — опрос ложится запросами на ту же базу, которая уже принимает весь поток вставок, и чем больше сообщений, тем дороже он обходится. Режим, который разбирается здесь, — как раз большой поток, поэтому поллер в сравнение не возвращался.
Процессорные секунды сняты сэмплером с периодом 2–3 секунды: средние корректны, короткие пики могли не попасть.
Вывод
Событие обязано попадать в базу той же транзакцией, что и данные, — иначе это dual write, и он теряет события при любых настройках брокера (Задача двух генералов).
Дальше вопрос в том, кто вычитывает журнал:
Получателей единицы, оба конца у одной команды. В измеренном диапазоне прямое чтение дешевле по процессору — 1.19 против 2.20–2.35 мс на сообщение при одном получателе, — и база в брокерном варианте работает больше, а не меньше. Цена: эксплуатация слотов и собственный мониторинг удержания WAL.
Получателей много. Цена веера растёт примерно на 0.094 мс за читателя, цена CDC плоская; по экстраполяции они сравниваются около одиннадцати получателей, и упереться можно раньше — в
max_wal_senders. До 4 читателей — досточно простой логической репликации, от 4 до 10 (минус слоты для физической репликации) — нужно прикручивать шардирование. Более 10 — другая схема, тестировать и считать.Потребитель в другой зоне ответственности. Нужен контракт событий — выделенная таблица-аутбокс, — а за ней уже брокер: читать чужие рабочие таблицы значит зависеть от физической схемы владельца.
Зачем все таки нужен брокер
Начнём со сценария для которого Kafka была спроектирована — кликстим для аналитики. События пишутся сразу в брокер, причем батчами. Потеря части событий некритична для бизнеса. Забираются и обрабатываются события тоже батчами.
Я провел такой замер. Отдельный стенд, отправитель пишет прямо в брокер, минуя таблицу. 200 000 сообщений, восемь консьюмеров:
Kafka | RabbitMQ quorum | логическая репликация | |
|---|---|---|---|
мс CPU на сообщение | 0.45 | 0.58 | 2.22 |
Здесь брокер в своей стихии: когда ему не нужно ничего вычитывать из базы.
Как чистый транспорт Kafka дешевле всех. RabbitMQ Streams дает практически тот же результат, лишь немного уступая Kafka. RabbitMQ Quorum Queue отстает, особенно под нагрузкой. Но выруливает за счет возможностей (DLX, Routing) и менее требователен к оперативной памяти.
С основной таблицей результатов эти числа не сопоставимы — другая версия стенда, другой объём прогона, отправка минуя веб-сервис. Гарантия здесь другая: результат бизнес-операции уже лежит в базе, а отправить его ещё и в брокер значит писать в два хранилища, между которыми процесс может умереть.
Если отбросить кликстрим и прочие случаи, где события вообще не попадают в базу, у Kafka и RabbitMQ остаётся своя конфигурация, и она довольно узкая: много сервисов-отправителей и много получателей, причём у каждого своя база на отдельном сервере.
Отправители не упираются в запись, потому что пишут каждый в свою базу.
Получатели держат свои инбоксы, тоже каждый у себя.
Брокер связывает это всё и делит поток по партициям.
Именно в такой конфигурации окупаются и его процессорное время, и его память: одного декодера журнала на всех тут просто нет, как нет и единой базы, которой можно отдать освободившиеся ресурсы.
Но у такой архитектуры своя цена — распределённые транзакции, согласованность между базами, контракты между командами, — и она заметно больше, чем разница в миллисекундах процессорного времени. Об этом я напишу в следующих статьях.
Общий вывод не изменился:
Если у вас один сервер\кластер базы и на нём PostgreSQL, то: пока база вывозит вашу нагрузку, брокер вам не нужен.
Код и полные таблицы — https://github.com/gandjustas/habr-aspnet-kafka/tree/outbox-to-inbox. Замер без аутбокса — ветка queue-load-test.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.