Локальная ИИшница: рецепт приготовления
Статья для тех, кто уже имеет опыт работы с облачными ИИ, но в силу причин вынужден перейти на локальную ИИшку.
Здесь я опишу несколько неожиданных проблем с выбором железа и софта, которые мне пришлось решить, имея на старте несколько противоречивых требований, и что в итоге получилось.
Спойлер: я прошел путь от «лучше, чем ничего» до «гораздо лучше, чем ничего!».
В этой статье не будет ничего про особенности и сравнение моделей, написание скилов или mcp-серверов. Здесь только первый шаг – связка железа и софта (ИИшницы), чтобы у меня (Java-разработчика) в IDE IDEA появился ИИ-ассистент приемлемого уровня, от которого можно получать реальную пользу.
Причины запуска эксперимента
Причин всего две: конфиденциальность и исследовательский зуд. Тем, кто хорошо знаком с ИИ этот блок можно смело пропускать.
Скрытый текст
Конфиденциальность
Если вы задумываетесь над тем, чтобы применить ИИ в работе, то всегда нужно иметь в виду, что облачные ИИшки часто заграничные. А трансграничная передача персональных данных и/или коммерческой тайны – это не только большой риск для вашего работодателя, но и для вас лично (погуглите какие статьи ГК и УК могут быть применены, если вдруг такие факты вскроются).
Если для себя лично, то это, разумеется, Ваше дело кому и в каком объеме рассказывать свои секреты. Просто в какой-то «прекрасный» момент можно осознать, какой фантастический объем личных данных Вы передаете в бесчисленных чатах с облачными ИИ. И дело не в том, что владельцы этих сервисов могут используют эти данные для обучения новых ИИ моделей. Дело в том, что этот цифровой след останется навсегда и однажды может попасть в нехорошие руки.
Я всегда держу в уме, что даже если отдельные данные не таят в себе какой-то угрозы, то совокупность множества этих данных уже может дать злоумышленнику ключи от всех дверей. И не стоит удивляться, если позвонивший мошенник будет знать имена родственников, девичью фамилию матери, кличку первого питомца, даты, адреса и так далее.
Для меня ни тот, ни другой сценарий не приемлем, поэтому задумался именно о локальной ИИшке.
Эксперименты с ИИ
Я впечатлен достижениями в области ИИ. Видеть, как на глазах меняется наша жизнь и не принимать в этом хоть минимального участия – это все равно, что айтишнику в резюме писать «владею компьютером: ворд, эксель».
Но это и не «подножка уходящего трамвая», на которую срочно нужно запрыгнуть: с каждым днем инструментарий все более дружественный и все менее требует глубокого понимания работы. Вероятно, уже через несколько лет порешаются и вопросы с галлюцинациями моделей, и с самоуправством агентов и прочими вопросами безопасного использования ИИ. Скорее всего нормализуются цены на железо и окончательно оформится новый класс устройств с унифицированной памятью «для дома и семьи», на которых можно будет запускать огромные модели.
Так что можно подождать 5-10 лет и тогда уже войти в эту тематику – созревшую и user-friendly. Особенной если не планируете менять работу в ближайшие годы и не боитесь выглядеть динозавром на собеседовании, когда начнутся вопросы про применение ИИ.
Но тогда получается мы пришли в айти только из-за денег, а это слишком скучно, чтобы об этом писать и про это читать.
Выбор и настройка железа
Тем, кто уже укомплектован оборудованием и не собирается ничего менять можно сразу переходить к следующей главе – подбору и настройкам софта.
Остальным предлагаю любопытный кейс из серии: «А что, так можно было?»
Скрытый текст
Если бы я начинал «с чистого листа», то, возможно, решил бы вопрос иначе.
Но у меня уже есть ноутбук – это Huawei MateBook X Pro на intel 1360p, 32 ГБ ОЗУ и 2 ТБ накопитель. Он легкий, относительно производительный и автономный. А еще он эстетически приятный и за ним приятно работать! (Большое спасибо Apple, что показала всем – ноутбук может доставлять эстетическое удовольствие.) На нем уже есть удобная для меня винда с набором софта, который покрывает все мои потребности.
Поэтому в первую очередь я искал возможность гармонично дополнить этот ноут «за недорого» и получить производительность хотя бы 50 токенов в секунду.
Чтобы не изобретать велосипед я сперва почитал, как вообще люди решают для себя подобные проблемы.
MacBook с унифицированной памятью
Я не любитель макбуков, но вариант по-своему интересный. Мобильность – да, прекрасная. Скорость инференса (по отзывам) несколько ниже желаемой, но не драматично.
А вот цена вопроса огорчила, ведь по моим прикидкам потребуется версия как минимум с 36 ГБ весьма не дешевой. Тем более под санкциями: с сомнительной гарантией и риском, что что-то заблокируют… Такие развлечения не для меня.
AMD Strix Halo и аналоги с унифицированной памятью
На момент, когда я делал выбор и анализировал варианты, подобные устройства еще только-только начинали появляться и мое представление о них было весьма поверхностным. Даже сейчас их не встретить в сетевых магазинах. Хотя понемногу появляются какие-то обзоры, замеры, впечатления. И эти замеры выглядят весьма многообещающими.
Да, пока производительности маловато (мягко говоря), но уже скоро… Чтобы производительность вышла на приемлемый уровень (хоть как-то сравнимый с макбуком) нужно туда и память поставить с пропускной способностью, как у макбука. Но тогда и цена такого девайса станет существенно выше.
Так что в среднесрочной перспективе этим устройствам так и оставаться многообещающими (в контексте ИИ-задач).
Стационарный комп с дискретной видеокартой
Можно взять интересный по производительности вариант, да еще и с возможностью апгрейда. Но ни о какой мобильности речи уже не идет – тоже не подходит.
Мощный игровой ноутбук с дискретной видеокартой
Тут сомнительно сразу все: и мобильность, и цена, и производительность (про эстетику и шум под нагрузкой молчу – это дело вкуса).
За такие деньги даже такой прагматик и кроила, как я, взял бы лучше макбук.
eGPU
Когда возникло стойкое ощущение, что задача не имеет красивого решения и придется частью хотелок пожертвовать – в памяти всплыл экзотический вариант с eGPU, о котором иногда пишут геймеры, но никто из ИИ-исследователей не обмолвился. А ведь это оно самое! Отсоединяю единственный кабель – и у меня легкий ноут; присоединяю – и у меня мощная машинка для моих экспериментов. И все это из легко доступных комплектующих и за приемлемую цену.
eGPU-док
На Озоне приобрел «коробочку» eGPU-док Wikingoo под Thunderbolt 4 /USB 4, выдающий еще и питание для ноута до 85 Вт по тому же кабелю. Уже появились варианты с Thunderbolt 5, но это важно только если планируете играть - для задач ИИ хватит и четверки. Эстетика у коробочки сомнительная, но я спрятал ее за монитор.
По стабильности работы по USB 4 (процессоры AMD) ничего не могу сказать, но под Thunderbolt 4 завелось без проблем (хотя и с особенностями, о которых дальше).
Большой плюс – никаких экзотических разъемов вроде OCuLink и возможность горячего подключения/отключения.
Цена на момент покупки: 18+ т.р.
Блок питания
Изначально взял блок питания ориентируясь исключительно на мощность. И пожалел…
«Традиционный» БП в связке с моим eGPU-доком шуршал вентиляторами всегда. Да, не громко, но всегда. В итоге – первый БП на Авито, а сам в магазин за более дорогим, но бесшумным в моих сценариях: полупассивным на 850 Вт (при ожидаемом потреблении до 400 Вт заложил удвоенную мощность, чтобы вентилятор не включался вовсе).
Цена: 11+ т.р.
Видеокарта
Изначально поскупился и взял народную rtx 3060 с 12 ГБ VRAM. И пожалел…
Да, во всех статьях пишут, что это «рабочий минимум» для начала. По мне – это потраченное время и деньги.
Нужно учитывать, что уже при старте винда для каких-то своих целей забирает 1,5-2 ГБ VRAM на той карте, которая «рисует кадры» на монитор. Да, есть лайф-хак о котором расскажу дальше, но узнал я о нем только недавно. Да и ситуацию бы это улучшило не значительно – интересные модели все равно бы не запустились. Ведь если у карты 12 ГБ VRAM, то это не значит, что на ней можно запустить модель размером 12 ГБ. Есть куча накладных расходов (например, KV-кэши), которые в реальности сильно приземляют оптимизм. Скорость генерации при этом была бы из серии «лучше, чем ничего».
В итоге – первая видюха на Авито, а сам в магазин за второй – rtx 5070 ti, у которой уже хотя бы 16 ГБ VRAM – вот это уже приемлемый минимум, от которого можно добиться большего, чем «Hello, world!».
Цена: 92 т.р. (на момент покупки, сейчас таких цен уже нет, к сожалению).
Подключение
Поскольку про сам вариант с eGPU я узнал от геймеров, то долгое время оставался в плену геймерской парадигмы подключения, которая выжимает максимум fps и где узкое место – это Thunderbolt 4.
Вариант А:
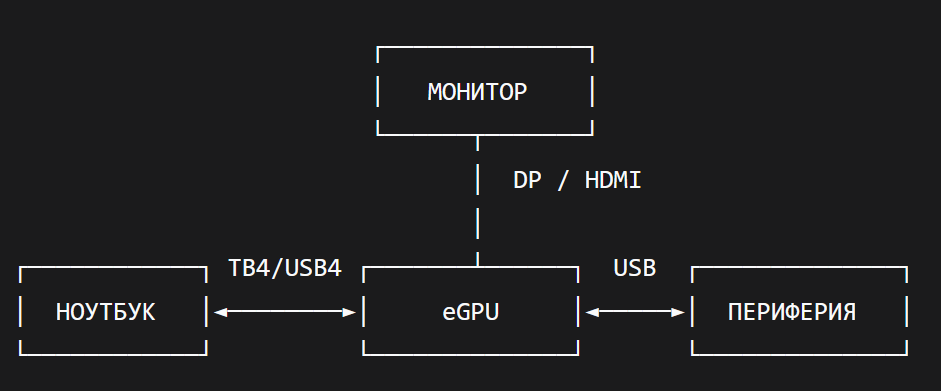
Этот вариант позволяет не гонять отрендеренные кадры обратно на ноут и тем разгрузить Thunderbolt. Нагрузку от периферии (клавиатура, мышь, принтер) можно приравнять к фоновому шуму.
Но оказалось, если fpsне важны, а нужно выжать максимум от внешней видюхи для ИИ-задач, то более правильным будет вариант Б:
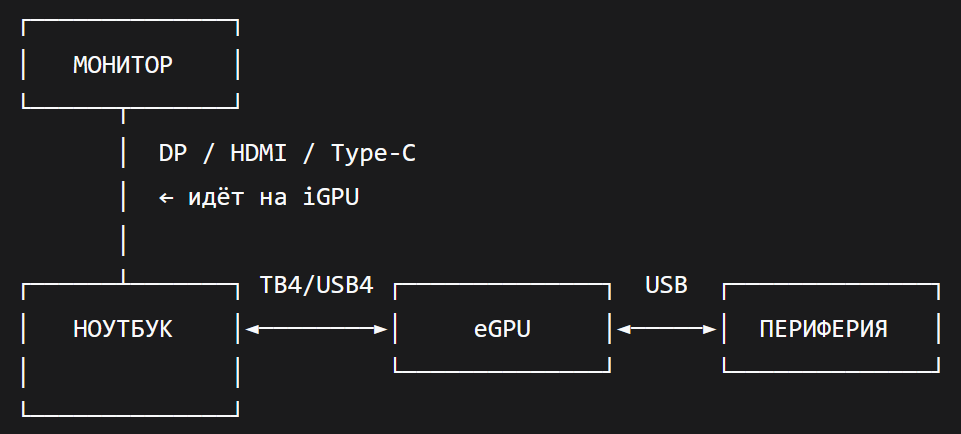
При таком подключении винда не резервирует под себя вообще почти ничего на eGPU и вся она занята только одним – ИИшкой.
Почему в обоих вариантах периферию я подключаю к eGPU? Мобильность – меньше проводов на ноут проще отключать/подключать. В варианте А у меня к ноуту всего 1 кабель, а в Б – 2. Ну и эстетика – меньше проводов в поле зрения.
Что получилось
Я для себя выбрал схему подключения А – «для ленивых», с одним кабелем на ноут. Но тут дело не в одной лишь лени, а в возможности поиграть чуть большем акустическом комфорте. Ноутбуки на Intel шуршат вентиляторами чаще желаемоного, к сожалению. И перекинуть нагрузку с iGPU на eGPU мне показалось будет хорошей идеей. Я не делал точных замеров и не могу это подтвердить цифрами, но мне так проще убедить себя, что сделал все возможное для тишины.
Итого цена вопроса могла бы быть 122+ т.р., если б сразу знал все эти особенности. В ценах октября 2026 тоже самое, наверное, стоит около 170+.
Подводные камни подключения
Все более-менее быстро завелось под Win11, но пришлось полностью отключить гибернацию в винде:
powercfg /hibernate offи повозиться с настройками управления режимом сна для PCI-express (скрин прилагаю). Иначе эта связка неправильно засыпала и очень сложно пробуждалась.
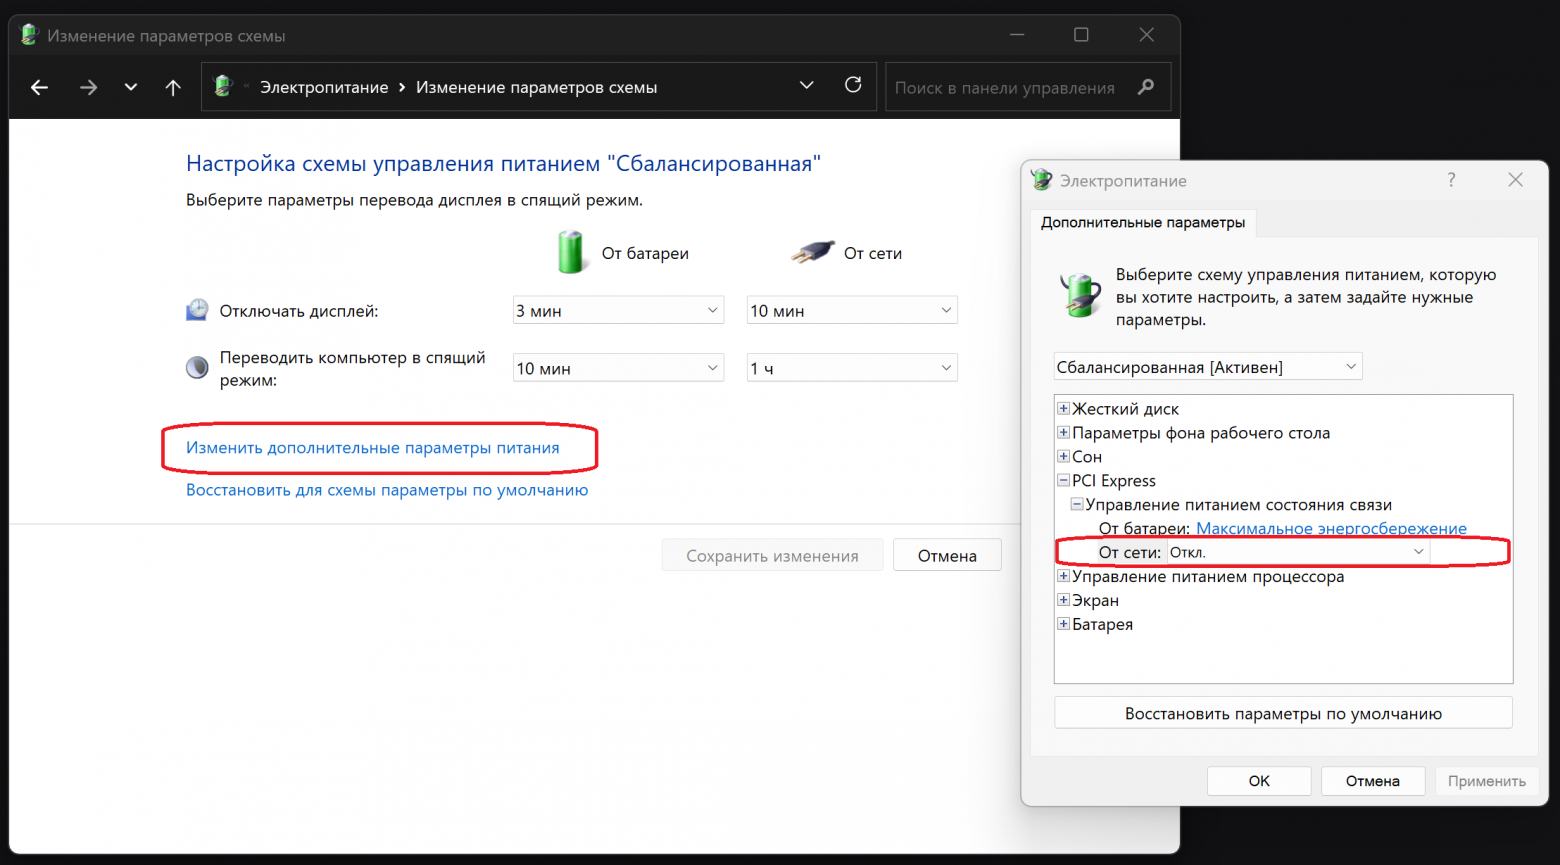
А еще не любая версия драйверов от Nvidia работает нормально. Узнал я об этом, когда недавно накатил себе свежих и режим засыпания поломался. Пришлось откатиться к игровым 610.88 от 28.07.2026. Одним словом, будьте готовы потратить время на подбор параметров.
Выбор и настройка софта
Здесь тоже не все пошло по плану.
Локальный LLM-рантайм
В статьях обычно пишут: «Для старта ставьте Ollama…» Поверил, поставил и сразу снес. Просто потому, что она не позволяет ни выбрать путь, куда устанавливать, ни путь, куда складывать скачанные модели. Все сваливается на диск C:\... А у ноутбуков Huawei есть особенность – они любят делить накопитель на системный (размером всего 200 ГБ) и другой. То есть диск C: и без этого в состоянии перманентного дефицита места, а тут еще Ollama с тяжелыми моделями. Конечно, в первую очередь это камень в огород Huawei – зачем вообще делить накопитель? Но я решил, что если в 2026 приложение не позволяет даже указать путь для сохранения, то стоит ли на него вообще тратить время?
В итоге поставил LM Studio и остался ею доволен – есть довольно понятный UI и достаточный для начала набор настроек. Плюс она хорошо дополняет Bionic.
Ложкой дегтя можно назвать то, что в какой-то момент в LM Studio внезапно пропала возможность скачивать новые модели. Даже не понял, когда это приключилось, т.к. не часто захожу на ту вкладку. Возможно, установка какого-то апдейта или самого Bionic’а поломала – разработчики тут явно что-то намудрили. Но есть возможность скачивать модели через Bionic и этого достаточно.
Настройки LLM-рантайма и параметры запуска моделей
LM Studio сразу переопределил путь, по которому складируются скаченные модели. В остальном же настраивать там особо нечего.
А вот с настройками моделей пришлось пройти некоторый путь проб и ошибок. Очень рекомендую сразу включить сохранение настроек для каждой модели («1» на скрине ниже):
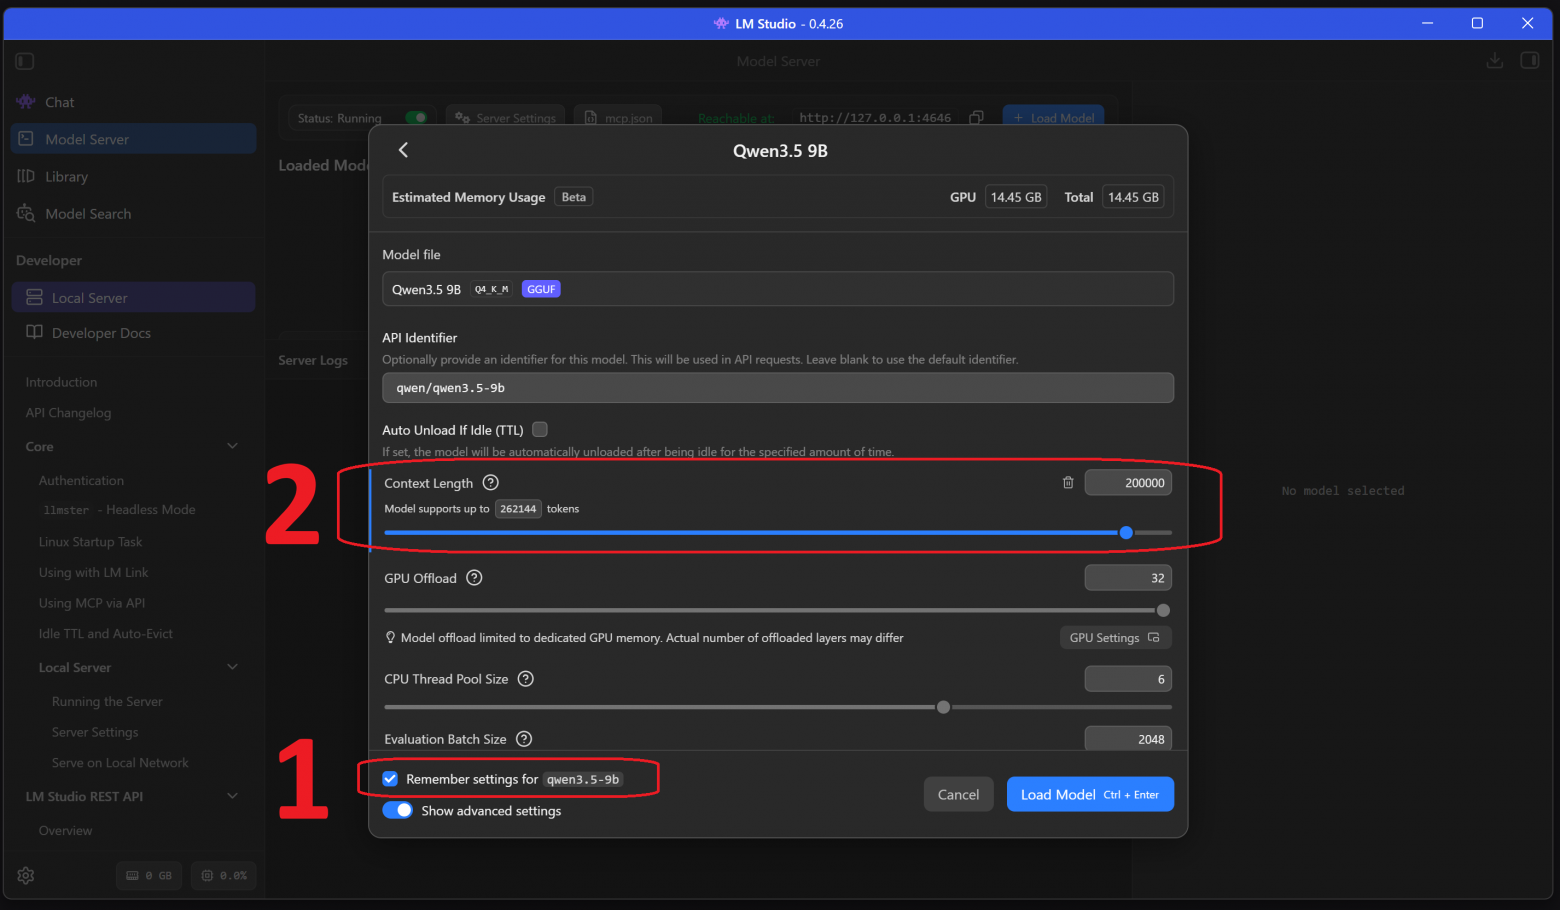
В моем случае все настройки у всех моделей одинаковы, кроме «Context Length» («2» на скрине выше) – его подбирал экспериментально поближе к максимальным значениям, но так, чтобы все уместилось во VRAM (иначе скорость генерации падает до 2-3 токенов в секунду).
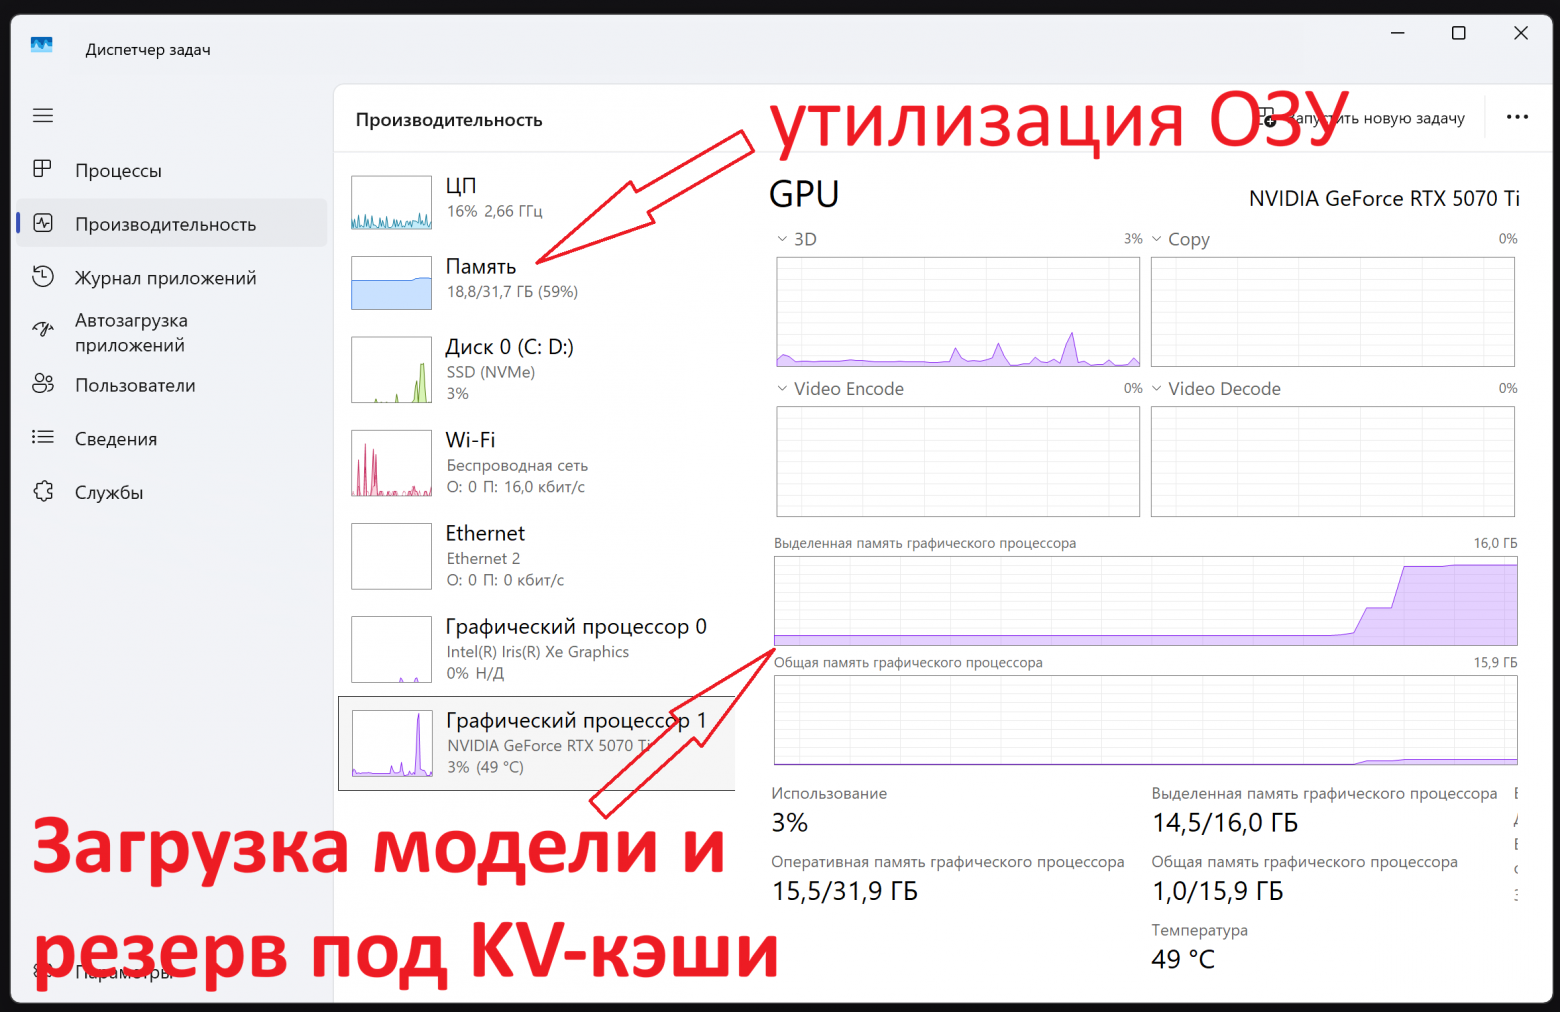
Чтобы утилизация ОЗУ оставалась на приемлемом уровне рекомендую сразу выключить «Keep Model in Memory» и «Try mmap()» («3» на скрине ниже), которые по умолчанию зачем-то включены. Заметного ускорения я от их включения я не заметил, а вот влияние на утилизацию ОЗУ огромное.
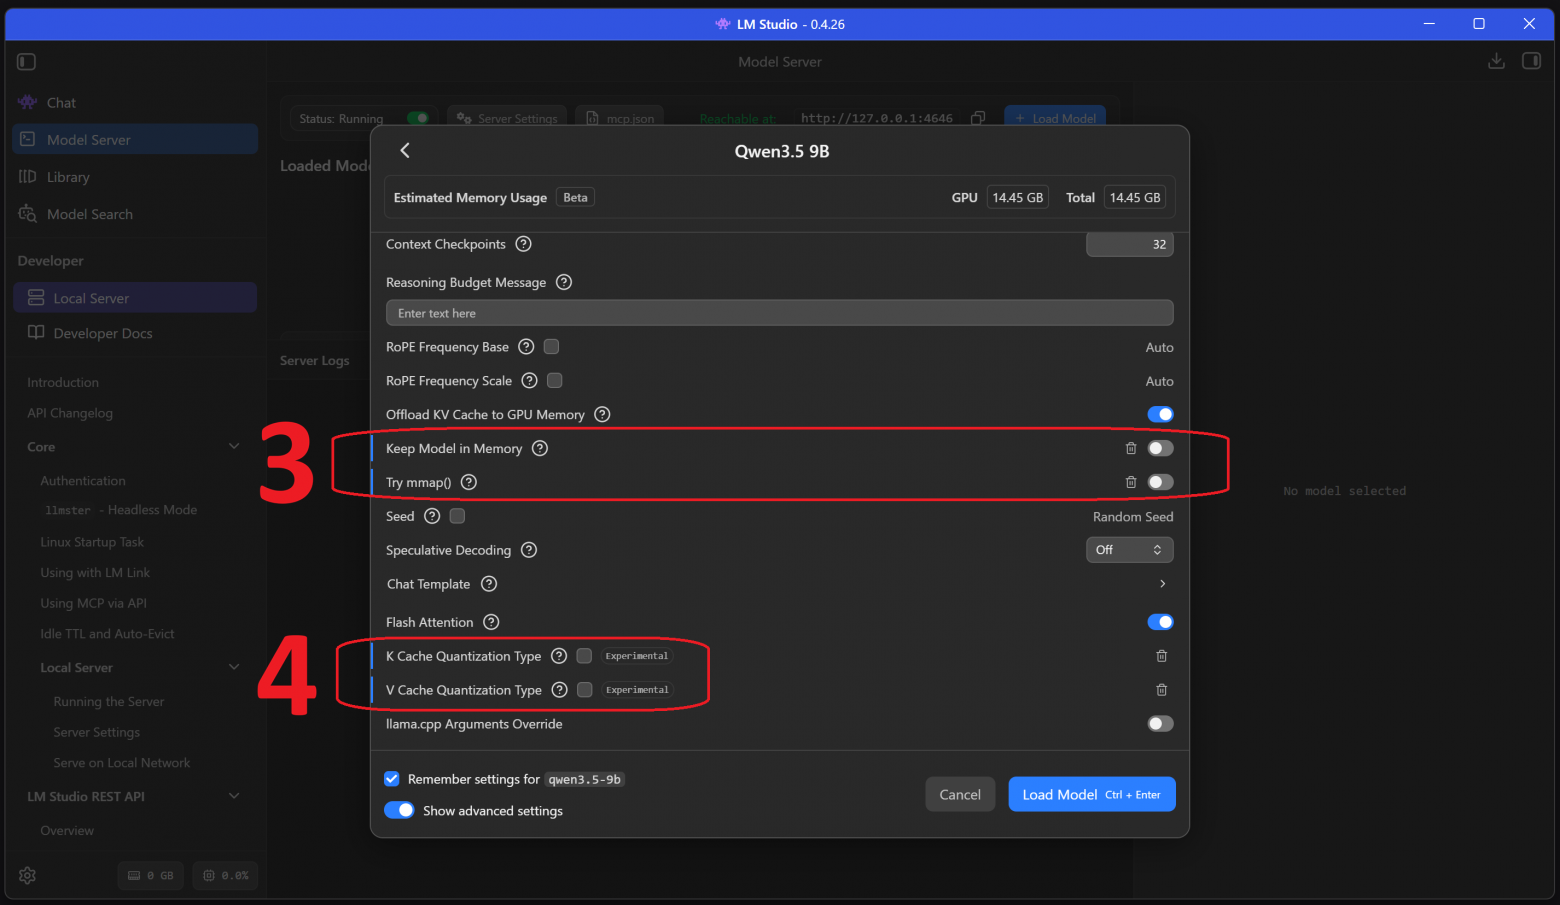
Если есть желание сэкономить немного VRAM можно включить «K Cache Quantization Type» и «V Cache Quantization Type». В теории при выбранном значении Q8_0 не должно быть заметного падения качества генерации при ощутимой экономии по памяти.
Агент - плагин в IDEA
Погуглил какие есть варианты, чтобы подключить себе ассистента прямо в любимую среду разработки и наметил для себя пару кандидатов: плагины Continue и DevoxxGenie.
Сперва заработал только Continue – к нему и стал приспосабливаться. В принципе разобраться не сложно, но он как будто выпал из тренда, в котором сейчас все развивается. Когда у всех сейчас скилы, субагенты и прочее веселье – у Continue рулы. Эта концепция какая-то странная – нужно в самом руле прописать условия, при которых он будет применяться. Например, always или на какое-то расширение (когда закидываете в контекст файл). В итоге в контекст то не подтягивается нужный рул, то подтягивается слишком много (а память не резиновая).
Чат отрабатывал корректно: блоки кода, форматирование – все корректно (хотя и аскетично). Но агент постоянно норовил что-то мне отредактировать и запрашивал разрешения несмотря на явный запрет во всех настройках, где только возможно.
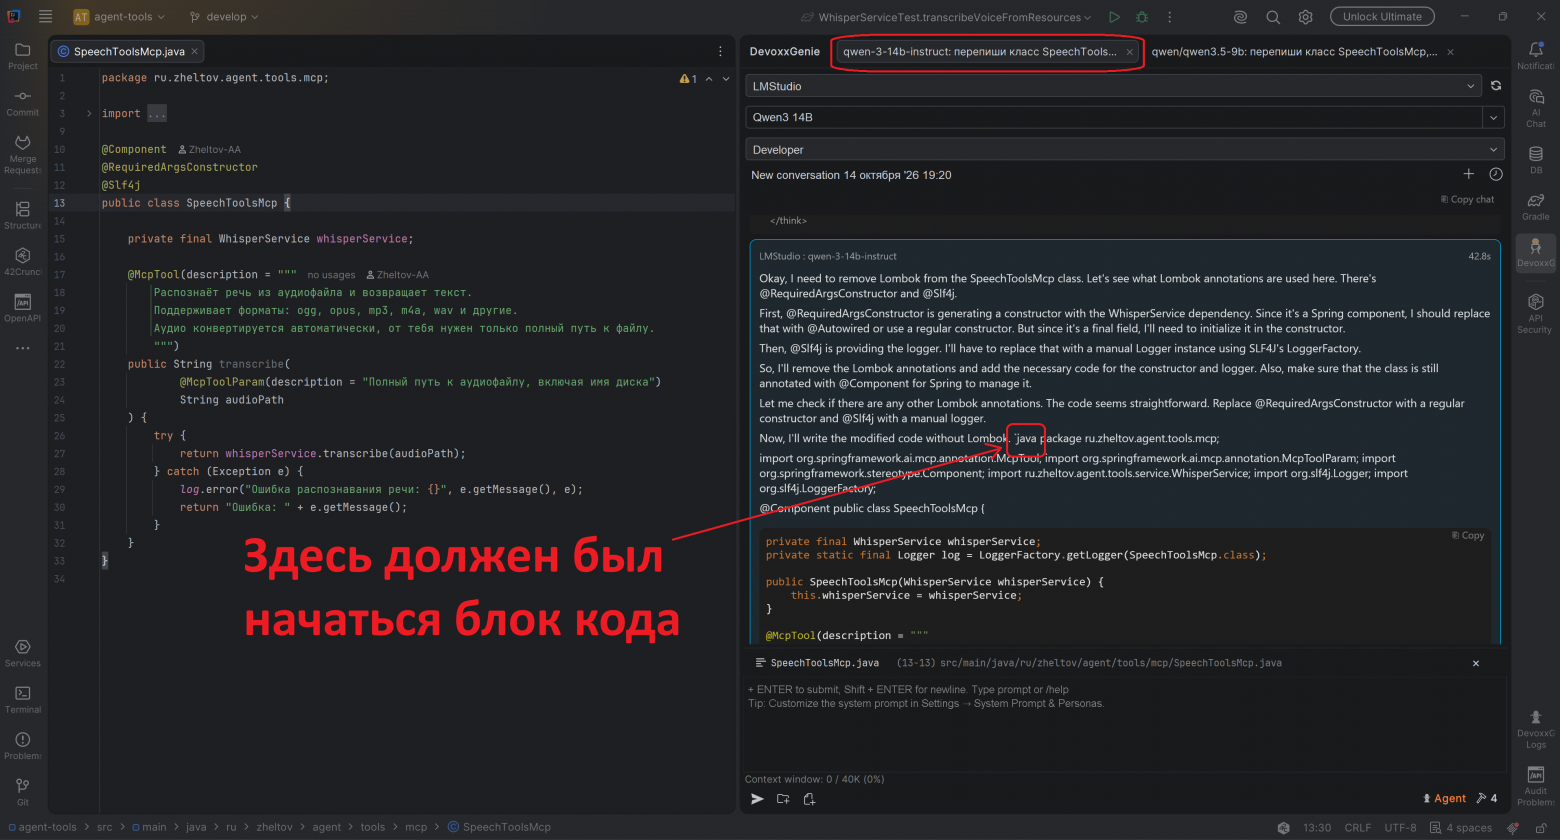
Когда после очередного обновления IDEA этот плагин отказался запускаться я не сильно переживал и переключился на DevoxxGenie. Как оказалось к лучшему: все мейнстримно и привычно. Ложка дегтя – в рендере чата. Можно задавать размеры шрифтов, отступы, скругление углов блоков кода – это удобная возможность подогнать среду под себя. Но, видимо, разработчики плагина решили, что хороший чат – это нарядный чат и постоянно стараются его как-то украсить. Получилось неплохо, но с моделью Qwe3 14B Instruct почему-то эта веселая разметка ломается (см. скрины)
Видно, что на Qwe3 14B Instruct потерялась граница блока кода и началось какое-то месиво, которое потом вдруг выправилось:
Все тоже самое, но на другой модели – успешно (почти):
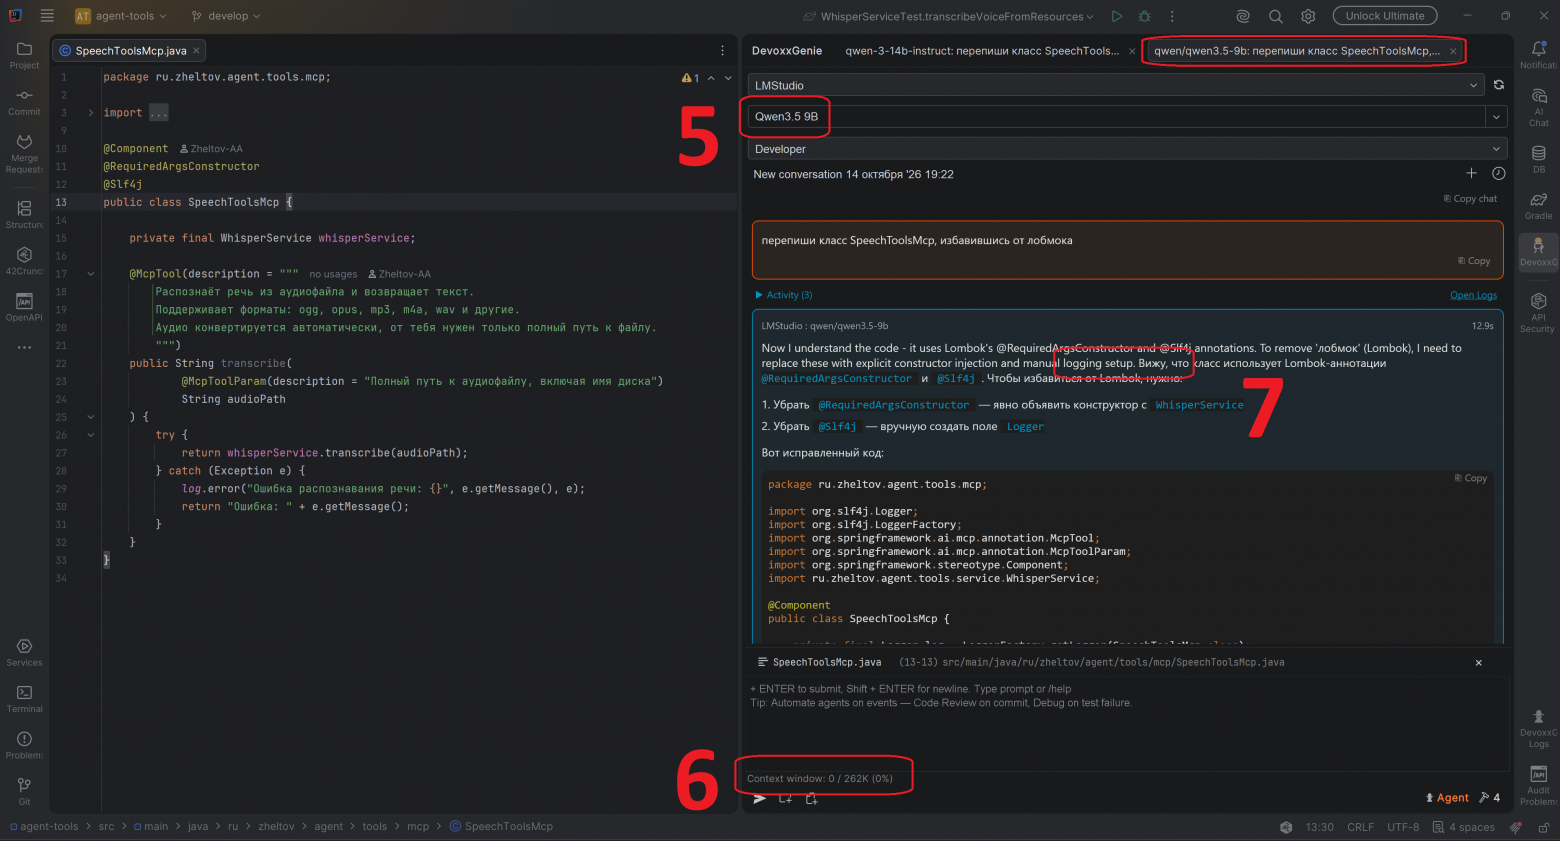
Кстати, выбирать модель в селекторе «5» приходится самому – плагин не знает, какая именно модель сейчас загружена, ведь он работает по OpenAI-совместимому протоколу, который этого не дает. К счастью, плагин хотя бы не пытается загрузить модель сам (хотя API это позволяет – проверено).
Предположу лишь, что это для вычисления потраченных токенов (см. «6» на скрине). Проблема в том, что 262K – это не мною установленный потолок (я выставил 200K), а максимум для выбранной мною в «5» модели. Да и расход считает плохо. Так что пока эта фича бесполезна.
А вот проблемы с рендером чата все-таки есть – см. «7». Несмотря на то, что я выключил стриминг ответов (Enable Stream Mode) и вывод размышлений (Show Thinking). И это именно проблема в плагине – пробовал и через UI самой LM Studio, и через Open WebUI – там все четко (хотя и не так красиво размечено). Надеюсь на будущие исправления.
В итоге несмотря на некоторую глюкавость DevoxxGenie все-таки остался на нем: рисует красиво (включая простые схемы и диаграммы – см. ниже).
Модель использую Qwen3.5 9B: окно контекста до 262K, поддерживает зрение (Vision) для распознавания скринов, хорошая совместимость с DevoxxGenie и поддержка инструментов. Для моих задач – вполне достаточно. Слабовато пишет код, но и Qwe3 14B Instruct его плохо пишет.
А вот обещанная схема:
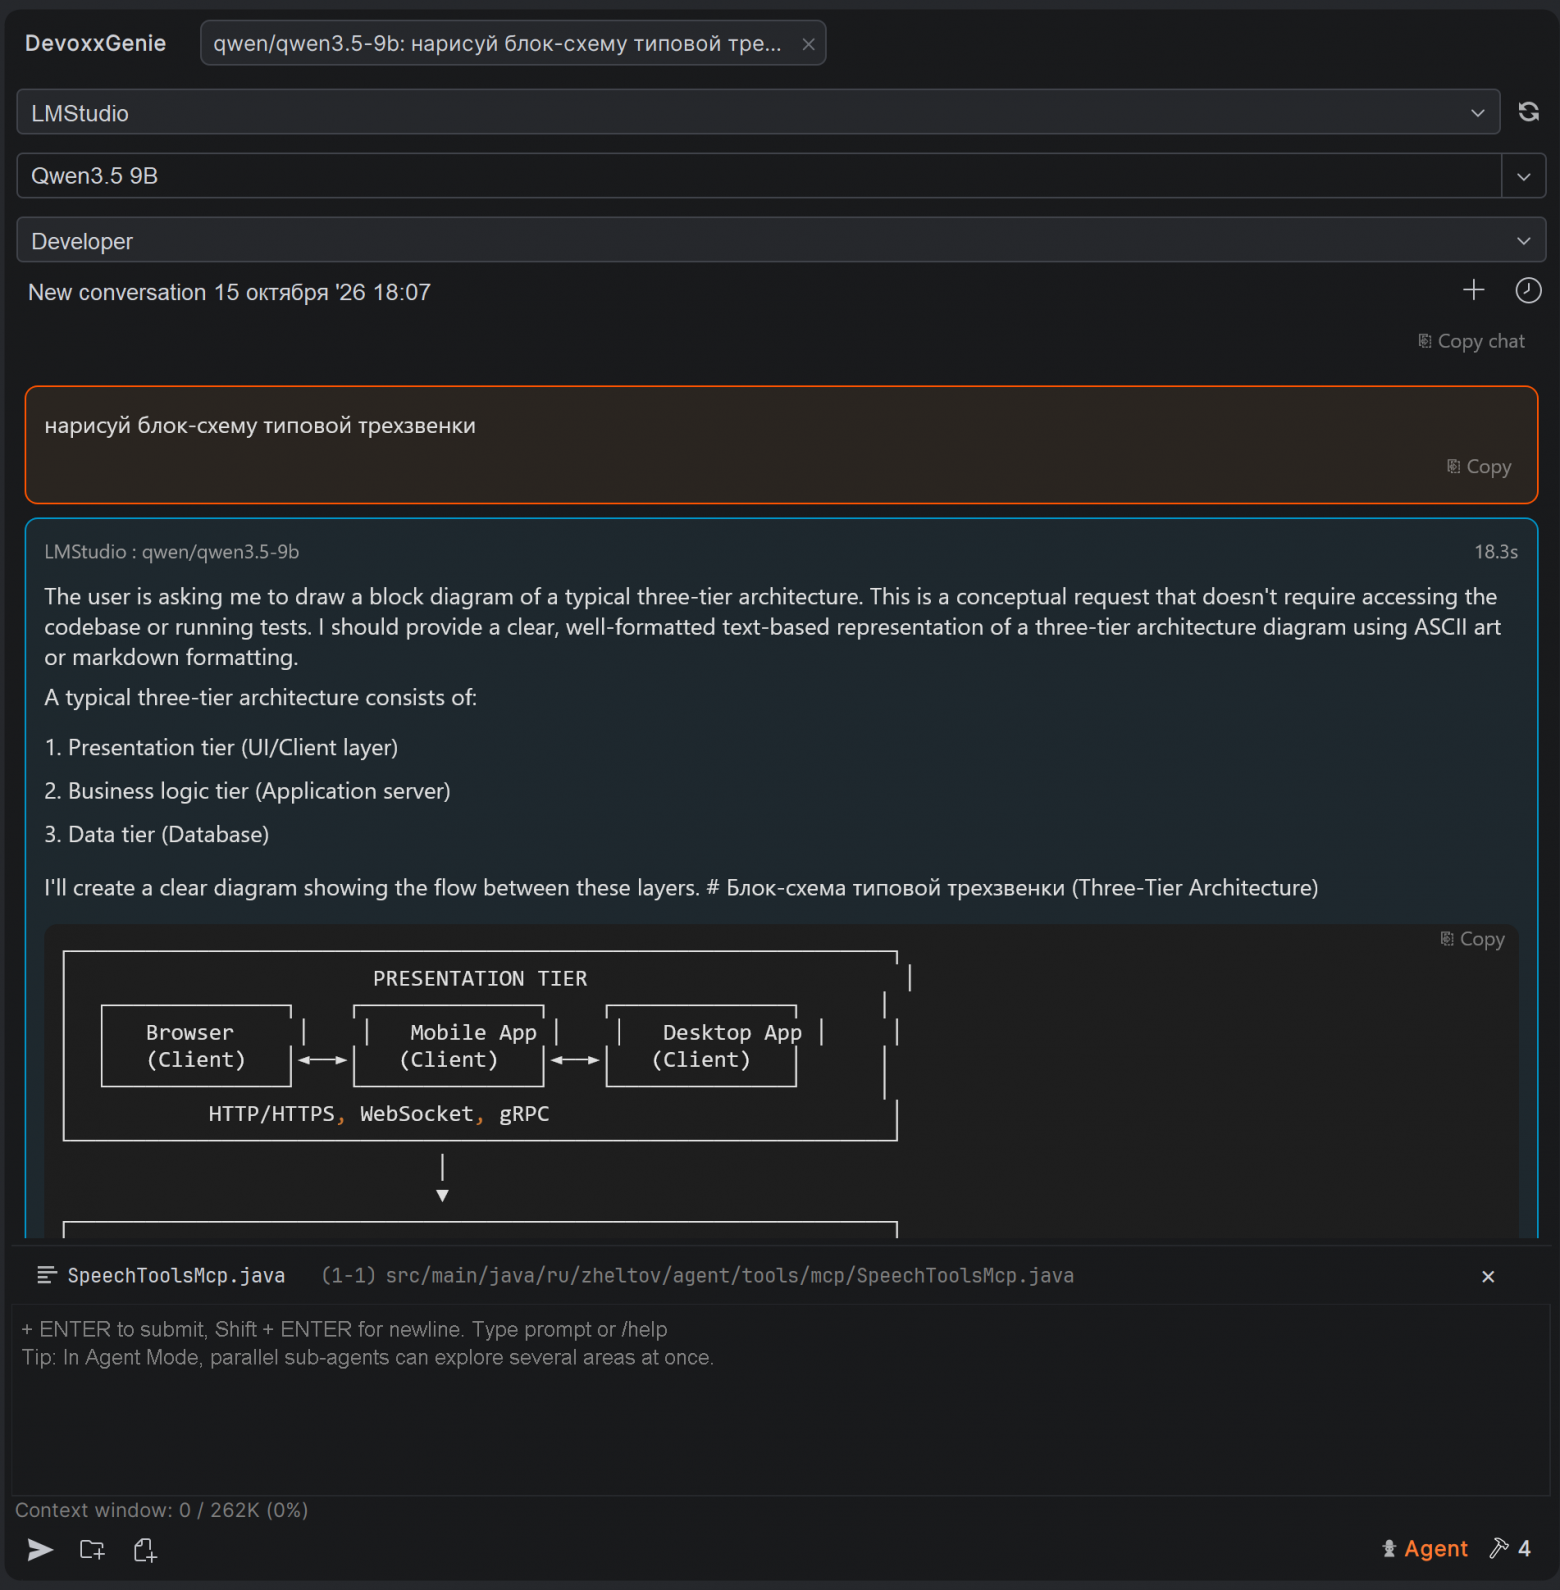
Да, криво-косо. Да, зачем-то подцепил в контекст открытый в IDE класс. Да, зачем-то вывел размышления… Но это уже гораздо лучше, чем ничего!
Какой следующий шаг?
Сейчас мне стало понятно, что 16 ГБ VRAM – это вообще минимальный минимум, даже если полностью разгрузить eGPU от задач вывода картинки на экран и использовать его только для ИИ.
Ну а сколько было бы достаточно? 32 ГБ VRAM возможно было бы достаточно для запуска модели уровня Qwen3.5 27B Q4_K_M с большим окном контекста при квантизации KV-кэша и разумном тюнинге. И результат ее работы, вероятно, будет получше моей нынешней Qwen3.5 9B Q4_K_M с неквантованным KV-кэшем. Но это не точно. При этом не «существенно лучше», а просто «получше». Это становится понятно, когда пытаешься решить сложную задачу с помощью сильной облачной модели.
Да, на горизонте замаячил новый класс устройств с большим объемом унифицированной памяти и по более-менее вменяемым ценам типа AMD Strix Halo. Конечно, пока все очень сыро и недостаточно производительно, но это только пробный шар – весьма многообещающий.
Но даже если решить вопрос с железом, остаётся проблема постановки задач и управления агентом. Нельзя попросить агента «Сделай все хорошо!» и рассчитывать на успех. Если задача сформулирована расплывчато, если код проекта хаотичен и не укладывается в общепринятые практики, если документация фрагментарна и противоречива, то даже опытный человек с IQ под 200 не сможет справиться с ней без дополнительных вопросов. ИИ-агент же даже не станет уточнять и переспрашивать – он просто бросится жечь токены, метаясь по проекту в поисках, заполнит контекст до объема, при котором начнет безудержно галлюцинировать и станет абсолютно бесполезен. А если у него будут широкие права, то может стать даже вреден.
Получается, дело не только в железе и моделях. Я научился в своей локальной ИИшнице получать интересные результаты на некоторых классах задач за счет изменения подходов к применению ИИ, но это уже другая история…
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.